


Python random模块中生成随机整数与随机小数的区别
深入对比Python random模块中生成随机整数与随机小数的核心机制,详细解析randint、randrange、random与uniform在数据类型、边界开闭、底层位变换及工程选型上的本质区别。
在 Python 的标准库 random 模块中,生成随机整数与随机小数的核心差异不仅体现在返回的数据类型(int 与 float)上,更深层次地体现在数学集合属性(离散分布与连续分布)、区间边界的包含规则(双闭区间与半开区间)、底层位流变换路径以及计算精度约束上。掌握这些本质差异,能够帮助开发者在编写模拟算法、抽样逻辑或业务随机数时避免边界越界和精度偏移。
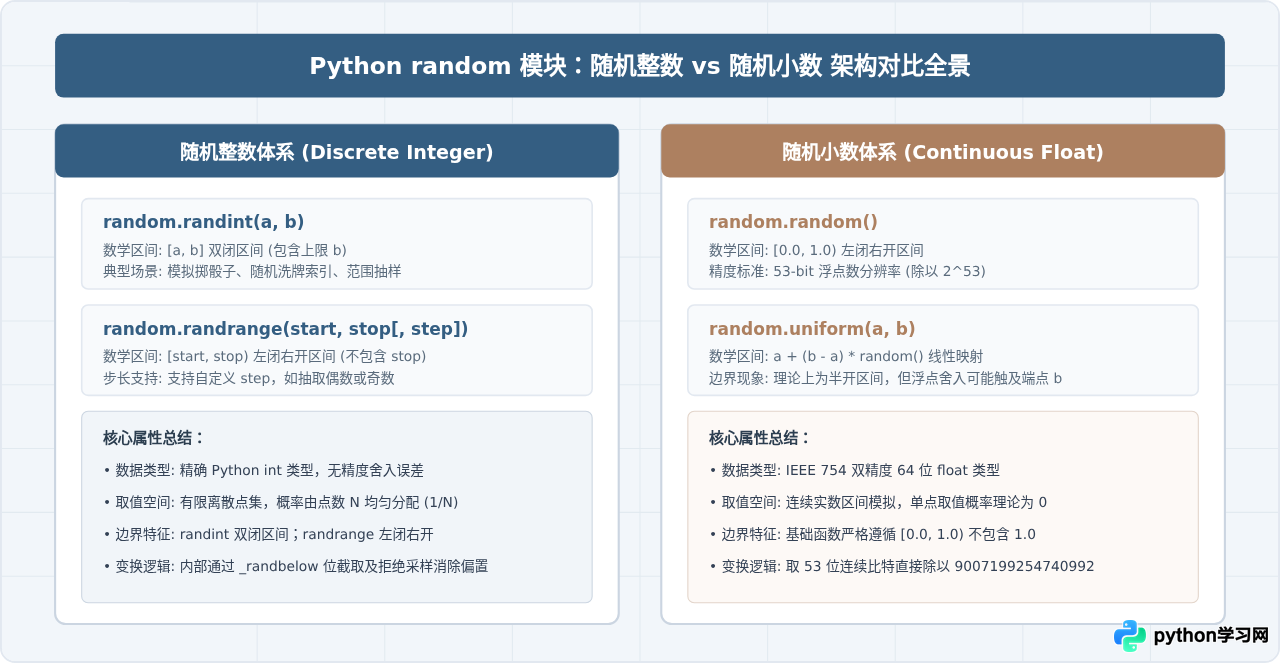
一、核心机制与函数体系对照
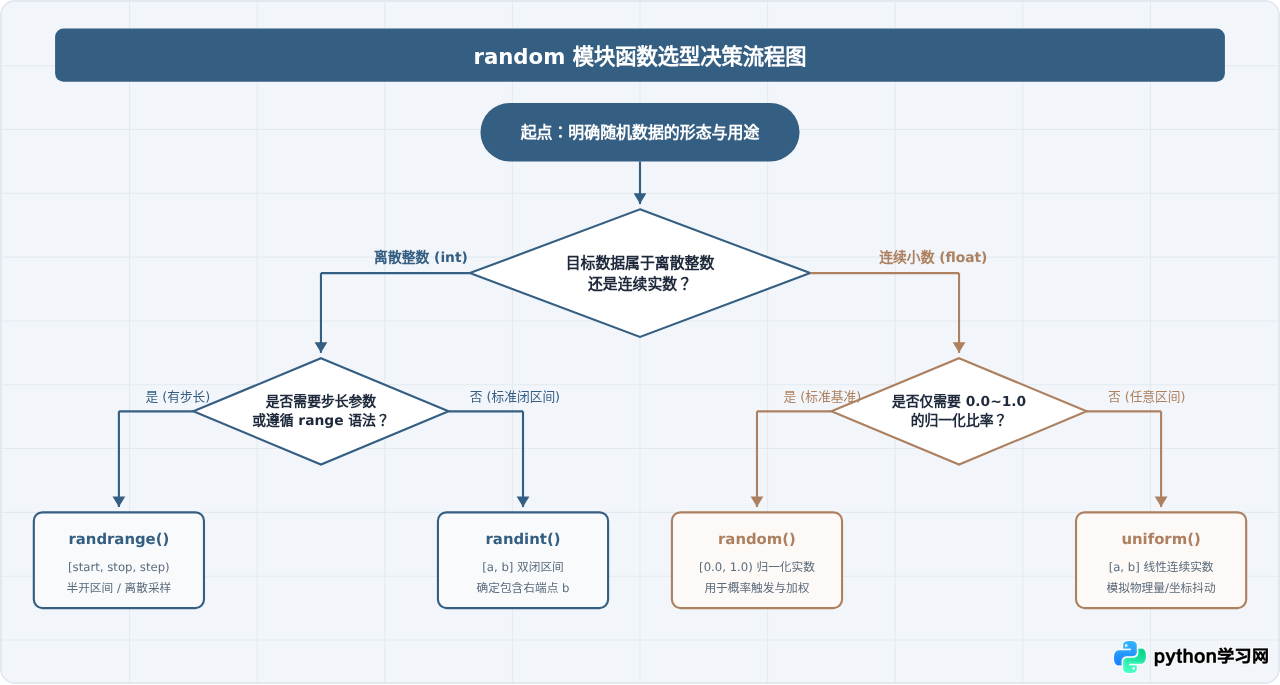
Python 的 random 模块针对整数和小数分别提供了专门的高级接口。两类函数分别服务于离散计数场景与连续度量场景:
- 随机整数接口:主要包括
random.randint(a, b)和random.randrange(start, stop[, step])。它们的返回值为精确的 Python 整数对象,用于从离散集合中进行等概率抽取。 - 随机小数接口:主要包括
random.random()和random.uniform(a, b)。它们的返回值为 IEEE 754 双精度浮点数(64 位),用于在连续实数区间内模拟均匀分布采样。
二、区间边界与包含规则的数学区别
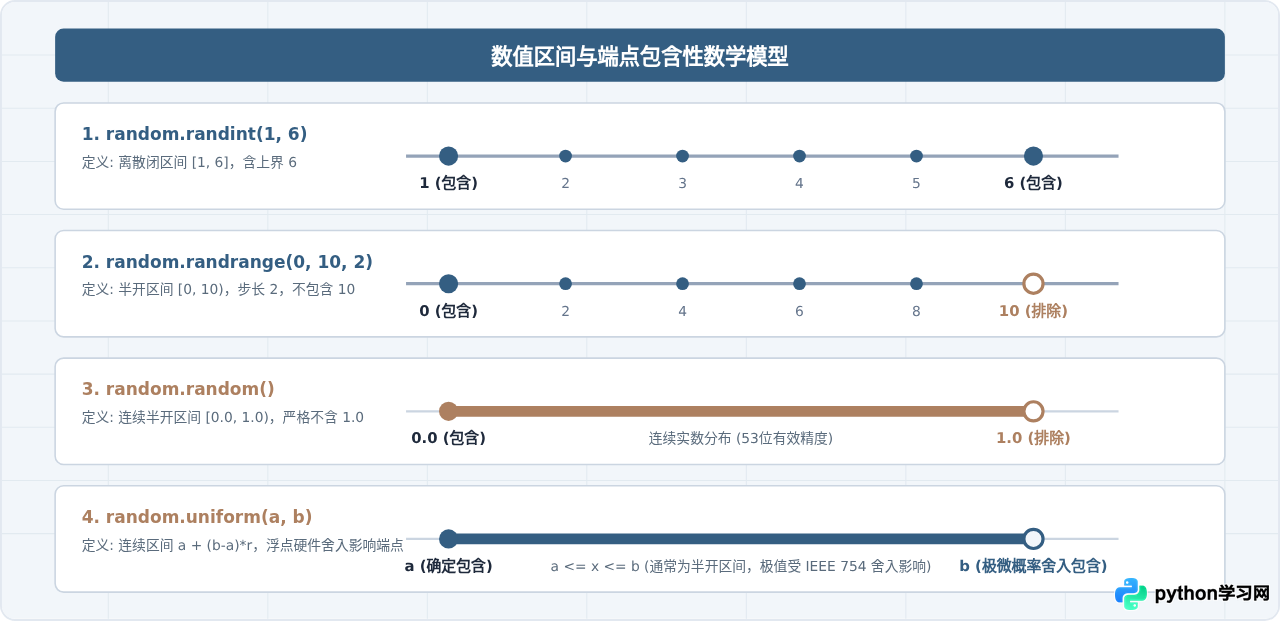
很多初学者在使用 random 模块时最容易踩坑的环节就是边界包含性。不同函数在数学区间上的定义存在明显差别:
1. randint 与 randrange 的边界差异
random.randint(a, b) 实际上是 random.randrange(a, b + 1) 的便捷别名。因此:
randint(1, 6)包含上界6,返回值集合为严格的{1, 2, 3, 4, 5, 6}。randrange(1, 6)遵循 Python 惯用的半开区间语义(如同内置的range()函数),取值范围为1 <= N < 6,返回值集合为{1, 2, 3, 4, 5},永远不会返回6。randrange还允许传入step步长参数,例如randrange(0, 10, 2)将仅从偶数集{0, 2, 4, 6, 8}中等概率返回一个数值。
2. random 与 uniform 的浮点区间特性
random.random() 生成标准区间的随机小数,其数学区间严格定义为半开区间:
0.0 <= N < 1.0由于浮点数在计算机中采用二进制科学计数法存储,Python 在底层将梅森旋转算法生成的 53 个随机比特位除以 2**53(即 9007199254740992)。分子取值范围是 [0, 2**53 - 1],因此结果严格小于 1.0,绝不会自然产生 1.0。
而对于 random.uniform(a, b),官方实现公式为:
def uniform(self, a, b):
    return a + (b - a) * self.random()
在理论数学上,由于 random() < 1.0,计算结果应该落在半开区间 [a, b)(当 a < b 时)或 (b, a](当 a > b 时)。但在计算机浮点数运算中,由于 IEEE 754 浮点乘加运算的舍入机制(Rounding),当 (b - a) * random() 的精度向无穷大方向发生舍入时,端点值 b 在极罕见情况下可能会被浮点硬件计算出来。因此官方文档严谨地表述为:“取决于浮点舍入,端点 b 可能会或可能不会包含在范围内”。
三、底层实现与位转换机理的区别
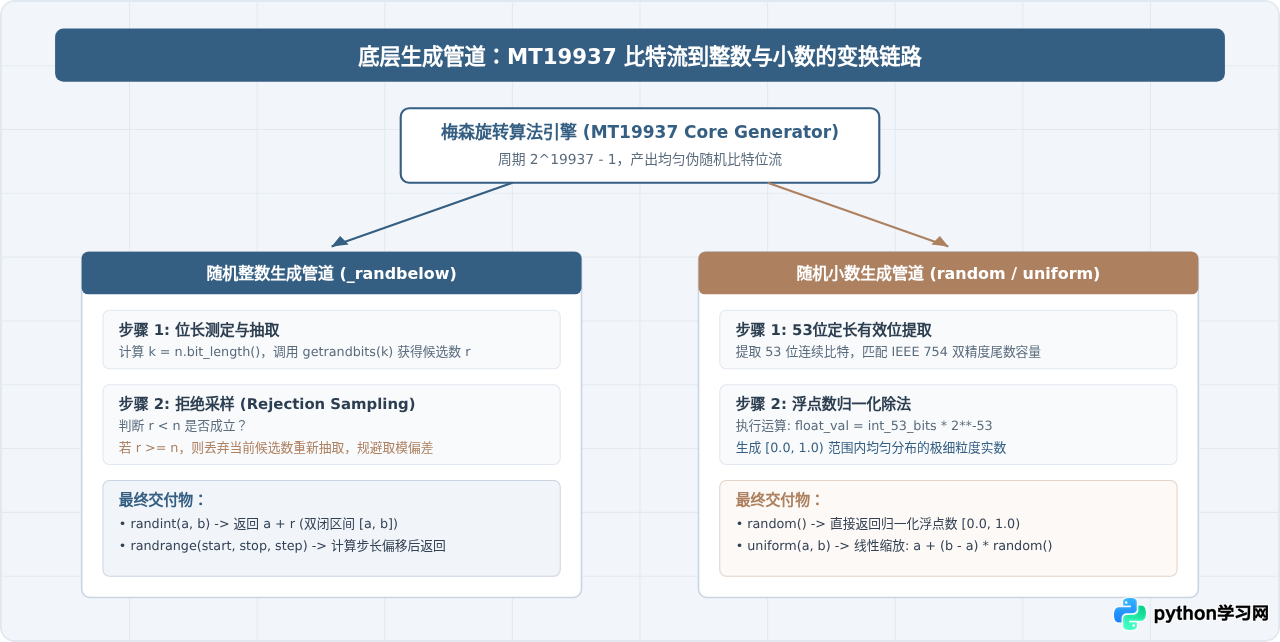
Python 标准库的 random 模块基于梅森旋转算法(Mersenne Twister, MT19937)构建,其状态周期长达 2**19937 - 1。该算法的核心产物是长度为 32 位或 64 位的伪随机无符号整数。从伪随机比特流到最终呈现给开发者的整数或浮点数,经历了完全不同的变换流程。
1. 随机整数的位截取与拒绝采样(Rejection Sampling)
在生成区间 [0, n) 内的随机整数时,常规开发者容易想到的做法是“取模运算”,即 getrandbits() % n。然而,如果比特流的总可能状态数不能被 n 整除,单纯取模会引入模偏差(Modulo Bias),导致较小的数字出现概率略高。
Python 官方通过内部方法 _randbelow(n) 彻底解决了该问题。其处理逻辑如下:
- 计算目标上界
n所需的最小二进制位数k。 - 通过底层的 C 扩展接口
getrandbits(k)直接提取k个随机比特位,得到一个候选值r。 - 如果候选值
r < n,则直接接受该值并返回。 - 如果候选值
r >= n,则放弃该候选值并重新抽取(拒绝采样),直至落在合法范围内。
这种设计确保了离散区间内的每一个整数都拥有数学上严格均等的出现概率,且不受模偏差影响。
2. 随机小数的 53 位除法映射
IEEE 754 标准中的双精度浮点数(binary64)包含 1 个符号位、11 个指数位和 52 个显式尾数位(配合隐式最高有效位共有 53 位有效精度)。为了充分利用双精度浮点数的全部精度,Python 的 random.random() 不是简单地生成 32 位数,而是执行以下操作:
- 从底层 MT19937 状态生成器中提取连续的 53 个随机比特位。
- 将这 53 位组成的无符号长整数(范围在
0到9007199254740991之间)作为分子。 - 将其直接除以浮点数常量
2**53(即9007199254740992.0)。
通过这种方式,生成的浮点数在 [0.0, 1.0) 区间内以 2**-53(约 1.11e-16)为基本增量均匀散布,实现了极高的精度分辨率和均匀分布质量。
四、开发场景与函数选型决策
在实际工程代码中,选错随机数函数会导致隐蔽的逻辑漏洞。例如:在需要随机选择列表下标时错误使用了浮点函数,或者在概率触发时错误使用了整数取模。下表汇总了选型的直接依据:
| 业务需求类型 | 推荐使用函数 | 区间特征与关键参数 | 典型代码范式 |
|---|---|---|---|
| 模拟骰子/抽卡次数等离散事件 | random.randint(a, b) |
双闭区间 [a, b] |
dice = random.randint(1, 6) |
| 序列切片/步长采样/跳跃抽样 | random.randrange(start, stop, step) |
半开区间 [start, stop),支持步长 |
idx = random.randrange(0, len(items), 2) |
| 概率触发/命中率判断(如30%概率) | random.random() |
半开区间 [0.0, 1.0) |
if random.random() < 0.3: do_action() |
| 物理模拟/连续坐标/带权随机扰动 | random.uniform(a, b) |
连续区间 [a, b],浮点数 |
delay = random.uniform(0.5, 2.5) |
五、工程实践中的典型陷阱与排查
在实际编码过程中,由于对整数与小数生成机制的混淆,极易产生以下几类典型问题:
1. 混淆 randint 与序列长度引发越界(IndexError)
在从列表 items 中随机选取下标时,常见的误写如下:
import random

items = ["apple", "banana", "cherry"]

# 错误示例:randint 包含右边界,当返回 3 时引发 IndexError: list index out of range
# bad_index = random.randint(0, len(items))

# 正确写法一:使用 randrange,完全对齐 len() 的半开区间语义
correct_index = random.randrange(0, len(items))

# 正确写法二:直接使用 choice
chosen_item = random.choice(items)
2. 浮点数等值比较陷阱
由于 random.uniform() 或 random.random() 返回的是双精度浮点数,在理论上两个浮点数完全相等的概率趋近于零:
# 错误示例:永远不要用 == 比较随机小数
val = random.uniform(1.0, 5.0)
if val == 3.0:
    print("命中指定值")  # 几乎不可能执行

# 正确做法:使用区间范围或阈值比较
if 2.99 <= val <= 3.01:
print("落在容差目标区间内")random 模块内所有的整数和小数函数均属于伪随机数生成器(PRNG),其内部状态可以通过观测连续输出推导重现。在涉及密码生成、安全令牌(Token)、验证码或敏感抽奖等安全场景中,严禁使用 random 模块,而应使用 Python 内置的 secrets 模块(如 secrets.randbelow())。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















