


Python函数返回多个值时为何推荐使用tuple
深入解析Python函数在返回多个值时为何推荐使用tuple(元组),从语法糖解糖、不可变契约、内存与执行效率、解构解包等核心维度全面分析。
return a, b),语言解释器在底层默认且必然地将其打包为元组(tuple)。推荐使用 tuple 而非列表(list)或其它结构作为多返回值载体,核心在于三大设计事实:tuple 拥有不可变的严格语义,确立了跨函数边界的数据契约安全;其在 CPython 中具备定长无扩容冗余的高效内存布局与对象池重用机制;同时语法层面原生支持高效的解构解包(unpacking)。
一、语法机制:逗号操作符与自动打包解包
许多初学者认为 Python 拥有直接返回“多个独立变量”的特殊语法,但从语言规范来看,Python 的任何函数在底层都只返回单个对象。当编写类似 return status, code, data 的语句时,起决定性作用的是逗号(comma)而非关键字或括号。
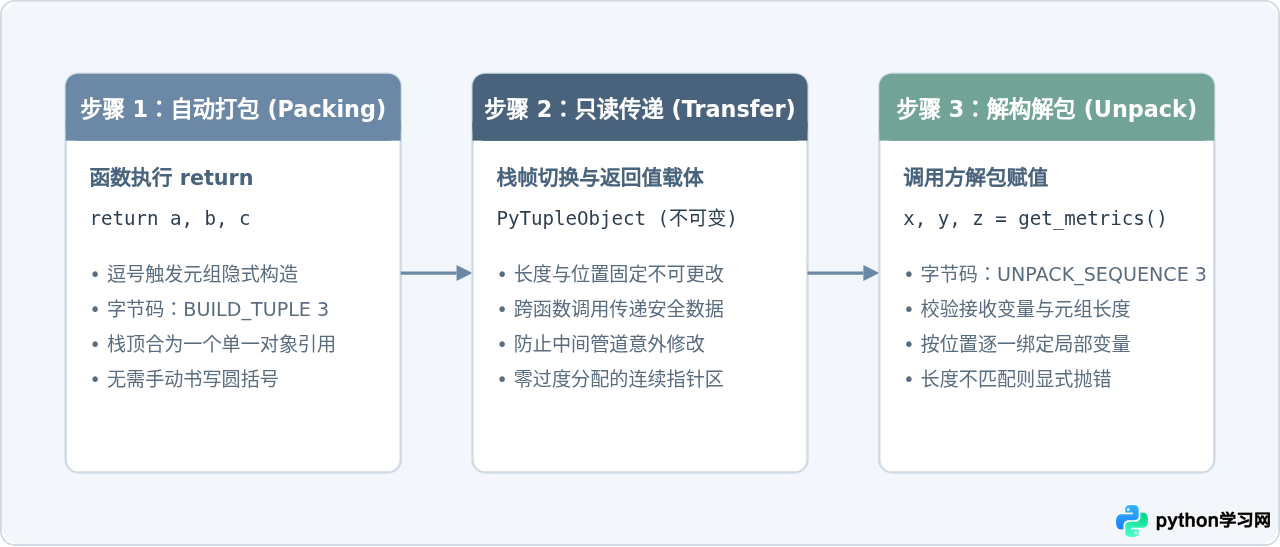
逗号在 Python 中扮演了元组构造表达式的角色。函数返回时的多个表达式被解释器自动封装为元组,这一过程被称为元组打包(Tuple Packing);接收方使用多个变量匹配赋值时,则触发序列解包(Sequence Unpacking)。
def get_system_metrics():
    cpu_usage = 42.5
    memory_usage = 68.0
    disk_usage = 81.2
    # 逗号隐式构造一个 3 元组并返回
    return cpu_usage, memory_usage, disk_usage

# 调用方通过解包同时接收三个明确的局部变量
cpu, mem, disk = get_system_metrics()
print(f"CPU: {cpu}%, Memory: {mem}%, Disk: {disk}%")
整个调用与返回过程可以在时序上划分为三个原子步骤:内部表达式打包为元组对象、函数栈退出时传递该对象引用、外部调用栈按位置展开赋值。
二、语义契约与不可变性:为何不是 List
在语法上,Python 完全允许函数显式返回一个列表,例如 return [status, message]。然而在实际工程与官方规范中,绝不推荐将列表作为常规的多返回值载体。这涉及 Python 设计哲学中元组与列表的核心定位差异:
- 异构记录(Heterogeneous Record)与同构集合(Homogeneous Collection):在 Python 惯用法中,元组通常表示一条具有固定字段含义的“记录”,每个位置的类型和业务含义可以完全不同(例如位置 0 为整数状态码,位置 1 为字符串提示,位置 2 为浮点耗时)。而列表则被设计为保存任意数量、同一业务类型的有序集合。
- 不可变性防范副作用(Immutability as a Defense):函数返回值往往代表某一时刻计算完成的既定事实。使用元组作为载体,能够向调用方乃至整个调用链路传递明确的“只读契约”。如果返回列表,任何接收方都可以随意执行
result.append()或修改特定槽位,导致在复杂的中间件或多函数调用链中产生难以排查的状态污染与并发隐患。
(int, str) 元组时,它承诺的是输出一对结构确定的只读数据。如果改用 [int, str] 列表,就暗示调用者可以对该数据容器进行增删改,这与“函数计算产物”的本质诉求背道而驰。
三、底层实现与性能优势:CPython 内存与字节码解析
除了代码语义上的考量,元组在 CPython 底层实现中享有极高优先级的性能优化。函数调用在现代软件中是高频操作,多返回值的开销对高吞吐服务具有直接影响。
1. 紧凑的内存布局与零冗余
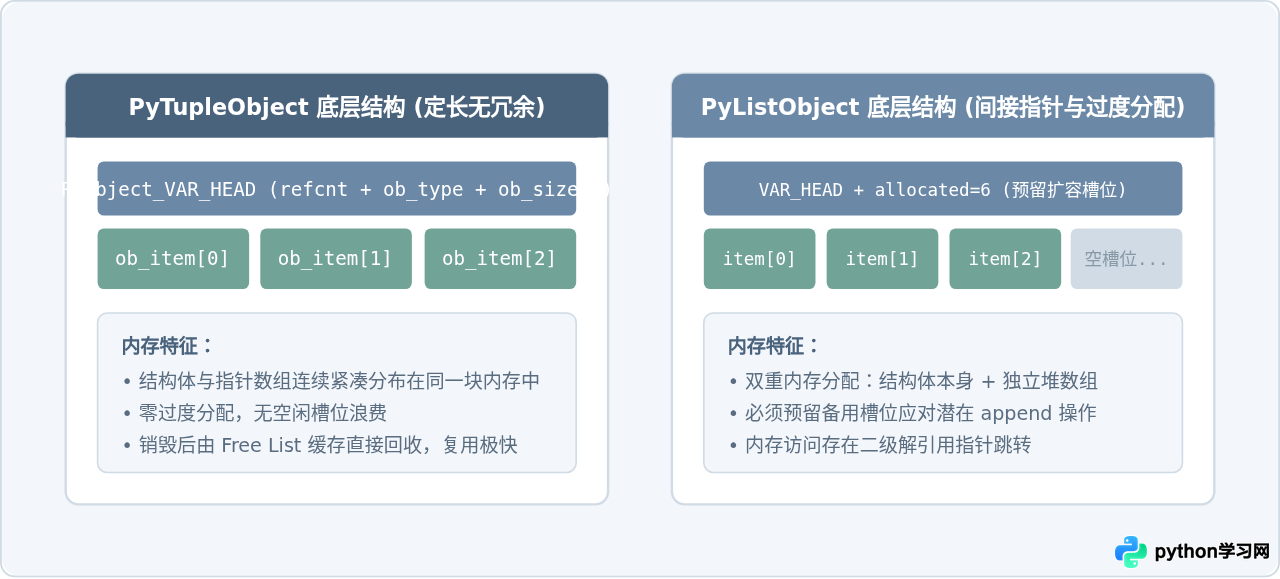
在 CPython 源码中,PyTupleObject 采用单一连续内存块存储。由于元组长度固定,它在分配时不需要为将来的扩容预留冗余指针插槽。与之相对,PyListObject 为了保证 append() 的均摊 \(O(1)\) 时间复杂度,采用了过度分配算法(over-allocation),维护着一个大于实际元素数量的缓冲数组,并包含一层指向独立指针数组的间接指针。
| 容器类型 | 包含 3 个元素时的内存占用(sys.getsizeof) | 额外预留槽位(Over-allocation) | 内存分配模式 |
|---|---|---|---|
| tuple | 64 字节 | 无(严格按需分配) | 单块连续内存,指针与结构体共存 |
| list | 88 字节(若经 append 可达 120+ 字节) | 有(根据增长系数预留) | 结构体 + 二级独立指针数组 |
2. 小型元组缓存池(Free List)
CPython 解释器为长度在 1 到 20 之间的元组维护了空闲链表缓存机制(在 Python 3.12+ 进一步整合入全局/内部小对象缓存池)。当一个临时元组被解包销毁后,其占用的 C 结构体内存并不会立即退回给操作系统,而是直接挂入缓存池。下一个同长度的函数返回元组可以直接复用这块内存,彻底省去了 malloc 系统调用的开销。
四、选型边界:何时应该超越普通元组
虽然 tuple 是返回多值的推荐基石,但随着业务逻辑复杂度的增加,过度依赖匿名普通元组也会引入维护性问题:
- 当返回变量超过 3 到 4 个时,调用方难以单凭记忆分清每个位置的实际意义,容易发生位置混淆;
- 解包时若调用方只关心其中某一个字段,必须使用大量下划线占位符(如
a, _, _, d = get_data()),降低代码可读性。
在不同场景下,应根据返回值数量与使用方式选择最恰当的承载结构:
from typing import NamedTuple
from dataclasses import dataclass

# 场景 1:普通元组 (2~3 个字段,含义直观)
def divide(dividend: int, divisor: int) -> tuple[int, int]:
    return divmod(dividend, divisor)

# 场景 2:NamedTuple (3 个以上字段,需字段名可读性且保持不可变轻量)
class UserSession(NamedTuple):
    user_id: int
    token: str
    role: str
    is_active: bool

def authenticate() -> UserSession:
    return UserSession(1001, "tk_98124", "admin", True)

# 调用方既可以按属性名访问,也可按元组解包
session = authenticate()
print(session.token)
uid, tok, *rest = authenticate()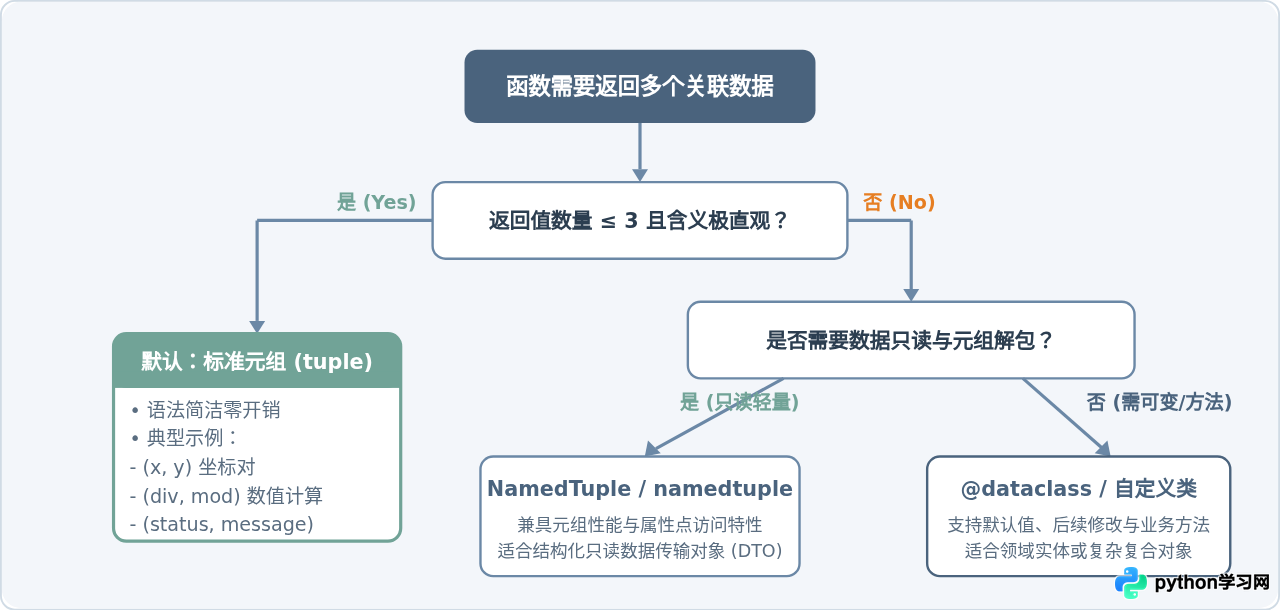
五、注意事项与常见误区
- 单返回值时的逗号陷阱:如果函数本意只返回单个对象,但尾部不小心多打了一个英文逗号(如
return result,),Python 会将其识别为单元素元组(result,),从而破坏调用方的类型假设。 - 元组内包含可变对象:元组本身的不可变性指的是“其包含的对象引用不可更改”。如果元组内部元素本身是列表或字典(如
return [1, 2], "ok"),该内部列表仍然可以被外部代码就地修改。因此,保障纯粹只读输出的最佳做法是确保元组内的所有子元素同样为不可变类型。 - 解包数量不匹配:解包赋值要求左值数量与元组元素完全一致,否则抛出
ValueError: too many values to unpack或not enough values to unpack。如果需要忽略部分多余字段,可结合 Python 3 的扩展解包语法(例如head, *tail = get_values())。
总结而言,Python 推荐使用 tuple 作为函数返回多个值的核心结构,并非随意而为的惯性习惯,而是语言语法糖优雅度、防范副作用的数据契约安全性、以及 CPython 内存优化三者高度统一的工程设计结果。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















