


Python读取中文文件报UnicodeDecodeError的排查与修复方法
针对Python读取中文文本文件时出现的UnicodeDecodeError报错,详细梳理其产生根源、系统排查步骤、GBK/UTF-8/BOM等常见场景修复代码及工程级防御规范。
在编写 Python 脚本读取包含中文的文本文件时,很多开发者经常会遭遇如下报错:运行 open('data.txt').read() 后,程序突然崩溃并抛出 UnicodeDecodeError: 'gbk' codec can't decode byte 0x... in position ...: illegal multibyte sequence 或 UnicodeDecodeError: 'utf-8' codec can't decode byte 0x... in position ...: invalid start byte。要彻底解决这个报错,核心方法是在调用 open() 时显式传入与文件真实编码一致的 encoding 参数(最常见为 utf-8、gb18030 或带 BOM 的 utf-8-sig),避免隐式依赖操作系统默认编码。本文将从报错机理、排查路径、修复方案到防御规范展开完整解析。
一、报错成因:二进制字节与字符映射的脱节
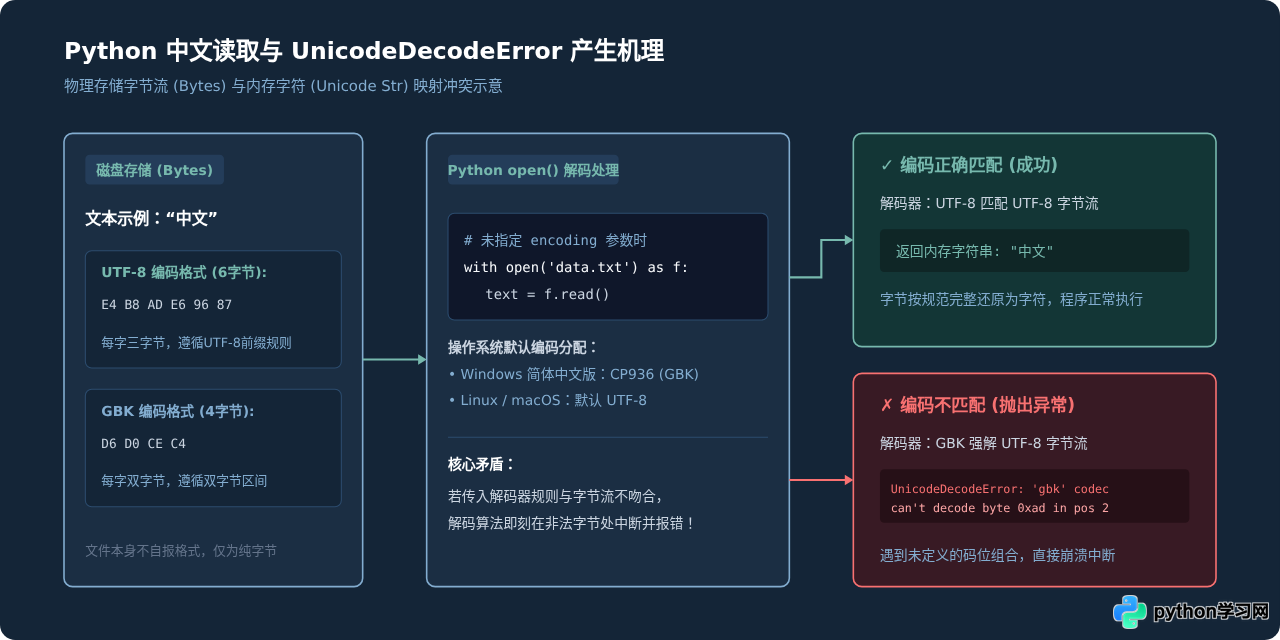
计算机在磁盘上保存任何文件时,本质上都只能存储由 0 和 1 组成的二进制字节流(Bytes)。当我们在文本文件中写入中文字符(例如“中文”)时,操作系统和编辑器必须按照某种规则将字符转化为字节,这个过程叫编码(Encoding);反过来,当 Python 程序打开文件并试图将其转化为内存中的字符串对象(str)时,必须将这些字节还原为字符,这个过程叫解码(Decoding)。
UnicodeDecodeError 的本质,就是Python 解码器在读取字节流时,遇到了当前指定编码规则中不允许出现的字节组合。例如:
- 场景 A(UTF-8 文件被当成 GBK 解码):文件是用 UTF-8 保存的,“中文”对应的二进制是 6 个字节
0xE4 0xB8 0xAD 0xE6 0x96 0x87。在 Windows 系统上,Python 默认采用gbk解码,而gbk规定汉字为双字节编码且对后续字节有严格范围限制,一旦遇到不合规的字节序列,便抛出'gbk' codec can't decode byte ...。 - 场景 B(GBK/ANSI 文件被当成 UTF-8 解码):文件是旧版 Windows 记事本或 Excel 导出的 ANSI/GBK 格式,“中文”对应的二进制是 4 个字节
0xD6 0xD0 0xCE 0xC4。如果 Python 尝试使用utf-8解码,由于0xD6属于多字节引导字节但后续字节不符合 UTF-8 规范,便抛出'utf-8' codec can't decode byte 0xd6: invalid start byte。
二、系统化排查路径:四步定位真实编码
遇到报错时,切勿盲目地将 utf-8 或 gbk 随意轮换测试。建立严谨的排查流程能够避免掩盖潜在的生僻字兼容问题或字符损坏。
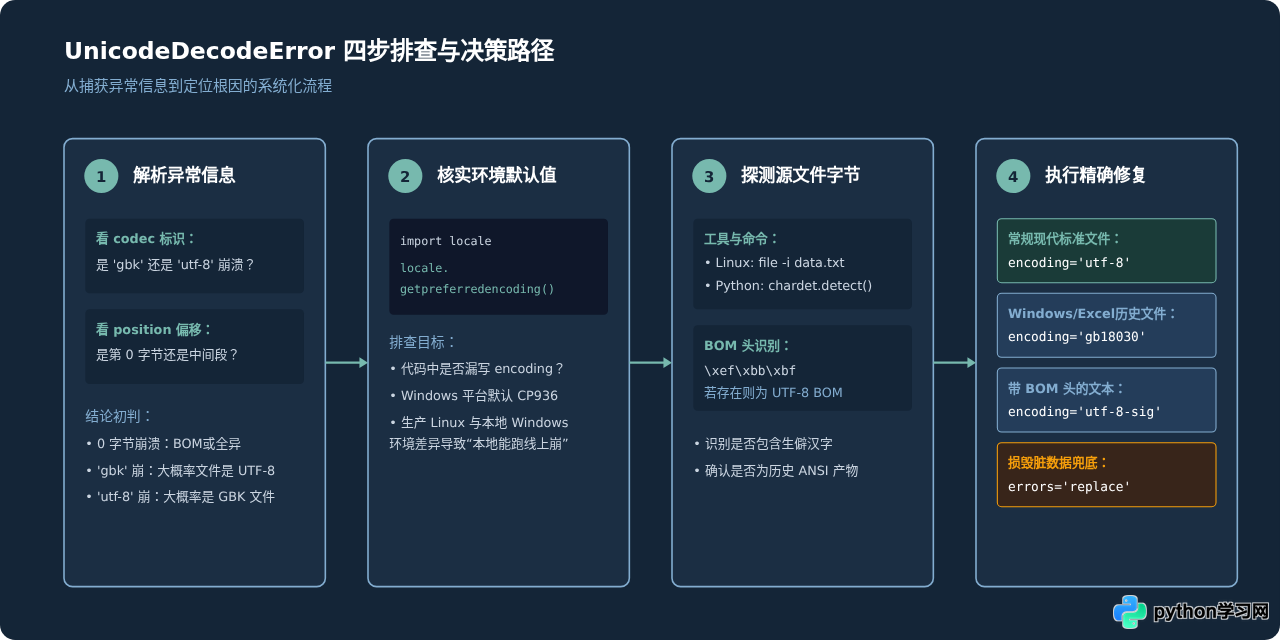
第 1 步:细读报错信息中的核心线索
仔细观察错误堆栈最后一行,其中包含了三个关键元数据:
UnicodeDecodeError: 'gbk' codec can't decode byte 0xad in position 2: illegal multibyte sequence'gbk' codec:表示 Python 当前正在使用的解码器名称。这说明你未传encoding参数导致走了 Windows 默认的 GBK,或者显式指定了encoding='gbk'。byte 0xad:表示首个发生冲突的非法字节十六进制值。如果是0x80以上的值,多半是因为读取了多字节编码(如 UTF-8)被按单字节或不兼容的双字节切分。position 2:表示发生错误的文件偏移量(字节索引)。
第 2 步:查看当前 Python 环境的系统默认编码
打开终端或在脚本中执行以下代码,确认当前操作系统为 Python 分配的默认首选编码:
import locale
import sys

print("首选编码:", locale.getpreferredencoding())
print("默认编码:", sys.getdefaultencoding())
在中文 Windows 10/11 上,locale.getpreferredencoding() 往往返回 cp936。若未显式传参,哪怕文件是由 VS Code 保存的现代 UTF-8 文件,也会必然报错。
第 3 步:检测源文件的真实编码
不要依靠文件后缀猜测编码。以下是确定文件真实编码的三种有效方式:
- 使用代码自动探测(推荐):在 Python 中使用
charset-normalizer或chardet库读取文件的原始二进制前几个字节进行推断:import charset_normalizer # 读取前 10KB 字节流进行编码猜测 with open('data.txt', 'rb') as f: raw_data = f.read(10240) result = charset_normalizer.detect(raw_data) print("探测到的编码:", result['encoding']) - 借助文本编辑器查看:使用 VS Code 打开文件,查看右下角状态栏显示的编码(如
UTF-8、UTF-8 with BOM或GB 2312)。 - 检查是否存在 BOM 签名:以二进制模式读取文件前 3 个字节:
with open('data.txt', 'rb') as f:
    header = f.read(3)
    if header == b'\xef\xbb\xbf':
        print("该文件为包含 BOM 头的 UTF-8 文件!")
第 4 步:判断是否存在生僻字或损坏数据
如果文件整体是 GBK 编码,但在读到某个特定行或特定人名时报错,常见原因是该文件中包含了“镕”、“䶮”等生僻字,超出了老旧 GB2312/GBK 字库的收录范围,此时需要提升至大字库解码器。
三、具体修复方案与典型场景实践
方案 1:显式指定 UTF-8 编码(解决 90% 以上的基础报错)
在现代软件工程中,绝大多数文本文件、JSON、配置文件及源代码均采用 UTF-8 编码。在 Windows 下未加参数运行 open() 时,由于默认使用了 GBK,便会报 'gbk' codec can't decode byte 0x...。修复方法是在 open() 中明确指定 encoding='utf-8':
# 正确写法:无论在 Windows、Linux 还是 macOS 均保持一致行为
with open('data.txt', 'r', encoding='utf-8') as f:
    content = f.read()
    print(content)
方案 2:使用 GB18030 代替 GBK / GB2312(解决历史中文数据及生僻字问题)
如果文件是由早期的 Windows 软件、简体中文 Excel 导出的 CSV,或者政府、金融系统的遗留数据库导出的,该文件很可能是 ANSI/GBK 编码。如果盲目使用 encoding='utf-8',就会报 'utf-8' codec can't decode...。
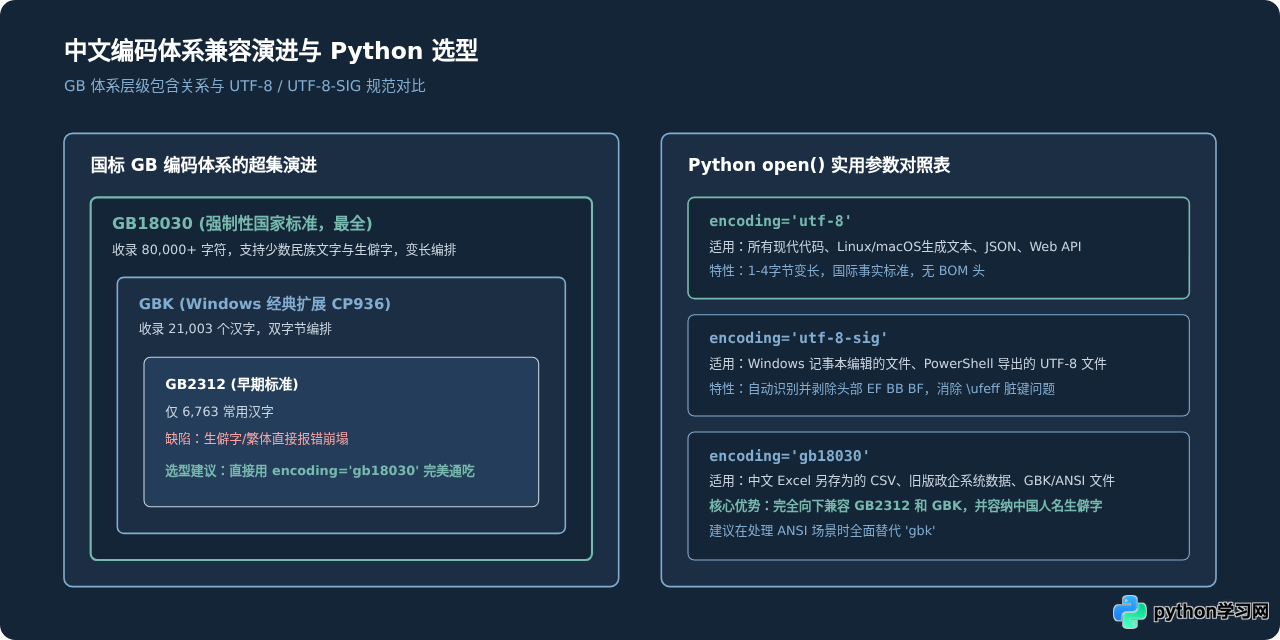
此时许多人会尝试写 encoding='gbk'。但在实际业务中,强烈建议优先使用 encoding='gb18030' 而不是 encoding='gbk' 或 encoding='gb2312'。原因在于我国中文编码标准的扩充关系:
- GB2312:仅收录 6,763 个常用简体汉字,遇到繁体字或生僻字直接无法处理。
- GBK:向下兼容 GB2312,收录了 21,003 个汉字。
- GB18030:是我国现行的强制性国家标准,完全向下兼容 GBK 和 GB2312,收录了超过 80,000 个汉字及少数民族文字。
使用 gb18030 可以完全解码 GBK 文件,同时能避免因人名或地名中含有生僻字(如“䶮”、“旻”、“赟”)而偶发崩溃:
# 推荐:处理 Windows 中文遗留文件或 Excel 导出数据
with open('legacy_data.csv', 'r', encoding='gb18030') as f:
    content = f.read()
方案 3:使用 utf-8-sig 消除 BOM 签名干扰
在 Windows 记事本中保存“UTF-8”时,系统常会在文件头部默默塞入 3 个不可见字节 \xef\xbb\xbf(即字节顺序标记 BOM)。普通 utf-8 解码器会将这 3 个字节解码为字符 \ufeff,它可能导致:
- 读取第一行时多了个不可见的
\ufeff,导致字典 key 匹配失败(如{'name': '张三'}变成了{'\ufeffname': '张三'}); - 在某些严格解析的场景下引发位置 0 处的解码错误。
修复方案是使用 Python 内置的 utf-8-sig 编码。它会在读取时自动检测并剔除开头的 BOM 标记:
# 使用 utf-8-sig 自动剥离开头的 \ufeff BOM 标记
with open('data_with_bom.txt', 'r', encoding='utf-8-sig') as f:
    header = f.readline().strip()
    print("首行字段名:", header)  # 干净的字段名,无 \ufeff
方案 4:容错模式处理损坏或混合编码数据(底线方案)
在网络抓取、系统日志归档或通信报文截获场景下,可能会遇到由多段不同编码拼接而成的“脏数据”,或者传输截断造成的半个汉字(损坏字节)。如果业务允许丢失少量不可读字符而绝不能让任务崩溃,可以使用 errors 参数:
# 替换模式:非法字节被安全替换为标准占位符  (\ufffd)
with open('dirty_log.log', 'r', encoding='utf-8', errors='replace') as f:
    log_content = f.read()

# 忽略模式:直接丢弃无法解码的字节(谨慎使用,会改变文本原有结构)
with open('dirty_log.log', 'r', encoding='utf-8', errors='ignore') as f:
raw_content = f.read()errors='ignore' 会静默吞掉异常并丢失数据,导致排查困难。除非是处理不可逆的脏日志分析,否则切勿在财务、交易或核心业务逻辑中作为常规手段使用。
四、第三方库与常见工具场景适配
在实际开发中,除了内置的 open() 函数,Pandas 数据分析和 Pathlib 面向对象文件操作也是 UnicodeDecodeError 的高发区。
1. Pandas 读 CSV 报 UnicodeDecodeError
当执行 pd.read_csv('data.csv') 时,Pandas 底层 C 引擎默认也是按 UTF-8 读取。如果文件是 GBK 编码,将抛出同名异常。修复方案是在 read_csv 中指定 encoding='gb18030':
import pandas as pd

# 修复 Pandas 中文读取报错
df = pd.read_csv('sales_data.csv', encoding='gb18030')
print(df.head())
2. pathlib 现代文件读取
使用 pathlib.Path 对象的 read_text() 方法时,同样必须传递 encoding 参数:
from pathlib import Path

p = Path('documents/report.txt')
# 正确:显式指定 UTF-8
text = p.read_text(encoding='utf-8')
五、工程级防御准则:彻底杜绝编码隐患
为了防止编码问题在团队成员之间、本地开发机与线上生产环境之间反复拉扯,应当在工程规范层面落实以下三项防御措施:
- 静态代码检查禁止“裸调 open”:在代码评审(Code Review)或使用 Flake8、Ruff 等 Linter 工具时,强制要求凡是调用
open()、read_text()、read_csv()处,必须显式传递encoding参数。 - 启用 Python 3.7+ 的 UTF-8 Mode(PEP 540):
Python 3.7 引入了 UTF-8 运行模式。在此模式下,即便在中文 Windows 上,Python 也会忽略系统代码页,全局将默认文本编码切换为 UTF-8。可以通过以下方式启用:
- 设置操作系统环境变量:
PYTHONUTF8=1 - 命令行启动时添加参数:
python -X utf8 script.py
- 设置操作系统环境变量:
- 统一持久化规范:在写入文件时同样必须显式指定
encoding='utf-8',从源头杜绝非标文件的产生:# 写入时统一 UTF-8,杜绝给下游埋坑 with open('output.txt', 'w', encoding='utf-8') as f: f.write("保持规范,统一编码")
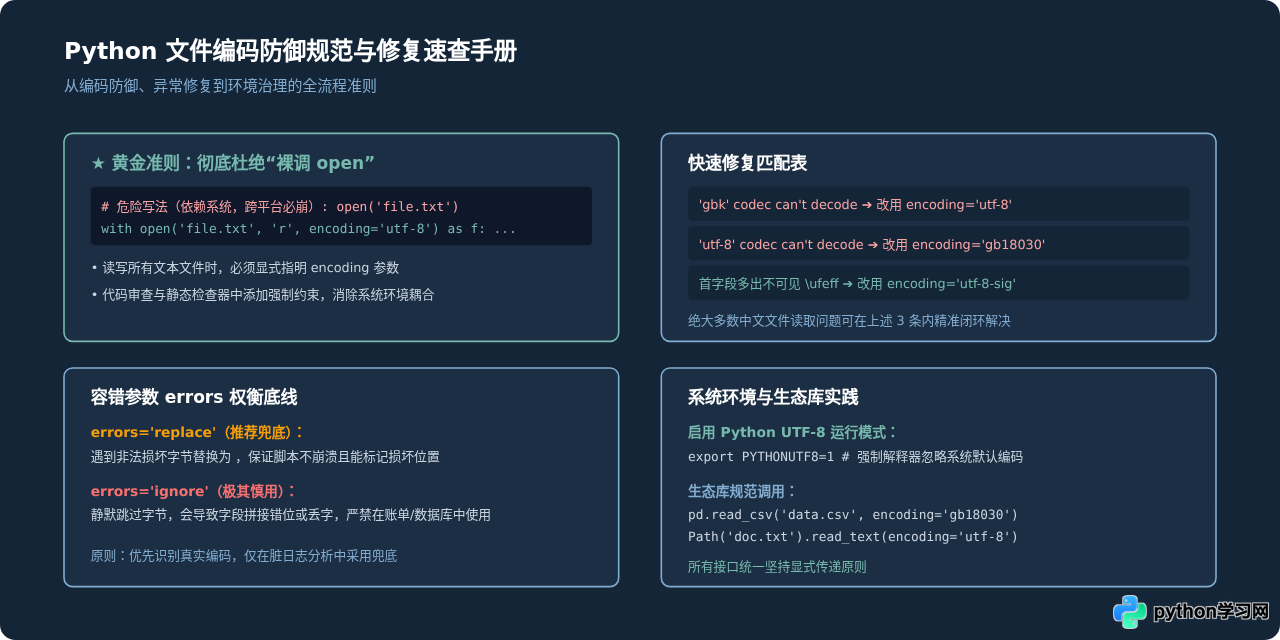
六、总结与速查清单
在 Python 中排查和解决 UnicodeDecodeError,关键在于认清“字节存储”与“解码解释”的分工。只要掌握以下四点,即可从容应对各类中文文件读取问题:
- 不要猜,先看报错:报错信息里标注的 codec 是 Python 当前使用的解码器,报错表明该解码器与文件实际二进制格式产生了冲突。
- 跨平台统一 UTF-8:对于绝大部分现代业务,在
open(..., encoding='utf-8')处显式指定 UTF-8,即可消除因 Windows 默认使用 GBK 造成的跨平台崩溃。 - 遗留数据认准 GB18030:遇到旧版 Windows 导出、Excel 导出的 ANSI/GBK 格式,优先使用
encoding='gb18030',以获得对生僻字、繁体字的最大兼容能力。 - Windows 记事本文档认准 utf-8-sig:如果文本开头出现莫名的
\ufeff或首列字典键匹配失败,改用encoding='utf-8-sig'即可自动剥除 BOM 标记。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















