


Python将列表放入集合报错TypeError:unhashable type怎么解
针对Python中将列表存入集合时触发的TypeError: unhashable type: 'list'报错,深入剖析集合哈希表底层原理与可变对象限制,提供4种典型场景的排查步骤、代码修复方案与全景避坑指南。
set.add([1, 2])、{[1, 2]} 或嵌套列表转集合时,会触发 TypeError: unhashable type: 'list'。根本原因在于 set 基于底层哈希表构建,要求所有元素必须是不可变(Immutable)且可哈希(Hashable)的,而 list 是可变对象。解法分为两种常见业务诉求:若需要将子列表作为一个独立元素存入集合,应将其转换为元组 tuple;若目的是将一个列表内部的元素拆解并去重,应使用 set(my_list) 而非花括号字面量包裹。
一、报错复现与根本原因剖析
在编写 Python 代码进行去重或聚合统计时,许多初学者经常会写出如下代码,随即控制台抛出显眼的类型错误:
# 错误场景 1:误用花括号字面量包裹列表进行去重
numbers = [1, 2, 2, 3]
unique_data = {[numbers]}  # 或者 {numbers}
# 报错:TypeError: unhashable type: 'list'

# 错误场景 2:将列表整体作为元素添加进已有集合
s = set()
s.add([10, 20])
# 报错:TypeError: unhashable type: 'list'

# 错误场景 3:二维列表直接转换为集合
points = [[0, 0], [1, 2], [0, 0]]
unique_points = set(points)
# 报错:TypeError: unhashable type: 'list'
要彻底解决这个问题,需要先弄清楚为什么 Python 规定集合元素必须是“可哈希的”(Hashable)。
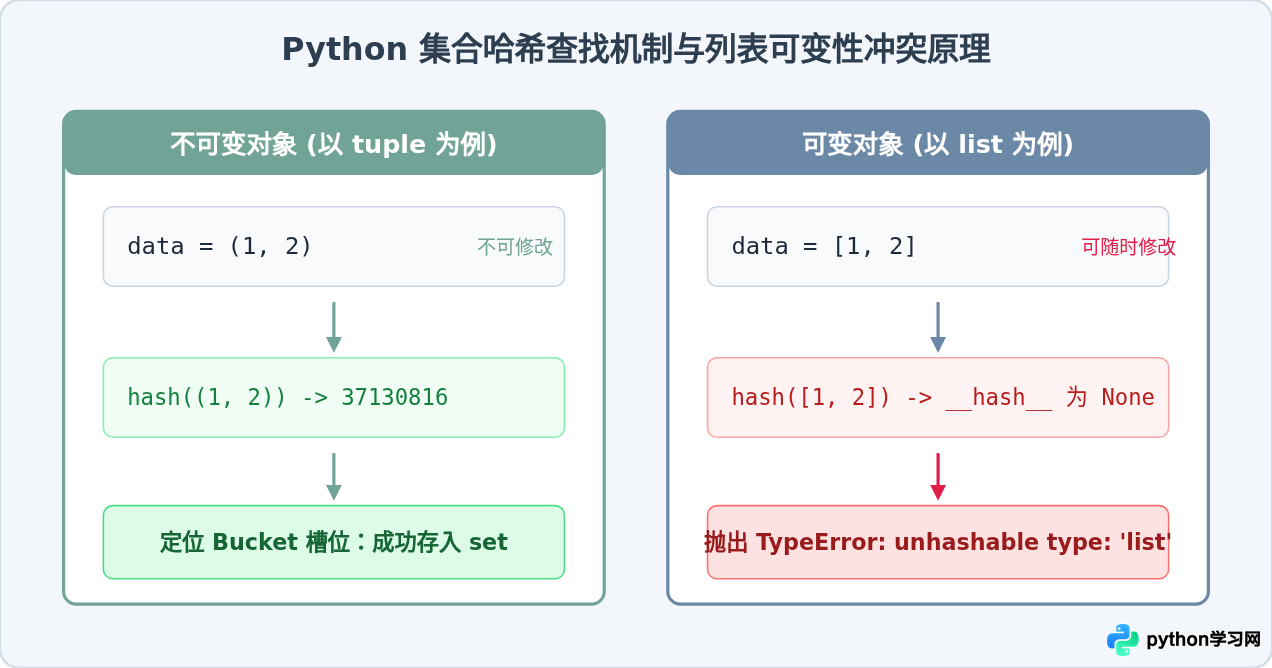
1. 集合的高效定位依赖哈希表
Python 中的 set 和 dict 在底层采用哈希表(Hash Table)实现。当向集合中加入一个元素 x 时,Python 会首先调用内置函数 hash(x) 计算其哈希码(Hash Code),再根据哈希码计算出该元素应该落在内存存储桶(Bucket)的哪一个索引位置。得益于这种机制,集合的元素查找、插入与删除操作平均时间复杂度达到极致的 O(1)。
2. 为什么可变对象(list)不能被哈希?
哈希机制成立的前提是:一个对象在其生命周期内,其哈希值必须保持恒定不变。如果一个对象支持原地修改(例如列表的 append()、pop() 或切片赋值),当列表内部数值改变时,它的逻辑特征已经变化。如果允许对列表计算哈希值,修改后哈希值改变,它在哈希表中的槽位就会错乱,导致集合无法再找到它,集合内元素的唯一性约束也将彻底崩塌。因此,Python 官方在设计底层数据结构时,直接将 list 标记为非可哈希对象,未为其实现 __hash__ 魔术方法。
二、标准排查与修复四步操作流程
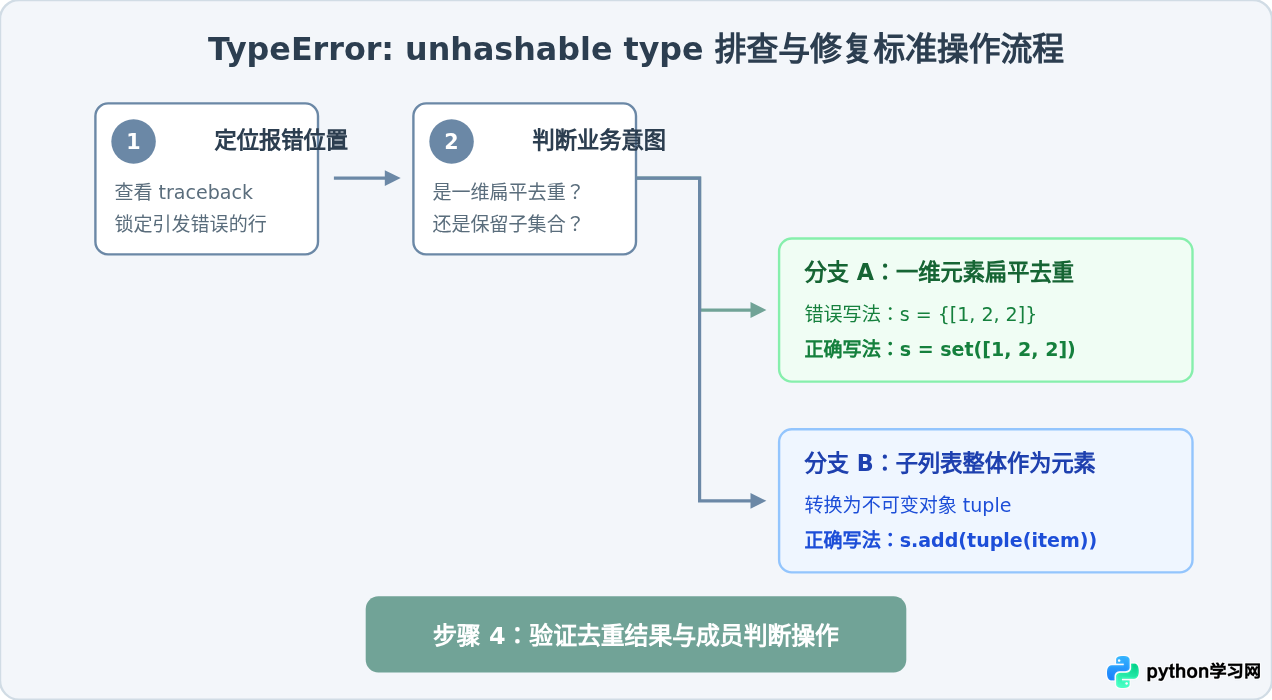
遇到该报错时,不需要盲目修改代码,按照以下四个标准步骤进行定位与修复:
- 定位报错代码行:检查是发生在集合创建表达式
{...}、set(...)构造器中,还是发生在后续的set.add()或set.update()方法调用处。 - 明确业务真实目标:厘清你究竟是想对“列表内的元素”进行去重,还是想把“整个子列表当成一个整体”作为一个集合元素。
- 实施对应代码转换:若是前者,修正为
set(my_list);若是后者,将子列表通过tuple()进行冻结转换。 - 运行验证集合状态:检查输出结果类型是否符合预期,集合大小及去重逻辑是否正确。
三、四大常见应用场景与针对性解法
场景一:单列表去重误写花括号(笔误问题)
在 Python 中,花括号 {...} 用于定义集合字面量。如果你写 {[1, 2, 3]},解释器会理解为“创建一个集合,里面包含一个元素,这个元素是列表 [1, 2, 3]”,而不是“将列表展开去重”。
# 错误示例:
data = [1, 2, 2, 3, 4, 4]
res = {data}  # 报错:TypeError: unhashable type: 'list'

# 正确解法:使用 set() 函数进行类型转换,它会遍历列表内部元素
res = set(data)
print(res)  # 输出示例:{1, 2, 3, 4}

# 若最终仍然需要列表格式:
unique_list = list(set(data))
print(unique_list)  # 输出示例:[1, 2, 3, 4]
场景二:二维列表/多维坐标点去重(将子列表转为元组)
在处理几何坐标、矩阵、图遍历记录路径或 SQL 查询结果时,经常会遇到子元素本身就是列表的情况(如 [[10, 20], [30, 40], [10, 20]])。如果直接调用 set(coordinates),集合在尝试将每个子列表加入哈希桶时依然会报错。
修复方案:利用生成器推导式,在放入集合之前先使用 tuple() 将每个子列表转换为只读元组:
coordinates = [[10, 20], [30, 40], [10, 20], [50, 60]]

# 1. 列表推导式转为包含元组的集合
unique_set = {tuple(pt) for pt in coordinates}
print(unique_set)
# 输出示例:{(10, 20), (30, 40), (50, 60)}

# 2. 如果业务后续必须要求保留子列表格式,再转回列表结构:
restored_list = [list(pt) for pt in unique_set]
print(restored_list)
# 输出示例:[[10, 20], [30, 40], [50, 60]](注意集合无序性)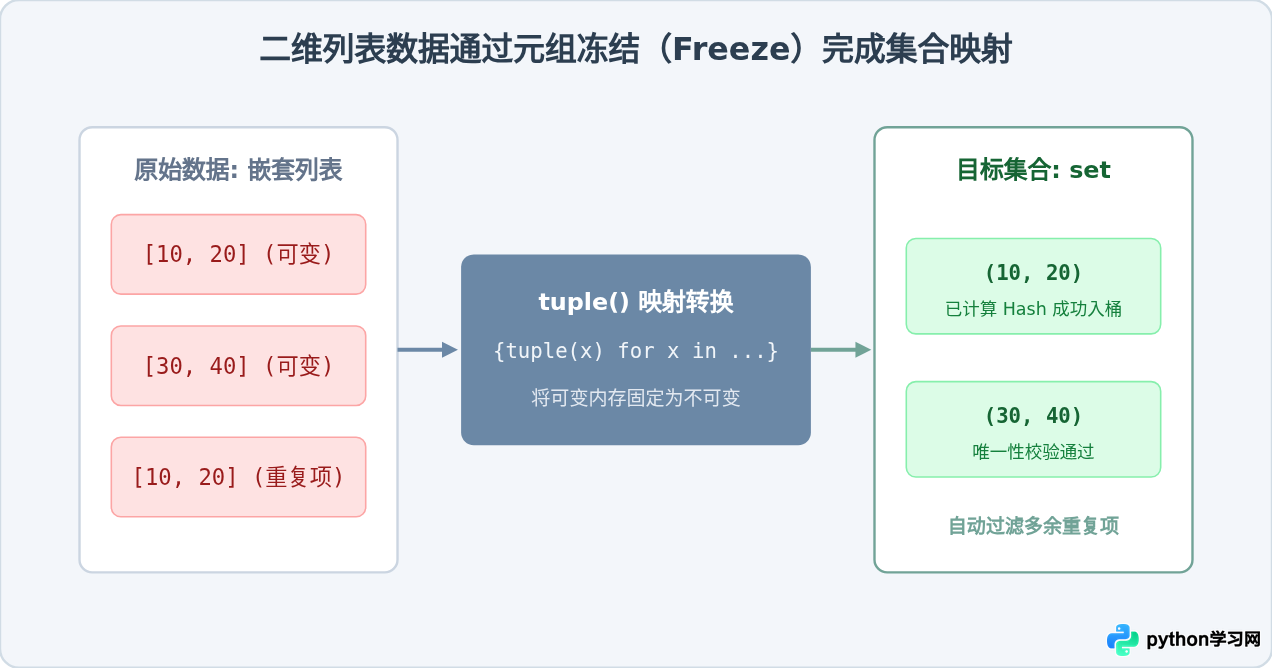
场景三:子项需要集合特性但要存入主集合(使用 frozenset)
如果子项自身需要支持无序去重特性(例如图论中的无向边,(A, B) 和 (B, A) 代表同一条边),但 set 本身也是不可哈希的可变对象。此时直接嵌套 set 会触发同样的错误:TypeError: unhashable type: 'set'。
解决方案:使用 Python 内置的不可变集合 frozenset:
# 业务需求:记录无向图的连通边,消除节点顺序差异并去重
raw_edges = [['node1', 'node2'], ['node2', 'node1'], ['node3', 'node1']]

# 使用 frozenset 包装每一条边
edge_set = set()
for edge in raw_edges:
    edge_set.add(frozenset(edge))

print(edge_set)
# 输出示例:{frozenset({'node1', 'node3'}), frozenset({'node1', 'node2'})}
print(len(edge_set))  # 长度为 2,成功实现无向去重
场景四:去重的同时必须保留列表原始出现顺序
直接使用 set() 进行去重虽然简单高效,但集合是完全无序的,它会打乱原始列表中元素的先后顺序。如果业务场景对顺序有严格依赖(例如日志处理、推荐召回列表),可以借助 Python 3.7+ 字典键保序的特性实现:
raw_sequence = ["apple", "banana", "apple", "cherry", "banana"]

# 传统 set 转换会丢失顺序:
unordered = list(set(raw_sequence))
print(unordered)  # 顺序可能变成 ['cherry', 'apple', 'banana']

# 保持顺序的专业解法:dict.fromkeys()
ordered_unique = list(dict.fromkeys(raw_sequence))
print(ordered_unique) # 稳定输出:['apple', 'banana', 'cherry']dict 保证插入顺序。dict.fromkeys(iterable) 在底层使用与哈希表类似的快速查找完成键去重,同时严格保留首次出现的先后次序,比手写循环判断 if x not in seen(复杂度 O(N^2))要快数十倍。
四、进阶细节与避坑指南
1. 警惕“包含列表的元组”带来的伪不可变性
很多开发者知道元组是不可变的,因此认为只要将外层转为 tuple 就万事大吉。请看以下代码:
# 错误示例:元组内部含有列表
mixed_item = (1, [2, 3])
s = set()
s.add(mixed_item)
# 依然报错:TypeError: unhashable type: 'list'深度原理:元组可哈希的前提是元组内部包含的所有子元素也必须全部是可哈希的。当 Python 计算 hash((1, [2, 3])) 时,会递归计算内部每一个成员的哈希值。一旦遍历到 [2, 3],依旧会由于列表缺失 __hash__ 而抛出异常。彻底解决需要进行深层转换(Deep Freeze):
def deep_freeze(obj):
    """递归将嵌套的列表结构转换为可哈希元组"""
    if isinstance(obj, list):
        return tuple(deep_freeze(x) for x in obj)
    if isinstance(obj, dict):
        return tuple((k, deep_freeze(v)) for k, v in sorted(obj.items()))
    return obj

safe_item = deep_freeze([1, [2, 3], [4, [5, 6]]])
s = {safe_item}  # 顺利通过!
2. 自定义类对象存入集合
如果你编写了一个代表数据的类(例如包含一个内部 tags 列表的商品类),希望放入集合去重,必须显式实现 __hash__ 和 __eq__ 魔术方法,并且在哈希计算中只能使用不可变属性:
class Product:
    def __init__(self, product_id, tags):
        self.product_id = product_id
        self.tags = list(tags)  # 内部包含可变列表

    def __eq__(self, other):
        if not isinstance(other, Product):
            return False
        return self.product_id == other.product_id

    def __hash__(self):
        # 严禁将可变的 self.tags 纳入 hash 计算!
        # 只使用唯一不可变标识进行哈希
        return hash(self.product_id)

p1 = Product(101, ["tagA", "tagB"])
p2 = Product(101, ["tagC"])
product_set = {p1, p2}
print(len(product_set))  # 长度为 1,根据 product_id 成功判定重复
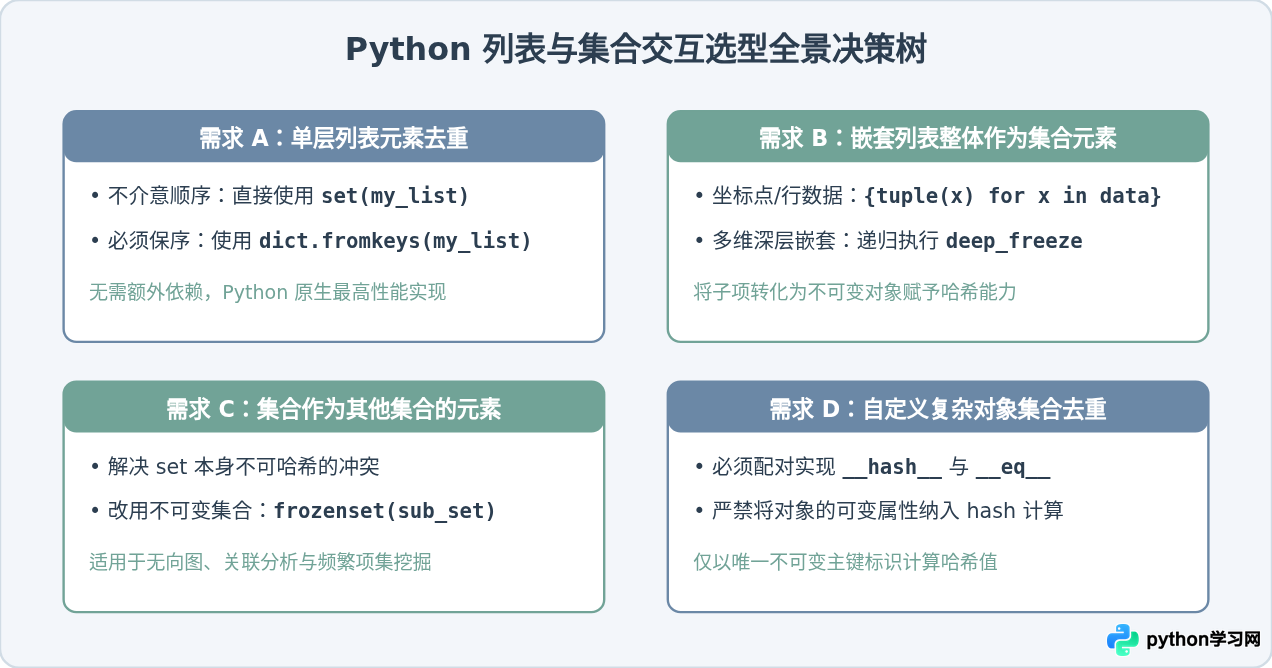
五、全景解决方案对比与选型指南
| 场景需求 | 引发错误的典型代码 | 标准修复写法 | 核心特性与适用边界 |
|---|---|---|---|
| 单列表元素去重 | s = {[1, 2, 3]} |
s = set([1, 2, 3]) |
效率最高(O(N)),但结果无序,元素必须是标量 |
| 多维列表/坐标去重 | set([[1, 2], [3, 4]]) |
{tuple(x) for x in data} |
将子列表冻结为元组,保留行列信息 |
| 集合嵌套集合去重 | set.add({'a', 'b'}) |
set.add(frozenset({'a', 'b'})) |
适用于无序组合、图连通边等复杂关系 |
| 去重且保留原有顺序 | list(set(data)) (丢失顺序) |
list(dict.fromkeys(data)) |
Python 3.7+ 原生支持,兼具保序与高速 O(N) 优势 |
| 深层任意嵌套结构 | tuple([1, [2, 3]]) (内层仍错) |
递归 deep_freeze() |
彻底消除深层包含的任何 list/dict 可变对象 |
六、总结
遇到 TypeError: unhashable type: 'list' 不需要感到困惑,它是 Python 语言层面对哈希表完整性与 O(1) 检索性能的自我保护机制。只要记住核心原则:集合的键必须不可变。在一维去重时使用 set(data) 或 dict.fromkeys(data),在二维或复杂嵌套时使用 tuple() 或 frozenset() 进行不可变化封装,即可优雅解决全部相关报错。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















