


Python从身份证号或日期中提取特定字段:字符串截取实战
本文深入讲解在Python中利用字符串切片与基础处理方法,从18位居民身份证号及标准日期字符串中高效提取出生日期、性别、年份、月份等特定字段的实战技巧与避坑指南。
在日常数据清洗与业务逻辑处理中,身份证号与各类格式化日期是最典型的定长或规范格式文本。解决这类提取需求的核心路径是利用 Python 原生的高性能字符串切片(Slicing)机制,配合索引边界与基础字符串方法,在无需引入第三方库的情况下实现纳秒级的特定字段剥离。本文将系统拆解正负索引的计算规则,深入分析 18 位身份证及多种日期文本的结构,并给出完整的代码实现与工程避坑实践。
一、字符串切片的核心机制与索引映射
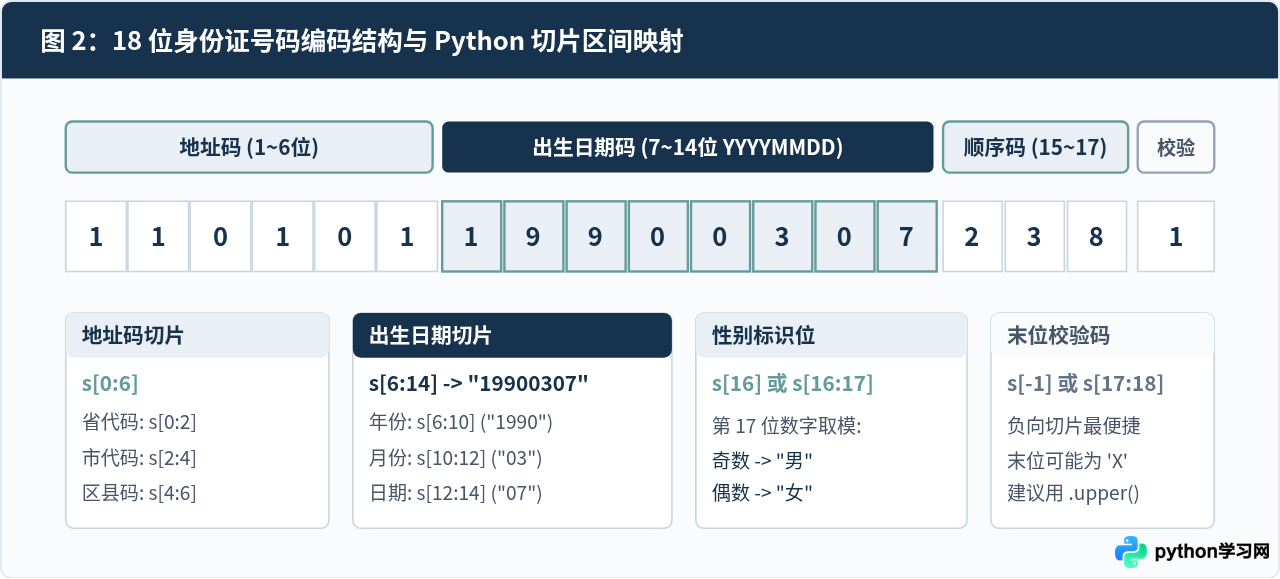
Python 字符串切片语法为 sequence[start:end:step]。要准确截取目标字段,必须牢记其核心逻辑:左闭右开区间 [start, end)。这意味着截取结果包含 start 索引处的字符,但不包含 end 索引处的字符。当省略 step 时,步长默认为 1。
Python 提供两套对称的索引体系:从左往右以 0 开始的正向索引,以及从右往左以 -1 开始的负向索引。在定长字符串中,负向索引极适合用于提取倒数固定的后缀或校验位。
二、18 位二代身份证号码的结构与切片实战
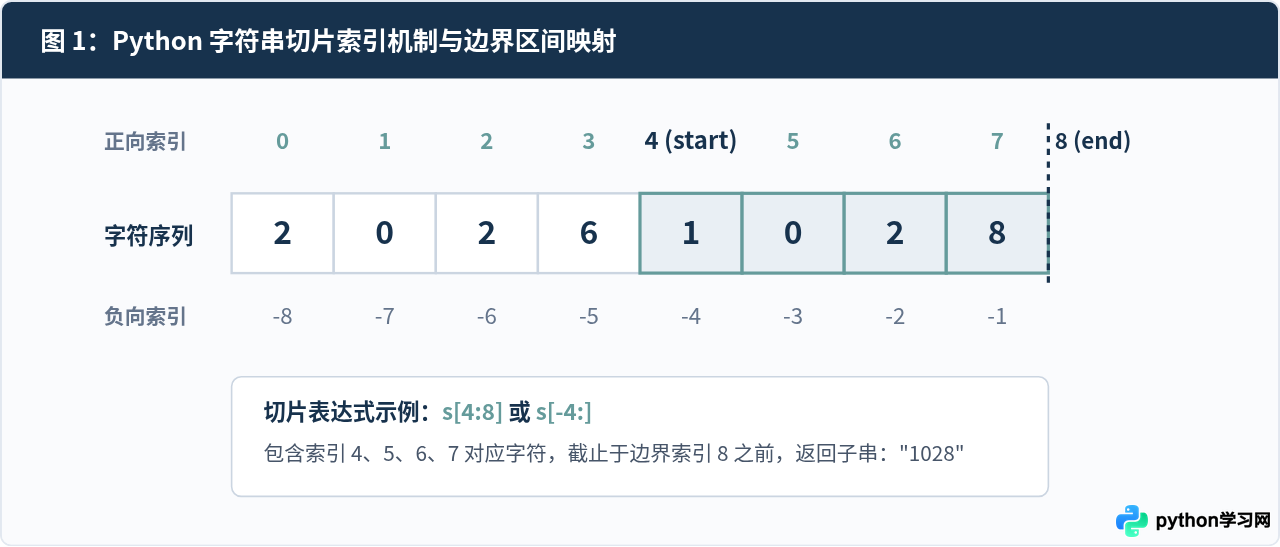
我国现行的第二代居民身份证号码为 18 位定长编码(GB 11643-1999 标准),其每一段位置均具有严格的法定含义:
- 第 1~6 位(索引
0:6):地址码,分别代表省、市、县区。例如前两位代表省份行政区划。 - 第 7~14 位(索引
6:14):出生日期码,格式为严格的YYYYMMDD。 - 第 15~17 位(索引
14:17):顺序码,其中第 17 位(索引16)用于指示性别:奇数为男性,偶数为女性。 - 第 18 位(索引
17:18或-1):校验码,由前 17 位按 ISO 7064:1983.MOD 11-2 计算得出,可能是数字 0~9 或大写字母 X。
下面是一个封装完备的提取函数,输入身份证号码,直接返回结构化字典:
def parse_id_card(id_card: str) -> dict:
    # 基础清洗:去除两端空格并将小写 x 统一转为大写 X
    clean_id = id_card.strip().upper()

    # 长度前置断言
    if len(clean_id) != 18:
        raise ValueError(f"身份证号码长度错误,应为18位,实际为 {len(clean_id)} 位")

    # 1. 提取省份代码 (前2位)
    province_code = clean_id[:2]

    # 2. 提取出生年月日并拼装为标准格式
    birth_year = clean_id[6:10]
    birth_month = clean_id[10:12]
    birth_day = clean_id[12:14]
    birth_date = f"{birth_year}-{birth_month}-{birth_day}"

    # 3. 提取第17位判断性别 (奇数男,偶数女)
    gender_digit = int(clean_id[16])
    gender = "男" if gender_digit % 2 != 0 else "女"

    # 4. 提取末位校验码
    check_code = clean_id[-1]

    return {
        "province_code": province_code,
        "birth_date": birth_date,
        "birth_year": int(birth_year),
        "birth_month": int(birth_month),
        "birth_day": int(birth_day),
        "gender": gender,
        "check_code": check_code
    }

# 执行示例
sample_id = "110101199003072381"
result = parse_id_card(sample_id)
print(result)三、日期时间字符串的特定字段提取
在日志分析与数据处理中,日期时间字符串存在两类典型形态:严格定长格式(如 "2024-10-28 14:30:15" 或紧凑型 "20241028")与变长分隔格式(如 "2024-5-8")。针对不同形态,应采取不同的截取策略。
1. 定长日期字符串:直接切片提取
对于符合 ISO 8601 标准的 YYYY-MM-DD HH:MM:SS(固定 19 位字符),字符坐标完全固定,切片是性能最高的方式:
datetime_str = "2024-10-28 14:30:15"

year = datetime_str[:4]         # "2024"
month = datetime_str[5:7]       # "10"
day = datetime_str[8:10]        # "28"
date_part = datetime_str[:10]   # "2024-10-28"
time_part = datetime_str[11:]   # "14:30:15"
hour = datetime_str[11:13]      # "14"
minute = datetime_str[14:16]    # "30"
second = datetime_str[17:19]    # "15"

print(f"日期: {date_part}, 年: {year}, 月: {month}, 日: {day}, 时间: {time_part}")2. 变长或未知补零日期:split() 与切片协同
当月份或日期未补零(例如 "2024-1-8" 或 "2024/5/12")时,硬编码切片索引会导致错位。此时应先使用 split() 分隔符拆分,再通过 zfill(2) 进行标准化补齐:
def normalize_and_extract(date_text: str, sep: str = "-") -> dict:
    parts = date_text.strip().split(sep)
    if len(parts) != 3:
        raise ValueError(f"日期格式不符合预期: {date_text}")

    year = parts[0]
    month = parts[1].zfill(2)  # 补充前导零
    day = parts[2].zfill(2)
    return {"standard_date": f"{year}-{month}-{day}", "year": year, "month": month, "day": day}

print(normalize_and_extract("2024-5-8"))四、字段提取操作的标准流程
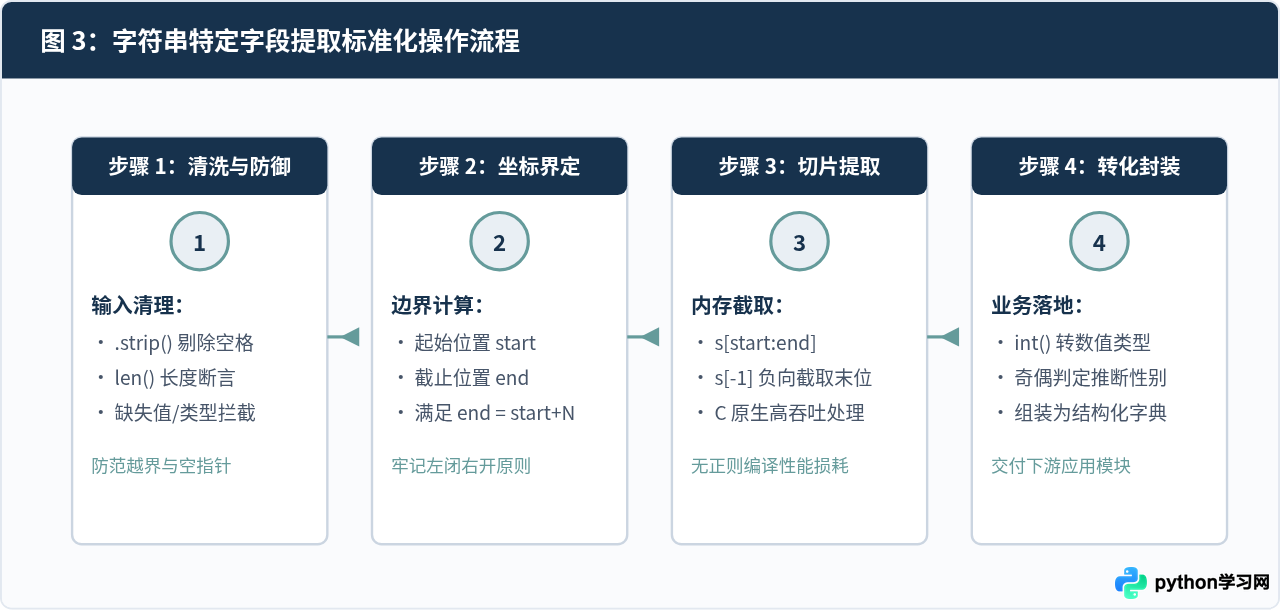
在工业级批量数据处理中,单纯调用切片极易因异常数据崩溃。标准的操作流程应包含前置清洗、长度验证、切片截取和业务逻辑推导四个阶段:
五、常见问题与技术选型决策
在实际工程中,许多初学者容易忽视切片的容错特性与性能边界:
Python 单个索引取值(如
s[18])在越界时会抛出 IndexError,但切片操作(如 s[6:14])在字符串长度不足时绝不报错,而是静默返回空字符串或不完整截取。例如对长度仅 10 位的错误串执行 s[6:14] 仅能得到 4 个字符。因此,在切片前必须显式执行 len() 校验。
Python 字符串属于不可变对象。切片操作会生成全新的字符串对象。虽然在小数据量下微秒即可完成,但在数十亿行级别的大数据处理中,如果只需要判断性别,应直接通过
s[16] 取单字符比较,避免创建多余的中间切片。
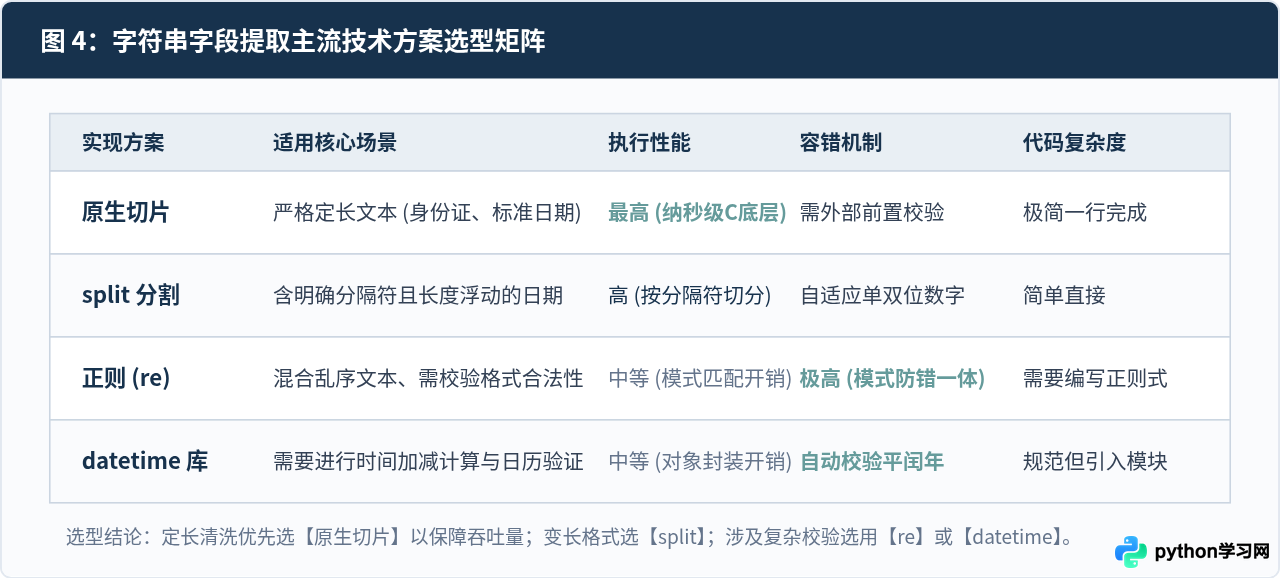
为了在工程开发中合理选择技术方案,下图对比了常用文本提取工具在场景、效率和容错度上的综合表现:
六、总结
从身份证号或日期字符串中提取目标字段,是 Python 基础语法在实际业务中的经典应用。通过掌握 [start:end] 的左闭右开特性,我们能够利用 s[6:14] 精准抽取出生年月日,利用 s[16] 解析性别,利用 s[-1] 快速捕获校验位。在工程落地时,始终铭记“先清洗校验长度、再执行坐标切片、最后转换业务类型”的防御性编程规范,即可构建出兼具极高运行效率与稳健容错能力的数据提取流水线。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















