


解决Python新手常见的缩进错误与编码问题
针对Python新手常见的缩进错误(IndentationError、Tab与空格混用)与文本编码问题(UnicodeDecodeError、跨平台默认编码差异、终端乱码),系统剖析底层机制、提供具体的排查流程、编辑器标准化配置与防御性代码写法。
一、深入解析Python缩进错误(IndentationError)
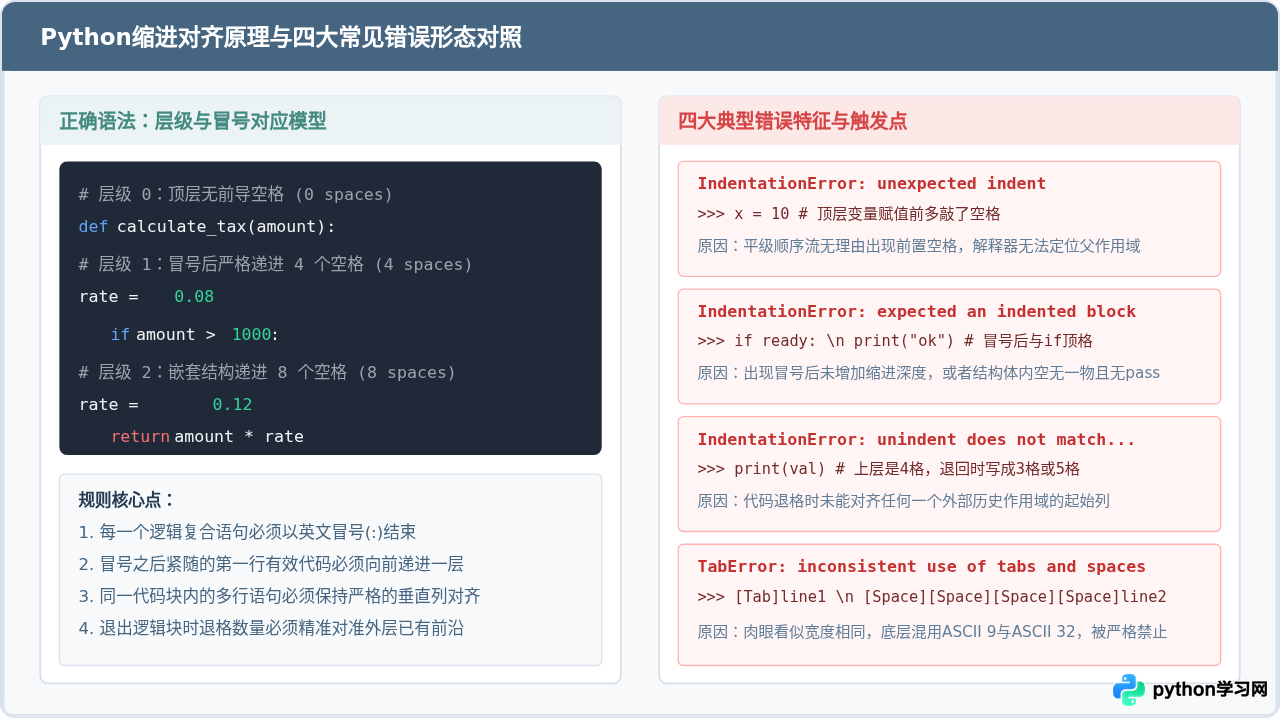
与C、C++、Java或JavaScript等依赖大括号 {} 划定代码块边界的编程语言不同,Python在语法设计中彻底舍弃了大括号与起始关键字,直接使用“严格对齐的前导空白字符”来声明逻辑层级与代码归属。这种设计使得代码排版直接参与编译器解析,一旦空格数量出现细微出入,解释器便无法推断语句之间的上下级关系,从而抛出 IndentationError 或 TabError。
1. 常见缩进报错形态与触发场景
-
IndentationError: unexpected indent(意外出现的缩进):通常发生在不应当缩进的位置出现了空格。例如在模块顶层(顶级作用域)编写常规顺序语句时,或者在平铺的赋值语句、import语句前不小心按入了空格。 -
IndentationError: expected an indented block(缺少必要的缩进块):当定义了带有冒号:的复合语句(如if、for、while、def、class、try)后,紧随其后的下一行未能提供比上一行更深层级的缩进,或者该逻辑块内容完全为空且未填入pass占位符。 -
IndentationError: unindent does not match any outer indentation level(退格无法匹配任何外层缩进级别):当前行向前回退缩进时,其前导空格数量未能与之前的任何一个外层代码块左边距完全对齐(例如外层是4个空格,当前退格行只留了3个或2个空格)。 -
TabError: inconsistent use of tabs and spaces in indentation(制表符与空格混用):在同一个代码文件或同一个逻辑块内,部分行使用了Tab制表符(ASCII 9),另一部分行使用了空格(ASCII 32)。虽然许多文本编辑器在视觉上将Tab渲染为4个空格的宽度,但在Python 3词法解析器眼中,它们是截然不同的字符,直接禁止混用。
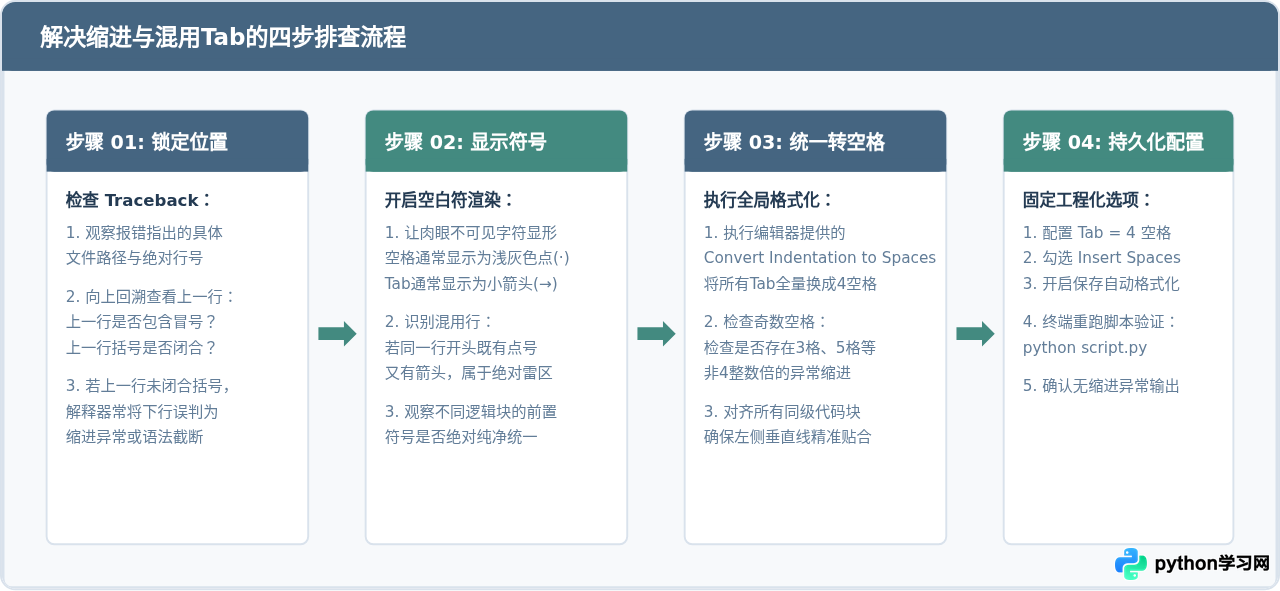
二、缩进错误的四步排查流程与IDE标准化配置
当终端抛出缩进报错时,许多新手倾向于随手增减空格,这种盲目调试往往会导致同文件其他代码块连锁报错。正确的排查流程应当遵循“查明行号 → 显示不可见字符 → 统一替换为4空格 → 配置持久化校验”四个阶段。
2. 主流编辑器的关键设置项
为了从根本上避免再次踩坑,应当在开发环境中锁定缩进规则。以目前使用率最高的 Visual Studio Code 与 PyCharm 为例:
-
VS Code 设置:
- 快捷键按下
Ctrl + Shift + P(macOS 为Cmd + Shift + P),输入Convert Indentation to Spaces并回车,将当前文件中的所有制表符转为标准空格。 - 打开设置(Settings),搜索
Editor: Insert Spaces,确保其勾选(为true),这意味着每次按下键盘上的 Tab 键,编辑器都会自动输入4个真实空格,而非写入 ASCII 9。 - 搜索
Editor: Tab Size,明确设定为4。 - 搜索
Editor: Render Whitespace,将其由默认的selection改为boundary或all,使前置空白符清晰可见。
- 快捷键按下
-
PyCharm 设置:
- 依次进入
File -> Settings -> Editor -> Code Style -> Python。 - 在
Tabs and Indents面板中,确保勾选Use tab character处于未选中状态,同时将Tab size与Indent均固定为4。 - 进入
Editor -> General -> Appearance,勾选Show whitespaces。
- 依次进入
三、深入解析Python编码问题(Encoding & Decoding)
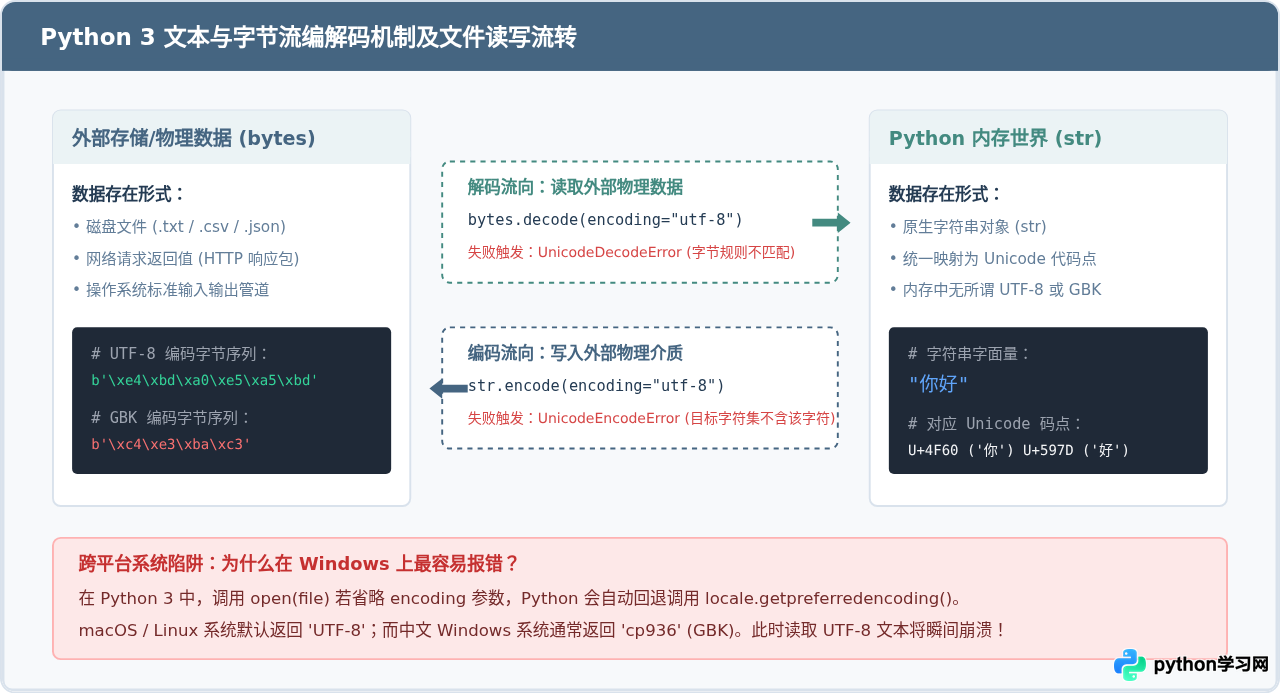
在Python 3中,字符模型做出了重大升级:内存中的文本被统一表示为 Unicode 字符序列(即 str 类型),而外部存储、网络传输、终端输出所处理的则是物理的二进制字节流(即 bytes 类型)。
两者的桥梁是编解码器:将抽象文本转换为物理字节流的操作称为编码(encode);将外部读取的物理字节流还原为内存文本的操作称为解码(decode)。绝大多数编码问题,都是因为在解码或编码时指定了错误的字符映射表。
1. 常见的编码报错表现
-
UnicodeDecodeError: 'utf-8' codec can't decode byte ... in position ...: invalid start byte
这是最典型的解码异常。说明你正在让Python使用 UTF-8 规则去解释一段并非以 UTF-8 编码保存的字节流(例如目标文件是以 GBK、ANSI 格式保存,或者文件头部损坏)。 -
UnicodeDecodeError: 'gbk' codec can't decode byte ... in position ...: illegal multibyte sequence
这多发生在 Windows 环境下,由于没有在open()中显式指定编码,Python 使用了系统默认的 GBK 编码器试图去读取标准的 UTF-8 文件,遇到多字节中文时直接报错。 -
UnicodeEncodeError: 'gbk' codec can't encode character '\u2022' ...
发生在试图将包含特殊字符(如生僻字、特定Unicode标点、Emoji)的字符串写入 GBK 编码的文件,或者通过print()输出到 GBK 编码的 Windows 终端命令行时,由于 GBK 字符集容量有限,无法表达该字符。 -
SyntaxError: Non-UTF-8 code starting with ... in file ...
Python 3 源码文件默认必须以 UTF-8 格式存储。如果使用某些旧式编辑器(如 Windows 记事本的 ANSI 模式)保存了带有中文注释的.py文件,解释器在读取脚本时便会直接拒绝执行。
四、编码问题的标准解决方案与防御性写法
解决编码问题的核心哲学是:永远显式声明,绝不依赖操作系统的隐式默认值。在工程实践中,遵循以下三条防御性编码规范,可以彻底杜绝 99% 的编码错误。
1. 规范一:文件读写必须显式指定 encoding="utf-8"
初学者最容易写出的“脆弱代码”就是直接调用 open("data.txt")。即使这行代码在开发者的 macOS 笔记本上能正常读取,一旦打包部署到客户的中文 Windows 电脑上,就会由于默认 cp936 而立即崩溃。
# ❌ 危险写法:依赖平台环境默认编码
with open("article.txt", "r") as f:
    content = f.read()

# ✅ 标准防御性写法:显式指定 UTF-8 编码
with open("article.txt", "r", encoding="utf-8") as f:
    content = f.read()

# ✅ 写入文件同样必须指明编码
with open("output.txt", "w", encoding="utf-8") as f:
    f.write("写入包含中文的内容与特殊字符 • ✓")
2. 规范二:处理不可靠外部数据时的降级策略
在爬虫抓取、日志解析或处理历史遗留数据时,外部文件可能混杂了损坏字节或不规则字符集。此时若强制解码失败,可根据业务容忍度使用 errors 参数或编码探测工具:
# 场景 A:容忍微量破损数据,忽略无法解析的字节
with open("dirty_data.log", "r", encoding="utf-8", errors="ignore") as f:
    text = f.read()

# 场景 B:保留异常位置标记,将无法解析的字节替换为占位符(如 )
with open("legacy_data.txt", "r", encoding="utf-8", errors="replace") as f:
    text = f.read()

# 场景 C:面对未知文件,先读取二进制流并进行编码自动嗅探
# 安装:pip install charset-normalizer
import charset_normalizer

with open("unknown_file.txt", "rb") as f:
    raw_bytes = f.read()
    detection = charset_normalizer.from_bytes(raw_bytes).best()
    if detection:
        content = str(detection)
        print(f"探测到文件编码: {detection.encoding}")
3. 规范三:配置系统级与运行期 UTF-8 模式
对于频繁在 Windows 控制台或跨环境运行 Python 脚本的开发者,可以通过环境配置将 Python 切换至强制 UTF-8 模式:
-
开启 Python UTF-8 模式:在环境变量中设置
PYTHONUTF8=1,或者在执行命令时增加-X utf8参数(例如python -X utf8 script.py)。开启后,Python 3.7+ 会忽略系统的locale设置,强制让open()默认采用 UTF-8。 -
Windows 终端编码切换:在 Windows CMD 或 PowerShell 中运行命令前,执行
chcp 65001将当前控制台活动代码页直接切换为 UTF-8,避免print()打印中文时出现乱码。 -
确保文件无 BOM:现代文本编辑器保存 UTF-8 时,请选择“UTF-8 without BOM”(无签名 UTF-8),避免文件开头产生
\ufeff字节影响某些解析工具。
五、缩进与编码问题防范与速查总结
为了帮助读者建立稳固的肌肉记忆与快速排查参照,下表总结了日常开发中最核心的关注项对照:
| 问题维度 | 典型错误场景 | 根本原因 | 一招解决的根本方法 |
|---|---|---|---|
| 代码缩进 | IndentationError: unexpected indent |
无逻辑分支的顶层语句前敲入了空格 | 删除顶层多余空白符,对齐左侧边界 |
| 代码缩进 | IndentationError: expected an indented block |
函数/循环/判断语句冒号后未增加缩进 | 冒号下一行缩进4空格,暂无内容写 pass |
| 代码缩进 | TabError: inconsistent use of tabs and spaces |
从外部复制的代码混杂了Tab与空格 | IDE全局执行 Convert Indentation to Spaces |
| 文本编码 | UnicodeDecodeError: 'utf-8' codec... |
用UTF-8解析了GBK格式的历史文件 | 核对源文件编码,改用 encoding="gbk" |
| 文本编码 | UnicodeDecodeError: 'gbk' codec... |
Windows系统 open() 默认使用了 cp936 |
任何 open() 显式声明 encoding="utf-8" |
| 脚本解析 | SyntaxError: Non-UTF-8 code... |
脚本存盘编码为ANSI且包含中文注释 | IDE将源码保存编码重置为 UTF-8 无BOM |
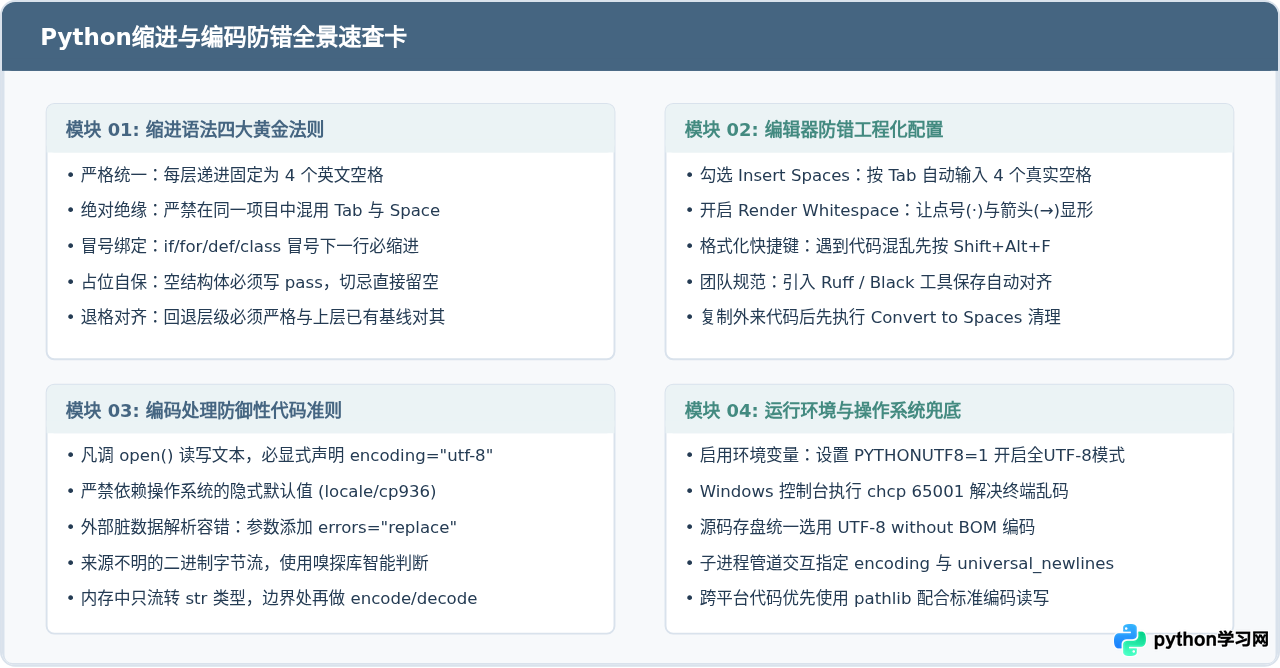
encoding="utf-8" 的条件反射,初学者就能完全摆脱这两类报错的困扰,专注于核心业务逻辑的构建。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















