


Python串口通信中中文乱码与二进制数据解析
深入讲解Python串口通信中中文乱码的产生机理与彻底解决方法,并针对工业与嵌入式场景中的二进制数据流,详细演示帧定界、粘包拆包与struct模块解析的完整实战方案。
struct 模块的高效解析实践。
一、串口中文乱码的成因与传输机制
串口(UART)在物理层面上是典型的流式字节传输通道(Byte Stream)。操作系统驱动和 pyserial 库向应用程序暴露的接口,始终是原生的 bytes 序列。Python 3 严格区分了内存中的字符抽象(Unicode str)与原始字节流(bytes)。当上位机尝试通过串口接收或发送中文文本时,乱码通常源于以下两个层面的问题:
- 字符编码集不匹配: 下位机硬件(如 STM32、ESP8266 或早期嵌入式系统)通常默认采用 GB2312、GBK 或 GB18030 编码,而 Python 3 默认或常规代码常常采用 UTF-8 进行解码。当把 GBK 编码的双字节中文字符强行按 UTF-8 解码时,由于 UTF-8 的前导字节特征位校验失败,解释器会立即抛出
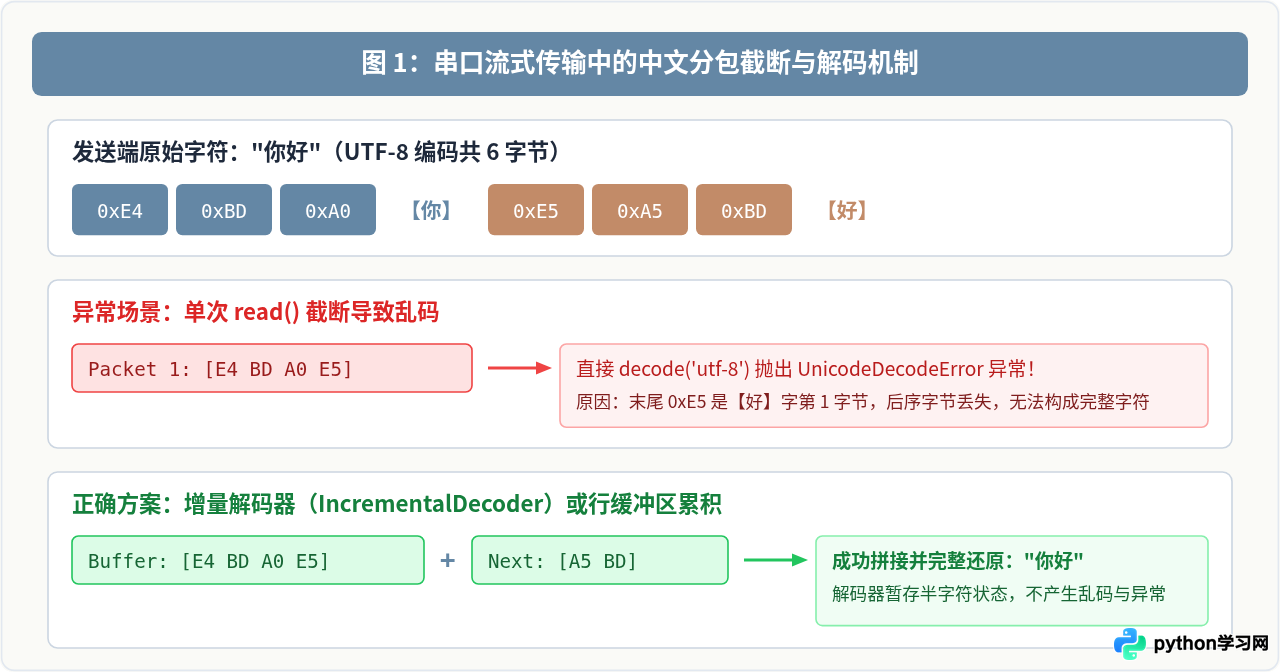
UnicodeDecodeError。 - 流式分包截断(关键陷阱): UTF-8 中一个汉字通常占 3 个字节,GBK 中一个汉字占 2 个字节。串口接收数据是异步且分块到达的。如果在某一时刻,串口缓冲区恰好只读到了一个中文字符的前 1 个或前 2 个字节,此时若直接调用
data.decode('utf-8'),就会因为末尾存在不完整的字节序列而报错。如果盲目使用errors='ignore'或errors='replace',就会丢弃关键字节或将其显示为问号(?)与“锟斤拷”等乱码。
二、中文乱码系统排查流程与工程解法
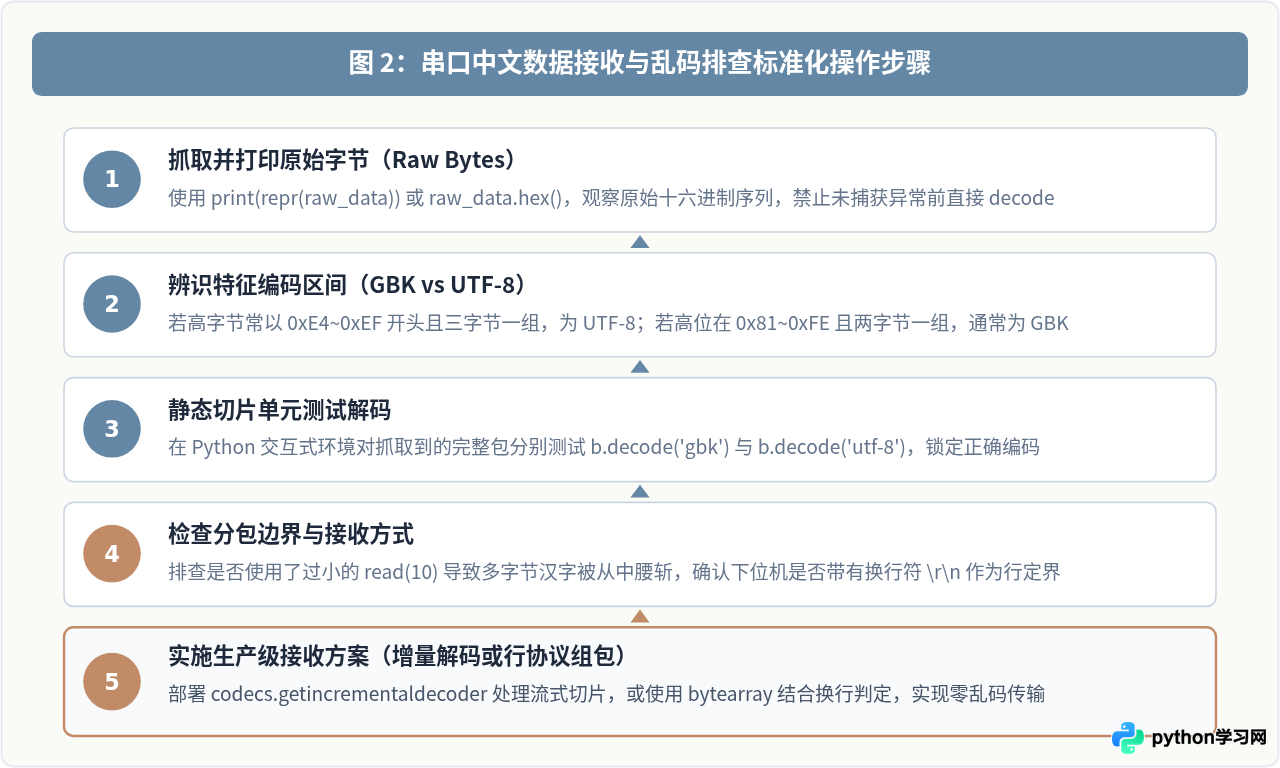
当我们在终端看到 \xe4\xbd 等十六进制打印或 UnicodeDecodeError 时,应遵循清晰的排查路径,切忌盲目添加 replace 参数。
解决中文乱码的标准代码实践
针对流式切片问题,Python 标准库 codecs 提供了 IncrementalDecoder(增量解码器)。它能自动在内部缓存未满足多字节长度的半字符残片,等到下一个数据包到达后合并解码,彻底解决分包截断报错:
import serial
import codecs

def run_serial_text_reader():
    # 配置串口参数,建议设定合理超时时间(单位:秒)
    ser = serial.Serial(port='COM3', baudrate=115200, timeout=1.0)

    # 获取对应编码的增量解码器(如果硬件是GBK,则换为 'gbk')
    # final=False 允许处于不完整字节状态而不报错
    decoder = codecs.getincrementaldecoder('utf-8')(errors='replace')

    print("开始监听串口文本数据...")
    try:
        while True:
            # 即使单次读取字节数很小,甚至只有 1 个字节,也不会导致多字节字符损坏
            chunk = ser.read(ser.in_waiting or 1)
            if chunk:
                # 增量解码并输出,末尾残留的不完整字节会自动留在解码器对象内部
                text = decoder.decode(chunk, final=False)
                if text:
                    print(text, end='', flush=True)
    except KeyboardInterrupt:
        print("\n监听已停止。")
    finally:
        ser.close()
三、二进制数据流:协议帧设计与粘包拆包
在传感器采集、电机控制等实时控制场景中,下位机发送的通常不是文本字符串,而是由高低字节、十六进制状态字和浮点数紧密排列的二进制数据流。
二进制数据不能使用 readline() 或按换行符切分,因为浮点数或整型数值的某一个字节本身的值可能恰好就是 0x0A(换行符 \n)或 0x00。如果不加区分地当成文本行切分,会产生严重的灾难性误判。
标准二进制帧结构设计
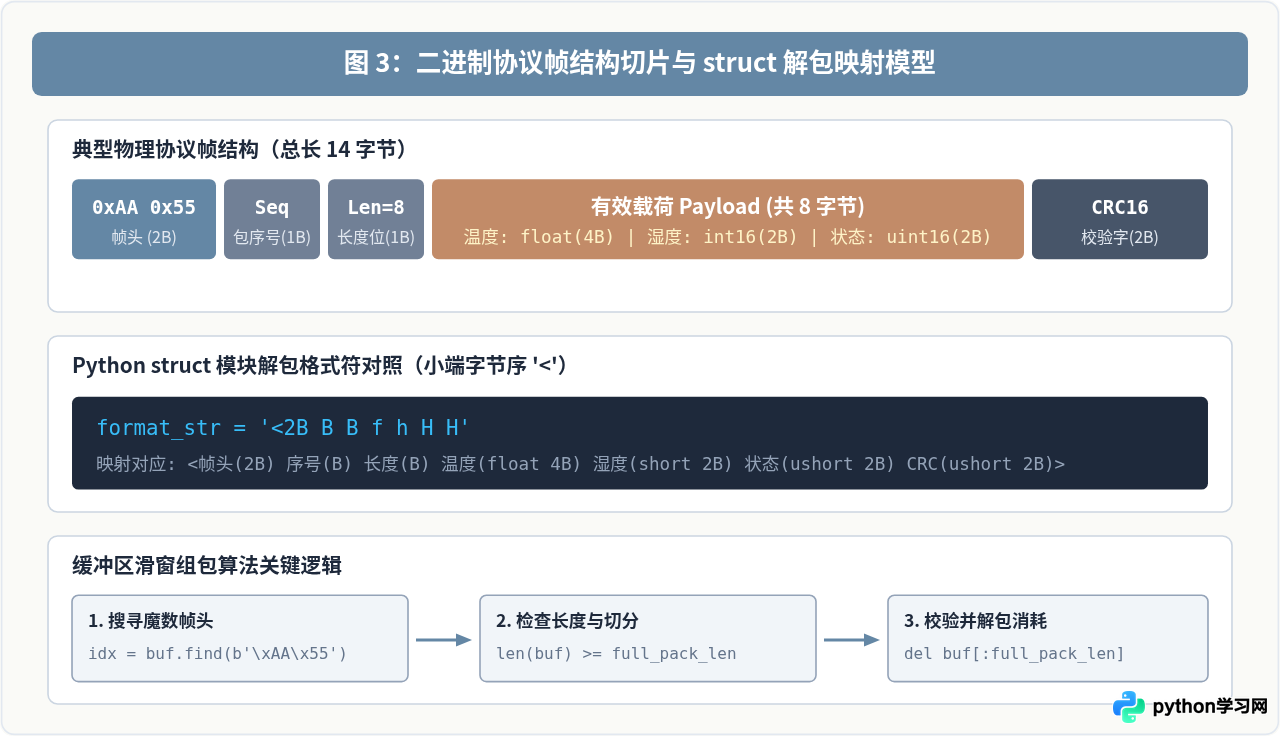
为了在不规则的串口流中精准定位并提取每个独立的业务包,工业级协议都会采用明确的定界帧结构:
- 帧头(Header / Magic): 2 个固定魔数字节,例如
0xAA 0x55,用于在数据流中寻找包的起始点。 - 序列号/包ID(Seq ID): 1 字节,用于检测丢包。
- 有效载荷长度(Length): 1 字节,指明后续载荷数据的字节数,让解析器知道何时收齐数据。
- 载荷内容(Payload): 核心数据,例如 4 字节温度浮点数、2 字节湿度整数、2 字节状态码。
- 校验码(Checksum / CRC16): 1~2 字节,验证数据在电气传输中是否受到干扰产生翻转。
四、使用 struct 模块深度解析多字节二进制数据
Python 标准库中的 struct 模块是处理 C 语言原生二进制内存块的利器。它提供了在 Python 值(数字、字符串)与 C 语言结构体表示的二进制字节流之间相互转换的能力。
核心格式控制符与字节序
| 格式字符 | C 语言类型 | Python 类型 | 标准字节大小 |
|---|---|---|---|
< / > |
无(修饰符) | 前缀:< 表示小端(Little-Endian),> 表示大端(Big-Endian) |
0 |
B / b |
unsigned char / signed char | int(0~255 / -128~127) | 1 |
H / h |
unsigned short / signed short | int(双字节整型) | 2 |
I / i |
unsigned int / signed int | int(4 字节整型) | 4 |
f |
float | float(IEEE 754 单精度浮点数) | 4 |
d |
double | float(IEEE 754 双精度浮点数) | 8 |
STM32、x86 等常见 CPU 架构均采用小端模式(低位字节存放在低地址)。如果在格式字符串中漏掉了
< 前缀,Python 会使用系统原生对齐规则,不仅可能按大端解析导致数值翻转数万倍,还会引入 C 语言默认的内存对齐填充(Padding Bytes),破坏精确按字节切分的协议。
工业级二进制通信接收与解析完整代码
以下代码演示了一个生产环境可直接复用的接收器:使用 bytearray 作为接收滑动窗口,能完美应对串口的“半包”(数据未收全)和“粘包”(两个包同时读出)问题。
import serial
import struct

def parse_serial_binary_stream():
    ser = serial.Serial(port='COM4', baudrate=115200, timeout=0.1)

    # 动态字节缓冲区
    rx_buffer = bytearray()

    FRAME_HEADER = b'\xAA\x55'
    # 帧结构: 帧头(2) + 序号(1) + 长度(1) + 载荷(8) + CRC16(2) = 14 字节
    PACKET_SIZE = 14
    # 解包格式: 小端,2个无符号字符、1个字符、1个字符、1个单精度浮点、1个短整型、1个无符号短整型、1个校验无符号短整型
    UNPACK_FORMAT = '<2B B B f h H H'

    print("开始监听二进制串口遥测流...")
    try:
        while True:
            # 1. 尝试从串口读取所有已到的原始字节,追加到接收缓冲区
            waiting_bytes = ser.in_waiting
            if waiting_bytes > 0:
                rx_buffer.extend(ser.read(waiting_bytes))

            # 2. 在缓冲区中循环检索有效数据帧
            while True:
                # 寻找帧头魔数
                header_index = rx_buffer.find(FRAME_HEADER)

                # 如果找不到帧头,但缓冲区已有数据,仅保留最后 1 个字节防备魔数被腰斩
                if header_index == -1:
                    if len(rx_buffer) > 1:
                        del rx_buffer[:-1]
                    break

                # 如果帧头不在起始位置,说明前面是噪声或脏数据,直接切除丢弃
                if header_index > 0:
                    del rx_buffer[:header_index]

                # 3. 检查当前缓冲区长度是否足够一个完整包
                if len(rx_buffer) < PACKET_SIZE:
                    # 长度不足,跳出内部循环,继续等待串口数据接收
                    break

                # 提取完整帧候选切片
                candidate_frame = rx_buffer[:PACKET_SIZE]

                # 4. 执行解包
                unpacked = struct.unpack(UNPACK_FORMAT, candidate_frame)
                h1, h2, seq, payload_len, temp, humidity, status_code, crc_val = unpacked

                # 简易校验和计算验证(示例:前面12字节的和对 0xFFFF 取模)
                calc_crc = sum(candidate_frame[:12]) & 0xFFFF
                if calc_crc == crc_val:
                    # 校验成功,提取业务数据
                    print(f"[帧 #{seq:03d}] 温度: {temp:.2f} ℃, 湿度: {humidity/10.0:.1f} %, 状态码: 0x{status_code:04X}")
                    # 从缓冲区消费掉这一个完整包
                    del rx_buffer[:PACKET_SIZE]
                else:
                    # 校验失败说明可能是伪帧头,切除帧头的第一个字节,继续往后寻找
                    print(f"CRC 校验失败!丢弃伪帧头 (收到: {crc_val:#x}, 计算: {calc_crc:#x})")
                    del rx_buffer[:1]

    except KeyboardInterrupt:
        print("\n监听已安全终止。")
    finally:
        ser.close()
五、常见问题与工程最佳实践总结
在实际联调过程中,软硬件双方经常会因为理解偏差导致通信失败。以下整理了四条最易踩坑的核心防线与排查决策树:
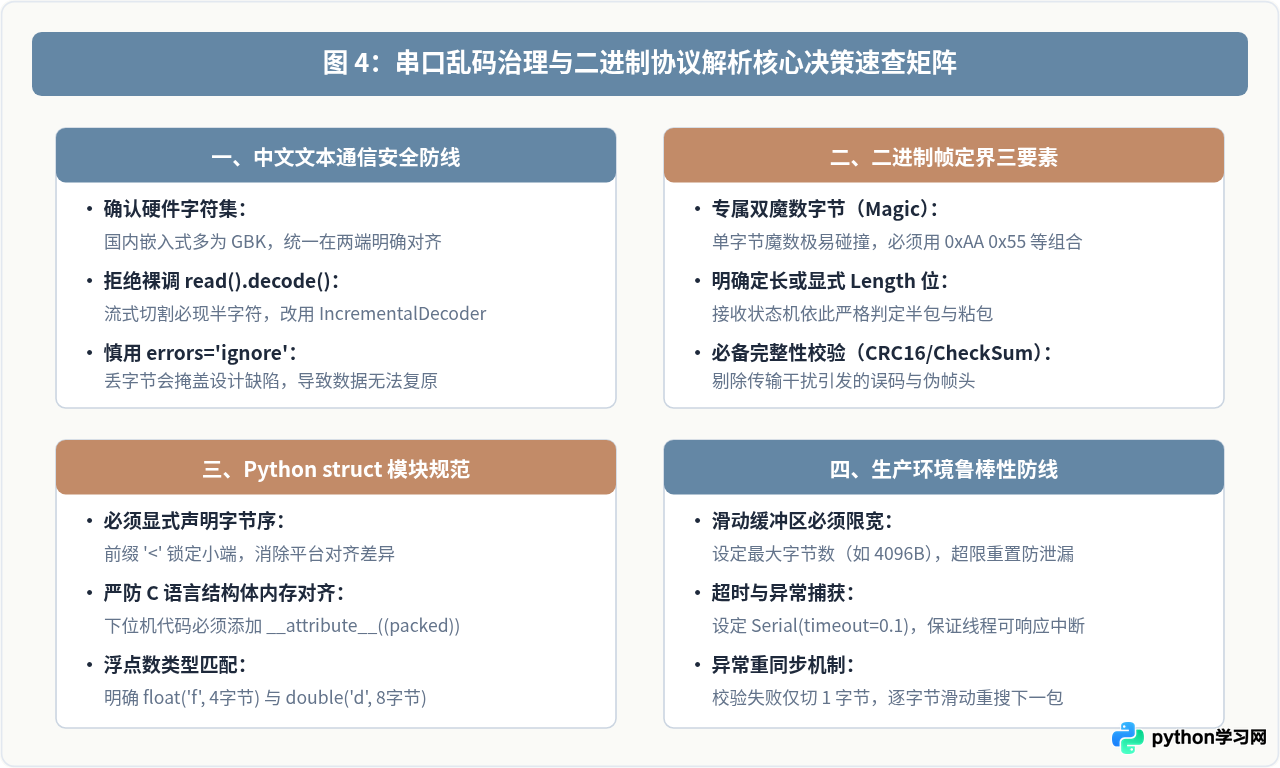
综上所述,串口通信并不神秘,其稳定性的核心在于尊重底层字节流传输客观规律:处理中文文本时,通过识别编码集并配合增量解码器,根除字符切断导致的乱码;处理二进制数据时,通过设计包含魔数帧头与长度位的规整协议帧,结合 bytearray 动态滑窗与 struct 模块,便能构建出高吞吐、零漏帧且强抗干扰的工业级通信程序。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















