


Python WSGI服务器内存占用过高怎么解决?
针对Python WSGI服务器(如Gunicorn、uWSGI)进程内存只增不减、内存占用过高甚至触发系统OOM Killer的问题,从排查定位、Worker回收策略、内存分配器替换到代码层治理提供系统化解决方案。
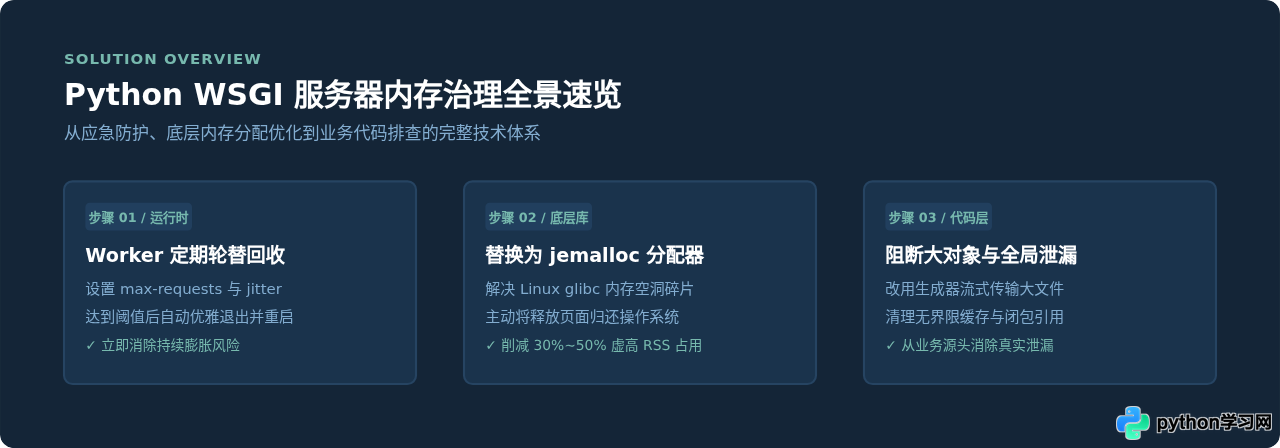
在生产环境中,Python WSGI 服务器(如 Gunicorn、uWSGI)随请求量累积常出现工作进程内存只增不减、最终引发宿主机 OOM 崩溃的现象。解决这一问题的核心路径包括三项措施:配置 Worker 进程的平滑轮替回收机制(限制单进程最大请求数)、使用 jemalloc 替换 glibc malloc 抑制内存碎片与高水位空洞,以及在代码层面消除全局对象缓存与大响应全量加载。
一、现象与根因:为什么 WSGI 内存只升不降?
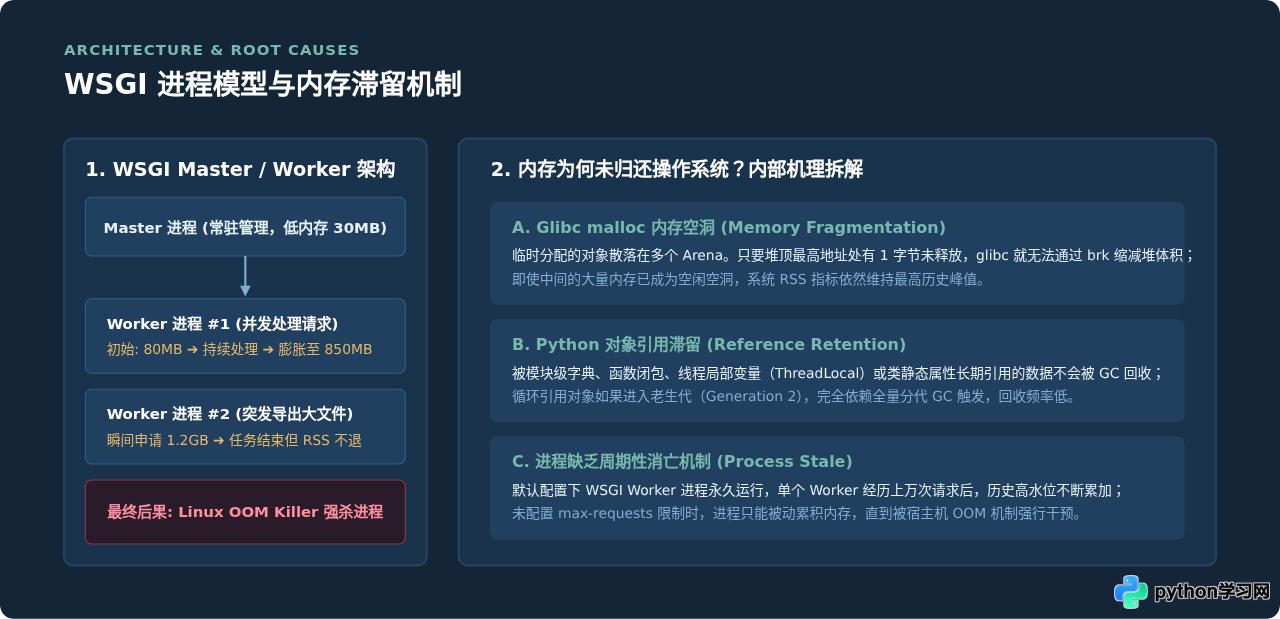
假设你的生产 API 运行在 Gunicorn 或 uWSGI 之上,刚启动时每个工作进程(Worker)仅消耗 80MB 内存。然而随着连续处理数千个 HTTP 请求,Worker 进程的常驻内存(RSS)逐渐攀升至 800MB 甚至数 GB,即使外部流量回落到零,内存也不会下降。当节点总可用内存被耗尽时,操作系统的 Linux OOM Killer 会强制终止关键服务进程。
在 Python WSGI 架构中,Worker 内存居高不下通常由以下三种相互叠加的机制所致:
- Linux 默认内存分配器(glibc malloc)的内存碎片与内存空洞: Python 内部的
pymalloc负责小对象(≤512字节)分配,大对象则通过系统标准malloc申请。当突发请求分配大量临时内存后,虽然 Python 的垃圾回收器释放了对象,但 glibc 由于堆顶存在未释放的块,无法执行brk缩容,或者未能触发madvise(MADV_DONTNEED),导致空闲内存停留在进程的 Arena 中,操作系统视角下的 RSS 内存依然维持在历史最高峰。 - 真性内存泄漏(Memory Leaks): 代码中存在长生命周期对象引用短生命周期数据,例如模块级全局字典缓存、未显式关闭的数据库连接/ORM 会话、被循环引用且重写了
__del__的孤儿对象,或 C 扩展库(如某些图像处理、科学计算库)申请的堆内存未正确释放。 - 请求边界与响应缓冲不当: 导出大 Excel、生成大报表或处理几十兆文件上传时,视图函数将所有数据一次性读入字节串(
bytes),瞬间将 Worker 内存顶上极高水位,从而把整个进程的常驻基线锁定在高位。
二、排查四步法:精确定位内存泄漏点
在着手改动配置或重构代码之前,必须先通过数据指标区分“真性内存泄漏”与“内存分配器碎片假象”。
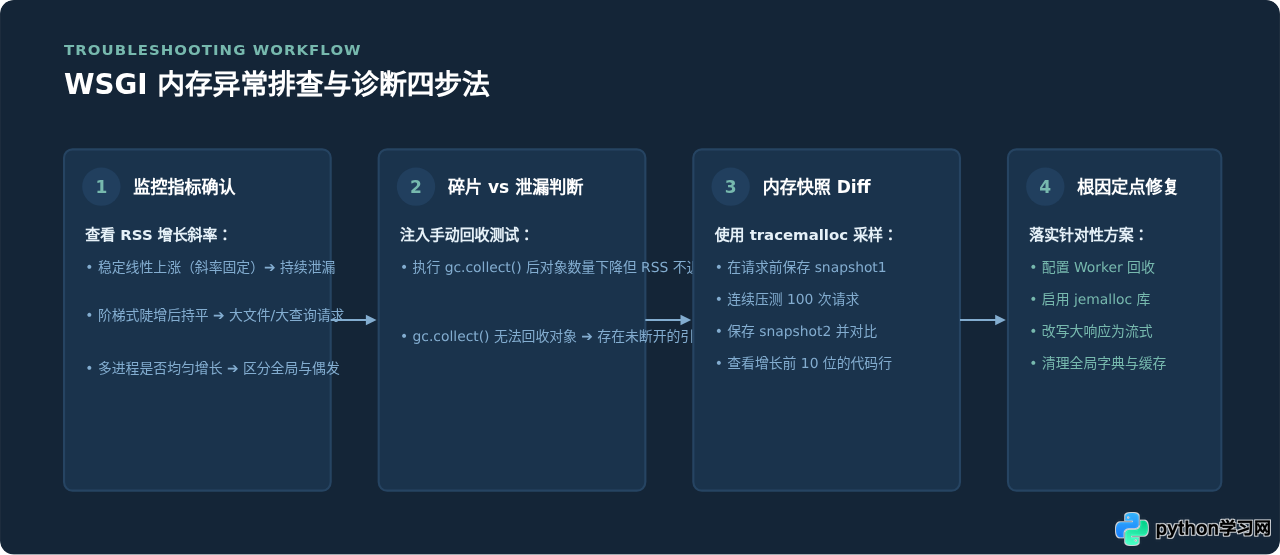
步骤一:使用 tracemalloc 捕获内存增量快照
Python 标准库内置了 tracemalloc 模块,能够追踪分配内存的具体代码行与调用栈。在开发或预发环境中,可以通过简单的中间件或调试端点,对处理前后进行快照对比(Diff):
import tracemalloc

# 在应用启动初期尽早开启追踪
tracemalloc.start(25)  # 保存深度为 25 层的调用栈

# 在两次请求之间捕获快照并对比
snapshot_before = tracemalloc.take_snapshot()

# ... 触发目标业务接口或执行压测 ...

snapshot_after = tracemalloc.take_snapshot()

# 过滤并比对增量最大的前 10 行代码
top_stats = snapshot_after.compare_to(snapshot_before, 'lineno')

print("[ 内存净增量 Top 10 代码调用点 ]")
for stat in top_stats[:10]:
    print(stat)
运行输出示例中,若某行代码持续贡献数百兆的 size_diff,即可直接将排查范围缩小至特定函数(例如某处解析大 JSON 或累积日志的列表)。
三、运行时治理:配置 Worker 进程主动回收(最快止血方案)
在生产事故中,重构业务代码和寻找隐蔽泄漏点往往需要较长时间。最有效、最成熟的应急与兜底手段是配置 WSGI 服务器的主动回收机制:让 Worker 在处理一定数量的请求或达到指定内存上限后,优雅退出并由 Master 进程重新拉起新 Worker。
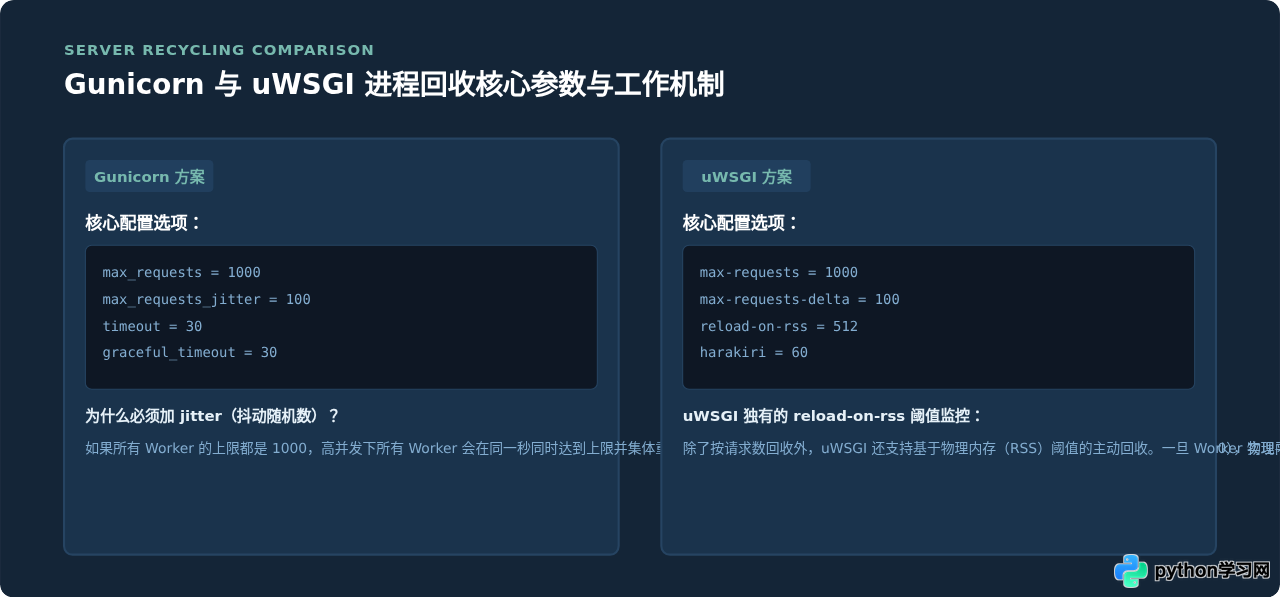
1. Gunicorn 生产级配置示范
在项目的 gunicorn.conf.py 中配置以下参数:
# gunicorn.conf.py
bind = "0.0.0.0:8000"
workers = 4
worker_class = "sync"

# 关键参数:单个 worker 处理 1000 个请求后自动重启
max_requests = 1000

# 关键参数:添加 0~100 的随机抖动区间(实际每个 worker 重启阈值为 1000~1100 次)
# 防止流量洪峰时所有工作进程同时重启
max_requests_jitter = 100

# 优雅退出超时时间,确保当前请求完整处理完毕
graceful_timeout = 30
timeout = 60
2. uWSGI 生产级配置示范
若使用 uWSGI,可以在 uwsgi.ini 中增加请求计数限制与内存硬指标上限:
[uwsgi]
module = myapp.wsgi:application
master = true
processes = 4
threads = 2

# 处理满 1000 次请求后重启进程
max-requests = 1000
# 为每个 worker 设置差异化步长,避免同时重启
max-requests-delta = 100

# 内存阈值回收:当 worker 常驻内存(RSS)超过 512MB 时自动重启
reload-on-rss = 512

# 僵死超时(秒):请求耗时超过 60 秒强制杀掉 worker,释放被挂起的内存
harakiri = 60
harakiri-verbose = true
四、分配器优化:使用 jemalloc 根治 Linux 内存碎片
许多团队在开启了 max_requests 之后,发现内存依然在很短的时间内飙到很高,甚至单进程在几百次请求内就占满内存。这通常不是 Python 代码本身的泄漏,而是 Linux 默认的 glibc malloc 内存分配机制在面对多线程/高并发时产生的 Arena 内存碎片与内存空洞。
glibc malloc 会为每个核心创建多个内存分配区(Arena),但在小对象频繁申请与销毁时,堆顶空洞会导致内存无法交还给 Linux 内核。业界标准的解决方案是使用 jemalloc 代替 glibc malloc。
jemalloc 采用了分级 Chunk/Slab 算法与更精细的脏页回收策略(积极使用 MADV_DONTNEED),对多线程高并发下的 Python 进程尤其友好。生产实测表明,在不改动任何 Python 代码的情况下,仅通过 LD_PRELOAD 加载 jemalloc,即可将 WSGI 进程在请求峰值后的常驻 RSS 降低 30% 至 50%。
在宿主机或 Docker 镜像中启用 jemalloc
安装与引入 jemalloc 非常轻量,不需要重新编译 Python 解释器:
# 1. 在 Ubuntu/Debian 基础镜像或服务器中安装
apt-get update && apt-get install -y libjemalloc-dev libjemalloc2

# 2. 通过环境变量注入预加载库(推荐在 Dockerfile 中设置)
ENV LD_PRELOAD="/usr/lib/x86_64-linux-gnu/libjemalloc.so.2"

# 3. 配置 jemalloc 脏页清除策略(每产生 10 块脏页主动向操作系统释放)
ENV MALLOC_CONF="background_thread:true,dirty_decay_ms:10000,muzzy_decay_ms:10000"

# 4. 正常启动你的 WSGI 服务器
CMD ["gunicorn", "-c", "gunicorn.conf.py", "myapp.wsgi:application"]
五、代码层根治:避免常见内存反模式
在完成运行时与底层分配器的加固后,若依然存在明显的线性泄漏,则必须定位并清理业务代码中的反模式。常见的陷阱及优化方法如下:
1. 杜绝模块级全局字典作为“临时缓存”
许多开发者喜欢在全局作用域声明一个 cache = {} 存放请求临时数据或用户 Token,却没有设置过期淘汰策略。这会导致全局字典无限膨胀。必须使用带有大小限制与过期机制的缓存容器(如 cachetools.LRUCache)或外部 Redis:
# ❌ 错误示范:无限膨胀的全局变量
GLOBAL_REQUEST_CACHE = {}

def handle_user(user_id, data):
    GLOBAL_REQUEST_CACHE[user_id] = data  # 永久滞留在内存,永不释放


# ✔️ 正确示范:使用固定容量的 LRU 缓存,或使用 Redis
from cachetools import LRUCache

# 严格限制最多保存 2000 个键,超出时自动淘汰最久未访问的对象
SAFE_CACHE = LRUCache(maxsize=2000)

def handle_user_safe(user_id, data):
    SAFE_CACHE[user_id] = data
2. 大文件与大报表导出:改用生成器流式响应
在导出几十万行 Excel 或几百兆 CSV 时,严禁使用 data = query.all() 并一次性生成完整的字节流返回。应利用 WSGI 的生成器机制(StreamingHttpResponse 或 Flask 的 Response(stream_with_context(...)))分批产出数据:
# 以 Django 为例:流式输出 CSV 避免将全量内容塞入内存
import csv
from django.http import StreamingHttpResponse

class Echo:
    """定义一个仅实现 write 方法的仿文件对象,供 csv_writer 写入"""
    def write(self, value):
        return value

def generate_csv_rows(query_set):
    pseudo_buffer = Echo()
    writer = csv.writer(pseudo_buffer)
    yield writer.writerow(['ID', '用户名', '注册时间'])

    # 使用 iterator() 逐批从数据库取回,避免一次性生成数万个 ORM 对象
    for user in query_set.iterator(chunk_size=1000):
        yield writer.writerow([user.id, user.username, user.created_at])

def export_users_view(request):
    users_qs = User.objects.all().order_by('id')
    response = StreamingHttpResponse(
        generate_csv_rows(users_qs),
        content_type="text/csv"
    )
    response['Content-Disposition'] = 'attachment; filename="users.csv"'
    return response
六、长效监控与长治久安:全景治理闭环
解决 WSGI 内存问题不能依靠单点技巧,而应构建覆盖运行前防护、运行时回收、代码层优化与持续度量的长效闭环。
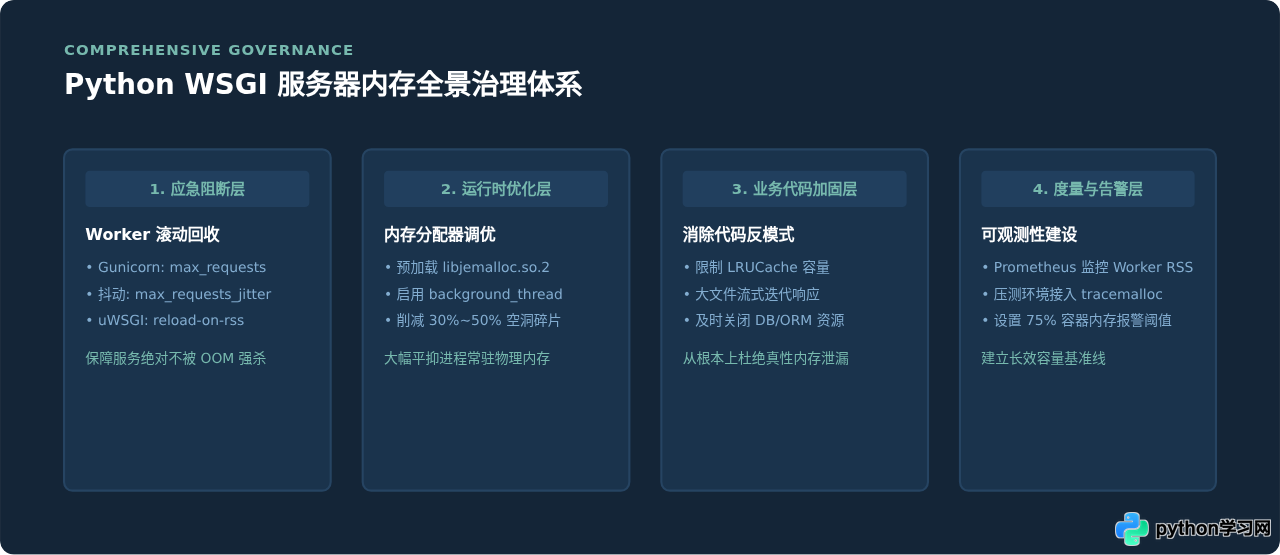
| 治理措施 | 适用组件 | 预期成效 | 实施成本 |
|---|---|---|---|
| 配置 max-requests + jitter | Gunicorn / uWSGI | 杜绝单进程长期占用累计,平滑轮替 | 低(修改配置文件即刻生效) |
| 接入 libjemalloc | Linux / Docker 运行时 | 消除 glibc 堆内存空洞,降低 30%~50% RSS | 低(增加环境变量预加载) |
| 基于 RSS 阈值重启 | uWSGI (reload-on-rss) | 超出设定内存阈值时精准回收 | 低(仅限 uWSGI) |
| 大响应流式改造 | Django / Flask / FastAPI | 消除大报表/大文件上传下载时的内存瞬间峰值 | 中(改写业务视图函数) |
| tracemalloc 差异比对 | Python 诊断与测试 | 定位深层代码与第三方 C 扩展泄漏源 | 中(需要压测重现配合) |
综上所述,面对 WSGI 服务器内存暴涨问题,先在配置文件中加入 max_requests 与随机抖动 避免线上宕机;紧接着在运行时引入 jemalloc 解决内存空洞;最后借助 tracemalloc 配合流式重构,清理代码中积存的大对象与全局缓存,即可从根本上保证 Python Web 服务的长期稳健运行。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















