


Python经典算法实现:排序、搜索及常见数据结构代码示例
系统梳理Python中经典排序算法、搜索算法及常见底层数据结构的完整代码实现与原理解析,包含冒泡、快速、归并排序、二分搜索、链表、栈、队列及二叉搜索树的详细示例。
掌握算法与数据结构是编写高效、可维护Python程序的基石。虽然Python标准库提供了内置的 sorted()、list、dict 和 collections 等高性能封装,但手动实现底层结构与经典算法不仅是理解运行原理的必经之路,也能让开发者在面对复杂业务场景与性能瓶颈时做出更合理的选型与定制设计。本文围绕经典基础数据结构、排序算法、搜索算法展开,提供可直接运行的代码示例与工程要点说明。
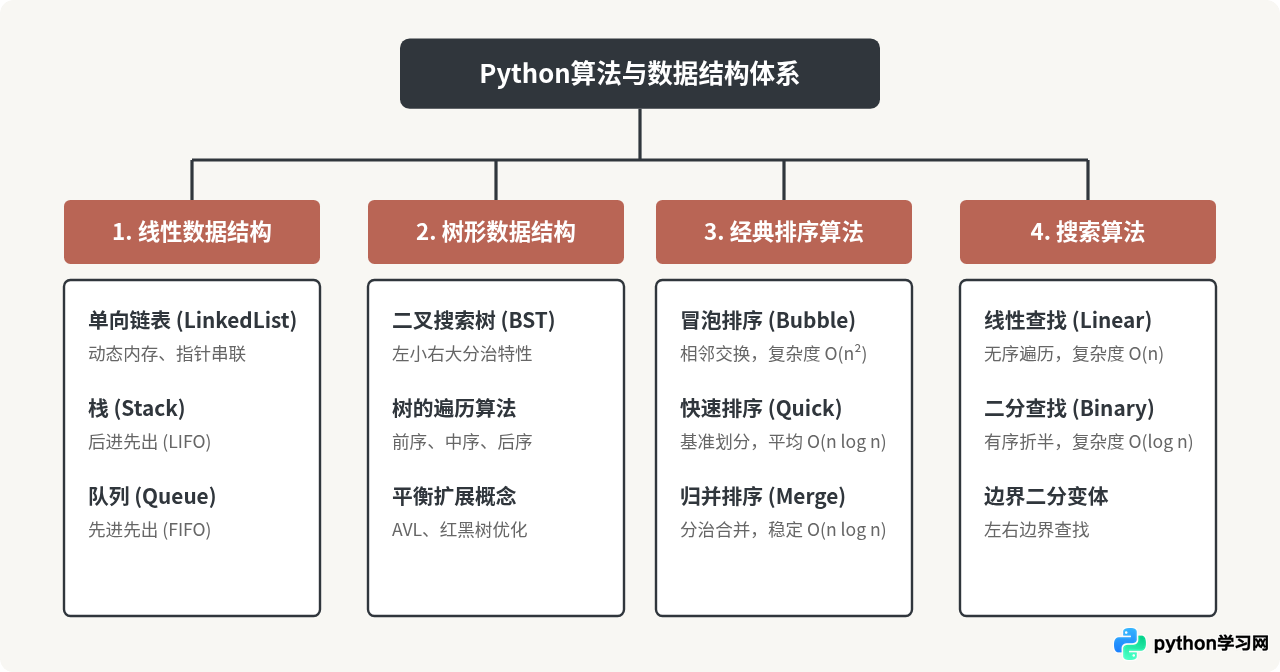
一、常见数据结构及其Python原生实现
数据结构是组织和存储数据的方式。虽然Python内置的列表(list)功能强大,但其底层是动态数组。在频繁进行头部插入或删除操作时,时间复杂度为 \(O(n)\)。通过类定义节点指针,我们可以构建出链表、栈、队列以及二叉树。
1. 单向链表(Singly Linked List)
单向链表由一系列节点组成,每个节点包含数据区与指向下一节点的指针。链表在内存中不需要连续空间,在已知位置插入和删除的复杂度为 \(O(1)\),但随机访问的时间复杂度为 \(O(n)\)。
class Node:
    """链表节点定义"""
    def __init__(self, val=0, next_node=None):
        self.val = val
        self.next = next_node

class LinkedList:
    """单向链表实现"""
    def __init__(self):
        self.head = None

    def append(self, val):
        """在尾部添加节点"""
        new_node = Node(val)
        if not self.head:
            self.head = new_node
            return
        curr = self.head
        while curr.next:
            curr = curr.next
        curr.next = new_node

    def prepend(self, val):
        """在头部添加节点:O(1) 复杂度"""
        new_node = Node(val, self.head)
        self.head = new_node

    def delete(self, val):
        """删除首个匹配值的节点"""
        if not self.head:
            return False
        if self.head.val == val:
            self.head = self.head.next
            return True
        curr = self.head
        while curr.next and curr.next.val != val:
            curr = curr.next
        if curr.next:
            curr.next = curr.next.next
            return True
        return False

    def to_list(self):
        """转为Python列表便于查看"""
        res = []
        curr = self.head
        while curr:
            res.append(curr.val)
            curr = curr.next
        return res

# 示例验证
ll = LinkedList()
ll.append(10)
ll.append(20)
ll.prepend(5)
print("链表现状:", ll.to_list())  # 示例输出: 链表现状: [5, 10, 20]
ll.delete(10)
print("删除10后:", ll.to_list())  # 示例输出: 删除10后: [5, 20]
2. 栈与队列(Stack & Queue)
栈遵循后进先出(LIFO)原则,适用于函数调用栈、括号匹配或撤销操作;队列遵循先进先出(FIFO)原则,常用于任务调度与消息缓冲。在实际工程中,建议使用标准库 collections.deque 实现高效的两端操作,以下展示封装示例:
from collections import deque

class Stack:
    """基于动态数组的栈结构实现"""
    def __init__(self):
        self._items = []

    def push(self, val):
        self._items.append(val)

    def pop(self):
        if self.is_empty():
            raise IndexError("pop from empty stack")
        return self._items.pop()

    def peek(self):
        if self.is_empty():
            return None
        return self._items[-1]

    def is_empty(self):
        return len(self._items) == 0

class Queue:
    """基于双端队列的队列实现,保证入队与出队均为 O(1)"""
    def __init__(self):
        self._items = deque()

    def enqueue(self, val):
        self._items.append(val)

    def dequeue(self):
        if self.is_empty():
            raise IndexError("dequeue from empty queue")
        return self._items.popleft()

    def is_empty(self):
        return len(self._items) == 0

# 示例验证
s = Stack()
s.push(1)
s.push(2)
print("栈顶弹出:", s.pop())  # 示例输出: 栈顶弹出: 2

q = Queue()
q.enqueue("A")
q.enqueue("B")
print("队首出队:", q.dequeue())  # 示例输出: 队首出队: A
3. 二叉搜索树(Binary Search Tree)
二叉搜索树(BST)满足左子树所有节点的值均小于根节点值,右子树所有节点的值均大于根节点值。在平衡状态下,其查找、插入与删除的时间复杂度为 \(O(\log n)\)。中序遍历二叉搜索树可得到升序序列。
class TreeNode:
    def __init__(self, val=0):
        self.val = val
        self.left = None
        self.right = None

class BinarySearchTree:
    def __init__(self):
        self.root = None

    def insert(self, val):
        if not self.root:
            self.root = TreeNode(val)
        else:
            self._insert_node(self.root, val)

    def _insert_node(self, node, val):
        if val < node.val:
            if node.left is None:
                node.left = TreeNode(val)
            else:
                self._insert_node(node.left, val)
        elif val > node.val:
            if node.right is None:
                node.right = TreeNode(val)
            else:
                self._insert_node(node.right, val)

    def inorder_traversal(self):
        """中序遍历:左 -> 根 -> 右,结果按升序输出"""
        res = []
        def _inorder(node):
            if not node:
                return
            _inorder(node.left)
            res.append(node.val)
            _inorder(node.right)
        _inorder(self.root)
        return res

# 示例验证
bst = BinarySearchTree()
for num in [50, 30, 70, 20, 40, 60, 80]:
    bst.insert(num)
print("中序遍历结果:", bst.inorder_traversal())
# 示例输出: 中序遍历结果: [20, 30, 40, 50, 60, 70, 80]
二、经典排序算法实现与对比
排序是计算机科学中最基础的计算任务之一。根据数据规模与内存限制的不同,常用排序算法在时间、空间复杂度与稳定性上各有侧重。
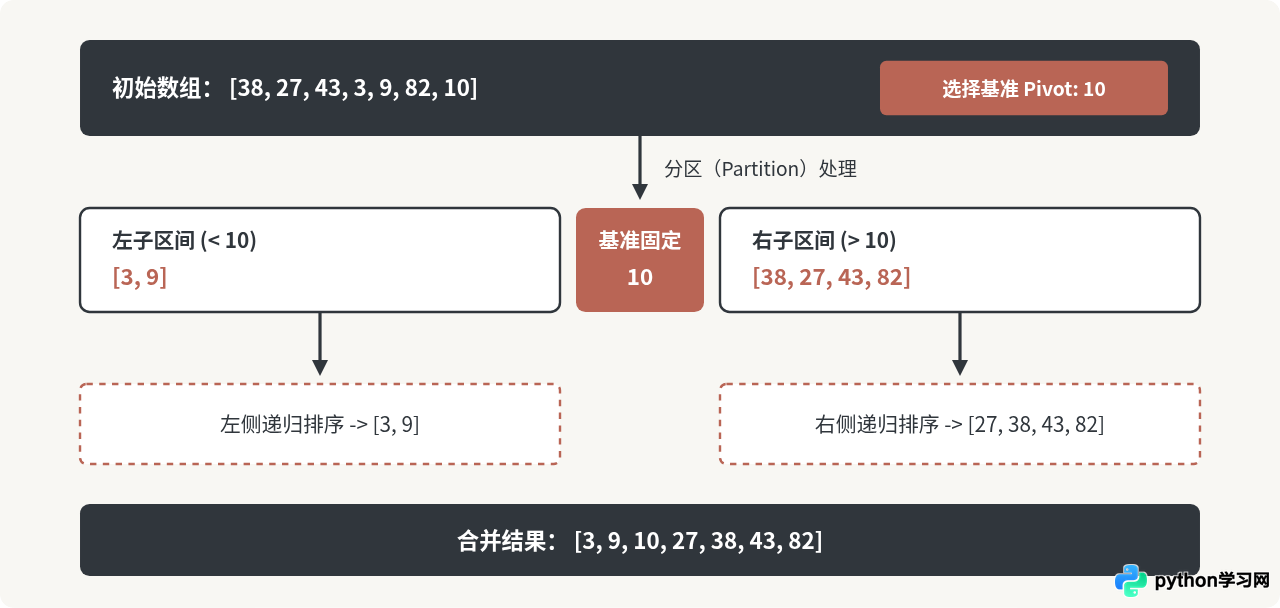
1. 冒泡排序(Bubble Sort)
冒泡排序通过相邻元素的比较与交换,使未排序部分的最大值如同气泡般逐渐浮到末尾。通过增加 swapped 标志位优化,当某一轮未发生任何交换时,可提前终止算法,使最好时间复杂度达到 \(O(n)\)。
def bubble_sort(arr):
    """冒泡排序实现(带提前终止优化)"""
    a = arr.copy()
    n = len(a)
    for i in range(n):
        swapped = False
        for j in range(0, n - i - 1):
            if a[j] > a[j + 1]:
                a[j], a[j + 1] = a[j + 1], a[j]
                swapped = True
        if not swapped:
            break
    return a

# 示例验证
sample_list = [64, 34, 25, 12, 22, 11, 90]
print("冒泡排序结果:", bubble_sort(sample_list))
# 示例输出: 冒泡排序结果: [11, 12, 22, 25, 34, 64, 90]
2. 快速排序(Quick Sort)
快速排序基于分治策略。选定一个基准元素(pivot)后,将数组重新排列为两部分:小于等于基准的放在左侧,大于基准的放在右侧,随后对左右两侧递归执行。以下给出符合工程标准的原地交换(in-place)实现:
def quick_sort(arr):
    """快速排序(原地划分)"""
    a = arr.copy()

    def _quick_sort(low, high):
        if low < high:
            pivot_idx = _partition(low, high)
            _quick_sort(low, pivot_idx - 1)
            _quick_sort(pivot_idx + 1, high)

    def _partition(low, high):
        pivot = a[high]  # 选取末尾为基准
        i = low - 1
        for j in range(low, high):
            if a[j] <= pivot:
                i += 1
                a[i], a[j] = a[j], a[i]
        a[i + 1], a[high] = a[high], a[i + 1]
        return i + 1

    _quick_sort(0, len(a) - 1)
    return a

# 示例验证
print("快速排序结果:", quick_sort([38, 27, 43, 3, 9, 82, 10]))
# 示例输出: 快速排序结果: [3, 9, 10, 27, 38, 43, 82]
3. 归并排序(Merge Sort)
归并排序同样采用分治法,它将数组不断平分为左右两半,直到子序列长度为1,然后将有序子序列逐层合并。归并排序在最坏与平均情况下均为 \(O(n \log n)\) 复杂度,且是一种稳定的排序算法(相同元素的相对顺序保持不变)。
def merge_sort(arr):
    """归并排序实现"""
    if len(arr) <= 1:
        return arr

    mid = len(arr) // 2
    left = merge_sort(arr[:mid])
    right = merge_sort(arr[mid:])

    return _merge(left, right)

def _merge(left, right):
    result = []
    i = j = 0
    while i < len(left) and j < len(right):
        if left[i] <= right[j]:
            result.append(left[i])
            i += 1
        else:
            result.append(right[j])
            j += 1
    result.extend(left[i:])
    result.extend(right[j:])
    return result

# 示例验证
print("归并排序结果:", merge_sort([14, 7, 3, 12, 9, 11, 6, 2]))
# 示例输出: 归并排序结果: [2, 3, 6, 7, 9, 11, 12, 14]
三、搜索算法实现与执行边界
搜索算法用于在数据集合中查找满足特定条件的元素位置。针对不同组织形式的数据,搜索效率差异显著。
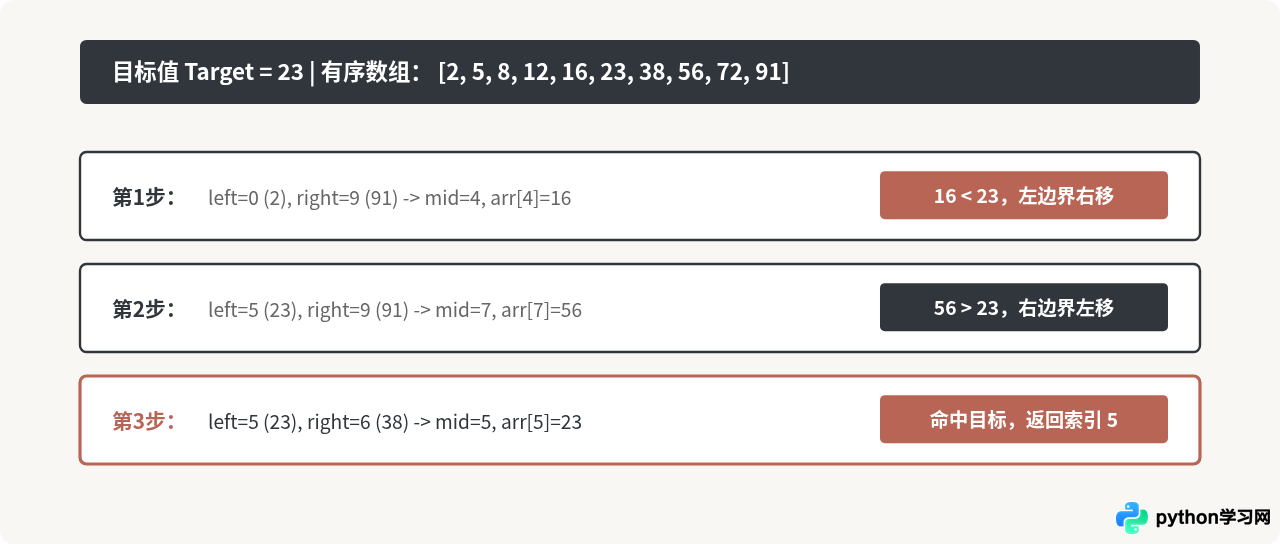
1. 线性搜索(Linear Search)
线性搜索适用于无序列表或没有索引支持的链表。算法从序列头逐一检查每个元素,找到目标返回索引,未找到返回 -1。时间复杂度为 \(O(n)\),无需数据预处理。
def linear_search(arr, target):
    """线性搜索实现"""
    for index, value in enumerate(arr):
        if value == target:
            return index
    return -1

# 示例验证
data = [19, 42, 7, 33, 85, 2]
print("线性查找目标33索引:", linear_search(data, 33))  # 示例输出: 3
print("线性查找目标99索引:", linear_search(data, 99))  # 示例输出: -1
2. 二分查找(Binary Search)
二分查找的前提是数据必须是有序序列。通过对比中间元素,每次可排除一半的候选区间。注意计算中间索引时,low + (high - low) // 2 能够有效避免大整数边界问题。
def binary_search(arr, target):
    """标准二分查找:返回目标值在升序列表中的索引,不存在返回 -1"""
    low = 0
    high = len(arr) - 1

    while low <= high:
        mid = low + (high - low) // 2
        if arr[mid] == target:
            return mid
        elif arr[mid] < target:
            low = mid + 1
        else:
            high = mid - 1

    return -1

# 示例验证
sorted_data = [2, 5, 8, 12, 16, 23, 38, 56, 72, 91]
print("二分查找23索引:", binary_search(sorted_data, 23))  # 示例输出: 5
print("二分查找40索引:", binary_search(sorted_data, 40)) # 示例输出: -1四、算法与数据结构选型与复杂度对比
在工程开发中,并不存在某种“万能”算法或结构。正确的选型需要在时间消耗、内存占用以及代码复杂度之间做出合理取舍:
| 算法/数据结构 | 平均时间复杂度 | 最坏时间复杂度 | 空间复杂度 | 稳定性/特点 |
|---|---|---|---|---|
| 单向链表 (Singly Linked List) | 查: O(n) / 首部增删: O(1) | O(n) | O(n) | 指针开销大,无序碎片化内存 |
| 二叉搜索树 (BST) | 查增删: O(log n) | O(n) [退化成链表] | O(n) | 数据有序,中序遍历即为升序 |
| 冒泡排序 (Bubble Sort) | O(n²) | O(n²) | O(1) | 稳定排序,教学意义大于工程实用 |
| 快速排序 (Quick Sort) | O(n log n) | O(n²) [基准极度偏斜] | O(log n) [调用栈] | 不稳定,实测常数极小,通用性强 |
| 归并排序 (Merge Sort) | O(n log n) | O(n log n) | O(n) [辅助数组] | 稳定排序,适合大数据块或外排序 |
| 二分查找 (Binary Search) | O(log n) | O(log n) | O(1) | 必须依赖连续有序存储结构 |
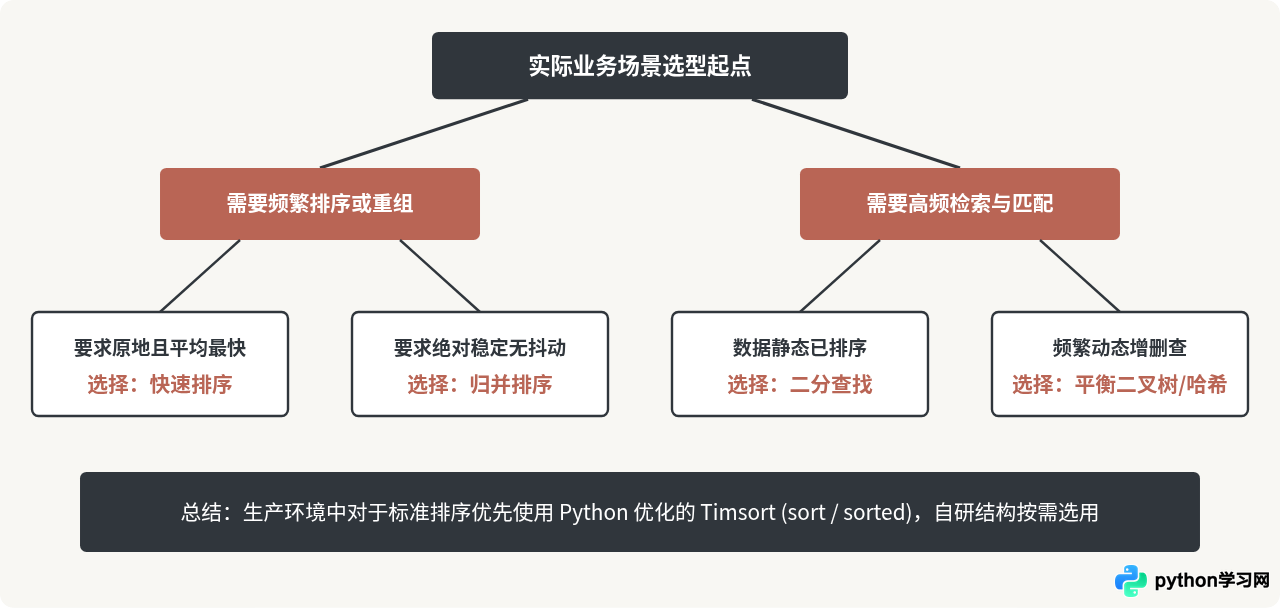
五、总结与工程建议
在Python开发实践中,理解算法的复杂度特性是写出高效代码的前提:
- 理解内置机制:Python的
list.sort()和sorted()采用的是结合了归并排序与插入排序的 Timsort 算法,其在面对现实世界中部分有序的数据时,表现极为优异。生产环境中无特殊需求应直接使用内置函数。 - 避免重复造轮子但掌握其原理:标准库中的
collections.deque针对先进先出的队列场景具有优化性能,bisect模块提供了经过严格测试的二分查找及插入实现。 - 警惕空间隐患:递归实现如快速排序和归并排序会产生函数调用栈与辅助内存占用。在处理百万级以上的大规模数据时,应优先考虑迭代写法或使用基于分块的外部排序。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















