


Python中怎么忽略大小写进行字符串模式匹配
详细介绍在Python中实现忽略大小写进行字符串模式匹配的多种方法,涵盖re模块flag参数、内联(?i)语法、预编译正则优化以及Unicode casefold处理技巧。
re 正则表达式模块,并在匹配函数中传入 flags=re.IGNORECASE(可简写为 flags=re.I),或者直接在正则表达式头部写入 (?i) 内联标记。如果仅仅是判断固定的普通子字符串是否存在或前后缀匹配,则推荐使用字符串原生的 str.casefold() 方法先做大小写折叠处理。
一、使用 re 模块与 re.IGNORECASE 标志位
Python 标准库自带的 re 模块提供了完整的正则表达式引擎。当我们需要查找某种特定模式(例如带有前缀、数字组合或特定结构的字符串)并且不希望受字符大写或小写影响时,设置 re.IGNORECASE 标志位是最直接的方式。
常用的检索函数如 re.search()、re.match()、re.findall() 和 re.finditer() 均支持通过 flags 参数传入该标志:
import re

text = "User status: APPROVED, Operator: admin_01, Log: success"

# 使用 re.search 在字符串中查找首个匹配项
pattern = r"admin_[0-9]+"
match_obj = re.search(pattern, text, flags=re.IGNORECASE)

if match_obj:
    print("匹配成功:", match_obj.group())  # 示例输出: 匹配成功: admin_01
    print("匹配索引范围:", match_obj.span())  # 示例输出: (33, 41)
else:
print("未找到匹配项")在日常书写中,re.IGNORECASE 与其单个大写字母缩写 re.I 完全等价。两者均指向同一个整型常量数值。如果需要同时搭配其他正则标志位(例如多行模式 re.MULTILINE 或跨行匹配点号 re.DOTALL),可以使用按位或运算符 | 组合传入:
# 组合使用忽略大小写与多行模式
combined_pattern = r"^status:\s*[a-z]+"
match = re.search(combined_pattern, text, flags=re.I | re.M)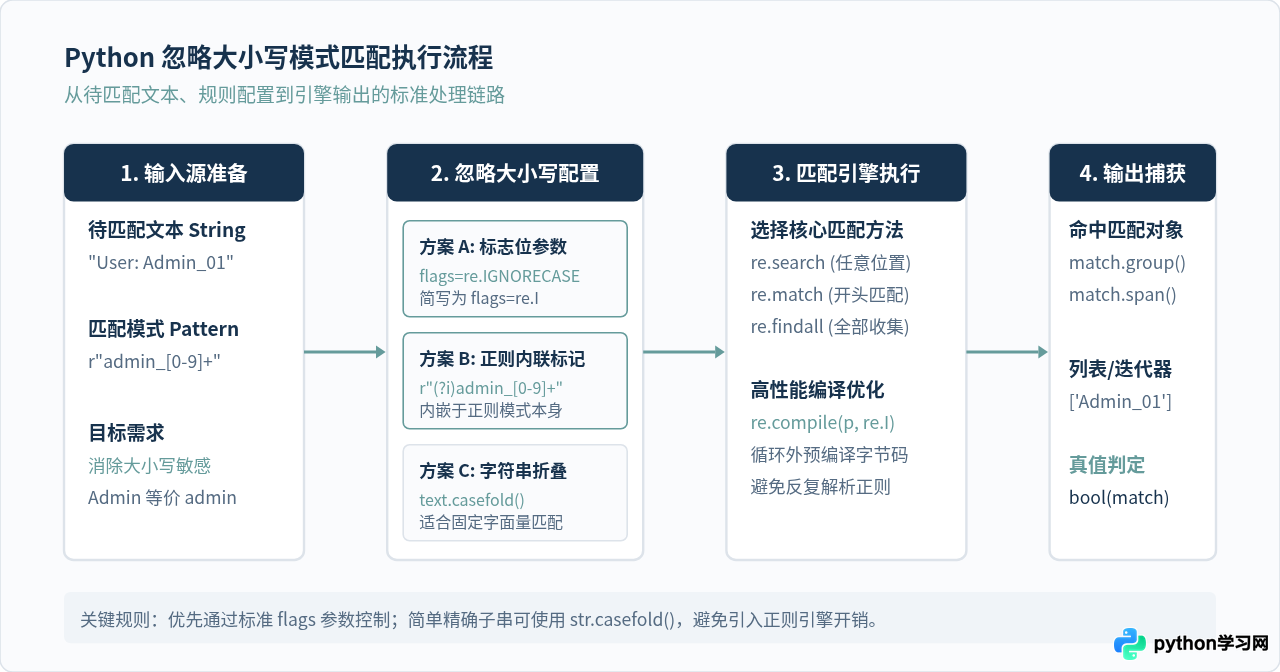
二、使用内联标志 (?i) 与局部忽略大小写
除了在调用函数时作为额外参数传递标志位之外,Python 的正则表达式语法还支持将标志内嵌在正则表达式字符串本身内部。这称为“内联标志”(Inline Flag)。
1. 全局内联标志 (?i)
当正则表达式开头包含 (?i) 时,整个正则表达式的后续匹配均会默认忽略大小写。这种写法的优势在于模式与其匹配规则内聚在一起,当规则存储在外部 JSON、YAML 配置文件或数据库中时,不需要应用程序代码显式设置 flags 参数:
import re

# 模式字符串自带 (?i) 内联标记
pattern = r"(?i)https?://[a-z0-9\-.]+"

content = "Visit HTTPS://Example.COM for documentation"
result = re.findall(pattern, content)
print(result)  # 示例输出: ['HTTPS://Example.COM']
2. 局部范围生效内联标记 (?i:...)
在很多现实业务场景中,我们可能只希望模式中的“某一部分”忽略大小写,而另一部分必须保持严格的大小写敏感。例如匹配一个带有固定前缀但后缀必须为全大写字母的令牌。
从 Python 3.6 起,正则引擎支持通过局部修饰符语法 (?i:...) 精确限定忽略大小写的有效范围:
import re

# 仅前缀 token 忽略大小写,随后的校验码必须为大写字母
precise_pattern = r"(?i:token)-[A-Z]{4}"

print(bool(re.search(precise_pattern, "TOKEN-ABCD")))  # 示例输出: True (匹配成功)
print(bool(re.search(precise_pattern, "token-ABCD")))  # 示例输出: True (匹配成功)
print(bool(re.search(precise_pattern, "token-abcd")))  # 示例输出: False (后缀严格区分大写,未命中)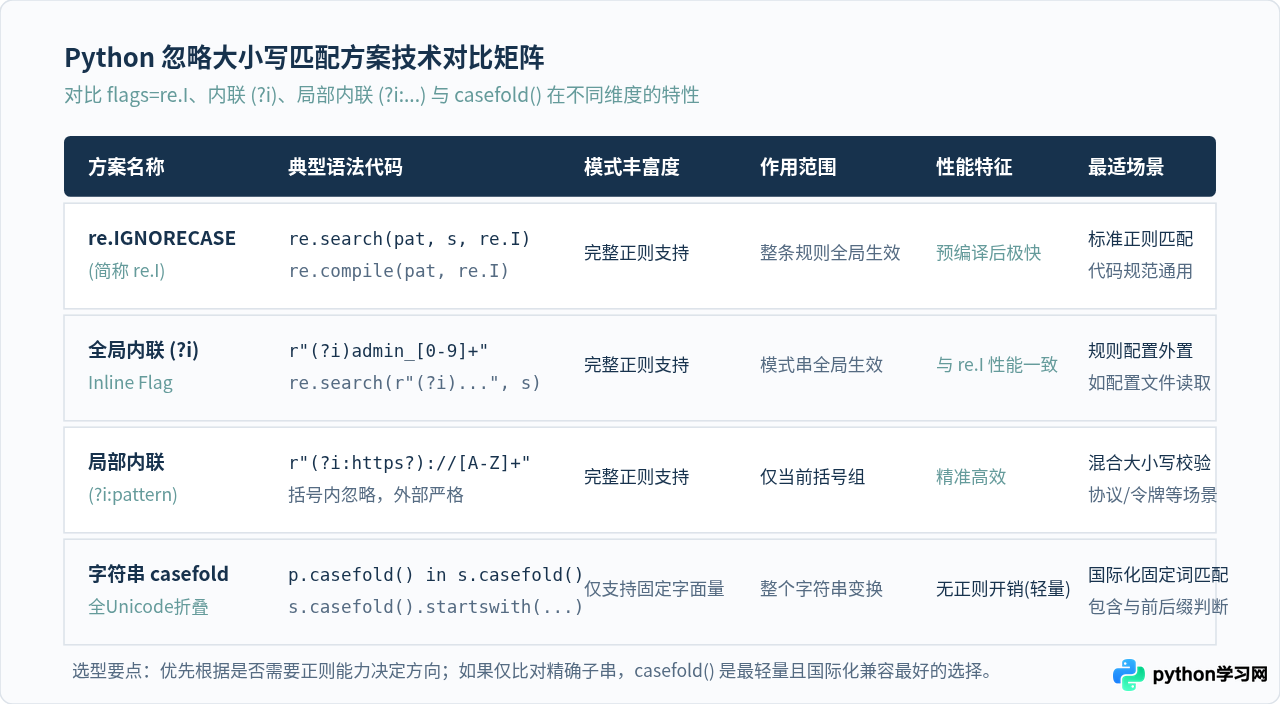
三、高性能场景:使用 re.compile 预编译模式
如果需要在循环中处理成千上万条日志或海量文本行,直接调用 re.search() 会导致 Python 内部频繁查询或管理底层正则缓存。推荐在循环外部使用 re.compile() 先将模式和忽略大小写标志预编译为 Pattern 对象:
import re

# 在循环或请求处理外部完成预编译,固化 flags
compiled_pattern = re.compile(r"error:\s*code_\d+", flags=re.IGNORECASE)

log_lines = [
    "2026-10-29 INFO System normal",
    "2026-10-29 Error: Code_404 not found",
    "2026-10-29 ERROR: CODE_500 internal crash",
    "2026-10-29 DEBUG Heartbeat ping"
]

matched_logs = []
for line in log_lines:
    if compiled_pattern.search(line):
        matched_logs.append(line)

print("命中的日志条数目目:", len(matched_logs))  # 示例输出: 2
预编译后的 Pattern 对象本身已经记录了 re.IGNORECASE 属性,在后续调用 search()、match() 或 sub() 时不需要也不应该再次重复传入标志位。
四、底层原理与 Unicode 大小写折叠(Case Folding)
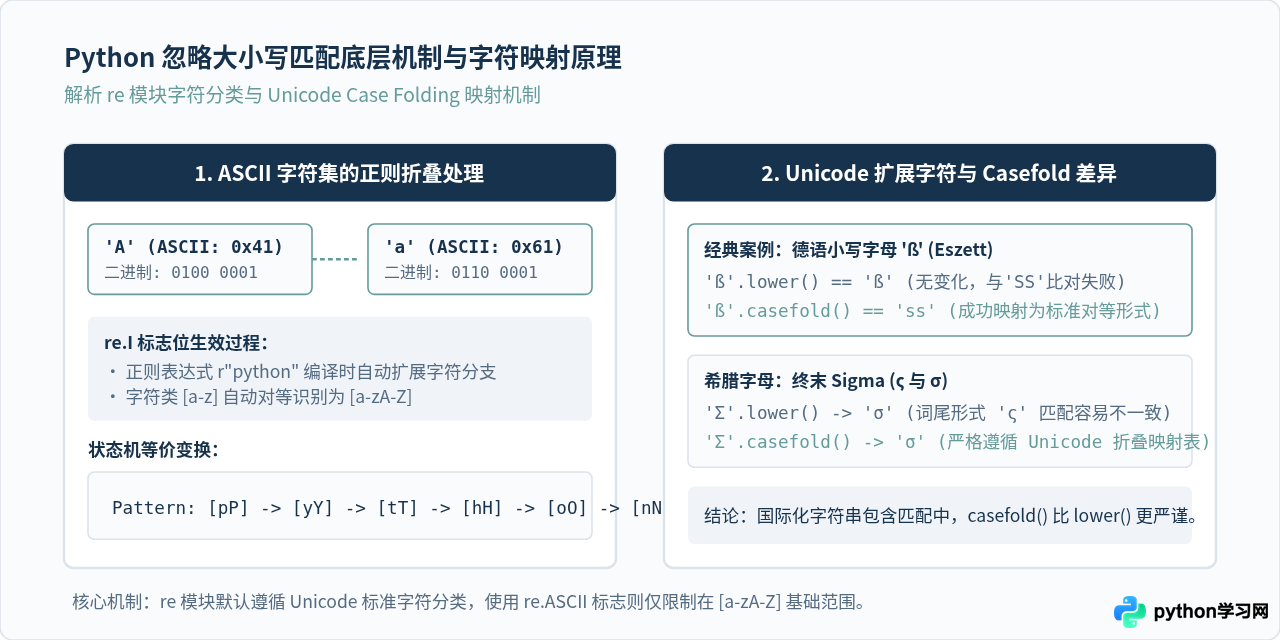
理解 Python 忽略大小写的运作方式,有助于避免在多语言文本和特殊字符场景下踩坑。对于 ASCII 范围内的标准英文字符(A-Z 与 a-z),大写和小写之间在二进制层面上只相差第 5 位(十六进制差 0x20),正则引擎在构建自动机时会自动将字符分支展开。
然而,Python 3 原生采用 Unicode 字符串。在 Unicode 规范中,单纯调用 .lower() 并不足以应对所有语言的无差别比对需求:
- 德语小写字母 'ß'(Eszett):在标准德语中,它的大写形式通常写作 "SS"。如果执行
"ß".lower(),返回依然是"ß",导致它与"SS".lower()(即"ss")无法对等;而执行"ß".casefold()则会正确折叠为"ss"。 - 希腊字母 'Σ'(Sigma):其小写形式存在词中形式 'σ' 和词尾形式 'ς'。
.casefold()同样会将其归一化处理。
五、非正则场景:简单固定子串的快速匹配
如果业务需求仅仅是检查目标文本中是否包含某个具体的关键词,且该关键词中不包含通配符或正则表达式语法,引入 re 模块会带来不必要的解析与自动机开销。此时直接使用 Python 字符串的内置方法是最优雅高效的解法:
# 场景:固定词不区分大小写检索
keyword = "PYTHON"
document = "Learning python programming from official documentation."

# 推荐做法:使用 casefold() 消除大小写差异
if keyword.casefold() in document.casefold():
    print("文档中包含指定关键字")

# 前缀与后缀判断
filename = "REPORT_2026.PDF"
if filename.casefold().endswith(".pdf"):
print("这是一个 PDF 文档").lower(),但在处理多语言国际化输入或外部未知来源的数据时,.casefold() 是官方推荐的无视大小写最佳实践方法。
六、高频避坑指南
在实际编写代码时,有几个容易引发隐蔽 Bug 的细节需要特别注意:
1. re.sub() 的参数位置陷阱
这是 Python 开发者最容易写错的地方之一。re.sub() 的函数签名中,第四个位置参数是 count(替换次数),第五个才是 flags:
# 函数原型: re.sub(pattern, repl, string, count=0, flags=0)

raw_text = "Cat and cat and CAT"

# 错误写法:把 re.I 作为第四个位置参数传递,实际传入了 count=re.I(即 count=2),并未生效标志位!
wrong_result = re.sub(r"cat", "dog", raw_text, re.IGNORECASE)

# 正确写法:必须显式使用关键字参数 flags=re.I
correct_result = re.sub(r"cat", "dog", raw_text, flags=re.IGNORECASE)
print(correct_result)  # 示例输出: dog and dog and dog
2. fnmatch 模块的跨平台差异
如果使用 Python 标准库中的 fnmatch 模块进行文件名通配符匹配(例如 *.py),请注意 fnmatch.fnmatch() 会根据操作系统底层文件系统的大小写敏感性表现出不同行为:在 Windows 系统上它默认忽略大小写,而在 Linux/macOS 上则区分大小写。如果需要跨平台始终保持一致的忽略大小写匹配,应将文件名与模式统一进行 casefold() 转换后再调用 fnmatch.fnmatchcase()。
七、总结
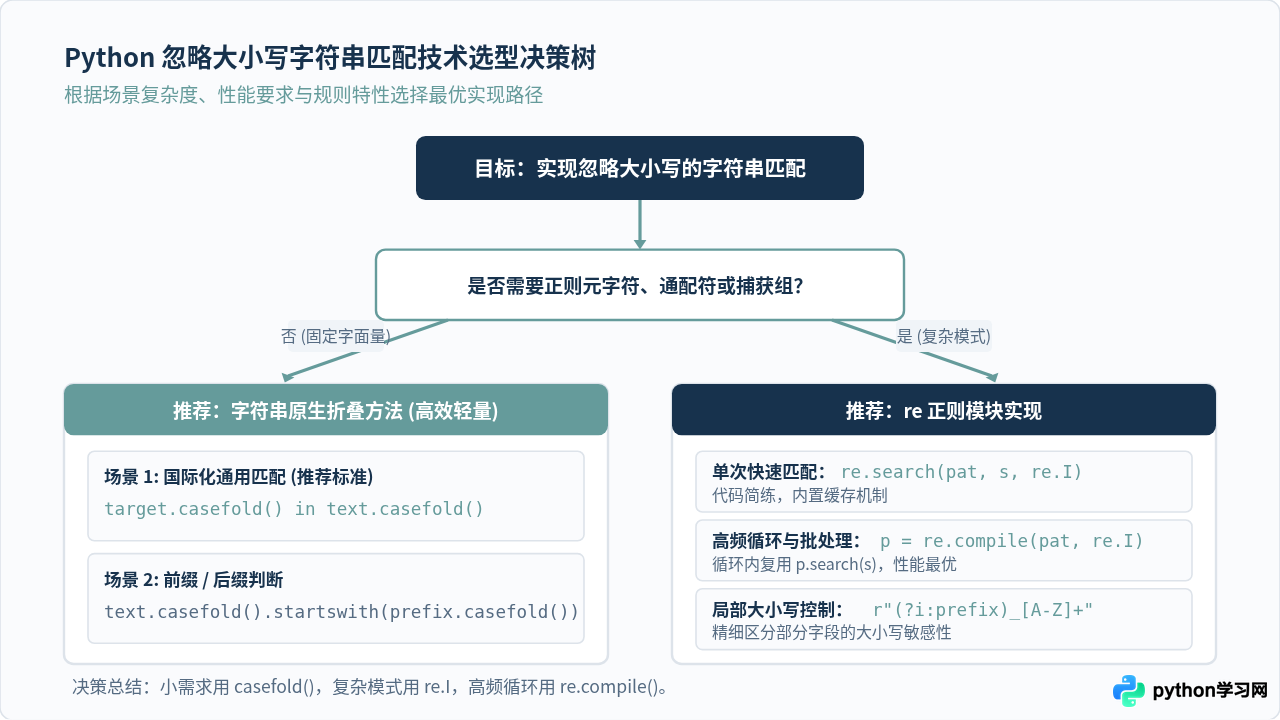
在 Python 中实现忽略大小写的字符串模式匹配,选择适合业务场景的方法能够兼顾代码可读性与运行性能:
- 正则模式匹配首选:使用
re.search()或re.findall()并传入flags=re.IGNORECASE(或re.I),也可以在模式字符串开头书写(?i)。 - 混合敏感度精细控制:使用 Python 3.6+ 支持的局部内联语法
(?i:...),仅对指定子模式忽略大小写。 - 大批量/高频调用:在循环外部使用
re.compile(pattern, re.IGNORECASE)预编译,避免重复构建解析树。 - 固定字面量子串:直接使用
str.casefold()消除大小写差异,执行效率最高且全面兼容 Unicode 规范。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















