


提升Python自动化脚本稳定性:错误重试机制与日志记录最佳实践
深入探讨提升Python自动化脚本生产环境稳定性的核心技术,系统讲解瞬态故障与致命异常的判定、指数退避与抖动重试机制实现、标准库logging的分级规范与日志文件自动轮转归档最佳实践。
一、自动化脚本为什么频频崩溃:瞬态故障与致命异常
许多自动化任务在本地调试时表现完美,部署到定时任务或服务器环境后却频繁意外中断。分析其崩溃原因,通常可以归结为两大类完全不同的错误类型:
- 瞬态故障(Transient Faults):网络抖动、DNS 解析瞬时超时、目标服务因负载短暂返回 HTTP 503 或 429、数据库连接池短暂耗尽等。这类故障具备偶发性和自愈性,几秒后重新发起请求往往就能恢复正常。
- 致命异常(Permanent Faults):身份凭据过期(HTTP 401/403)、API 接口参数协议不匹配(HTTP 400)、语法逻辑缺陷、磁盘空间耗尽等。这类故障即使重试一百次也无法成功,盲目重试只会徒增无谓开销。
很多初学者习惯用一层简单的 try...except Exception: pass 敷衍应对,这种做法往往比直接崩溃更危险——它彻底吞没了错误线索,使自动化流程在脏数据或半完成状态下继续推进,最终酿成严重的数据损毁或业务隐患。真正稳健的策略是:精准判定错误性质,对瞬态异常实施受控重试,对致命异常进行完整的现场日志固化并安全中断。
二、弹性重试机制设计:从普通循环到指数退避与抖动
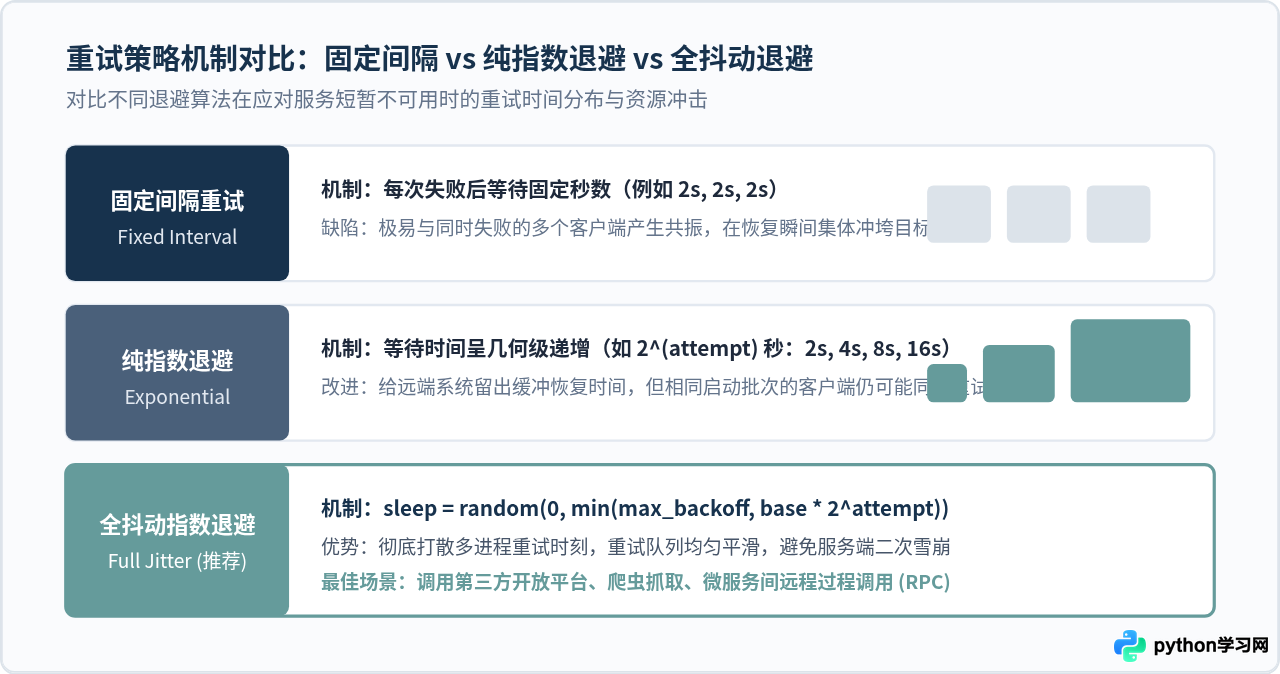
最原始的重试往往是在捕获异常后立即重新执行。但在高并发或依赖外部公共 API 的场景下,立即重试或固定间隔重试极易引发“惊群效应(Thundering Herd)”,导致目标服务端被瞬间冲垮。
1. 指数退避与全抖动(Full Jitter)策略
工程上公认的最优重试间隔计算模型是指数退避(Exponential Backoff)结合随机抖动(Jitter)。重试等待时间随着失败次数呈指数级放大,同时在时间区间内加入随机偏移,将多个并发客户端的重试时间窗口彻底打散:
2. 使用 Python 原生标准库实现通用重试装饰器
在不依赖第三方包的前提下,可以通过 Python 装饰器封装一个具备“指数退避 + 随机抖动 + 指定异常类型”的稳健重试工具函数:
import time
import random
import functools
import logging

logger = logging.getLogger("automation.retry")

def retry_with_jitter(max_attempts=3, base_delay=1.0, max_delay=10.0, retryable_exceptions=(Exception,)):
    """
    通用指数退避 + 全抖动重试装饰器
    :param max_attempts: 最大执行尝试次数
    :param base_delay: 基础退避时间(秒)
    :param max_delay: 最大等待时间上限(秒)
    :param retryable_exceptions: 触发重试的异常元组
    """
    def decorator(func):
        @functools.wraps(func)
        def wrapper(*args, **kwargs):
            attempt = 1
            while attempt <= max_attempts:
                try:
                    return func(*args, **kwargs)
                except retryable_exceptions as e:
                    if attempt == max_attempts:
                        logger.error(
                            f"函数 [{func.__name__}] 执行彻底失败,已达最大尝试次数 ({max_attempts})。最后一次异常: {e}",
                            exc_info=True
                        )
                        raise

                    # 计算指数退避时间并添加全抖动
                    exponential = min(max_delay, base_delay * (2 ** (attempt - 1)))
                    sleep_time = random.uniform(0, exponential)

                    logger.warning(
                        f"函数 [{func.__name__}] 遇到错误: {e}。第 {attempt}/{max_attempts} 次尝试失败,"
                        f"将在 {sleep_time:.2f} 秒后重试..."
                    )
                    time.sleep(sleep_time)
                    attempt += 1
        return wrapper
    return decorator
3. 生产级成熟库推荐:使用 tenacity
如果项目中允许引入第三方依赖,业界标准推荐使用 tenacity。它提供了高度声明式的 API,支持根据返回值条件重试、自定义停止条件和重试前后回调:
from tenacity import retry, stop_after_attempt, wait_random_exponential, retry_if_exception_type
import requests

# 仅在遇到网络连接错误或超时且尝试未满4次时重试,使用全抖动指数退避
@retry(
    stop=stop_after_attempt(4),
    wait=wait_random_exponential(multiplier=1, max=15),
    retry=retry_if_exception_type((requests.exceptions.ConnectionError, requests.exceptions.Timeout)),
    reraise=True
)
def fetch_api_data(url: str, params: dict = None) -> dict:
    response = requests.get(url, params=params, timeout=5)
    response.raise_for_status()
    return response.json()
三、自动化重试决策流程:精准把控执行路径
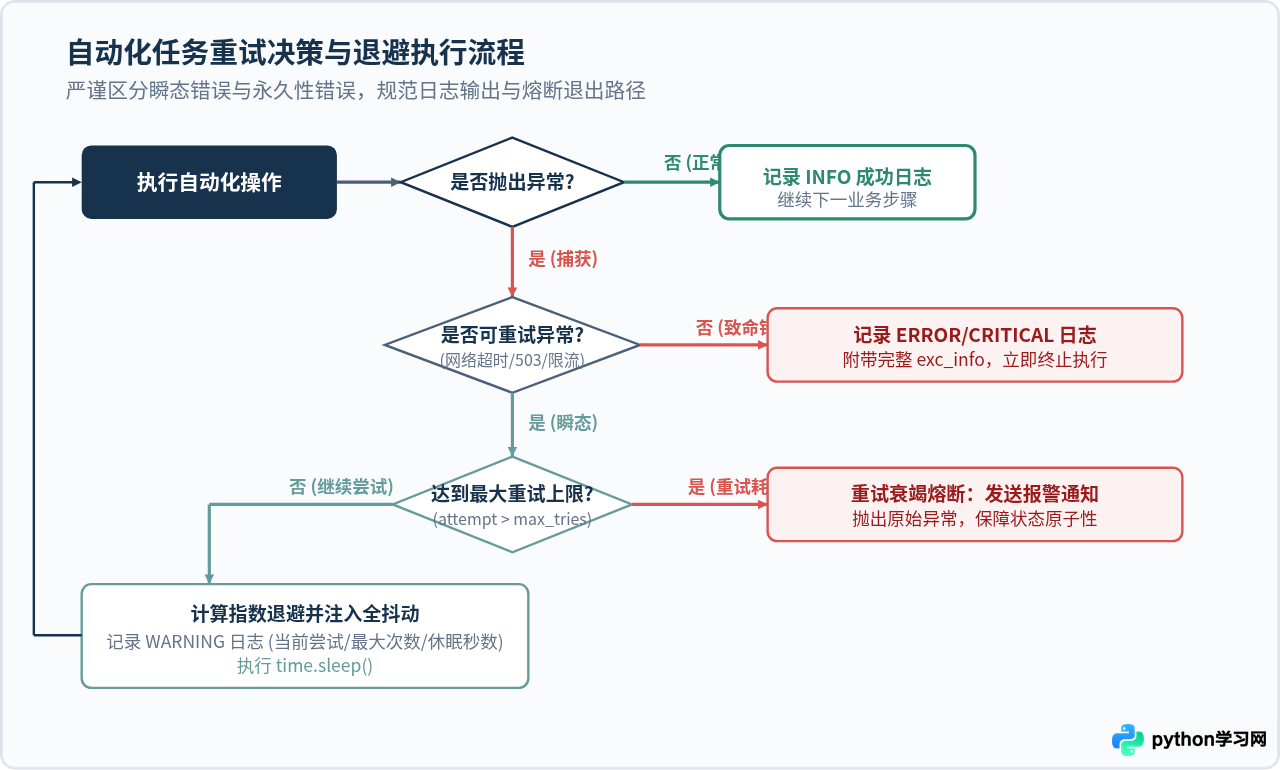
重试机制并非适用于每个代码块。将重试逻辑置于正确的颗粒度,是防止系统陷入无效重试的关键。下面的流程图展示了一个工业级自动化任务在面临异常时的标准判定流转路径:
四、构建企业级日志系统:摆脱 print 的可观测性方案
许多开发者在编写脚本时倾向于使用 print() 输出状态。然而,在自动化与定时任务场景下,print 存在致命缺陷:无法区分严重级别、缺乏时间戳与上下文元数据、不支持将不同级别输出重定向至独立文件、缺乏并发与轮转保障。使用标准库 logging 构建分层架构,是提升脚本可观测性的必经之路。
1. 日志分级标准在自动化场景的准确定位
| 日志级别 | 触发场景 | 在自动化脚本中的具体示例 |
|---|---|---|
| DEBUG | 底层调试细节 | 原始 HTTP 请求头与 Payload、数据库查询 SQL 语句、本地变量切片输出。 |
| INFO | 关键生命周期里程碑 | 脚本启动、成功连接远程服务、完成第 N 批数据同步、正常处理结束。 |
| WARNING | 预期内非阻塞异常 | 触发第 N 次瞬态重试、接口返回即将废弃的警告、部分非核心字段解析失败使用默认值。 |
| ERROR | 单项任务中断/失败 | 单条数据处理失败但整体循环仍可推进、多次重试彻底耗尽、关键远端接口拒绝访问。 |
| CRITICAL | 整个自动化进程瘫痪 | 配置文件损坏丢失、数据库连通性完全断开、内存溢出边缘,进程即将被迫退出。 |
2. 多通道日志分流与自动滚动归档架构
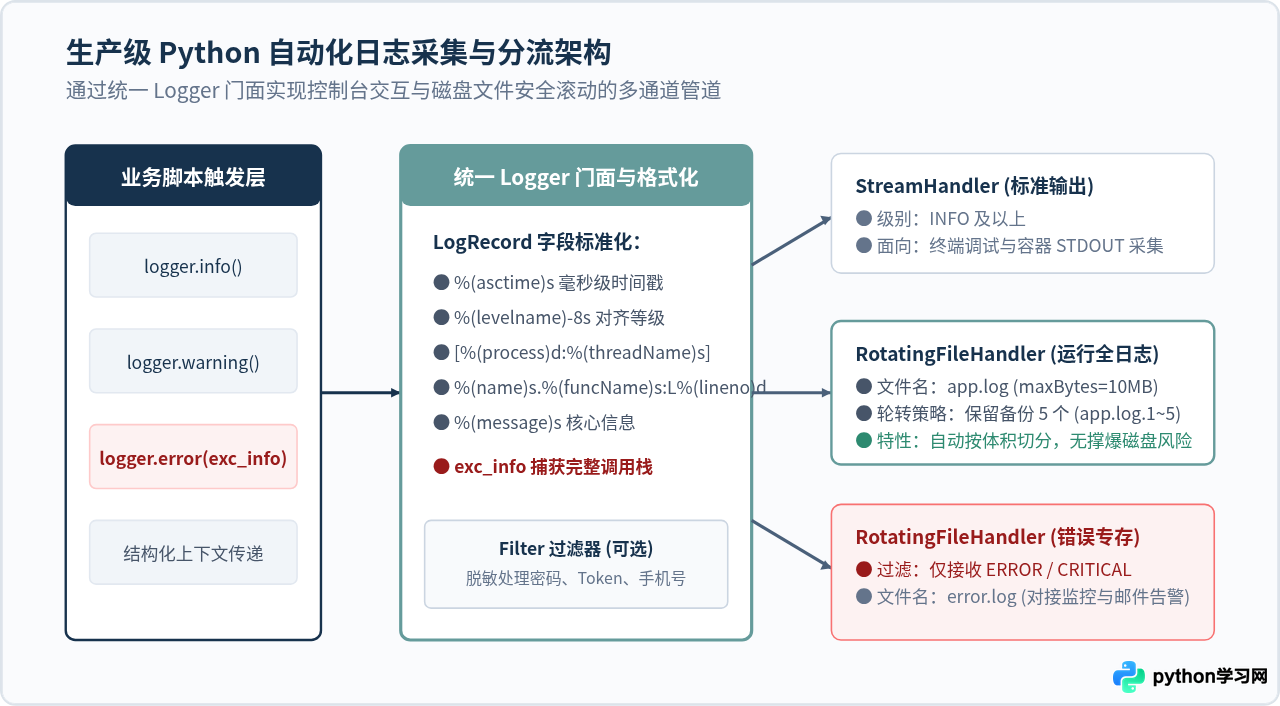
长周期运行的脚本如果将所有日志无限制写入单一文本,不仅会迅速占满服务器磁盘,而且会导致数吉字节的大文件在排查问题时极难检索。生产级方案必须配置 RotatingFileHandler 进行日志体积切割与保留数量限制:
五、生产级通用模板:重试机制与日志系统的协同实战
以下提供一份开箱即用的工业级自动化脚本框架。该框架完整集成了单例日志体系配置、按体积自动轮转、全抖动重试控制以及错误上下文追踪,可直接作为数据同步、爬虫或自动化运维任务的底座:
import os
import sys
import time
import random
import logging
from logging.handlers import RotatingFileHandler
from pathlib import Path

def setup_production_logger(
    app_name: str = "automation_task",
    log_dir: str = "logs",
    max_mb: int = 10,
    backup_count: int = 5
) -> logging.Logger:
    """
    配置工业级多通道轮转日志记录器
    """
    Path(log_dir).mkdir(parents=True, exist_ok=True)
    logger = logging.getLogger(app_name)
    logger.setLevel(logging.DEBUG)

    # 避免反复添加 handler 产生重复日志
    if logger.handlers:
        return logger

    # 1. 统一格式化器:包含时间戳、线程名、代码行号与等级
    standard_formatter = logging.Formatter(
        fmt="%(asctime)s [%(levelname)-7s] [%(process)d:%(threadName)s] %(name)s.%(funcName)s:%(lineno)d - %(message)s",
        datefmt="%Y-%m-%d %H:%M:%S"
    )

    # 2. 控制台 Handler (输出 INFO 及以上)
    console_handler = logging.StreamHandler(sys.stdout)
    console_handler.setLevel(logging.INFO)
    console_handler.setFormatter(standard_formatter)
    logger.addHandler(console_handler)

    # 3. 常规业务日志文件 Handler (全量记录 DEBUG 及以上,自动滚动)
    app_log_path = os.path.join(log_dir, f"{app_name}.log")
    file_handler = RotatingFileHandler(
        filename=app_log_path,
        maxBytes=max_mb * 1024 * 1024,
        backupCount=backup_count,
        encoding="utf-8"
    )
    file_handler.setLevel(logging.DEBUG)
    file_handler.setFormatter(standard_formatter)
    logger.addHandler(file_handler)

    # 4. 独立错误日志 Handler (仅收集 ERROR 及 CRITICAL,便于快速排错)
    error_log_path = os.path.join(log_dir, f"{app_name}_error.log")
    error_handler = RotatingFileHandler(
        filename=error_log_path,
        maxBytes=max_mb * 1024 * 1024,
        backupCount=backup_count,
        encoding="utf-8"
    )
    error_handler.setLevel(logging.ERROR)
    error_handler.setFormatter(standard_formatter)
    logger.addHandler(error_handler)

    return logger

# 初始化模块全局 Logger
logger = setup_production_logger()

class TransientServiceError(Exception):
    """自定义瞬态服务异常"""
    pass

def execute_with_resilience(action_name: str, max_retries: int = 3, base_delay: float = 1.0):
    """
    带全抖动退避的高可用任务执行器
    """
    attempt = 1
    while attempt <= max_retries:
        try:
            logger.info(f"开始执行任务环节: [{action_name}] (尝试 {attempt}/{max_retries})")

            # --- 模拟可能发生网络偶发故障的自动化业务 ---
            if random.random() < 0.6:
                raise TransientServiceError("远程服务器返回 503 Service Unavailable")

            logger.info(f"任务环节 [{action_name}] 执行成功!")
            return {"status": "success", "action": action_name}

        except TransientServiceError as err:
            if attempt == max_retries:
                logger.error(
                    f"任务环节 [{action_name}] 重试已达上限 ({max_retries} 次),最终失败!",
                    exc_info=True
                )
                raise

            # 计算指数退避 + 抖动延迟
            backoff_cap = min(15.0, base_delay * (2 ** (attempt - 1)))
            sleep_duration = random.uniform(0.5, backoff_cap)

            logger.warning(
                f"任务环节 [{action_name}] 捕获瞬态故障: {err}。"
                f"等待 {sleep_duration:.2f} 秒后发起第 {attempt + 1} 次重试..."
            )
            time.sleep(sleep_duration)
            attempt += 1

if __name__ == "__main__":
    logger.info("========== 自动化批量处理脚本启动 ==========")
    try:
        execute_with_resilience("同步远端用户订单数据", max_retries=4, base_delay=1.5)
        logger.info("========== 自动化批量处理脚本圆满结束 ==========")
    except Exception as e:
        logger.critical(f"自动化脚本发生不可恢复致命异常,主流程终止: {e}")
        sys.exit(1)
六、高可靠性治理全景总结与避坑清单
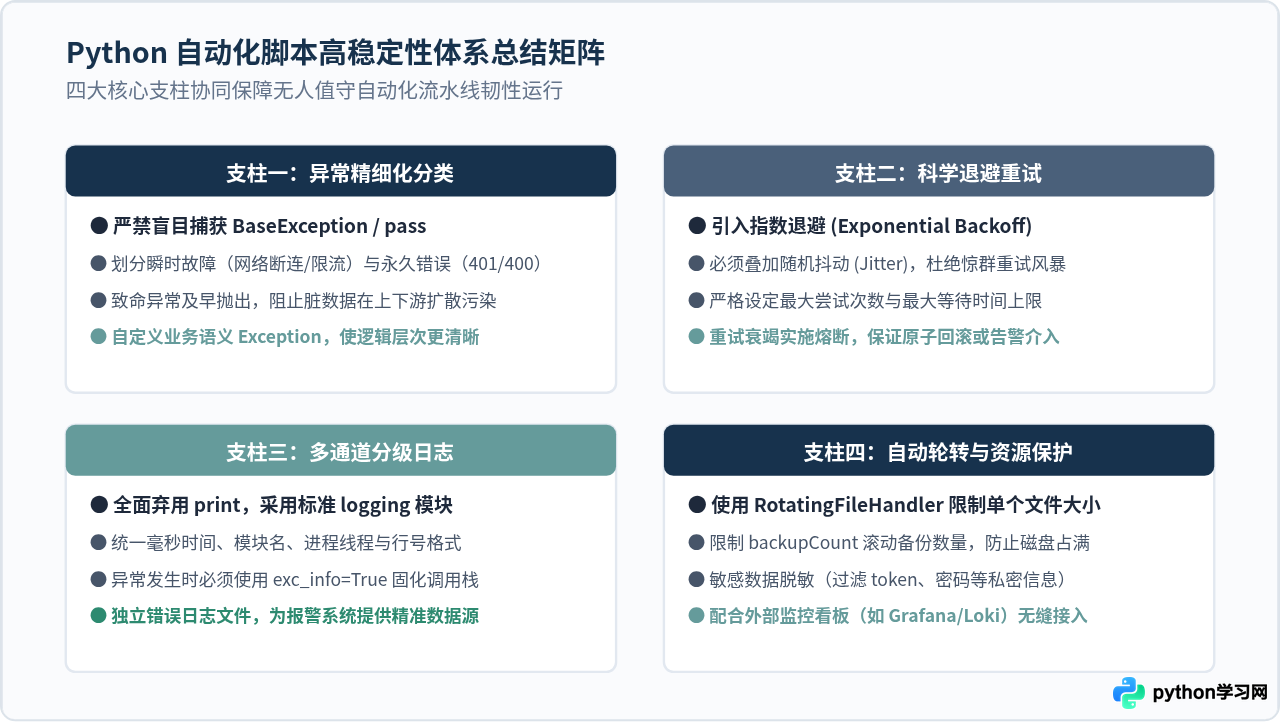
要真正让 Python 自动化脚本达到“工业级高可用”,需要建立从异常防御、受控重试到日志观测的全流程闭环体系。以下图表梳理了提升脚本稳定性的四大核心治理维度:
1. 不要对整个主函数进行粗暴重试: 重试的范围应尽量收缩至最小的 I/O 边界(如单次 HTTP 请求、单个文件读取),切忌将包含数据库写库、邮件发送等具有副作用的整段事务脚本包裹在重试循环中,否则可能导致重复写入或重复发送邮件。
2. 幂等性是重试的前提: 在对写操作实施重试之前,必须确保目标接口具备幂等性(如携带客户端唯一业务请求编号 request_id),避免因偶发的网络断连导致远端重复扣款或生成重复工单。
3. 保持标准输出流缓冲刷新: 在 Docker 容器或后台 nohup 运行脚本时,确保 Python 输出为非缓冲模式(如启动参数添加 -u 或环境变量设置 PYTHONUNBUFFERED=1),确保终端日志实时可见。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















