


Python使用mpmath库进行超高精度Pi计算
详细讲解如何在Python中使用mpmath库进行千位乃至万位超高精度Pi(圆周率)计算,剖析精度上下文、内置常数与Chudnovsky算法实现及性能优化策略。
在日常数据分析和常规工程开发中,Python 内置的 float 类型足以应付绝大多数场景。然而,Python 的标准浮点数底层基于 IEEE 754 双精度浮点格式,仅具备 53 位二进制有效数字,换算为十进制仅有大约 15 至 17 位有效精度。当面对数论验证、天文轨道精细模拟、极限渐近级数验证或密码学算法研究时,这种硬件限制将直接导致严重的精度截断与舍入误差累积。为了在 Python 中打破这一上限,mpmath 成为了最通用、功能完备且生态成熟的任意精度浮点数计算工具库。本文将从精度配置机制、内置常数调用、高精度级数手写实现及性能加速策略四个维度,系统讲解如何使用 mpmath 计算数千位乃至数万位的高精度圆周率 $\pi$。
一、浮点数精度限制与 mpmath 双后端架构
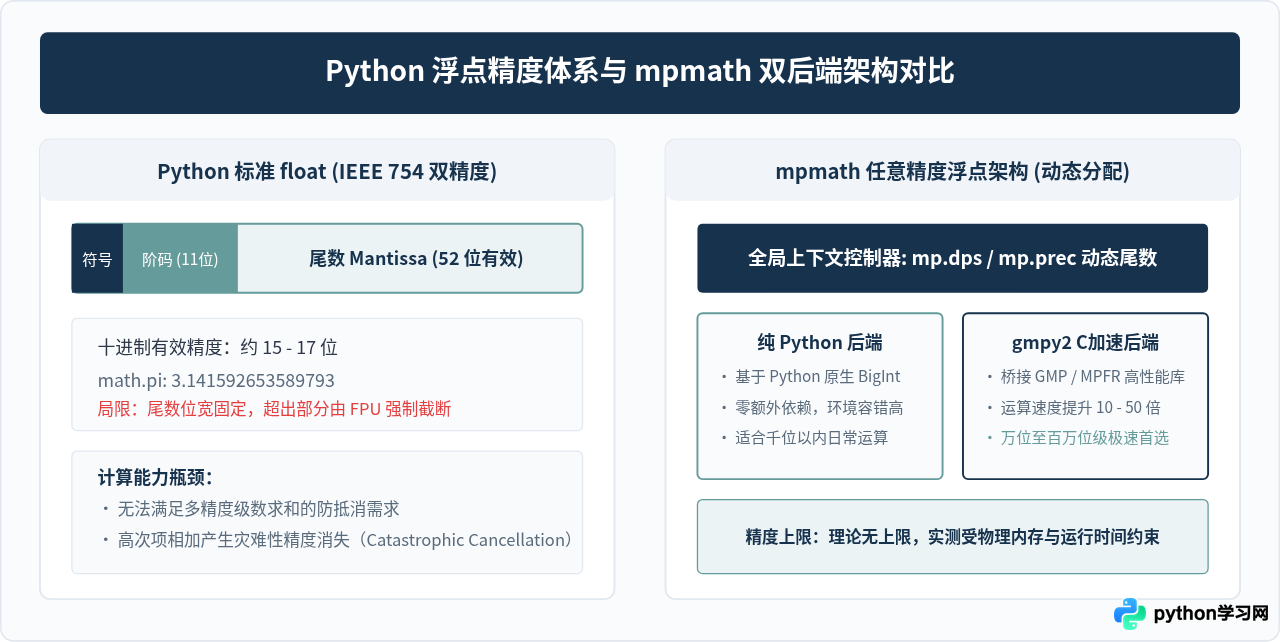
在深入具体代码之前,我们需要厘清标准浮点类型与任意精度库在底层机制上的根本差异。Python 原生的 float 将数值打包为固定 64 位(1 位符号、11 位阶码、52 位尾数),计算由 CPU 的浮点运算单元(FPU)硬件直接完成,速度极快但无法扩展。如果你在标准 Python 交互环境中输入 import math; math.pi,只能得到 3.141592653589793,第 16 位以后的数值就已经丢失了确定性。
而 mpmath 采用了完全不同的软件级浮点设计。它将一个浮点数表示为任意长度的整数尾数与阶码的组合,其精度只受限于主机的物理内存大小。更重要的是,mpmath 具备优雅的双后端架构:
- 纯 Python 后端(Pure Python):无需安装任何 C 编译器或外部依赖,能在所有支持 Python 的操作系统及架构上即装即用。底层利用 Python 自身支持的大整数(arbitrary-precision integer)来实现大数运算。
- GMP/MPFR 加速后端(via gmpy2):当环境中安装了
gmpy2库时,mpmath会自动切换为底层基于 GNU Multiple Precision Arithmetic Library (GMP) 和 MPFR 库的高性能 C 实现,运算吞吐量可提升数十倍至上百倍,非常适合计算百万级精度的场景。
二、环境搭建与精度控制核心机制
使用 mpmath 进行高精度计算的第一步是安装库并理解其精度调节机制。在终端中执行以下命令即可安装纯 Python 版核心库:
pip install mpmath如果你需要计算 5,000 位以上的极限精度,建议同时安装 gmpy2。mpmath 在加载时会自动检测该模块,并在可用时自动启用 C 级别加速:
pip install gmpy2精度设定的双核心:dps 与 prec
mpmath 提供了两种并行的精度控制属性:
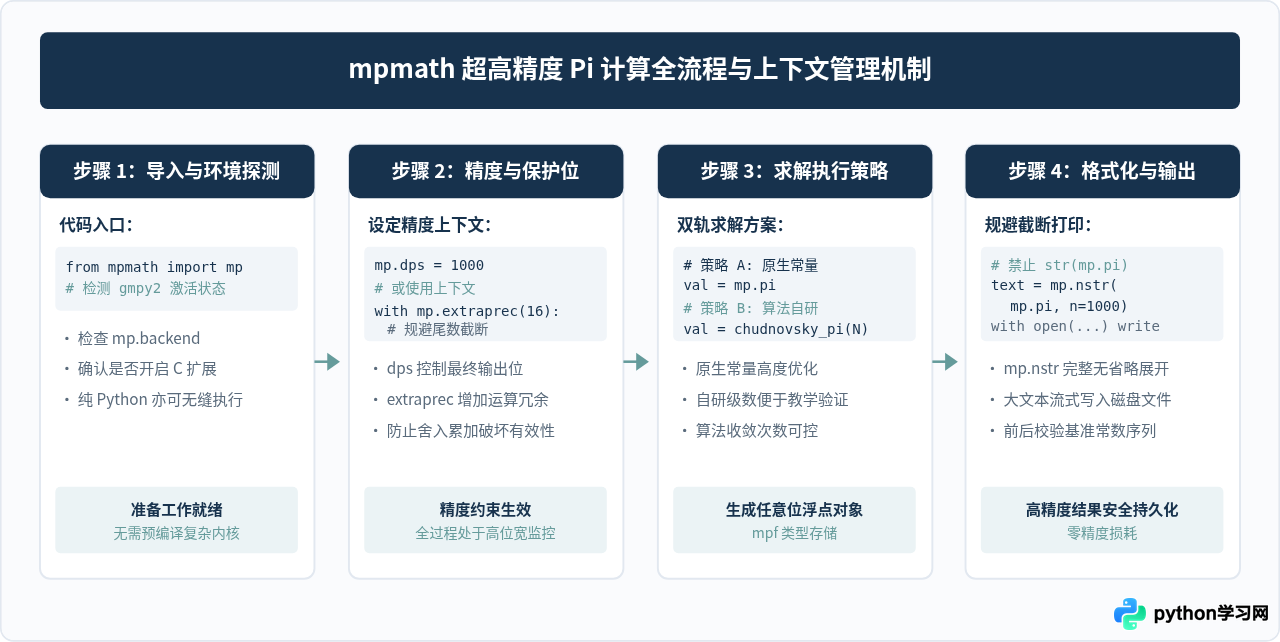
mp.dps(Decimal Places):即十进制有效数字位数。例如设置mp.dps = 100,代表后续所有浮点运算都维持至少 100 位十进制精度。mp.prec(Bits of Precision):即二进制尾数位宽。两者的换算关系为prec ≈ ceil(dps * 3.321928)。修改其中任意一个,另一个都会自动同步更新。
安全上下文:局部精度管理与保护位
在复杂数学迭代中,直接修改全局的 mp.dps 容易对程序的其他模块造成副作用。mpmath 提供了 workdps 和 extraprec 上下文管理器,允许在独立的代码块内临时调整精度,或者添加内部运算专用的“保护位”(Guard Digits),从而防止中间环节多次舍入带来的微小误差累积污染最终有效位数。
三、获取超高精度 Pi 的两种实用路径
路径一:直接调用 mpmath 内置的 mp.pi 常量
mpmath 内部高度封装了数学常数的快速计算策略。当你访问 mp.pi 时,它并不是一个写死的静态浮点数,而是一个计算常数对象(常数生成器)。只要你改变 mp.dps,再次访问 mp.pi 就会以当前精度即时求值。下面是直接获取 100 位和 1,000 位圆周率的完整示例:
from mpmath import mp

# 1. 设置工作精度为 100 位十进制有效数字
mp.dps = 100
pi_100 = mp.pi
print("--- 100位精度 Pi ---")
# 使用 mp.nstr 完整输出,避免被终端打印省略号截断
print(mp.nstr(pi_100, n=100))

# 2. 设置工作精度为 1000 位
mp.dps = 1000
pi_1000 = mp.pi
print("\n--- 1000位精度 Pi (前120位展示) ---")
pi_str = mp.nstr(pi_1000, n=1000)
print(pi_str[:120] + "... [后续共 " + str(len(pi_str) - 120) + " 位]")
运行结果(示例):
--- 100位精度 Pi ---
3.141592653589793238462643383279502884197169399375105820974944592307816406286208998628034825342117068

--- 1000位精度 Pi (前120位展示) ---
3.141592653589793238462643383279502884197169399375105820974944592307816406286208998628034825342117067982148086513282306647... [后续共 881 位]
路径二:基于 Chudnovsky 级数自主实现超高精度 Pi
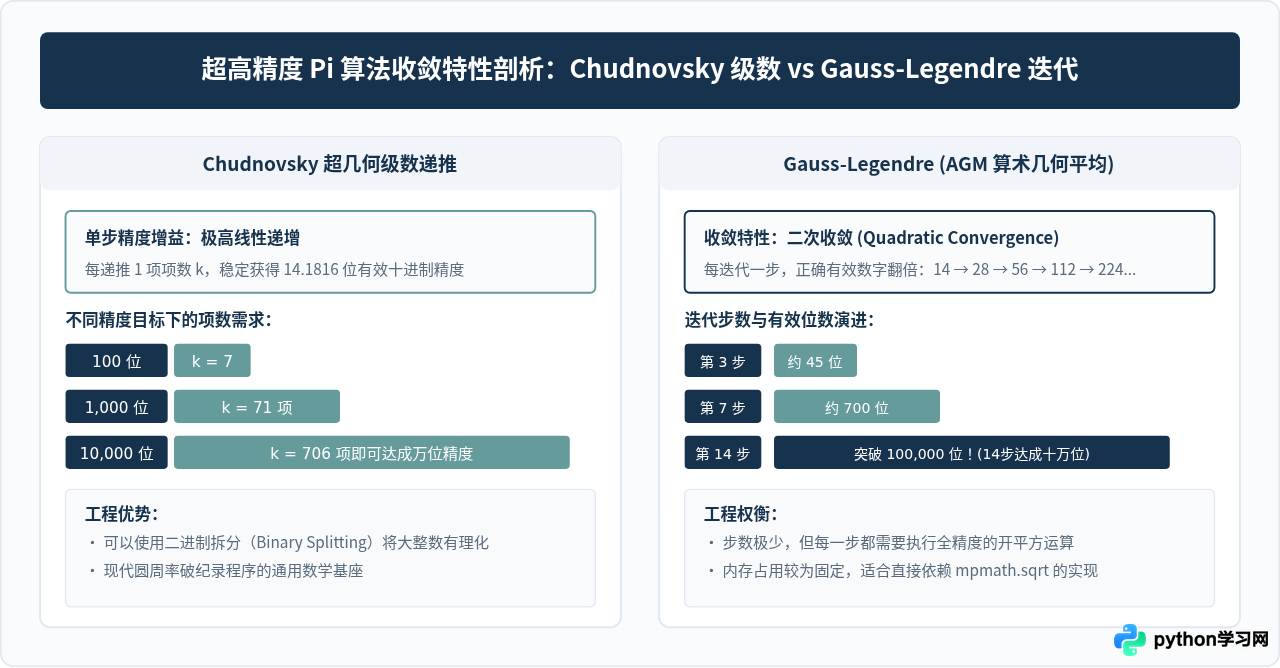
为了不仅限于“黑盒”调用,理解超高精度 Pi 的生成算法同样至关重要。目前世界上打破圆周率计算世界纪录(如数万亿位)的核心算法均源于 Chudnovsky 级数公式。该公式基于拉马努金级数推广而来:
$$\frac{1}{\pi} = 12 \sum_{k=0}^{\infty} \frac{(-1)^k (6k)! (13591409 + 545140134 k)}{(3k)! (k!)^3 (640320)^{3k + 3/2}}$$
Chudnovsky 级数的收敛速度极快,每递推一项 $k$,即可稳定增加约 14.1816 位有效十进制数字。若我们要计算 1,000 位精度,仅需迭代约 $\lceil 1000 / 14.1816 \rceil \approx 71$ 次。借助 mpmath 的大数与开方计算能力,我们可以编写出简洁且鲁棒的 Chudnovsky 求解器:
from mpmath import mp
import math

def calculate_pi_chudnovsky(target_dps):
    """
    使用 Chudnovsky 算法在指定精度下计算 Pi
    :param target_dps: 目标十进制有效位数
    :return: mpf 类型的 Pi 计算结果
    """
    # 额外增加 15 位保护精度(Guard Digits),彻底消除级数尾项累加带来的舍入误差
    with mp.workdps(target_dps + 15):
        # 预先计算所需迭代次数 (每项贡献约 14.1816 位)
        iterations = int(math.ceil(target_dps / 14.181647462725478)) + 1

        # Chudnovsky 常数定义
        C = 640320
        C3_OVER_24 = (C ** 3) // 24

        sum_total = mp.mpf(0)

        for k in range(iterations):
            # 分子: (-1)^k * (6k)! * (13591409 + 545140134 * k)
            num = ((-1) ** k) * math.factorial(6 * k) * (13591409 + 545140134 * k)
            # 分母: (3k)! * (k!)^3 * (640320)^(3k)
            den = math.factorial(3 * k) * (math.factorial(k) ** 3) * (C ** (3 * k))

            term = mp.mpf(num) / mp.mpf(den)
            sum_total += term

        # 补全公式外层系数: 12 / (640320^(3/2)) * sum_total
        # 等价于: sum_total * 12 / (640320 * sqrt(640320))
        factor = mp.mpf(12) / (mp.mpf(C) * mp.sqrt(mp.mpf(C)))
        pi_inv = factor * sum_total
        pi_val = mp.mpf(1) / pi_inv

    # 退出保护上下文后,以调用方要求的目标精度截取返回
    with mp.workdps(target_dps):
        return +pi_val

# 验证计算 500 位 Pi
if __name__ == "__main__":
    dps = 500
    my_pi = calculate_pi_chudnovsky(dps)
    print(f"Chudnovsky 500位计算完成:\n{mp.nstr(my_pi, n=dps)}")

    # 校验自研算法与 mpmath 官方库常数的一致性
    mp.dps = dps
    diff = abs(my_pi - mp.pi)
    print(f"\n与 mpmath 官方库内置常数差值: {diff}")
四、关键陷阱与性能优化建议
虽然 mpmath 的 API 语义与 Python 标准数学模块十分相似,但在超高精度模式下,如果不了解底层数据类型转换与字符串格式化的细节,极容易踩入精度丢失或性能骤降的陷阱。
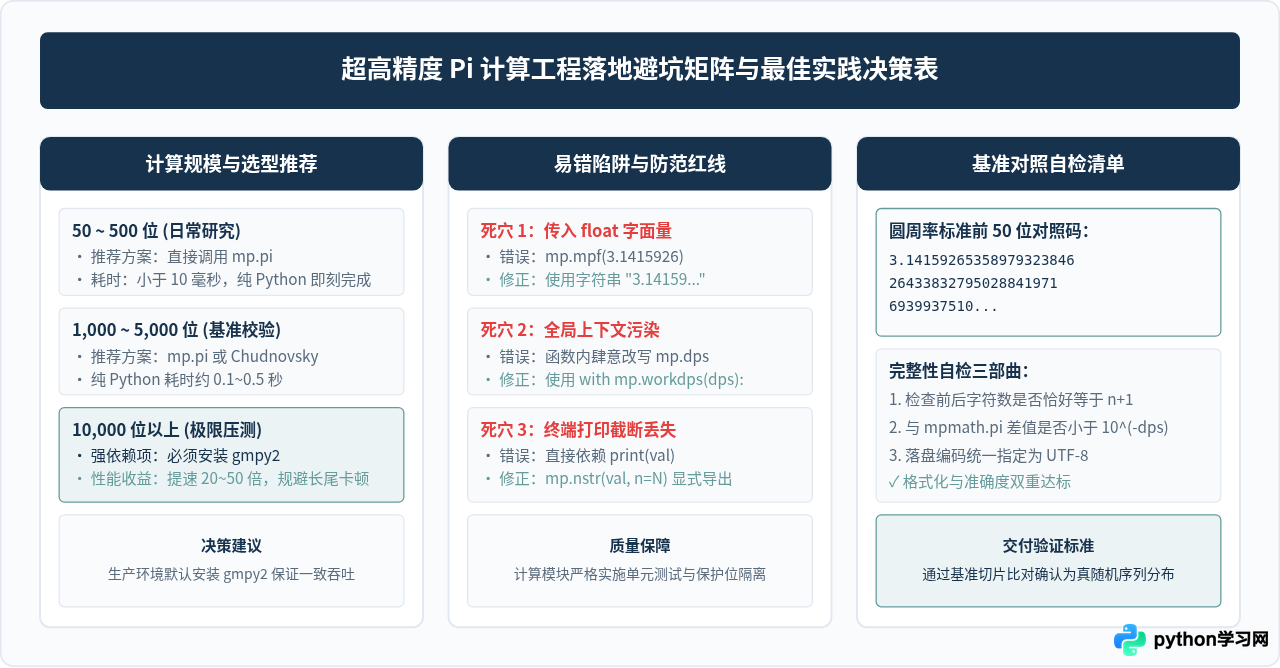
1. 陷阱一:从 Python float 隐式传参构建 mpf
这是最典型也是最隐蔽的错误。如果你写出 x = mp.mpf(3.141592653589793),即使你的 mp.dps = 1000,变量 x 的实际有效精度依然只有 16 位!因为字面量 3.141592653589793 在传递给 mpf() 构造器之前,就已经被 Python 解释器压缩为 64 位 IEEE 754 双精度浮点数了。
始终使用字符串、整数或原生分数传参:mp.mpf("3.1415926535897932384626..."),或者利用 mpmath 提供的符号表达式与大整数进行构建。
2. 陷阱二:忽略保护位导致末位扩散误差
任何数值算法在多次求和、乘除时都会产生舍入。如果你设置 mp.dps = 50 并进行 100 次迭代,最终结果的第 48 至 50 位可能已经被误差污染。在进行任意级数推导时,必须养成使用 with mp.extraprec(15): 增加保护位的习惯,计算完成后再切回目标精度进行输出。
3. 陷阱三:打印截断与大文本输出
当精度达到数千位时,直接调用 print(mp.pi) 会被 Python 交互环境或日志系统自动截短(中间展示为 ...)。为了获取完整的文本产物,应使用 mp.nstr(val, n=目标位数) 生成完整格式化字符串,并直接写入本地文件:
from mpmath import mp

mp.dps = 10000  # 一万位精度
pi_val = mp.pi

# 完整导出为纯文本文件,不经过控制台缓冲区
with open("pi_10000_digits.txt", "w", encoding="utf-8") as f:
    f.write(mp.nstr(pi_val, n=10000))
print("一万位圆周率已成功持久化至磁盘文件!")
总结
通过本文的讲解与实践,我们可以清楚地看到:Python 在超高精度数学运算领域不仅不是短板,反而得益于 mpmath 极其友好的 API 设计与可插拔的双后端体系,展现出了极高的灵活性与工程表现力。无论你是需要几百位精度用于物理常数的极小微扰分析,还是需要数万位精度用于验证 Chudnovsky 等经典级数的极限收敛性,遵循“设定工作精度 → 附加运算保护位 → 规范类型传参 → 完整格式化持久化”这一标准化工程链路,都能确保计算过程平稳无误、数值分毫不差。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















