


怎么辨别Python资源网的质量?避免过时与错误教程
面对海量网络教程,如何准确识别Python资源网的质量?本文从语法特征排查、依赖生态演进、站点采集特征与权威交叉验证等维度,提供一套立即可执行的辨别指南,助你避开过时与错误代码。
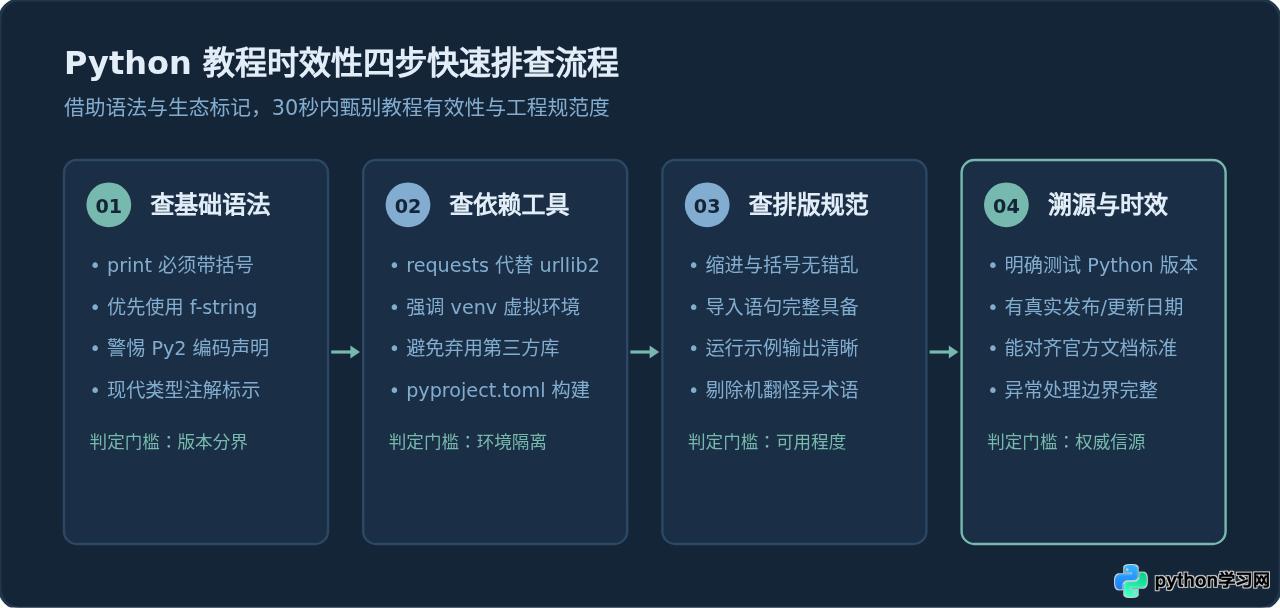
在终端中输入一段从技术博客复制的代码,屏幕上却抛出 SyntaxError: Missing parentheses in call to 'print',或者 ImportError: No module named urllib2。初学者往往会反复怀疑自己的环境配置出了纰漏,却未曾意识到问题其实出在信息源头——这段教程成文于十余年前的 Python 2 时代,早已脱离现代运行环境。在搜索引擎充斥着大量机翻聚合站、低质采集站和僵尸博客的当下,辨别 Python 资源网的质量,核心在于掌握一套快速鉴别逻辑:看语法与 API 时代特征、审依赖管理与环境规范、析站点内容组织、溯权威官方标准。掌握这套方法,读者可以在半分钟内过滤掉绝大部分失效内容。
一、第一道防线:从代码语法与核心标记快速诊断
代码本身具有极其明确的时代烙印。Python 语言在过去十几年中经历了多次关键演进,不同版本引入的语法糖和标准库重构,是辨别教程是否过时最直接的“标尺”。只要在教程正文中粗览几处关键语法,就能基本判断其技术年代。
以下是几项极具代表性的快速排查标记:
- print 语句是否有括号:如果正文中的代码仍然写作
print "Result:", val,毫无疑问是 Python 2 的遗留残余。现代 Python 3 必须使用函数调用形式print("Result:", val)。 - 字符串格式化方式:仍然大篇幅依赖
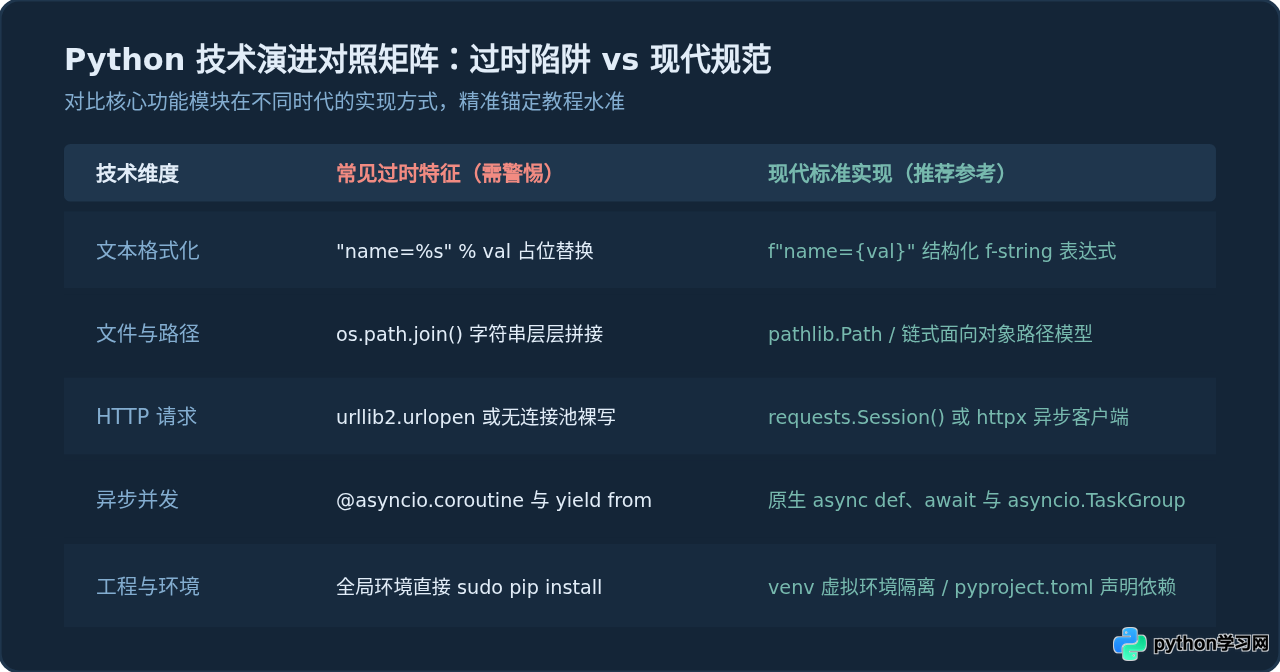
%格式化(如"user=%s" % name)甚至string.Template,且全文对str.format()或 f-string(Python 3.6+)只字不提的教程,其内容编写至少落后了数个大版本。现代工业界和高质量教程中,f-string(形如f"user={name}")已是事实上的默认写法。 - 路径与文件操作机制:早期的教程习惯使用
os.path.join()、os.path.exists()等函数反复做字符串拼接。而现代规范教程更推崇 Python 3.4 引入的pathlib.Path对象模型,写法更直观、跨平台且具有强类型安全性。 - 类型提示(Type Hints):在讨论函数定义、接口设计或较复杂的工程示例时,高质量的现代教程通常会引入类型注解(如
def process_data(items: list[str]) -> dict[str, int]:),这体现了教程作者对 Python 3.9+ 现代化工程规范的跟进。
二、第二道防线:审视依赖库选择与运行环境配置
高质量的教程不仅教授业务逻辑,还会遵循当前行业推行的工程实践。反之,低质量或严重过时的教程往往在第三方库和环境搭建步骤中暴露出严重缺陷。
1. 依赖库的过时与替代关系
Python 生态活跃,大量早期库因设计缺陷或维护停滞已被更优雅的方案取代。教程中所推荐的第三方包,直接反映了作者的视野与教程的时效:
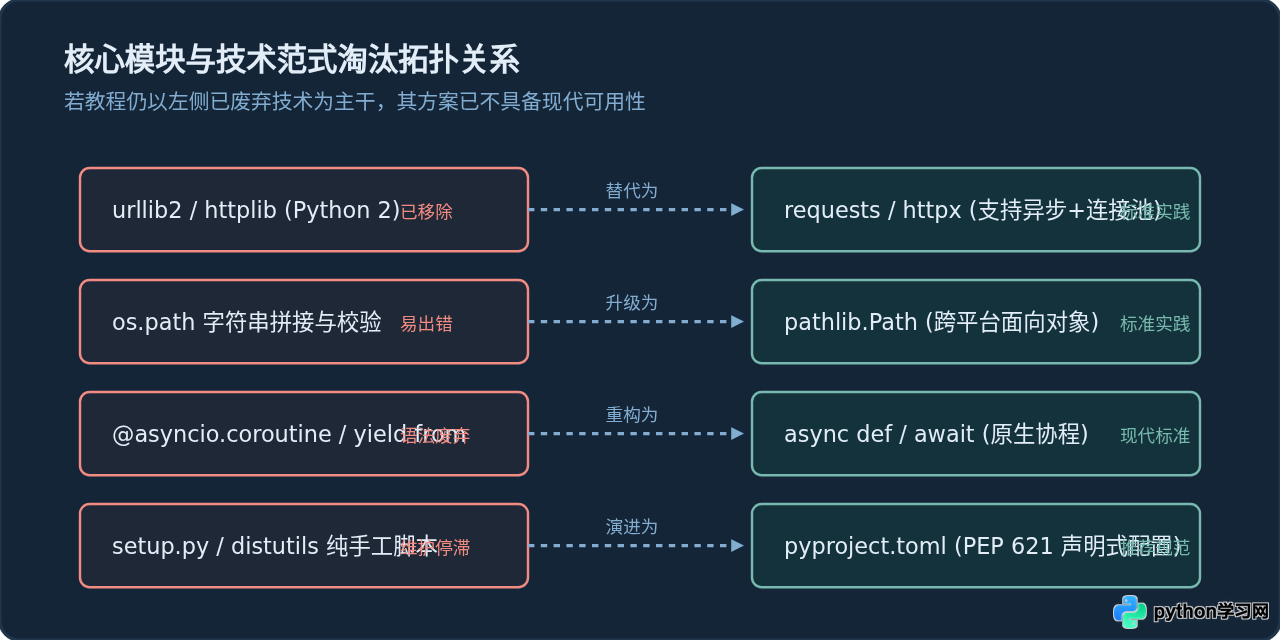
- 网络请求:教程若仍然使用内置的
urllib2(Python 3 中已拆分为urllib.request)甚至httplib,说明内容源自远古版本;即便是 Python 3,现代教程通常优先推荐requests或支持异步的高性能客户端httpx。 - 异步编程:早期 Python 3.4 采用基于生成器的协程机制,使用
@asyncio.coroutine装饰器和yield from语法。这套机制在 Python 3.8 已经被弃用,在 3.10 中彻底移除。现代教程必须是原生的async def和await。 - 项目打包与配置:凡是还在教读者纯手工编写复杂的
setup.py进行安装配置,却对pyproject.toml(PEP 517 / 518 / 621)毫无提及的项目,往往停滞在数年前的打包体系中。
2. 环境隔离与安装指令的规范性
一个严谨的教程作者绝不会在第一步就命令读者“打开终端输入 sudo pip install some-package”。现代操作系统(如主流 Linux 发行版及 macOS)已严格执行 PEP 668 规范,直接向系统解释器安装全局第三方包会遭遇 externally-managed-environment 保护错误。
高质量资源网必然会在安装步骤中明确说明:
# 步骤 1:创建并激活虚拟环境(推荐命名为 .venv)
python3 -m venv .venv
source .venv/bin/activate  # Windows 下使用 .venv\Scripts\activate

# 步骤 2:在隔离环境中安装依赖,并明确锁定版本号
pip install httpx==0.27.0
如果教程通篇忽视虚拟环境、缺失安装位置说明,甚至连第三方库的导入名称(import name)与安装包名称(install name)都不加区分,这通常是内容东拼西凑的直接证据。
三、第三道防线:识别采集站与机翻垃圾的结构特征
随着自动化内容农场的泛滥,搜索引擎中充斥着被爬虫批量抓取、伪原创或机器翻译的技术文章。这类资源网不仅提供不了有效帮助,还会带来致命的排版错误与误导。
在浏览未知站点时,可通过以下特征快速识别劣质站点:
- 排版与符号损坏:Python 极度依赖缩进。劣质采集程序在抓取清洗过程中,往往会丢失所有空格缩进,将多行代码压平成一行;或者把英文引号
"..."强行转成中文全角引号“……”,直接导致代码无法复制运行。 - 荒谬的机翻术语:低端站直接使用机器批量翻译海外问答。例如将关键字
yield翻译为“产量”或“屈服”,将None翻译为“没有”,将raise Exception翻译为“提高例外”,将string slice翻译为“串片”。读到类似生硬词汇时,应当机立断关闭网页。 - 伪造发布日期:采集站通常会使用脚本动态将文章发布时间伪造为“10分钟前发布”或“今天”,正文里却赫然写着基于 Python 2.7 的操作说明。判断文章实际年份,要以代码内的库版本与语法特性为准,而非网页顶部的动态时间戳。
- 无头无尾的断片代码:只有十几行核心逻辑,缺失了顶部关键的
import声明,也不提供输入数据样例和运行后的控制台输出。读者无法验证,也无法在本地复现。
四、建立高信噪比资源库与交叉核验工作流
辨别的最终目的是为了高效获取准确知识。与其在漫无边际的搜索引擎结果中逐条甄别,不如主动建立起分层的高信任源,并在遇到存疑内容时执行标准的交叉核验。
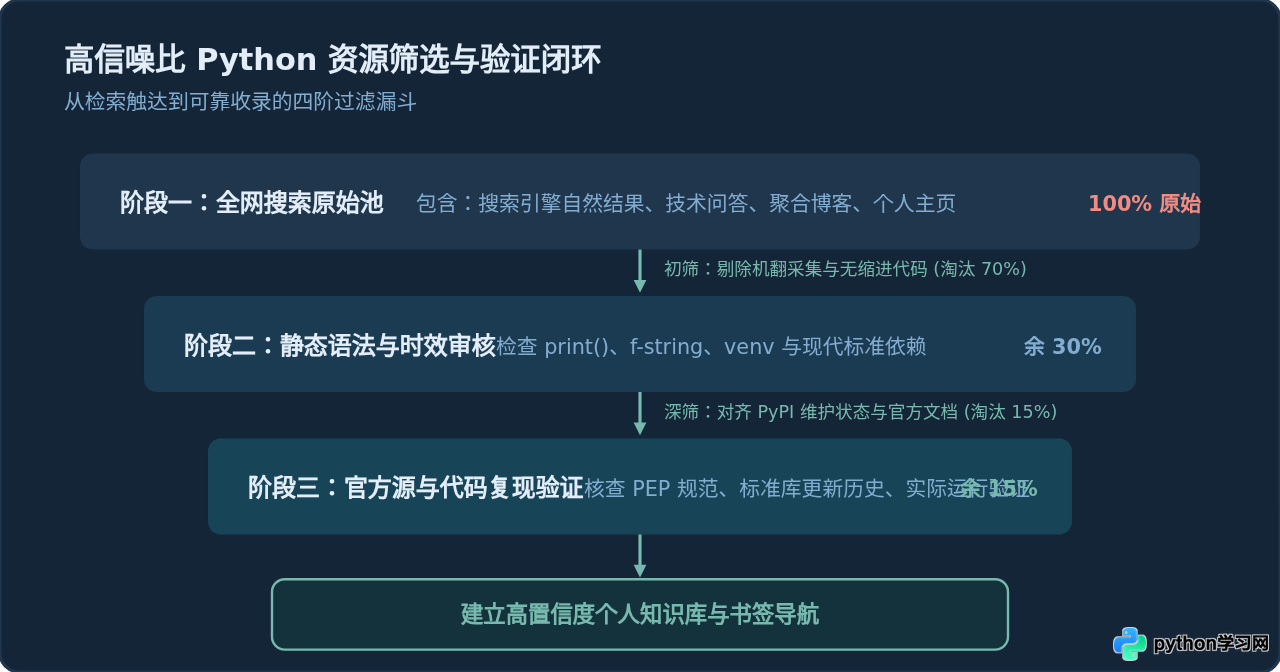
1. 值得优先参考的权威梯队
- 第一梯队:官方文档与 PEP 标准
docs.python.org/zh-cn/3/已具备高质量的官方中文翻译。阅读库的官方文档或教程时,首先看页面顶部的语言与版本切换器,确保对应版本为3.10+。此外,了解某个特性的初衷与规范边界,直接查阅对应的 PEP 文档(如 PEP 484 类型注解、PEP 572 海象运算符)最具说服力。 - 第二梯队:主流知名框架官方教程与快速入门
像 FastAPI、Pydantic、SQLAlchemy 2.0、Pandas 等活跃开源项目的官方 Tutorial,其代码组织高度贴合现代 Python 风格,往往比各类二手博客清晰完整数倍。 - 第三梯队:同行评议充分的开源社区与专业专栏
例如经过多轮审校的开源电子书(如针对现代 Python 的实战指南)、知名开源项目的 GitHub Discussions 与官方 Release Notes。
2. 一分钟交叉验证技巧
当面对一篇思路清晰但你不确定其函数是否已被弃用的教程时,不需要全文重构,只需执行以下两步:
- 查 PyPI 状态:在 pypi.org 检索教程中使用的第三方包,查看右侧的
Last updated与Requires-Python。若最后一次更新停留在四五年前,或者最高仅支持到 Python 3.6,应果断放弃并寻找替代方案。 - 查官方弃用日志(Deprecated):直接将关键函数名拼上
python doc deprecated在引擎中检索。例如查询cgi.escape,官方文档会明确标注其在 Python 3.2 弃用并在 3.8 移除,并给出替换方案html.escape。
python 3.11+ 或过滤特定低质域名,能直接屏蔽掉数以百计的历史冗余页面。
五、总结:建立主动过滤的技术阅读习惯
辨别 Python 资源网质量的过程,实质上是开发者从“被动接收代码”转向“主动审视架构”的必经之路。面对未知教程,先看 print 与字符串格式化定位年代,次看虚拟环境与依赖选型辨别工程素养,再查排版与术语识别机翻采集,最后依托官方文档锁定权威事实。建立起这套筛选直觉,不仅能帮你规避海量过时报错,更能确保你掌握的代码规范始终与现代技术前沿同频。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















