


Python re模块match、search与findall的区别及代码案例
深入解析Python标准库re模块中match、search与findall三个核心函数的执行机制、匹配范围、返回值类型差异与经典代码案例。
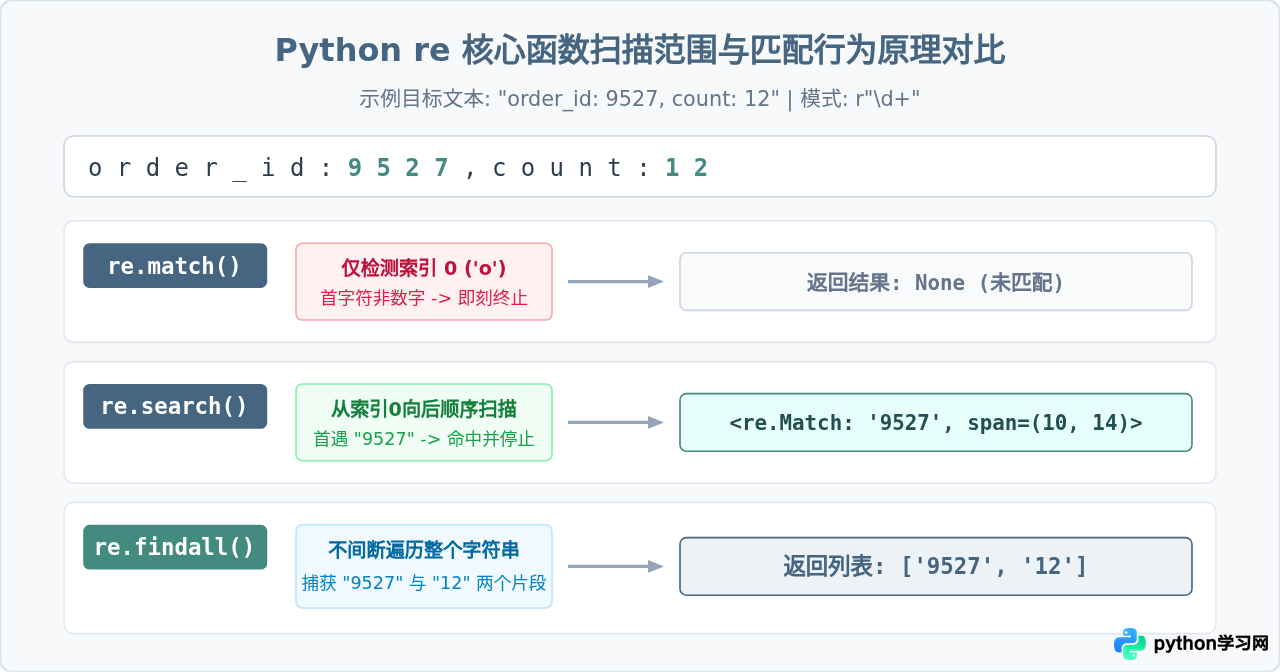
在 Python 正则表达式处理中,re.match()、re.search() 和 re.findall() 是使用频率最高却也最容易混淆的三个核心函数。三者的根本分歧在于扫描范围、匹配停止时机以及返回值的数据结构:match 仅从字符串起始位置匹配并返回首个 Match 对象;search 扫描整个字符串但找到首个有效匹配后立即返回 Match 对象;而 findall 会贯穿全文扫描并以列表(List)形式返回所有非重叠匹配项。本文通过对比原理、分部拆解与可执行代码案例,帮助读者建立清晰的选用依据。
一、核心机制差异速览
为了直观掌握三者的边界,我们首先从函数签名、扫描起点、提前退出机制与无匹配时的表现展开概括:
re.match(pattern, string):严格从字符串的第 0 位(起始位置)开始比对。只要开头第一个字符与正则表达式不符,即使后续子串完全符合模式,匹配也会直接宣告失败并返回None。re.search(pattern, string):扫描整个字符串,寻找模式出现的第一个位置。一旦找到有效匹配即刻停止后续扫描,返回封装了该匹配信息的re.Match对象;若全文均无匹配则返回None。re.findall(pattern, string):非贪婪停止,贯穿整个字符串查找所有互不重叠的匹配片段。它不返回 Match 对象,而是直接将匹配内容打包为 Python 列表(list)。若全文未找到任何匹配,则返回空列表[]。
二、re.match():前缀强校验与定点匹配
re.match() 专用于判断目标文本是否“以某模式开头”。当我们需要校验严格遵循前缀格式的数据(例如 URL 协议头、文件类型标识符、固定结构报文)时,该函数效率极高,因为它无需扫描后续冗长内容。
代码案例:前缀校验与字段提取
import re

text_valid = "HTTPS://example.com/api/v1"
text_invalid = "The protocol is HTTPS://example.com"
pattern = r"(?P<protocol>https?)://"

# 案例 1: 文本以模式开头
res1 = re.match(pattern, text_valid, re.IGNORECASE)
if res1:
    print(f"匹配成功: {res1.group()}")
    print(f"捕获组内容: {res1.group('protocol')}")
    print(f"匹配位置跨度: {res1.span()}")
else:
    print("匹配失败")

# 案例 2: 目标模式出现在文本中间
res2 = re.match(pattern, text_invalid, re.IGNORECASE)
print(f"中间匹配测试结果: {res2}")
输出示例:
匹配成功: HTTPS://
捕获组内容: HTTPS
匹配位置跨度: (0, 8)
中间匹配测试结果: None在上述案例中,text_invalid 虽然包含 HTTPS://,但由于其开头是 The,re.match() 直接返回 None。需要特别注意:对返回值为 None 的对象直接调用 .group() 将抛出 AttributeError,因此必须进行非空检查。
三、re.search():全文探测与首位提取
re.search() 解决了“模式位于字符串任意位置”的检测问题。它从左向右逐字扫描,直到找到第一个符合规则的子串。由于其具备“命中即止”的特性,在大文本中查找关键标记或首个日志错误码时非常高效。
代码案例:日志错误码首次检索
import re

log_line = "2026-10-28 10:15:20 [WARNING] user_id=1024, error_code=404, retry_code=500"
pattern = r"error_code=(\d+)"

match_obj = re.search(pattern, log_line)
if match_obj:
    print(f"完整匹配项: {match_obj.group(0)}")
    print(f"错误码数值: {match_obj.group(1)}")
    print(f"字符起始索引: {match_obj.start()}, 结束索引: {match_obj.end()}")
else:
    print("日志中未检测到错误码")
输出示例:
完整匹配项: error_code=404
错误码数值: 404
字符起始索引: 44, 结束索引: 58
从结果可见,虽然字符串末尾还有一个数字代码 500,但 re.search() 在捕获到 error_code=404 后便停止检索,只返回包含首个匹配项的 Match 对象。
四、re.findall():全量收集与捕获组结构
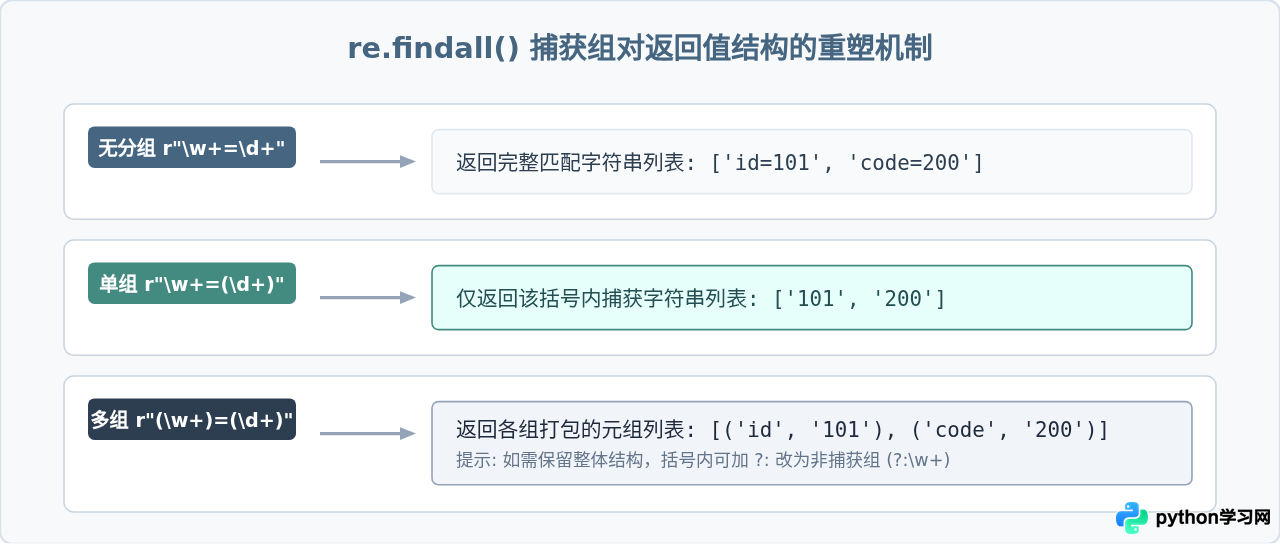
re.findall() 用于提取所有满足条件的子串。与其他两个函数不同,它的返回值不是 Match 对象,而是包含了所有结果的字符串列表。更为重要的是,正则表达式中是否存在括号捕获组 (),将直接改变 findall() 的返回数据形态。
代码案例:三种分组形态对照
import re

source_data = "item_apple: $15, item_orange: $28, item_banana: $7"

# 1. 无捕获组:获取整个键值对字符串
pattern_all = r"item_\w+:\s*\$\d+"
print("无捕获组:", re.findall(pattern_all, source_data))

# 2. 单捕获组:只提取价格数字
pattern_single_group = r"item_\w+:\s*\$(\d+)"
print("单捕获组:", re.findall(pattern_single_group, source_data))

# 3. 多捕获组:分别提取品名与价格
pattern_multi_group = r"item_(\w+):\s*\$(\d+)"
print("多捕获组:", re.findall(pattern_multi_group, source_data))
输出示例:
无捕获组: ['item_apple: $15', 'item_orange: $28', 'item_banana: $7']
单捕获组: ['15', '28', '7']
多捕获组: [('apple', '15'), ('orange', '28'), ('banana', '7')]
在实际开发中,如果为了逻辑组织需要使用括号(例如 r"https?://(www\.)?example\.com"),但又希望 findall 输出完整匹配串,应当使用非捕获组语法 (?:...),避免结果被意外过滤截断。
五、三者核心特性对比与选型决策
为了帮助读者在具体编码场景中快速定型,下表对三个函数的核心属性进行了系统对照:
| 比较维度 | re.match() | re.search() | re.findall() |
|---|---|---|---|
| 匹配起始位置 | 必须从字符串第 0 位开始 | 从第 0 位向后扫描任意位置 | 贯穿整个字符串全文扫描 |
| 匹配目标数量 | 至多匹配 1 项 | 至多匹配 1 项(首遇项) | 全部非重叠匹配项(0 到 N) |
| 成功返回值 | re.Match 实例对象 |
re.Match 实例对象 |
list 列表(元素为字符串或元组) |
| 无匹配返回值 | None |
None |
空列表 [] |
| 获取匹配位置 | 支持(.span(), .start()) |
支持(.span(), .start()) |
不支持(仅含提取内容,无下标) |
| 典型适用场景 | 协议头、前缀检验、命令起始格式 | 单次关键词查找、全局探测抽取 | 批量提取、数据清洗、多指标解析 |
六、安全调用规范与工程最佳实践
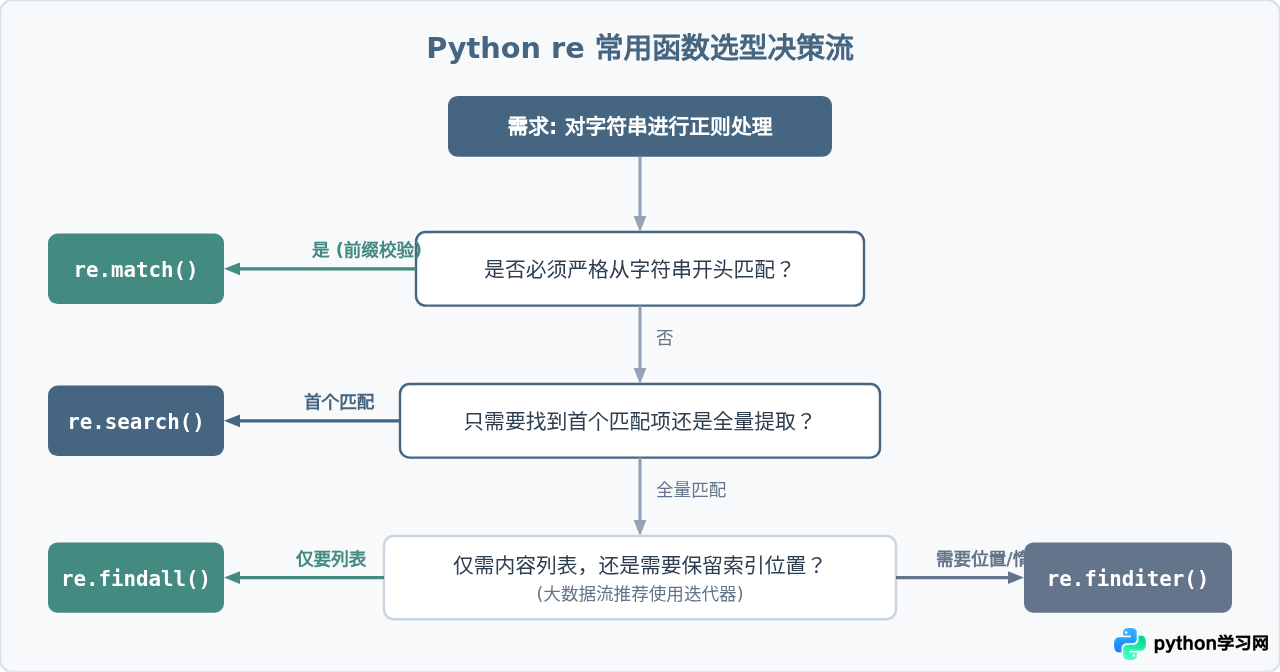
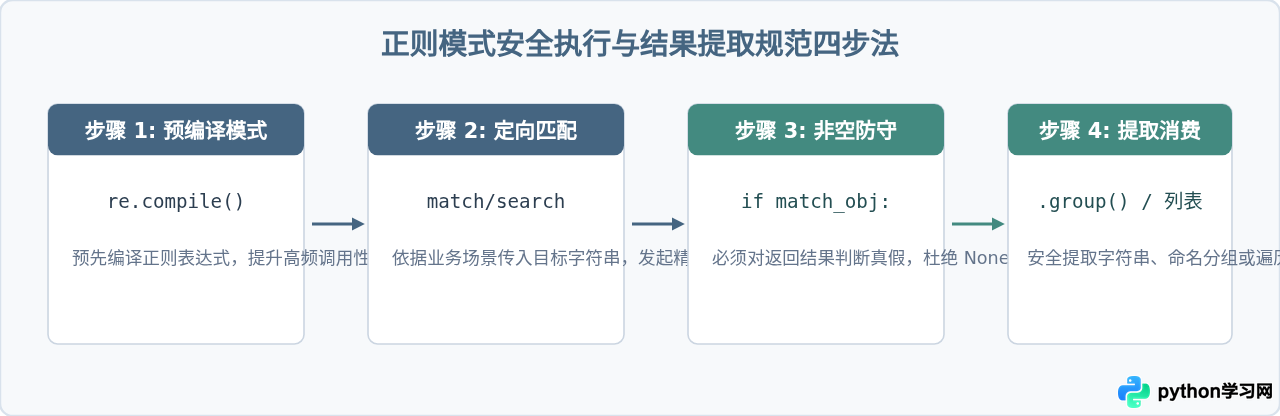
在生产代码中编写正则处理逻辑时,为了防止服务因为空指针异常崩溃,或在大并发下由于正则重复解析引发性能瓶颈,建议遵循标准操作流程。
1. 警惕 NoneType 引发的 AttributeError
初学者最常犯的错误是不做判断就链式调用 re.search(...).group()。当字符串不匹配时,函数返回 None,直接调用会触发 AttributeError: 'NoneType' object has no attribute 'group'。推荐使用海象运算符(Python 3.8+)或者标准防御语句:
import re

text = "status: pending"
pattern = r"code=(\d+)"

# 推荐写法: 海象运算符兼顾简洁与安全
if m := re.search(pattern, text):
    code_value = m.group(1)
else:
    code_value = "default_code"

print(f"最终判定代码: {code_value}")
2. 高频循环中优先使用 re.compile()
直接调用 re.match() 或 re.search() 时,Python 内部虽然维护了少量模式缓存,但在数万次以上的密集循环中,显式调用 re.compile() 将模式编译为 Pattern 对象能免除哈希查找开销,使程序意图更明确:
import re

# 提前编译为 Pattern 对象
pattern_obj = re.compile(r"^\d{4}-\d{2}-\d{2}$")

dates_to_check = ["2026-10-28", "2026/10/28", "2026-12-01"]
valid_dates = [d for d in dates_to_check if pattern_obj.match(d)]
print(f"合法日期列表: {valid_dates}")
3. 海量匹配优先考虑 re.finditer()
当目标文本包含数千个匹配项,或者目标文本大小达数十兆字节时,re.findall() 会一次性把所有字符串实例化并塞入内存列表中。此时可改用 re.finditer(),它返回一个惰性迭代器,每次 next() 只产生一个 Match 对象,大幅降低内存峰值消耗。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















