


Python异步爬虫模块对比:aiohttp与httpx在高并发下的表现
深入对比Python主流异步网络库aiohttp与httpx在高并发爬虫场景下的表现,从底层架构、吞吐量(RPS)、内存占用、连接池复用机制到实际代码调优,提供清晰实用的选型指南。
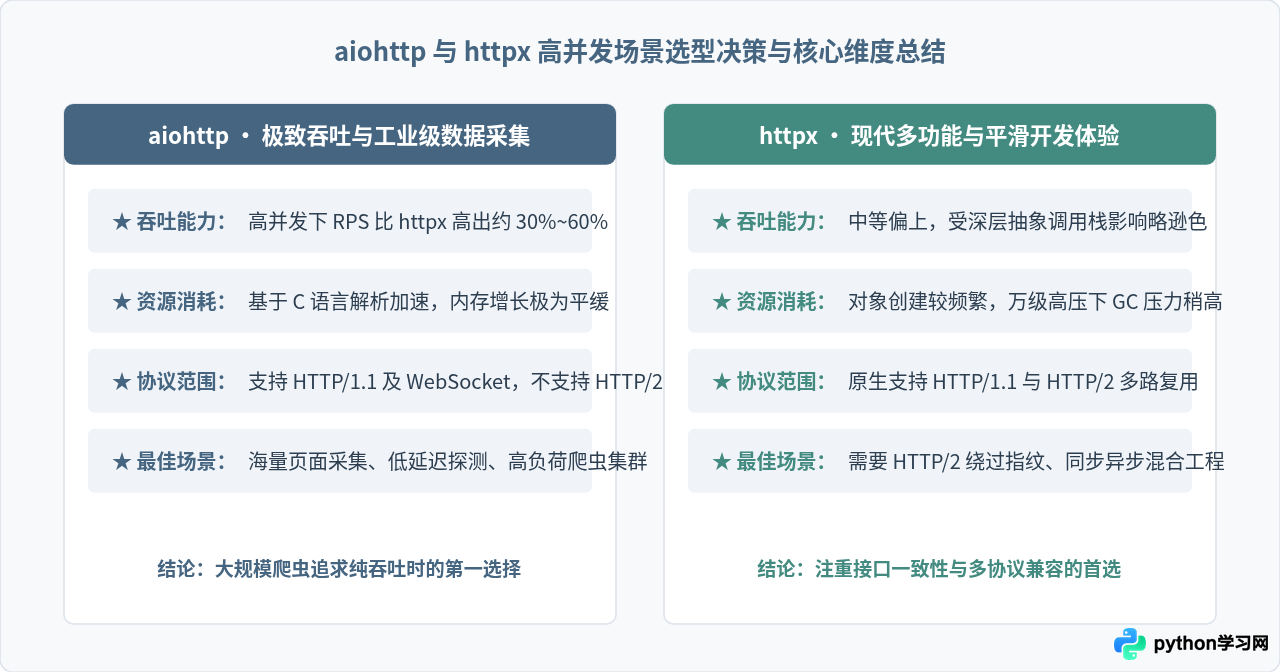
asyncio 深度优化的轻量架构与 C 语言扩展解析器,在纯请求吞吐量(RPS)和内存占用上具备更显著的性能优势;而 httpx 拥有与 requests 极为贴近的现代 API、同步与异步双模式驱动以及原生的 HTTP/2 支持,更适合多协议适配和对代码组织体验要求更高的中大型爬虫项目。
一、核心架构与内部执行机制解析
要理解两者在高并发场景下的性能分水岭,必须先深入其底层架构设计。异步爬虫在高并发下的瓶颈不仅在于操作系统网络套接字(Socket)的 I/O 处理,更在于 Python 解释器在用户态处理对象分配、协程切换、上下文管理及 HTTP 协议报文解析的 CPU 消耗。
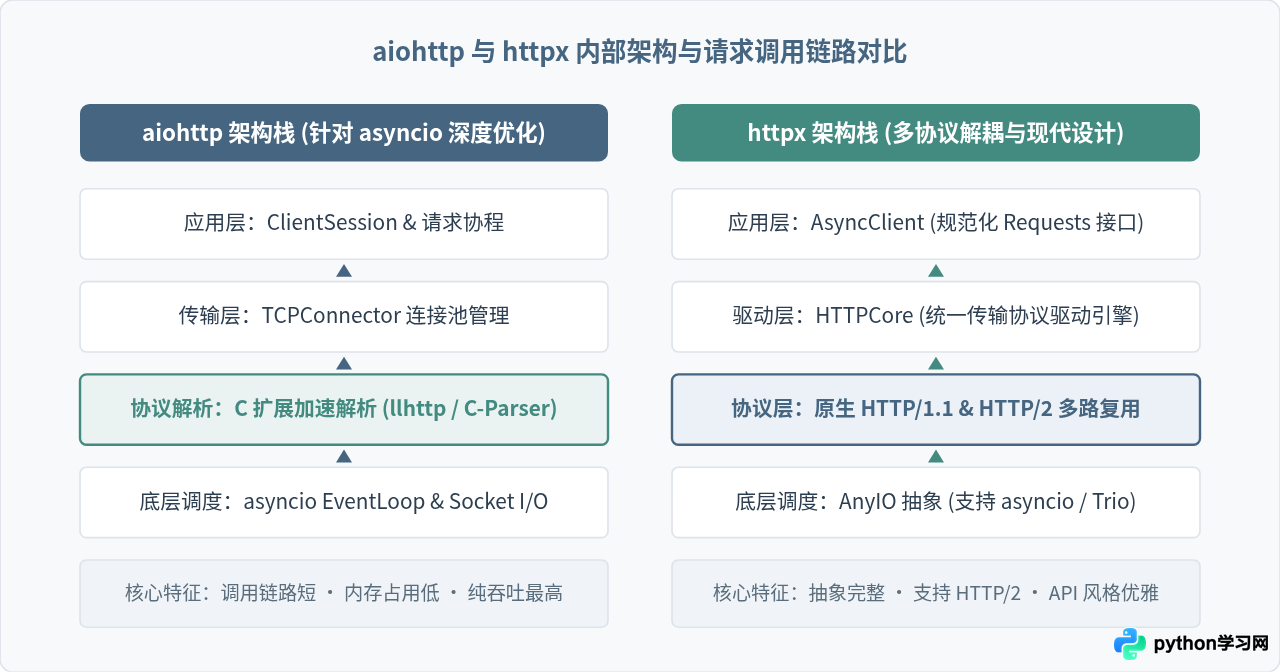
aiohttp 自设计之初就完全围绕 Python 原生标准库 asyncio 构建。为了压榨协议解析速度,aiohttp 默认集成了基于 C 语言编写的高性能解析库(如 llhttp 或 aiohttp._http_parser),能够绕过部分纯 Python 运行时的开销。在发送和接收报文时,其函数调用链路非常紧凑,几乎没有多余的抽象层。
httpx 则采用了分层解耦的架构设计。其上层提供现代化的客户端接口,中间层通过独立的传输驱动库 httpcore 统一调度网络连接,底层抽象层则依托 AnyIO 支持跨框架运行(既可以在 asyncio 下工作,也可以在 Trio 下工作)。这种高度模块化赋予了 httpx 原生支持 HTTP/2 协议多路复用的能力,但同时也带来了更深的方法调用栈和更多的内部中间对象创建,在万级并发快速循环中会产生额外的 CPU 消耗。
二、高并发核心性能指标对比与分析
在控制变量的基准测试场景下(使用局部高性能异步测试服务器,消除外网抖动,模拟 10,000 个 HTTP 请求在不同并发窗口下的完成情况),两个模块呈现出了差异明显的数据特征。
| 评测维度 | aiohttp (HTTP/1.1) | httpx (HTTP/1.1) | httpx (开启 HTTP/2) |
|---|---|---|---|
| 平均吞吐量 (RPS) | 较高(基准水平 100%) | 中等(约为 aiohttp 的 60% ~ 75%) | 受 CPU 计算影响,并发较高时约为 aiohttp 的 50% ~ 65% |
| 内存占用增长率 | 平缓,GC 回收迅速 | 相对较高,对象链较长 | 中等(依赖单个持久连接复用帧) |
| 高负载 CPU 消耗 | 较低,C 扩展承担密集解析 | 较高,纯 Python 封装与层级转发 | 较高,HPACK 头压缩与多路复用调度消耗 CPU |
| 连接池管理机制 | TCPConnector (基于 host 细粒度控制) | Limits (基于最大总连接与 Keepalive 限制) | 单主机复用连接,减少 TCP 握手开销 |
| 协议完整性 | 仅支持 HTTP/1.1 与 WebSocket | 原生支持 HTTP/1.1 与 HTTP/2 | 原生多路复用,有效降低连接建立握手 |
1. 为什么 aiohttp 的吞吐量更高?
当并发数上升到 500 以上时,网络爬虫的耗时不再仅仅受限于带宽。每个请求的创建、分发、状态更新、数据块拼装都会在事件循环中生成事件回调。aiohttp 将 ClientSession 视为轻量级的请求分发管道,其内置的 C 解析器能够极快地将原始 TCP 字节流切分为 HTTP Header 与 Body,减少了 Python 虚拟机的字节码执行次数。
而 httpx 因为要维护统一的 Request/Response 响应模型,并在 httpcore 与 httpx 之间流转数据,高频请求下创建的中间小对象显著增多,容易引发 Python 垃圾回收器(Garbage Collector)频繁进行分代回收,从而导致事件循环产生短暂微停顿。
2. HTTP/2 多路复用对爬虫并发的实际影响
HTTP/2 允许在同一个 TCP 连接上并发交错发送多个请求与响应帧。对于目标服务器强制要求 HTTP/2、或者对单个 IP 频繁建立 TCP 握手极为敏感的反爬系统,httpx 开启 http2=True 后可以通过少量的物理连接发起数百个并发抓取请求,极大减少了 TCP 握手和 TLS 协商的耗时。但在服务端未限制握手且仅比拼纯处理速度的局域网/内网测试中,HTTP/2 客户端由于需要进行二进制分帧和头信息解压缩,在 CPU 密集型的 Python 爬虫进程中反而可能比高效的 HTTP/1.1 跑出稍低的纯 RPS。
三、高并发爬虫生产级代码实现与关键配置
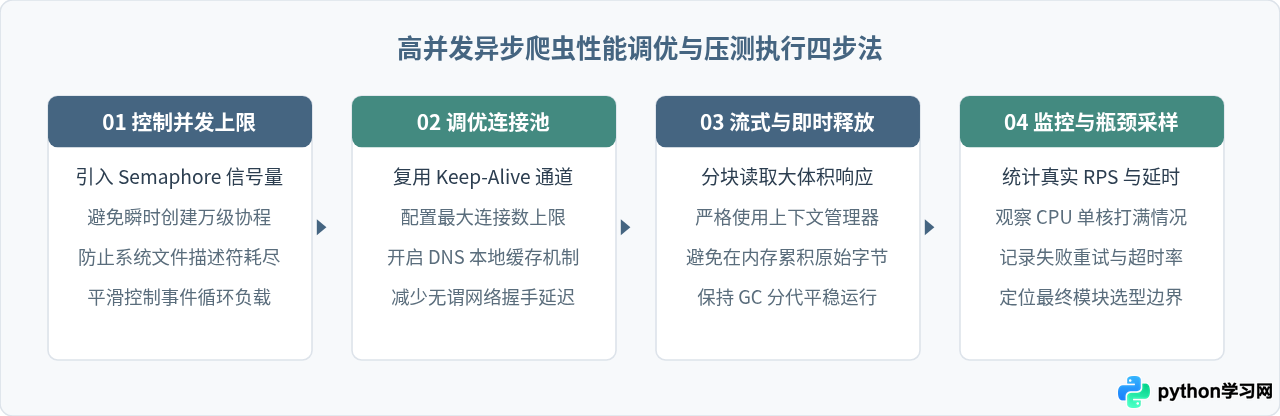
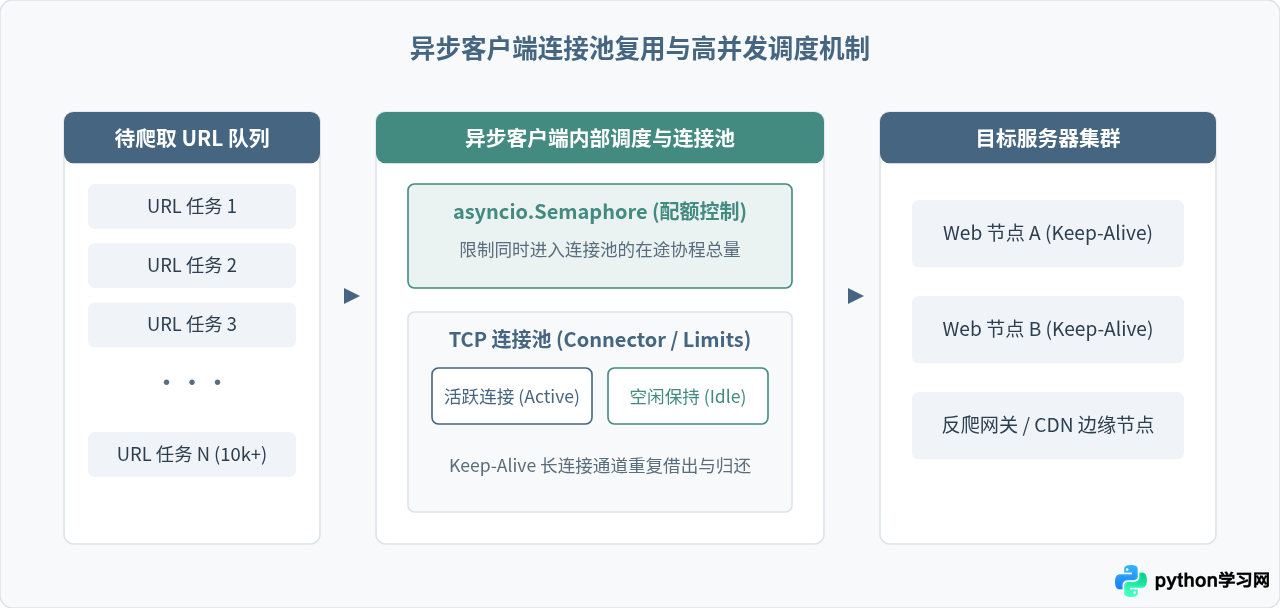
在高并发场景下,无论选用哪个模块,绝对不能无节制地创建协程并不设限地调用 get()。若直接使用 asyncio.gather 触发数万个未控流的请求,会导致操作系统句柄耗尽并抛出 OSError: Too many open files。正规做法是通过 asyncio.Semaphore 配合全局客户端连接池进行受控调度。
1. aiohttp 高并发标准模板与调优参数
在 aiohttp 中,连接池由 aiohttp.TCPConnector 控制。关键参数包括:limit(全局最大并发连接数)、limit_per_host(单域名最大连接数)以及 ttl_dns_cache(DNS 解析缓存时效)。同时必须配置 ClientTimeout,防止某个滞后连接卡死工作协程。
import asyncio
import aiohttp

async def fetch_aiohttp(session: aiohttp.ClientSession, url: str, sem: asyncio.Semaphore) -> int:
    async with sem:
        try:
            async with session.get(url) as response:
                # 读取状态码与文本,及时释放底层 socket
                text = await response.text()
                return response.status
        except Exception as e:
            # 生产环境记录日志或重试
            return 0

async def main_aiohttp(urls: list[str], max_concurrency: int = 200):
    # 调优连接池:复用长连接、开启 300 秒 DNS 本地缓存
    connector = aiohttp.TCPConnector(
        limit=max_concurrency,
        limit_per_host=50,
        ttl_dns_cache=300,
        enable_cleanup_closed=True
    )
    timeout = aiohttp.ClientTimeout(total=10, connect=3)
    sem = asyncio.Semaphore(max_concurrency)

    async with aiohttp.ClientSession(connector=connector, timeout=timeout) as session:
        tasks = [fetch_aiohttp(session, url, sem) for url in urls]
        results = await asyncio.gather(*tasks)
        print(f"aiohttp 完成抓取: 总数 {len(results)}, 成功率: {results.count(200) / len(results):.2%}")

if __name__ == "__main__":
    test_urls = ["https://httpbin.org/get"] * 1000
    asyncio.run(main_aiohttp(test_urls))
2. httpx 高并发标准模板与调优参数
在 httpx 中,连接池由 httpx.Limits 控制,主要参数包括 max_connections 与 max_keepalive_connections。若目标站点支持 HTTP/2,可传入 http2=True。
import asyncio
import httpx

async def fetch_httpx(client: httpx.AsyncClient, url: str, sem: asyncio.Semaphore) -> int:
    async with sem:
        try:
            response = await client.get(url)
            return response.status_code
        except Exception as e:
            return 0

async def main_httpx(urls: list[str], max_concurrency: int = 200):
    # 配置连接池大小与空闲保持数
    limits = httpx.Limits(
        max_connections=max_concurrency,
        max_keepalive_connections=50,
        keepalive_expiry=30.0
    )
    timeout = httpx.Timeout(10.0, connect=3.0)
    sem = asyncio.Semaphore(max_concurrency)

    # 如需多路复用支持,可设置 http2=True(需预装 httpx[http2])
    async with httpx.AsyncClient(limits=limits, timeout=timeout, http2=False) as client:
        tasks = [fetch_httpx(client, url, sem) for url in urls]
        results = await asyncio.gather(*tasks)
        print(f"httpx 完成抓取: 总数 {len(results)}, 成功率: {results.count(200) / len(results):.2%}")

if __name__ == "__main__":
    test_urls = ["https://httpbin.org/get"] * 1000
asyncio.run(main_httpx(test_urls))ClientSession 或 AsyncClient 都是常见严重错误。每一个 Client 实例内部都独立维护着连接池与 DNS 解析器。在高并发下如果频繁在单次请求里 async with aiohttp.ClientSession():,会导致连接池失效、TCP 连接被立即丢弃,并引发大量处于 TIME_WAIT 状态的端口占用。务必确保全局共享同一个客户端实例。
四、选型决策指南与核心建议
在进行实际技术选型时,不应脱离业务特点单纯对比跑分。aiohttp 与 httpx 并非互斥的对立选择,而是服务于不同侧重点的优秀工具:
1. 优先选择 aiohttp 的场景
- 超大规模批量数据抓取:爬虫目标为千万级 URL、监控类实时数据流或高频指标轮询,首要瓶颈是本机的 CPU 和并发请求吞吐率。
- 纯 asyncio 生态系统:整个爬虫框架完全基于 Python 原生异步,无需与同步阻塞逻辑混合,追求最低的内存驻留与运行损耗。
- 目标站点仅提供 HTTP/1.1 接口:此时 httpx 的 HTTP/2 优势无法体现,aiohttp 更加精炼的底层解析能够直接转化为更高的 RPS。
2. 优先选择 httpx 的场景
- 强制依赖 HTTP/2 特性的站点:某些高防御网站对 HTTP/1.1 的大量高频并发连接会施加严格的封锁策略,而通过 HTTP/2 单连接多路复用可以模拟更真实的现代浏览器网络流量。
- 代码库需同时兼顾同步与异步调用:例如某些通用 SDK 或通用爬虫解析管线既有同步调用场景也有异步驱动模式,使用 httpx 可以保持完全一致的请求参数接口与响应结构体对象。
- 偏好类 requests 的极简开发体验:httpx 在参数命名、异常体系设计以及文件上传、JSON 解析等细节上与 requests 高度契合,能显著缩短团队开发周期。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















