


怎么用Python函数实现汉诺塔算法?
本文详细讲解如何使用Python函数通过递归实现汉诺塔算法,从核心逻辑拆解、完整可执行代码、三阶汉诺塔移动全过程、递归调用栈分析到进阶生成器实现与避坑指南,通俗清晰。
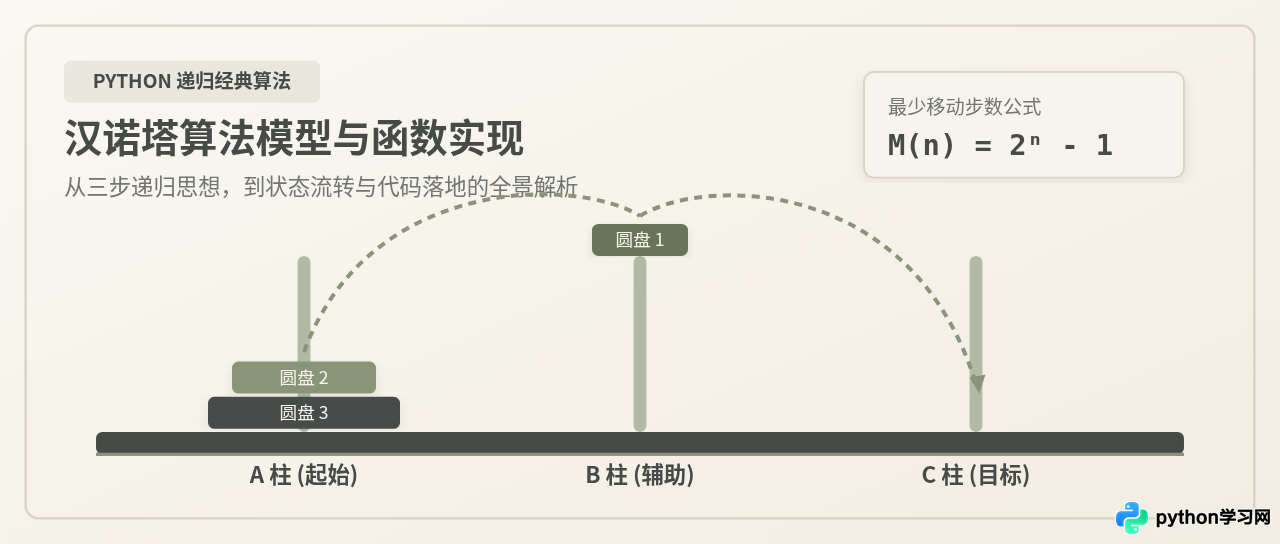
一、汉诺塔规则与递归拆解本质
汉诺塔(Tower of Hanoi)是源于印度的古老益智问题。游戏在三根柱子(常标记为 A、B、C)之间进行,初始时 A 柱上按自下而上由大到小的顺序套有 n 个圆盘。算法的目标是在遵循以下两条刚性约束的前提下,将所有圆盘完整移至目标柱 C:
- 单次单动:每次只能将某一根柱子最顶层的一个圆盘移动到另一根柱子上。
- 大盘不压小盘:在任何移动环节中,较小圆盘的上方都严禁放置较大圆盘。
初次接触此问题的读者,往往会尝试顺着盘子的具体编号(如 1、2、3 号盘)去预演每一步该放到哪根柱子,甚至试图在 Python 中维护三个列表来实时模拟每根柱子的盘面物理状态。但随着盘数增加,状态组合数呈指数爆炸,这种“步步追踪”的直觉往往会导致代码陷入极其繁复的条件判断中。
真正的解题破局点在于分治与递归抽象。无论圆盘总数 n 有多大,我们都可以把底部的第 n 个(也是最大的)圆盘与它上方的“n-1 个圆盘的组合体”分开看待:
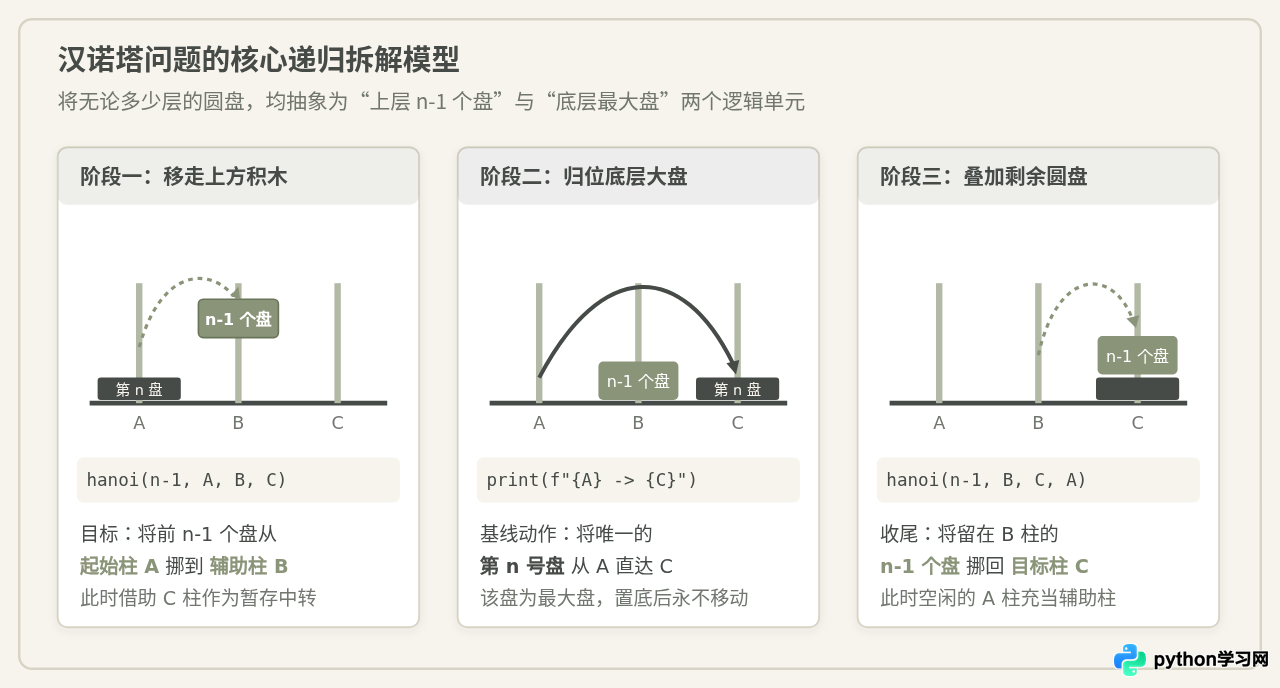
如图 1 所示,整个求解序列被精确分割为三个宏观阶段:
- 阶段一(压制解除):将上层 n-1 个圆盘从起始柱挪走,暂存到辅助柱 B 上。此时目标柱 C 充当了临时中转通道。
- 阶段二(基座归位):此时起始柱 A 上只剩最大的第 n 个圆盘,目标柱 C 亦处于空置或仅含更大基座的状态,直接将该盘从 A 移到 C。
- 阶段三(整体聚合):将在辅助柱 B 上的 n-1 个圆盘完整迁移至目标柱 C 上,此时已归位的第 n 个大盘由于比它们都要大,完全不影响上方盘子的合法移动。
二、Python 代码实现与逐行拆解
在 Python 中,我们定义一个名为 hanoi 的函数。为了让代码含义一目了然,我们为柱子设置具备明确角色意义的形参名称:source(起始柱)、target(目标柱)、auxiliary(辅助中转柱)。
def hanoi(n, source, target, auxiliary):
    # 基线条件:只剩一个圆盘时,直接一步到达目标柱
    if n == 1:
        print(f"{source} -> {target}")
        return

    # 步骤 1:将上方 n-1 个圆盘从 source 移到 auxiliary,target 作为中转
    hanoi(n - 1, source, auxiliary, target)

    # 步骤 2:将底层的第 n 个圆盘直接从 source 移到 target
    print(f"{source} -> {target}")

    # 步骤 3:将辅助柱 auxiliary 上的 n-1 个圆盘移到 target,source 作为中转
    hanoi(n - 1, auxiliary, target, source)
1. 函数核心代码的关键点说明
-
基线条件(Base Case):
if n == 1:是递归能够收敛退出的保障。当规模缩减到只剩 1 个盘子时,它没有上方任何压制物,直接从当前起始柱移向当前目标柱即可,无需再进行子任务拆分。 -
第一次递归调用的参数换位:
hanoi(n - 1, source, auxiliary, target)。注意第二和第三个参数的位置,实参传入的是auxiliary(作为该子调用的目标)与target(作为该子调用的辅助柱)。 -
中间步的物理动作:
print(f"{source} -> {target}")仅代表单次合法移动。此时移动的是当前子问题中最大的那个盘子。 -
第二次递归调用的参数换位:
hanoi(n - 1, auxiliary, target, source)。此时存放在auxiliary上的盘子成为新的起点,最终目标是target,而原来的source则转换为了临时中转柱。
2. 运行示例与输出验证
我们以最经典的 3 层圆盘(n=3)为例执行该函数:
if __name__ == "__main__":
    print("--- 三阶汉诺塔移动步骤 ---")
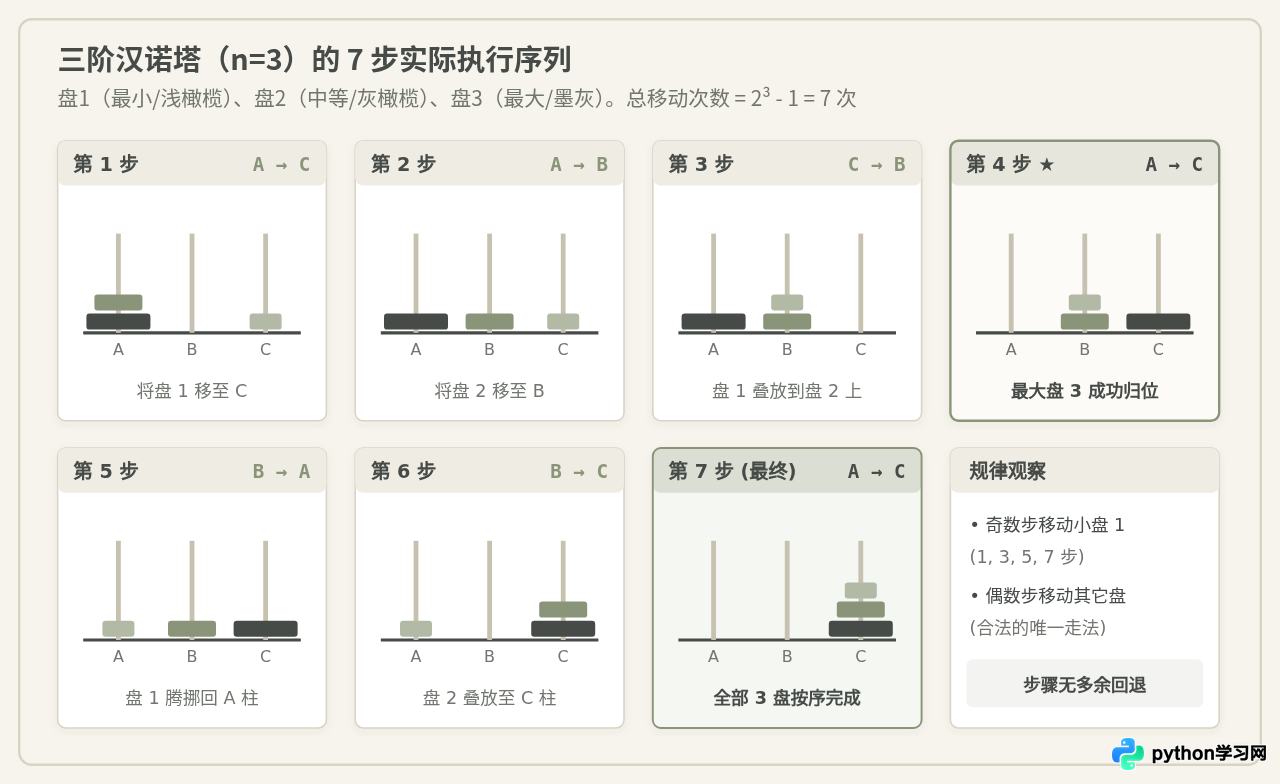
hanoi(3, 'A', 'C', 'B')--- 三阶汉诺塔移动步骤 --- A -> C A -> B C -> B A -> C B -> A B -> C A -> C
三、递归调用栈与常见认知辨析
理解汉诺塔算法最大的认知门槛在于:函数里的形参名与外部传入的柱子标识之间的动态映射关系。
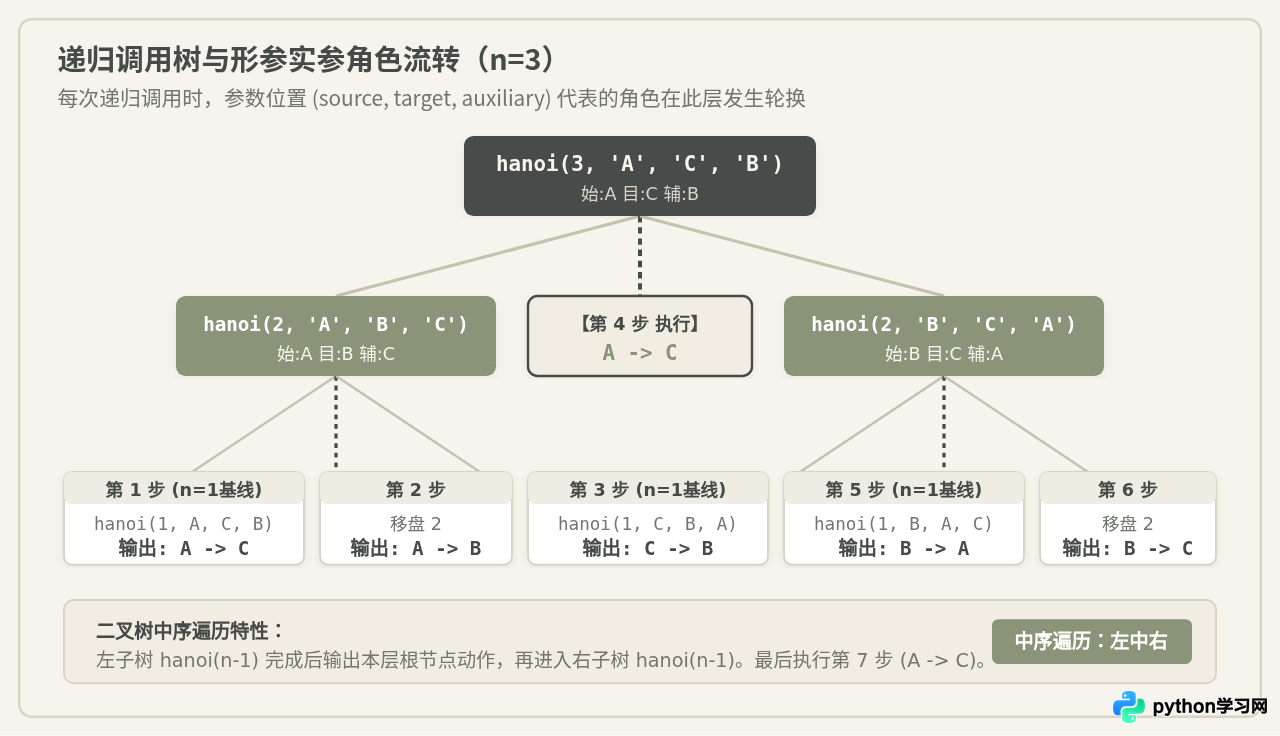
常见困惑辨析:柱子名称是不是写死的?
初学者常常产生误解:“为什么传进去的是 A、B、C,函数执行到后半段却输出了从 B 到 C,难道 Python 会感知柱子上的盘子数量吗?”
辨析与原因:
答案是 Python 并未维护任何物理盘子状态,这完全归功于实参按位置传递给形参时的角色轮换。
- 在顶层调用
hanoi(3, 'A', 'C', 'B')中:source='A',target='C',auxiliary='B'。 - 进入第一个子递归时执行
hanoi(2, source, auxiliary, target),即实参传入('A', 'B', 'C')。在新的函数栈帧里,形参target接收到的值实际上是字符'B'!因此该层下所有的“移向 target”动作,输出的都是-> B。 - 进入第二个子递归时执行
hanoi(2, auxiliary, target, source),实参传入('B', 'C', 'A')。此时形参source接收到的值变为了'B'。
每一个栈帧都完整保存了自己的变量上下文,随着递归的深入(压栈)与回溯(出栈),各根柱子在“起点、终点、中转”三个角色间自如轮换。
四、进阶实用优化:生成器与规模开销
在实际工程或复杂交互项目中,直接在递归函数内使用 print() 输出存在明显局限:如果上层调用方希望在界面上播放移动动画、记录操作日志或将轨迹存入数据库,硬编码打印会导致逻辑强耦合。
1. 使用 Python yield 生成器按需生成步数
当盘数增加时,如果将全部移动步骤一次性构造为列表返回,会占用可观的内存空间。使用 Python 的生成器 yield from 可以在不消耗额外内存的前提下,实现流式按需消费:
def hanoi_generator(n, source, target, auxiliary):
    """生成器形式的汉诺塔算法,按需产出每一步移动元组 (from, to)"""
    if n == 1:
        yield (source, target)
        return

    yield from hanoi_generator(n - 1, source, auxiliary, target)
    yield (source, target)
    yield from hanoi_generator(n - 1, auxiliary, target)

# 外部调用与消费
for step_num, (src, tgt) in enumerate(hanoi_generator(3, 'A', 'C', 'B'), 1):
    print(f"第 {step_num} 步: {src} 移至 {tgt}")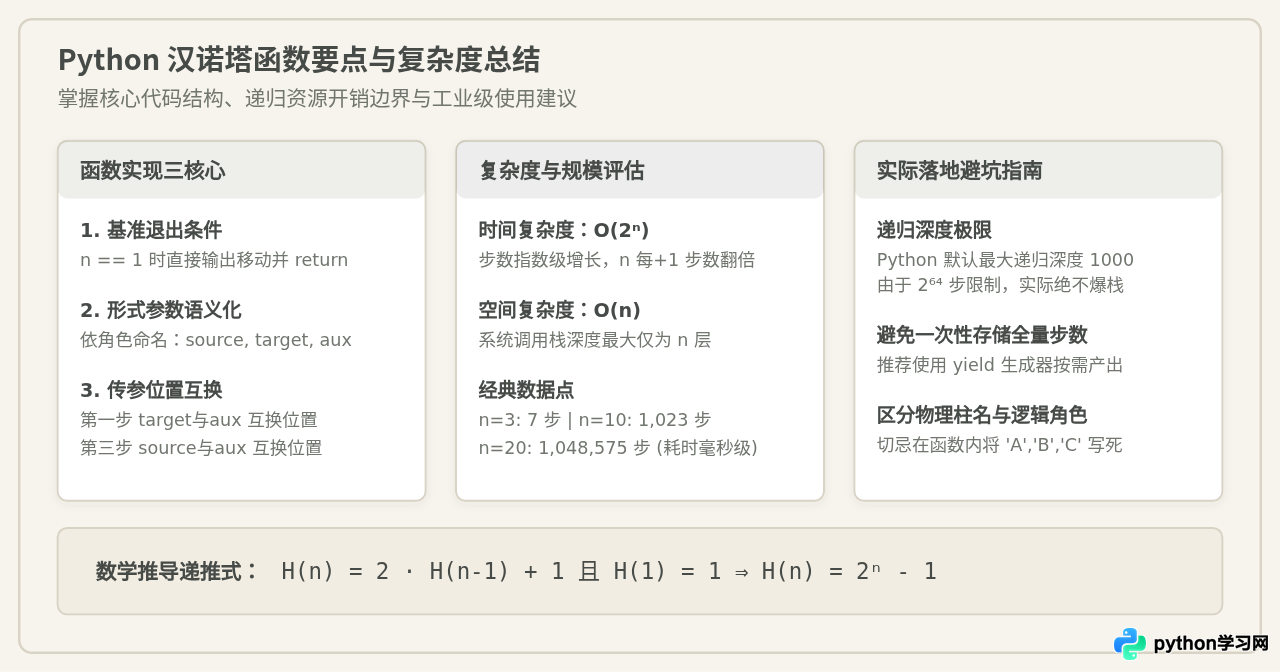
2. 时间与空间复杂度解析
| 盘数 (n) | 理论移动步数 (2ⁿ - 1) | 时间复杂度 | 最大调用栈深度(空间复杂度) |
|---|---|---|---|
| n = 1 | 1 步 | O(1) | 1 层 |
| n = 3 | 7 步 | O(2³) | 3 层 |
| n = 10 | 1,023 步 | O(2¹⁰) | 10 层 |
| n = 20 | 1,048,575 步 | O(2²⁰) | 20 层 |
| n = 64 | 18,446,744,073,709,551,615 步 | O(2⁶⁴)(计算需数千亿年) | 64 层(系统内存无压力) |
从上表可以清晰看出汉诺塔的一个迷人特性:极低的空间开销与极高的时间开销并存。
- 空间复杂度仅为 O(n):在任何一个特定时刻,递归栈的最大深度等于树的高度,即圆盘总数 n。即使是神话传说中的 64 层汉诺塔,Python 递归深度也只有 64 层,远低于系统默认的 1000 层上限。
- 时间复杂度达到 O(2ⁿ):由于步数递推关系满足 H(n) = 2H(n-1) + 1,步数随着 n 的增加发生指数爆炸。通常在单台普通电脑上,n 超过 25 就会产生明显的耗时,n 达到 30 以上若要打印所有步骤便难以在常规时间内运行完毕。
五、常见问题排查与避坑指南
-
排查问题:输出的步骤中出现了小盘在下、大盘在上的非法移动?
原因排查:检查两次递归调用的参数传入顺序。第一处调用必须是(n-1, source, auxiliary, target),第二处调用必须是(n-1, auxiliary, target, source)。只要调换了其中任意两个柱子的位置,整棵递归树的对称性便会被破坏,导致盘面逻辑紊乱。 -
排查问题:程序陷入死循环或报 RecursionError?
原因排查:检查基线条件是否编写了return,或者是否写成了if n == 0: return。虽然n == 0也是合法的边界,但如果没有在n == 1时正确截止或者递归时误写成n + 1,将导致递归深度无限增加直至触发 Python 递归深度异常。 -
排查问题:如何不打印只获取最终总步数?
最佳实践:如果仅需要得知完成搬移所需的最小步数,完全不需要真正运行递归函数,直接计算公式(1 << n) - 1(即 2 的 n 次方减 1)即可在 O(1) 时间内获得精确步数。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















