


Python面试高频算法题库推荐:LeetCode与牛客网实战指南

对于准备 Python 技术岗位(包括后端开发、数据分析、算法工程及自动化测试等方向)求职的技术人员而言,算法面试是考察逻辑思维与编程功底的关键环节。在实际备考过程中,LeetCode 与牛客网是目前最核心的两个解题实战平台。高效备考的完整路径是以 LeetCode 构建扎实的数据结构与算法体系,主攻经典高频题单;以牛客网熟悉国内目标企业的真实面试笔试真题,并专项适应 ACM 模式的标准输入输出。本文将从平台核心机制差异、高频题单规划、阶段备考流程及 Python 实战避坑四个维度,提供清晰具体的行动指南。
一、平台定位与核心差异:LeetCode 与牛客网如何高效协同
很多初学者在准备面试时容易产生疑问:既然两个平台都有算法题,是否只需选择其中一个刷题即可?答案是否定的。LeetCode 与牛客网在评测模式、题目来源和求职生态上存在本质差异,二者在备战阶段承担着完全不同的职责。
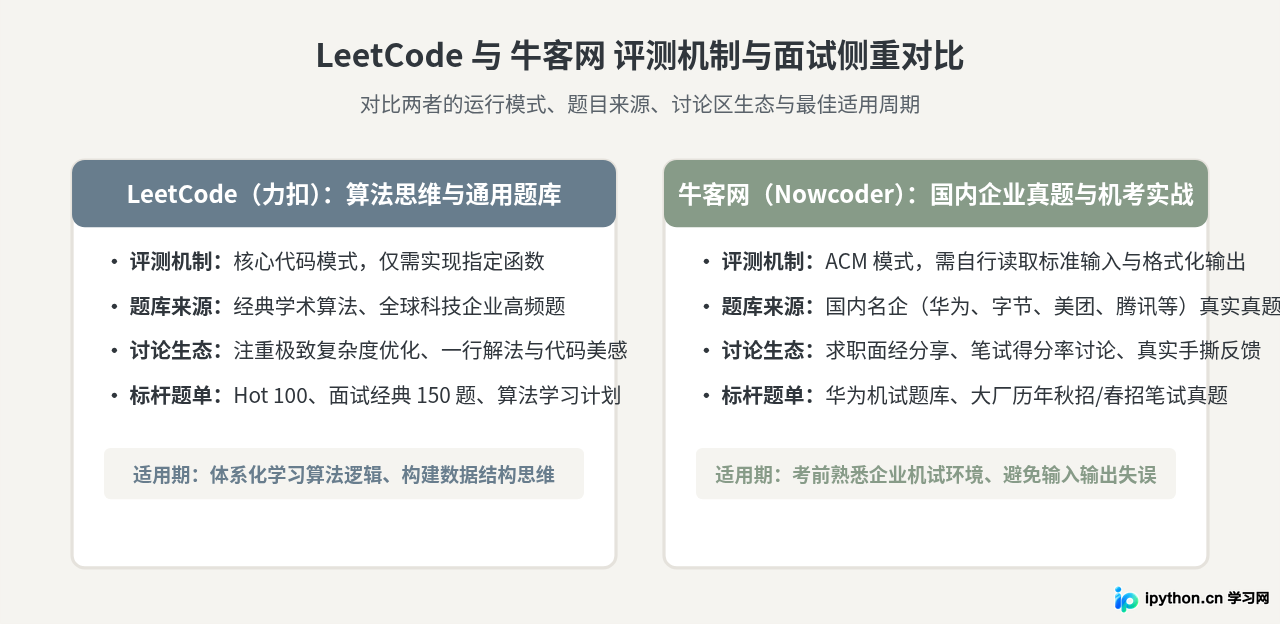
1. 核心代码模式与 ACM 模式的机制差异
LeetCode 全面采用“核心代码模式”。在解题界面中,平台已经定义好了类与方法签名(例如 class Solution: def twoSum(self, nums: List[int], target: int) -> List[int]:)。考生只需在函数内部实现核心算法逻辑并返回结果,系统会自动完成用例数据的解析与入参传递。这种模式让考生专注于算法思维本身,免去了手动处理输入输出的琐碎工作。
与此相对,牛客网的大部分企业真题及国内公司机考(如华为、美团等)采用“ACM 模式”。在 ACM 模式下,题目不提供预设的入参变量,必须由考生自行引入 sys 模块,读取标准输入流(sys.stdin),手动完成字符串分割、类型转换、边界判定,并将最终答案通过 print() 格式化输出。若不提前进行针对性练习,很多习惯了核心代码模式的求职者极易因输入格式错误或读取超时导致机试零分。
2. 题库来源与讨论区侧重点的互补性
LeetCode 的题目经过严密提炼,覆盖了经典的计算机科学算法分类,且讨论区聚集了全球开发者关于时间复杂度与空间复杂度的极限优化思路,适合用于夯实基础。而牛客网题库深度绑定国内互联网与科技企业的历年招聘原题,讨论区聚集了大量考生的真实面经、题型考察频率与笔试分数线反馈。将二者结合,能够兼顾“算法内功修炼”与“企业应试实战”。
二、高频题库分类推荐:核心模块与重点突破矩阵
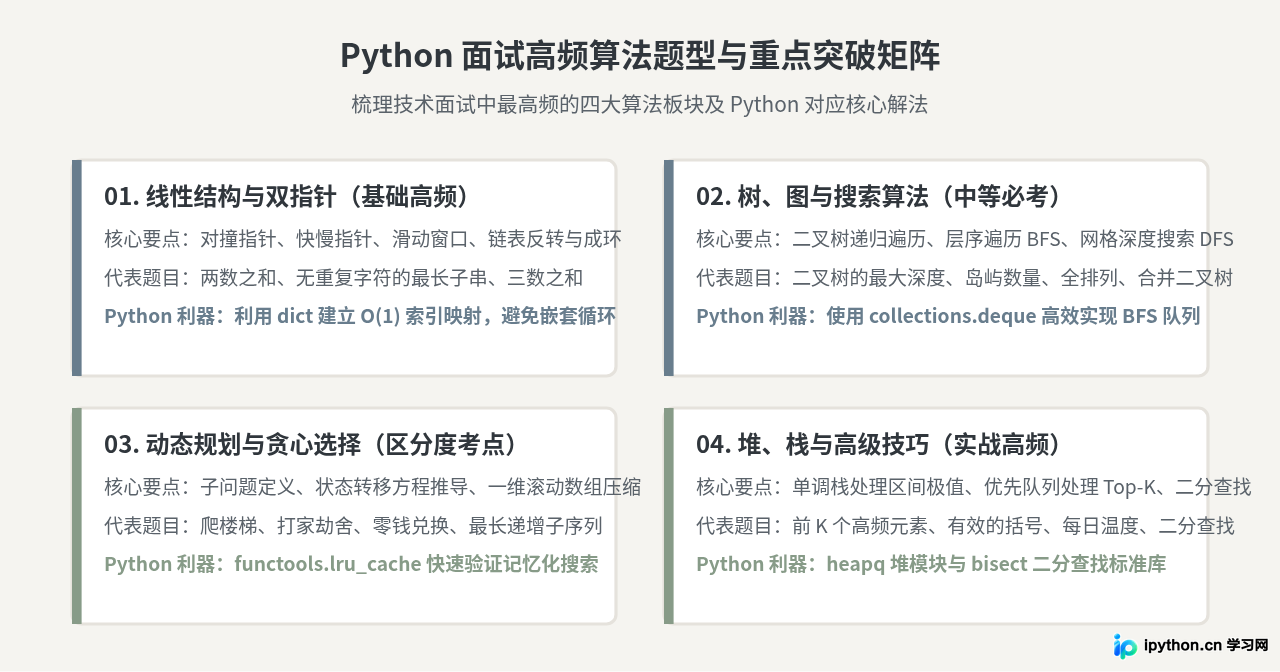
技术面试中的算法考查并非无迹可寻。统计表明,超过 80% 的高频算法题集中在四大核心模块。按专题分类集中攻关,能够快速形成结构化的解题反应:
1. 重点官方与社区题单推荐
- LeetCode 热题 100(Hot 100):技术面试首选题单。该题单收录了互联网大厂面试中复现频率最高的 100 道题目,难度覆盖简单到中等偏上,能建立最核心的算法模型。
- 《剑指 Offer》(专项突击版):特别适合国内招聘背景。题目高度契合国内企业对基本数据结构、指针操作、边界异常情况的考察方式。
- 牛客网《华为机试题库》:准备国内硬核笔试的试金石。该题库是练习 Python ACM 模式输入输出、字符串处理、进制转换与图遍历的绝佳资源。
- 牛客网“公司历年真题”板块:临考前 1-2 周按照目标企业(例如字节跳动、美团、腾讯等)筛选最近两年的真实笔试卷,严格限时模拟实战。
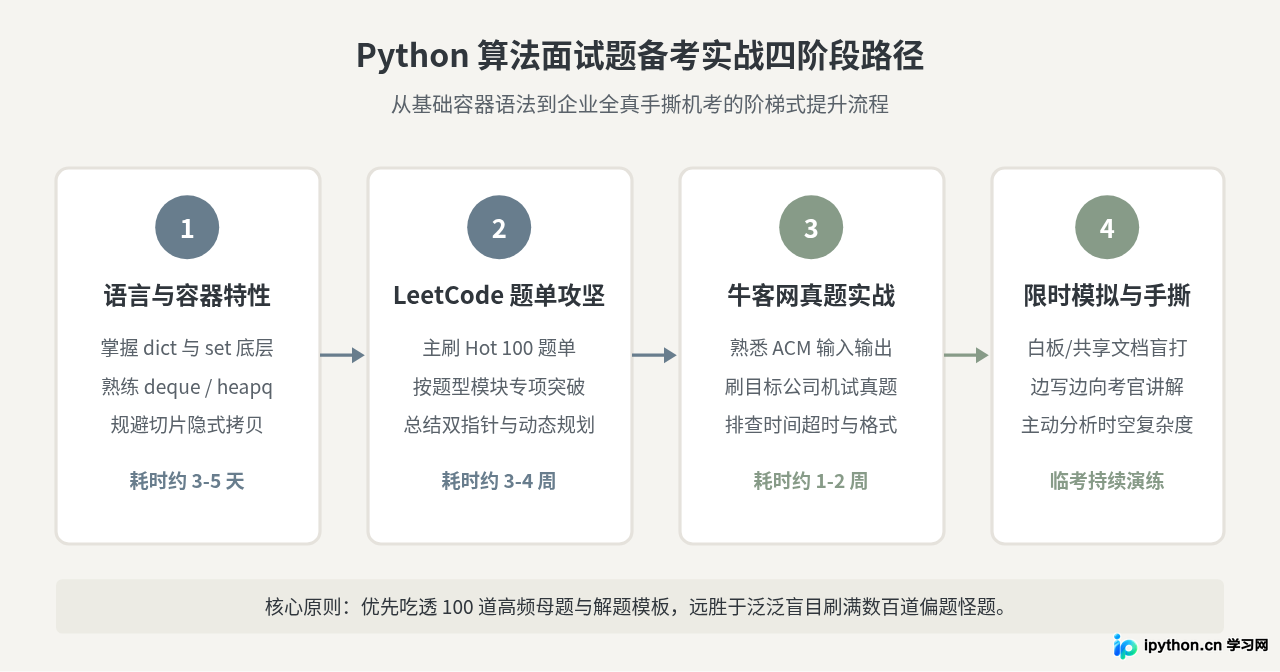
三、备战四阶段实施步骤:阶梯式推进计划
算法能力的提升需要遵循认知规律,从基础语法习惯到高强度全真手撕逐步递进。建议按照以下四个阶段展开备战:
四、Python 实战避坑指南:ACM 输入输出与核心解题规范
在笔试与面试手撕过程中,许多候选人虽然算法逻辑清晰,却因 Python 的语言特性与输入输出处理失误导致丢分。以下总结两个最核心的实操场景与规范代码。
1. 牛客网 ACM 模式高效输入输出模板
在牛客网等平台的机试环境中,如果使用循环 input() 读取大规模测试数据(例如数万行输入),极易因为 I/O 阻塞导致“运行超时”。最安全高效的做法是利用 sys.stdin.read() 一次性读取全部输入并按空白切分:
import sys

def main():
    # 一次性读取标准输入的全部数据并按空白符(换行、空格、制表符)分割
    raw_data = sys.stdin.read().split()
    if not raw_data:
        return

    ptr = 0
    # 示例场景:多组输入,每组首个整数为元素个数 n,紧接着 n 个整数
    while ptr < len(raw_data):
        n = int(raw_data[ptr])
        ptr += 1
        numbers = [int(x) for x in raw_data[ptr : ptr + n]]
        ptr += n

        # 执行核心计算逻辑,例如求最大值与累加和
        total_sum = sum(numbers)
        # 严格按照题目要求的格式输出结果
        print(total_sum)

if __name__ == '__main__':
main()print("debug:", val)),会被判题系统直接判为答案错误。
2. 核心算法题标准规范:滑动窗口范式示例
在 LeetCode 核心代码模式下,以经典高频题“无重复字符的最长子串”为例,展示清晰规范的 Python 解题结构。核心思想是利用哈希表记录字符最新出现的索引,并通过双指针动态维护无重复窗口:
class Solution:
    def lengthOfLongestSubstring(self, s: str) -> int:
        char_index_map = {}
        left = 0
        max_length = 0

        for right, char in enumerate(s):
            # 若字符在当前窗口内部出现过,则将左边界收缩至重复字符的下一个位置
            if char in char_index_map and char_index_map[char] >= left:
                left = char_index_map[char] + 1

            # 更新当前字符的最新索引
            char_index_map[char] = right
            # 更新最大窗口长度
            current_window = right - left + 1
            if current_window > max_length:
                max_length = current_window

        return max_length
3. Python 性能与边界关键排查点
- 列表切片的隐式内存开销:在递归或循环中频繁使用
arr[1:]会在底层创建原列表的浅拷贝,时间与空间复杂度均为 O(n)。涉及大数组处理时,务必使用索引下标代替切片。 - 字符串拼接性能陷阱:在循环内频繁使用
s += char会导致频繁的内存重新分配。在构建长字符串时,应先将片段存入列表,最后使用"".join(list)完成拼接。 - 递归深度限制保护:Python 默认递归深度上限通常为 1000。在深度优先搜索(DFS)遍历深层树或大图时,应显式设置
sys.setrecursionlimit(200000)或改用显式栈的迭代解法。
五、通关策略全景总结
攻克 Python 算法面试不在于刷题数量的盲目比拼,而在于对经典母题的深度理解、对平台特性的准确把握以及在面试官面前的流畅表达。以下是高效备战的关键准则总结:
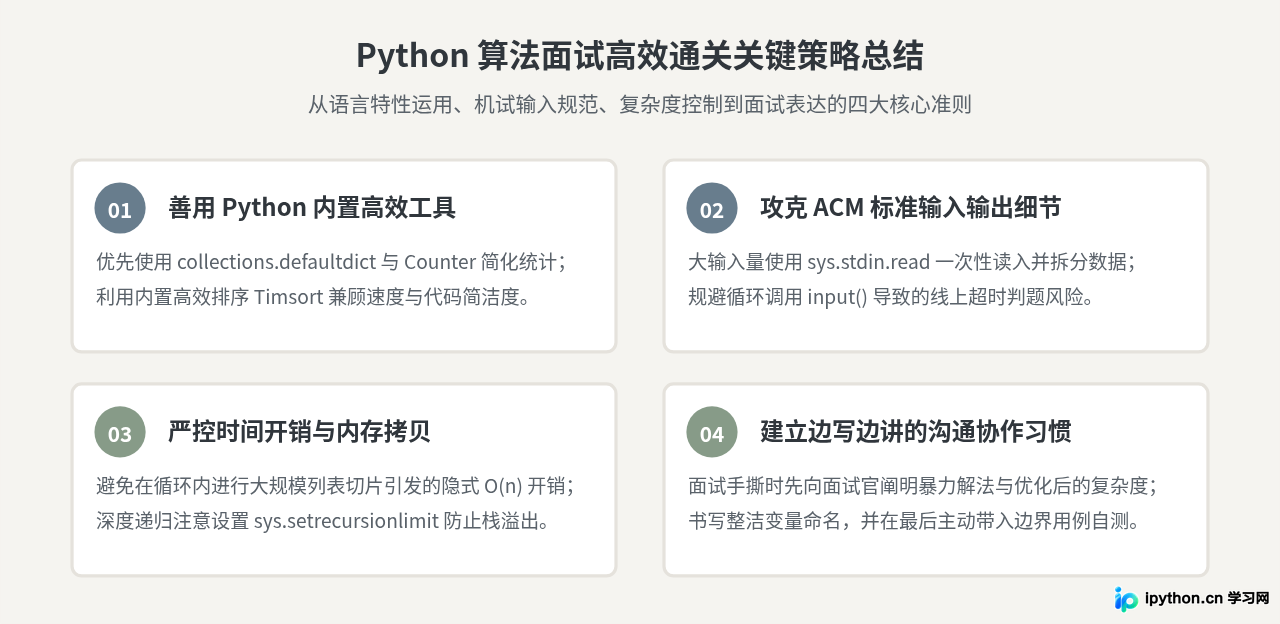
总而言之,以 LeetCode 为主阵地打好数据结构和通用算法基本功,以牛客网为实战演练场适应企业机试标准输入输出与真题考点,并在平时练习中养成严谨的复杂度分析和规范编码习惯,即可在 Python 算法面试中从容应对各种题型考验。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















