


Python基础语法易错点解析:缩进规则与冒号使用
深入解析Python基础语法中最核心的两大易错点:缩进规则与冒号使用。详细剖析代码块作用域机制、常见语法报错原因、Tab与空格混用排查以及工程化防御方案。
{})或 begin/end 等显式关键字,转而采用“冒号引导 + 强制对齐缩进”的机制来定义代码块结构。这套设计虽然赋予了代码高度的统一与可读性,但也使初学者极易遭遇 IndentationError 和 SyntaxError。本文直接围绕缩进规则与冒号的核心语法逻辑展开,剖析高频报错形态、底层判定条件,并给出规范的排查与预防方案。
一、冒号与缩进的配对逻辑与作用域机制
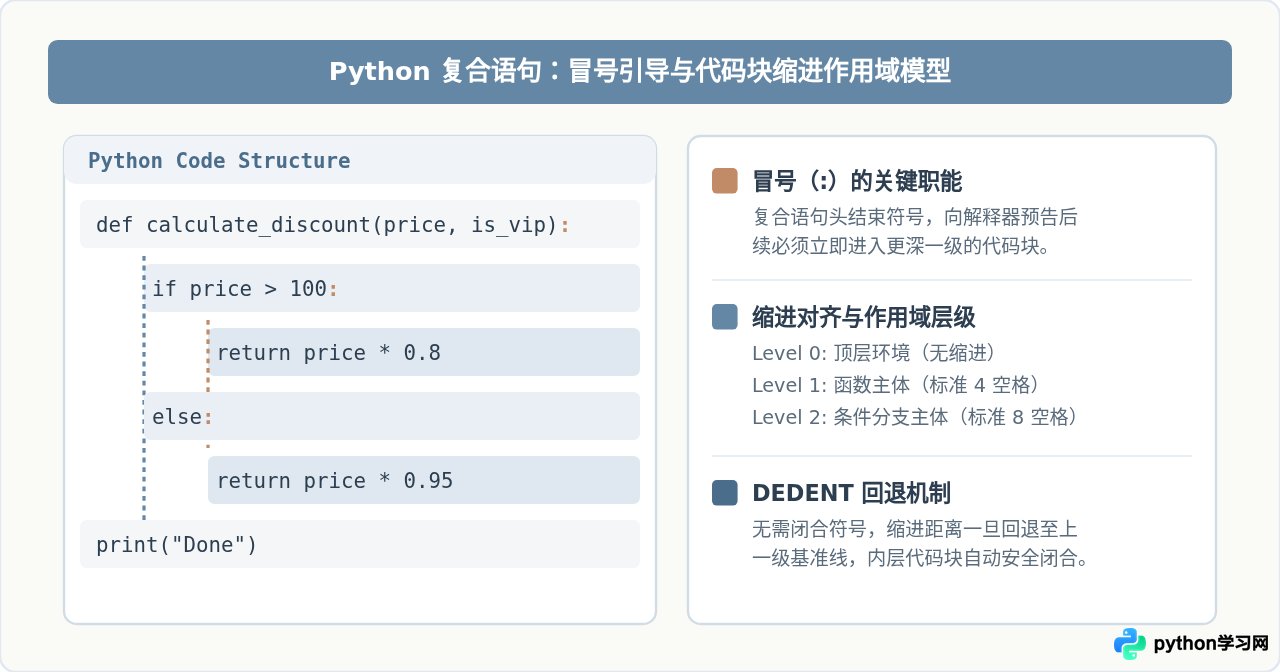
在 Python 中,冒号(:)与缩进从来不是割裂存在的语法元素,二者构成了严谨的“头部声明”与“主体承接”契约。任何引发下级代码块(Suite)的复合语句,其头部行末尾必须以英文半角冒号结束,而后续紧跟的所有同级逻辑行则必须向右保持完全相等的缩进量。
当解释器解析到控制流或定义语句时,冒号是语法分析器识别“复合语句头已就绪”的关键标记;紧接着,词法分析器通过统计行首空白生成 INDENT 标记,将执行流程压入新的作用域层级。直到遇到缩进回退行产生 DEDENT 标记,该代码块才宣告结束。
二、三大典型缩进错误与形成原因
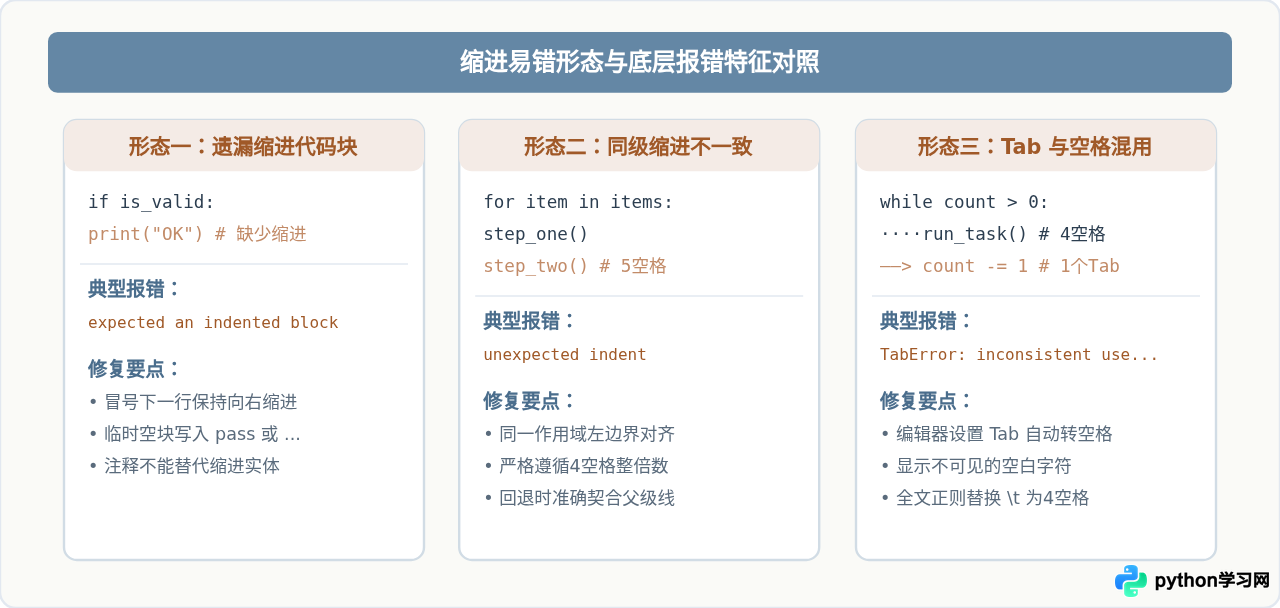
Python 编译器在对源文件进行词法分析时,专门维护着一个名为 indent stack(缩进栈)的数据结构。栈底始终为 0,每当发现缩进增加,新缩进数值被压栈;缩进减少时则依次弹出,直至与栈中某一级数值精确吻合。若违反这一机制,就会抛出 IndentationError 或 TabError。
1. 缺少必要缩进:expected an indented block
在复合语句头(以冒号结尾的行)之后,如果下一行没有增加缩进,或者该代码块为空且未放置任何占位语句,解释器就会报出此错误。
# 错误示例:定义函数或条件分支后为空,未提供代码块内容
def process_data(items):
    # 此处仅有注释,未提供有效执行语句或占位符
print("开始处理")  # IndentationError: expected an indented block after function definition on line 1

# 正确示例:暂不实现功能时必须使用 pass 占位
def process_data(items):
    pass  # 明确告知解释器此代码块为空,结构完整
2. 同一代码块内缩进不对齐:unindent does not match
在同一个逻辑块中,所有并列语句的缩进空格数必须严格相同。若某一行缩进量多于或少于当前块基准,且无法与缩进栈中任何外层层级对齐,解释器就无法判断该行所属的代码层级。
# 错误示例:同一层级内缩进不一致
if score >= 60:
    print("成绩合格")
     print("请继续保持")  # IndentationError: unexpected indent(多了1个空格)

# 错误示例:回退时无法对应外层缩进
def check_status(flag):
    if flag:
        print("开启")
      print("检查完毕")  # IndentationError: unindent does not match any outer indentation level
3. 制表符与空格混用:TabError
这是跨编辑器协作或多人在不同环境下维护代码时最隐蔽的错误。虽然在某些编辑器中,一个制表符(Tab)显示宽度看起来等于 4 个空格,但在 Python 3 中,制表符与空格被视为完全不同的空白字符,严禁在同一个块内混用。
三、冒号使用场景清单与易遗漏陷阱
Python 语法中,并非所有行都需要冒号。冒号的使用场景具有明确的白名单特征。理解哪些语句必然以冒号结尾,可以从源头上杜绝 SyntaxError: expected ':'。
| 语法类别 | 典型关键字结构 | 容易出现遗漏的细节 |
|---|---|---|
| 条件分支 | if condition:elif condition:else: |
在多条件换行书写时,容易将冒号误写在首行而非条件表达式的最终末尾;else 之后易遗忘冒号。 |
| 循环结构 | for item in iterable:while condition: |
嵌套循环中内层循环头部易漏掉冒号;for...else 或 while...else 中的 else 易漏。 |
| 函数与类定义 | def function_name(args):class ClassName: |
带类型注解或多默认参数换行时,容易在右括号后直接回车换行而遗漏冒号。 |
| 异常处理 | try:except Exception as e:finally: |
try 单独成行时最常因为短小而漏敲冒号;多分支捕获特定异常时末尾易漏。 |
| 上下文管理 | with open(...) as f: |
同时打开多个资源换行书写时,冒号容易放错位置。 |
:)与半角英文冒号(:)混淆。Python 解释器仅识别 ASCII 编码中的英文冒号(十六进制 0x3A)。中文冒号在语法分析时会被当作非法字符,抛出 SyntaxError: invalid character in identifier。
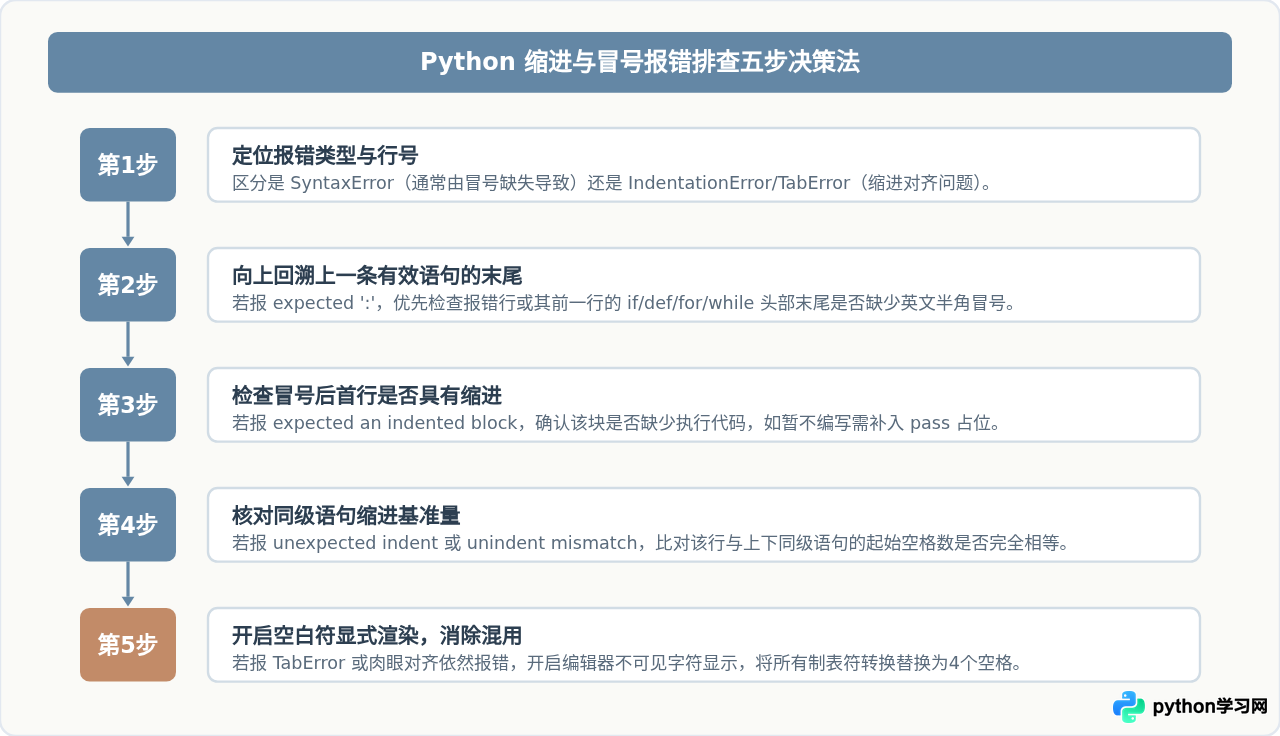
四、语法报错五步排查决策流程
当终端抛出与缩进或冒号相关的报错信息时,排查的核心在于理清“报错指示行”与“真正错误发生行”的物理位移。例如,如果遗漏了上一行的冒号,解释器往往是在下一行的开头才会发现语法不通,导致报错行号比实际少冒号的行推迟一行。
五、编辑器配置与工程化防错实践
在实际项目开发中,完全依赖人工手动敲空格对齐既低效又容易出错。通过合理配置主流编辑器以及引入自动化代码格式化工具,可以彻底消除 99% 以上的缩进与冒号语法问题。
1. 编辑器关键配置建议
无论使用 VS Code、PyCharm 还是其他主流编辑器,建议立即开启以下三项核心设置:
- Tab 键转换为空格(Insert Spaces):按键录入 Tab 时,编辑器自动注入 4 个标准空格字符,从源头杜绝制表符混入。
- 制表符宽度(Tab Size):显式设置为
4,与官方 PEP 8 推荐规范完全统一。 - 渲染空白字符(Render Whitespace):开启在选中区域或全局显示不可见字符。空格通常显示为浅灰色小圆点(
·),Tab 则显示为向右箭头(→),肉眼即可立即识别格式异常。
2. 引入格式化与代码静态检查工具
在保存代码或提交版本库前,借助自动化工具自动纠错与格式化是现代工程化开发的标准流程:
# 1. 使用 black 自动格式化(严格规范缩进与冒号规范)
pip install black
black your_script.py

# 2. 使用 flake8 进行代码静态合规检测(快速捕捉语法与缩进违背点)
pip install flake8
flake8 your_script.py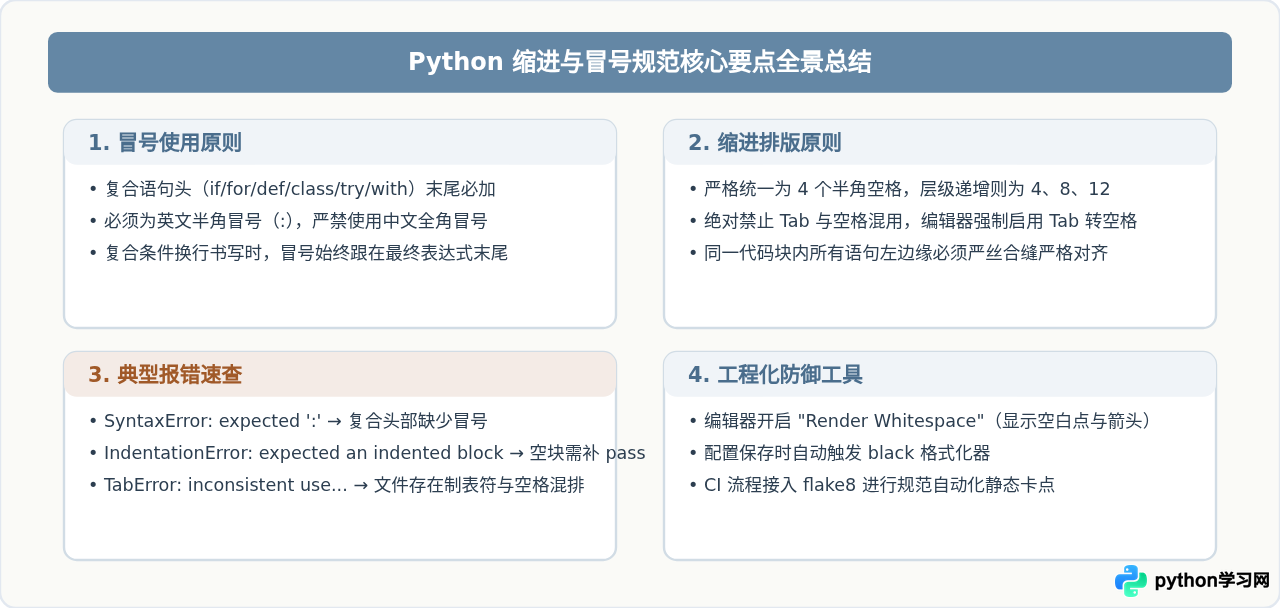
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















