


Python 3自动化办公常用库推荐:实现Excel与PDF批量处理
深入对比并详解Python 3在Excel与PDF批量处理场景中的主流常用库(pandas、openpyxl、pypdf、pdfplumber),提供工业级文件遍历、多表合并、格式保留与PDF切分提取的完整代码方案与避坑指南。
一、核心选型对比:认清四大主流库的分工与边界
Python 生态中并不存在一个“万能包揽全部需求”的单一库。初学者常踩的坑之一就是用错工具边界——比如尝试用 pandas 去调整某个单元格的底色或字体边框,或者用 pypdf 去无损提取不规则排版的发票表格。明确每个库擅长的处理层级,是实现高效自动化的前提。
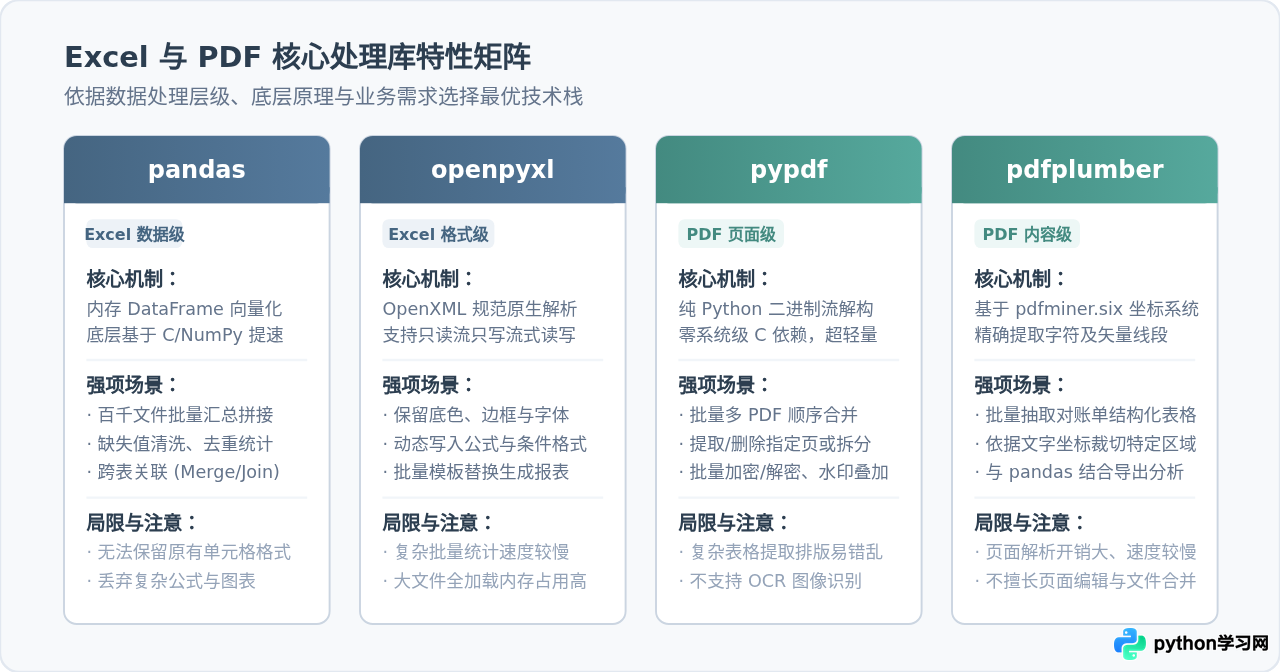
| 文件类型 | 推荐库 | 主要处理层次 | 核心优势 | 适用典型场景 |
|---|---|---|---|---|
| Excel | pandas |
数据计算层 (DataFrame) | 基于 C/NumPy 向量化运算,读写汇总速度极快 | 数十上百份结构相同的工作表垂直拼合、按列清洗统计 |
openpyxl |
文档结构与样式层 | 完整支持 OOXML 协议,支持单元格字体、边框、公式与多 Sheet 操作 | 基于业务模板批量生成带格式的工资条、月报,动态修改特定单元格 | |
pypdf |
页面与文件对象层 | 纯 Python 编写无系统依赖,秒级完成重组、切分、加密与水印叠加 | 批量把每人的单页证明合并为年度总册、按页码拆分归档、批量加密码 | |
pdfplumber |
字符布局与排版内容层 | 内置高精度的几何线框识别与文字坐标定位算法 | 从非扫描版 PDF 报表、水单、发票中把规整表格抓取为表格数据 |
二、Excel 批量处理实战:数据清洗与格式模板的双重方案
在实际生产环境中,针对 Excel 的批量操作主要分为两类截然不同的业务需求:“多工作簿结构化数据聚合”与“固定样式模板批量填报”。针对不同需求,应采用不同的技术方案。
1. 方案 A:使用 pandas 实现多工作簿高效拼接汇总
在批量汇总各个分店或部门上报的销售台账时,最关键的是统一字段并高效拼合。此时应避免在 for 循环中频繁调用磁盘写入或不断追加已有 DataFrame。推荐将读取的子表暂存在内存列表中,遍历完成后一次性执行 pd.concat():
from pathlib import Path
import pandas as pd

# 统一使用 pathlib 跨平台路径管理
source_dir = Path("./data/excel_input")
output_file = Path("./data/excel_output/2026年度销售汇总.xlsx")
output_file.parent.mkdir(parents=True, exist_ok=True)

data_frames = []

# 扫描目录下全部 xlsx 文件,并过滤隐藏临时文件
for excel_path in source_dir.glob("*.xlsx"):
    if excel_path.name.startswith("~$"):
        continue  # 跳过 Office 开启时的临时锁定文件

    try:
        # 指定必要字段为字符串格式,防止订单号或工号前面的 0 丢失
        df = pd.read_excel(excel_path, dtype={"网点编号": str, "交易单号": str})

        # 追加来源标签,方便溯源排查异常数据
        df["数据来源"] = excel_path.stem
        data_frames.append(df)
    except Exception as e:
        print(f"读取文件 {excel_path.name} 失败,已跳过: {e}")

# 一次性聚合写入磁盘
if data_frames:
    merged_df = pd.concat(data_frames, ignore_index=True)
    merged_df.to_excel(output_file, index=False, engine="openpyxl")
    print(f"合并完成,共计 {len(merged_df)} 行数据已保存至 {output_file}")
else:
    print("未扫描到有效的 Excel 数据源。")
2. 方案 B:使用 openpyxl 保护格式的批量模板注入
如果输出结果必须严格遵从企业既定版式(如带有公司 Logo、多重合并单元格、既定字体颜色以及预埋的汇总求和公式),pandas 就不再适用。此时应选用 openpyxl,基于预先制作好的模板文件动态注入数据:
from openpyxl import load_workbook
from pathlib import Path

template_file = Path("./templates/绩效确认单_模板.xlsx")
target_folder = Path("./output/绩效归档")
target_folder.mkdir(parents=True, exist_ok=True)

employee_data = [
    {"id": "A001", "name": "张敏", "dept": "研发部", "score": 96},
    {"id": "A002", "name": "李雷", "dept": "运维组", "score": 91},
]

for emp in employee_data:
    # 加载模板(保留所有原有排版与公式定义)
    wb = load_workbook(template_file)
    ws = wb.active

    # 精确修改业务数据格,单元格样式与条件格式完整继承
    ws["C3"] = emp["name"]
    ws["E3"] = emp["dept"]
    ws["C4"] = emp["id"]
    ws["E4"] = emp["score"]

    dest_file = target_folder / f"绩效单_{emp['name']}_{emp['id']}.xlsx"
    wb.save(dest_file)
    wb.close()
三、PDF 批量处理实战:页面重组与表格抽取的明确分工
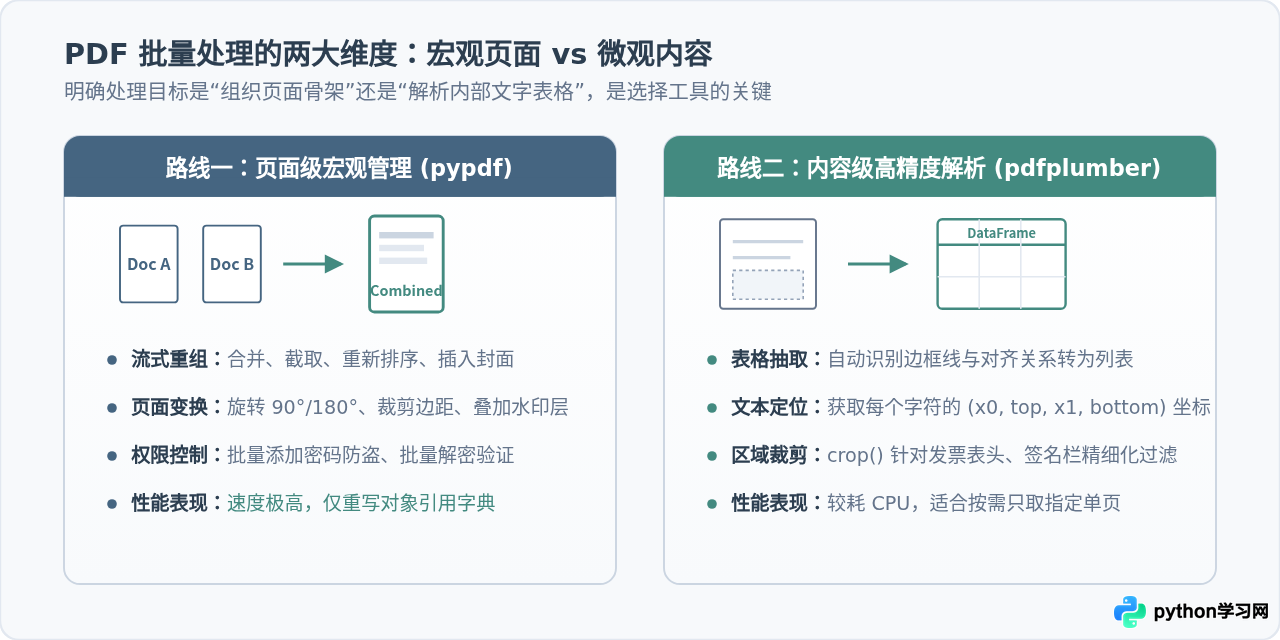
PDF 文件的技术底层是描述页面视觉呈现的绘图语言,其内容本质上是由字符坐标、线条向量和内嵌流组成的画布。对于 PDF 的自动化,必须分清处理诉求属于宏观页面编排还是微观文字提取:
1. 方案 A:使用 pypdf 实现海量 PDF 批量合并与书签构建
pypdf(前身为经典的 PyPDF2,目前官方统一维护版本为 pypdf)专注于对 PDF 内部页对象的高效重组。它在合并或切分过程中无需渲染文字或图元,内存占用极小:
from pathlib import Path
from pypdf import PdfWriter, PdfReader

pdf_input_dir = Path("./data/pdf_reports")
merged_pdf_path = Path("./data/output/2026第一季度汇总报告.pdf")
merged_pdf_path.parent.mkdir(parents=True, exist_ok=True)

writer = PdfWriter()
pdf_list = sorted(list(pdf_input_dir.glob("*.pdf")))

for single_pdf in pdf_list:
    try:
        reader = PdfReader(str(single_pdf))

        # 为合并后的总文档添加以原文件名命名的大纲书签
        writer.add_outline_item(title=single_pdf.stem, page_number=len(writer.pages))

        # 将该文档的所有页依次追加到输出队列
        for page in reader.pages:
            writer.add_page(page)
    except Exception as e:
        print(f"文件 {single_pdf.name} 处理异常: {e}")

# 一次性写出总 PDF
with open(merged_pdf_path, "wb") as f:
    writer.write(f)

print(f"批量合并完成,输出文件:{merged_pdf_path},总计 {len(writer.pages)} 页")
2. 方案 B:使用 pdfplumber 批量提取电子对账单表格转为 Excel
当需要从供应商或银行提供的 PDF 电子对账单中抽取表格明细并存入数据库或 Excel 时,pdfplumber 是目前解析精度最高、使用最广泛的工具:
import pdfplumber
import pandas as pd
from pathlib import Path

invoices_dir = Path("./data/pdf_invoices")
all_extracted_rows = []

for pdf_file in invoices_dir.glob("*.pdf"):
    with pdfplumber.open(pdf_file) as pdf:
        # 针对对账单第 1 页进行表格提取
        first_page = pdf.pages[0]
        tables = first_page.extract_tables()

        for table in tables:
            if not table or len(table) < 2:
                continue

            headers = table[0]  # 首行为表头
            for row in table[1:]:
                row_dict = dict(zip(headers, row))
                row_dict["凭证文件"] = pdf_file.name
                all_extracted_rows.append(row_dict)

# 转为 DataFrame 一键导出为标准 Excel 表格
if all_extracted_rows:
    df_result = pd.DataFrame(all_extracted_rows)
    df_result.to_excel("./data/output/提取对账明细汇总.xlsx", index=False)
    print(f"成功从 PDF 中抓取 {len(df_result)} 条数据并完成导出。")
四、批量处理的核心流水线设计与稳定性工程
能够运行单次测试脚本与能在无人值守环境下批量处理上万份文档之间,最大的技术差距在于防御性编程与资源控制。
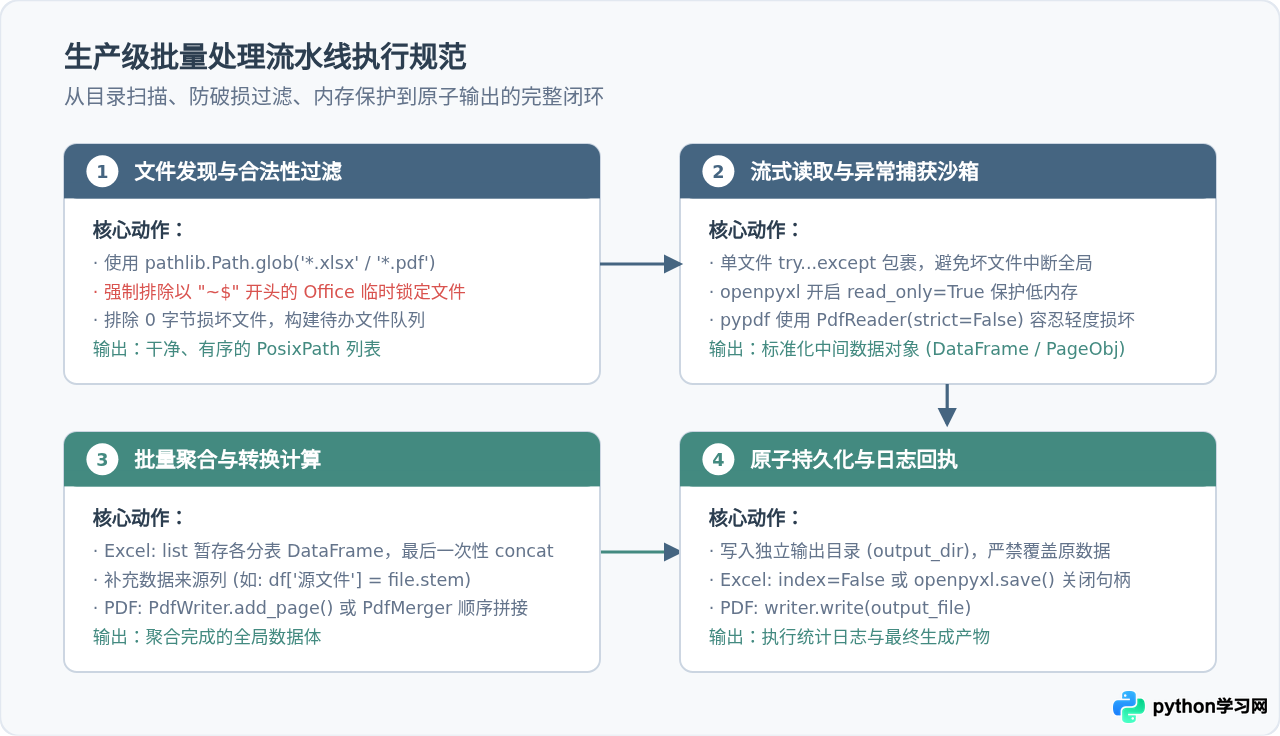
在批量流水线中,以下三个环节对稳定性至关重要:
-
严密的临时文件与零字节文件过滤:
Windows 上的 Excel 在被用户或同步软件开启时,会在当前目录下创建以
~$开头的隐形影子文件。如果脚本无差别遍历*.xlsx,将该临时文件当作正规工作簿读取,必将直接引发BadZipFile异常导致整个批量流程崩溃。使用if path.name.startswith("~$") or path.stat().st_size == 0: continue即可规避。 -
单任务容错与独立沙箱(Fault Isolation):
在
for循环体内部,必须使用独立的try...except块将单文件处理过程包裹。遇到损坏文件时记录警告日志并继续执行后续文件,杜绝“因为第 89 个文件损坏导致前 88 个处理成果前功尽弃”的情况。 -
内存流式读取与句柄释放:
当单张 Excel 表超过 50 万行时,若使用 openpyxl 默认模式加载,每个单元格会实例化为复杂的 Python 对象,内存可能飙升至数 G。在只需读取数据的场景下,必须启用
load_workbook(filename, read_only=True);在写出大文件时使用write_only=True。
五、总结:快速决策树与避坑指南
在面对具体的自动化办公需求时,建议按照下方决策路线选择最优技术方案:
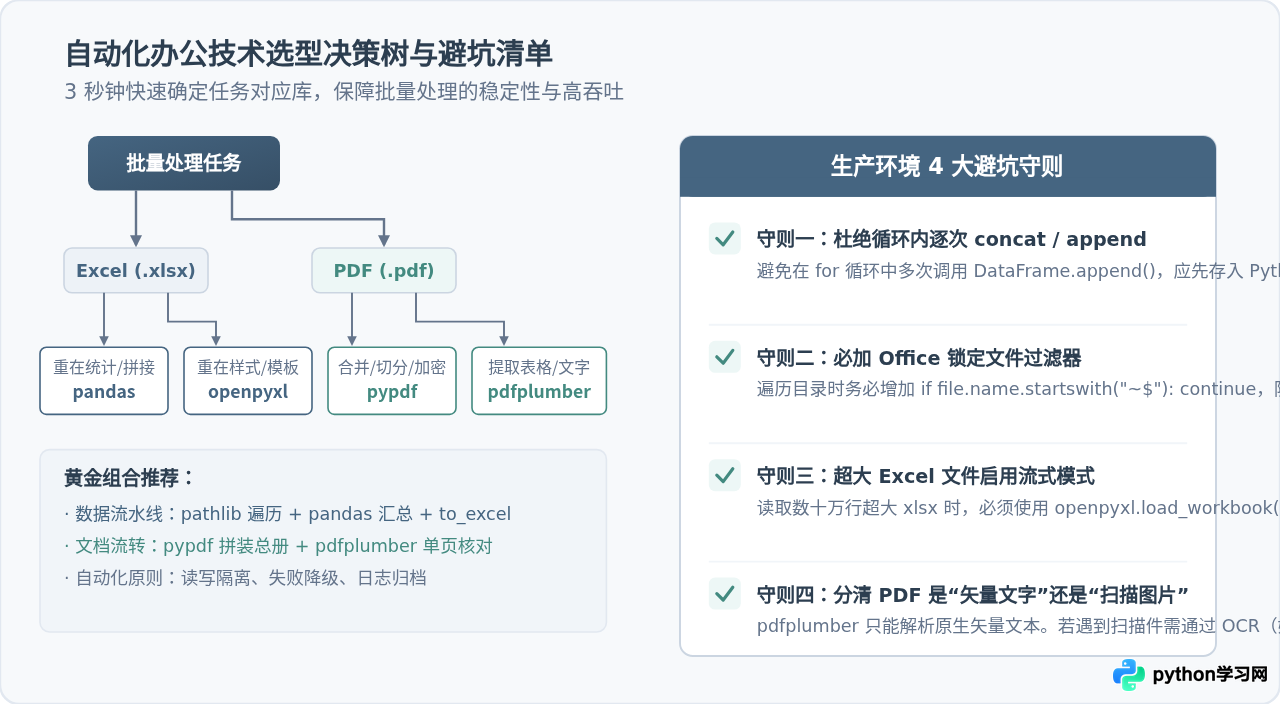
- 要拼合、汇总、统计多个 Excel 表格数据?首选 pandas。
- 要基于公司带格式的现成 Excel 模板批量填数生成美观报表?首选 openpyxl。
- 要合并多个 PDF 成为一本册子、按页拆分、旋转或加密码?首选 pypdf。
- 要从对账单、合同等现成 PDF 文件中抓出表格并转存为数据?首选 pdfplumber。
借助以上四个库与标准库 pathlib 的配合,你可以覆盖 95% 以上的日常 Excel 与 PDF 批量自动化处理诉求。合理构建异常捕获与流式读写机制,将显著提升批处理脚本的可靠性与执行效率。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















