


Python操作MongoDB与Redis:NoSQL数据库连接指南
针对Python开发者的MongoDB与Redis官方驱动连接指南。详细讲解PyMongo与redis-py的环境安装、URI格式规范、连接池调优、网络超时设置、连接探活验证以及双库协同缓存的最佳实践。
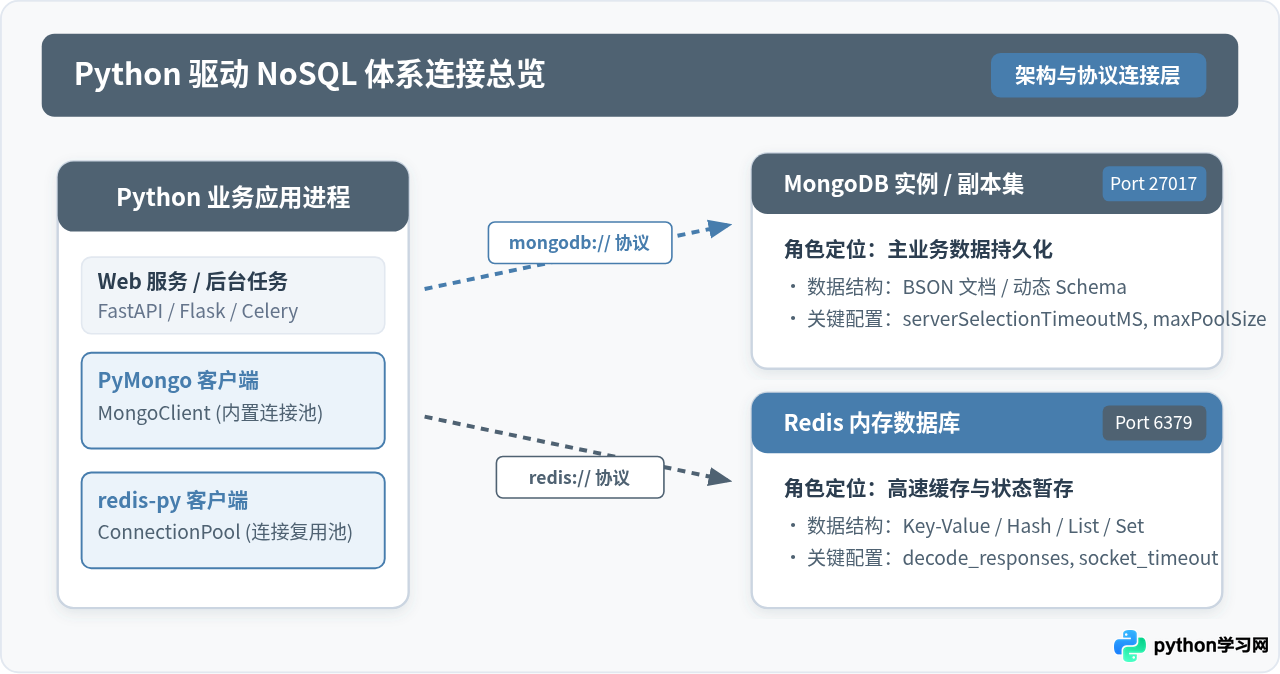
在 Python Web 服务与数据处理开发中,同时接入 MongoDB(面向文档、支持动态数据持久化)和 Redis(面向键值、提供高速内存缓存与轻量队列)是常见的高性能架构模式。连接这两个 NoSQL 数据库的核心,在于掌握官方驱动(pymongo 与 redis-py)的生命周期、底层连接池(Connection Pool)复用、超时阈值设定与健康探活逻辑。本文直接讲解 MongoDB 与 Redis 的标准连接步骤、关键参数配置与连接验证,并通过 Cache-Aside 缓存联动示例,展示生产环境下双 NoSQL 协同连接管理的完整落地方法。
环境准备与官方驱动安装
在 Python 中操作这两个数据库,请使用官方维护的核心驱动库。避免使用未经充分验证的第三方轻量封装包,以确保连接协议的兼容性与长连接稳定性:
- PyMongo:MongoDB 官方 Python 驱动,内置连接池管理与拓扑发现。若需连接以
mongodb+srv://开头的 DNS 记录集群(如 MongoDB Atlas),还需安装dnspython。 - redis-py:Redis 官方 Python 驱动(包名为
redis),原生支持连接池、自动重连以及 RESP 协议解析。
# 基础安装命令
pip install pymongo redis

# 如需支持 mongodb+srv:// 格式及更高性能的解析组件
pip install pymongo[srv] redis hiredis在安装 redis 时搭配 hiredis,可利用 C 语言编写的高性能解析库替代纯 Python 的协议解析器,在处理大量数据读写时能显著降低 CPU 消耗。
MongoDB 规范连接指南:MongoClient 与连接池
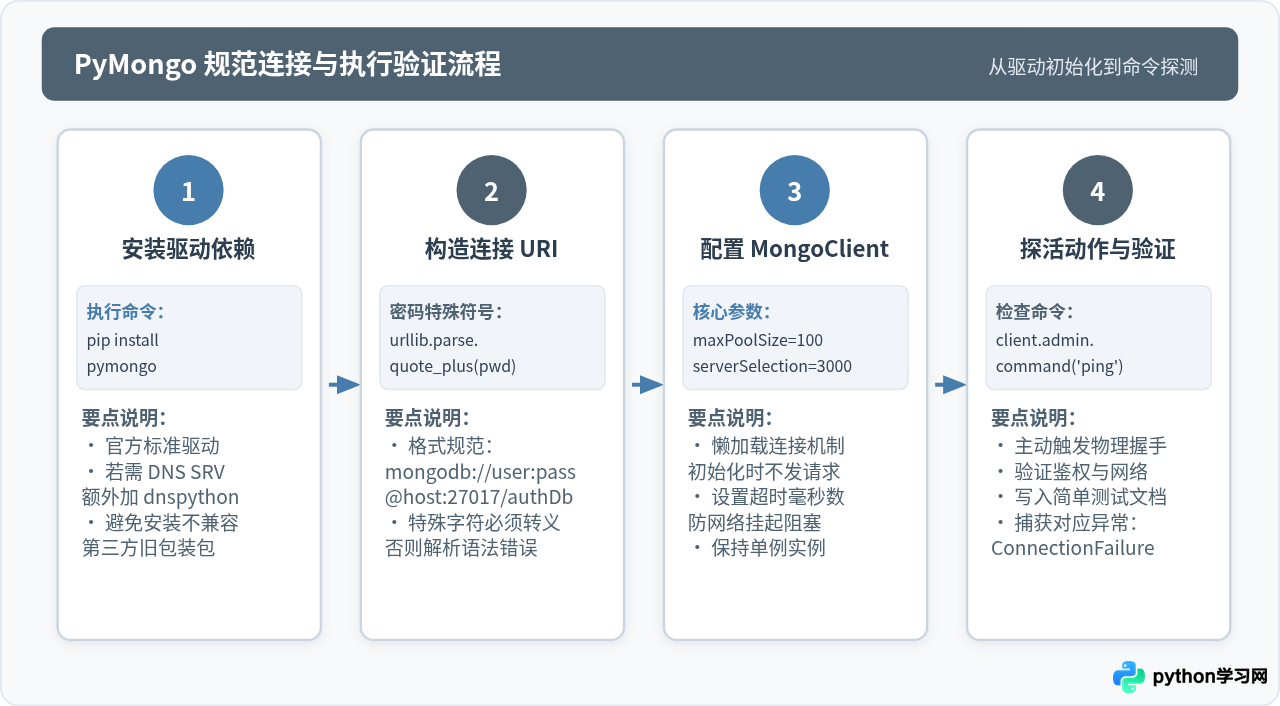
pymongo.MongoClient 是访问 MongoDB 的核心入口。在创建客户端对象时,驱动程序并不会立刻向服务器发起阻塞式的物理网络握手,而是采用“懒加载(Lazy Initialization)”机制,只有在执行首个查询、插入或显式探活命令时才会真正建立连接。
1. 连接 URI 规范与密码特殊字符转义
标准 MongoDB 连接字符串格式为:mongodb://[username:password@]host1[:port1][,...hostN[:portN]][/defaultauthdb][?options]。当数据库密码中包含如 @、:、/、# 等特殊字符时,若直接拼接 URI 会导致解析语法中断。此时必须使用标准库 urllib.parse.quote_plus 进行 URL 转义:
import urllib.parse
from pymongo import MongoClient

# 密码包含特殊符号时的正确转义示范
raw_user = "app_user"
raw_password = "P@ssw/ord:2026#!"
encoded_user = urllib.parse.quote_plus(raw_user)
encoded_password = urllib.parse.quote_plus(raw_password)

# 构造安全连接 URI,并明确指定鉴权数据库 authSource
mongo_uri = f"mongodb://{encoded_user}:{encoded_password}@127.0.0.1:27017/?authSource=admin"
2. 核心超时与连接池关键参数
为防止在数据库网络出现故障或单节点宕机时将 Python 业务线程无限期挂起,必须显式设定合理的超时阈值:
serverSelectionTimeoutMS:服务器选择超时时间(默认为 30000ms,即 30 秒)。在 Web 服务中,通常建议设为3000到5000毫秒,超时后快速失败并向上层抛出异常。connectTimeoutMS:TCP 物理建连超时时间,建议设置为5000毫秒。maxPoolSize:每个节点维持的最大并发连接数(默认为 100)。根据应用 Worker 进程数综合评估,避免大量连接耗尽数据库 FD 限制。minPoolSize:连接池中保活的最小空闲连接数,保证突发并发流量无需临时创建连接。
3. 连接探活与读写验证完整示例
通过执行 client.admin.command('ping') 可以强制触发网络建连与鉴权,从而在应用服务启动阶段及时验证数据库可用性:
from pymongo import MongoClient
from pymongo.errors import ConnectionFailure, ServerSelectionTimeoutError

def init_mongo_connection():
    try:
        # 初始化客户端(单例复用)
        client = MongoClient(
            "mongodb://127.0.0.1:27017/",
            serverSelectionTimeoutMS=3000,
            connectTimeoutMS=5000,
            maxPoolSize=50,
            minPoolSize=10
        )
        # 执行 admin ping 命令验证网络连通与鉴权
        client.admin.command('ping')
        print("[MongoDB] 数据库连通成功!")

        # 验证基础数据写入与读取
        db = client["content_hub"]
        collection = db["articles"]

        # 插入示例数据
        test_doc = {"_id": "art_1001", "title": "NoSQL 连接实践", "status": "published"}
        collection.update_one({"_id": "art_1001"}, {"$set": test_doc}, upsert=True)

        # 读取验证
        ret = collection.find_one({"_id": "art_1001"})
        print(f"[MongoDB] 读取验证成功:{ret['title']}")
        return client

    except (ServerSelectionTimeoutError, ConnectionFailure) as err:
        print(f"[MongoDB] 连接失败,请检查服务状态或网络防火墙:{err}")
        raise err

if __name__ == "__main__":
    mongo_client = init_mongo_connection()
Redis 规范连接指南:ConnectionPool 与客户端生命周期
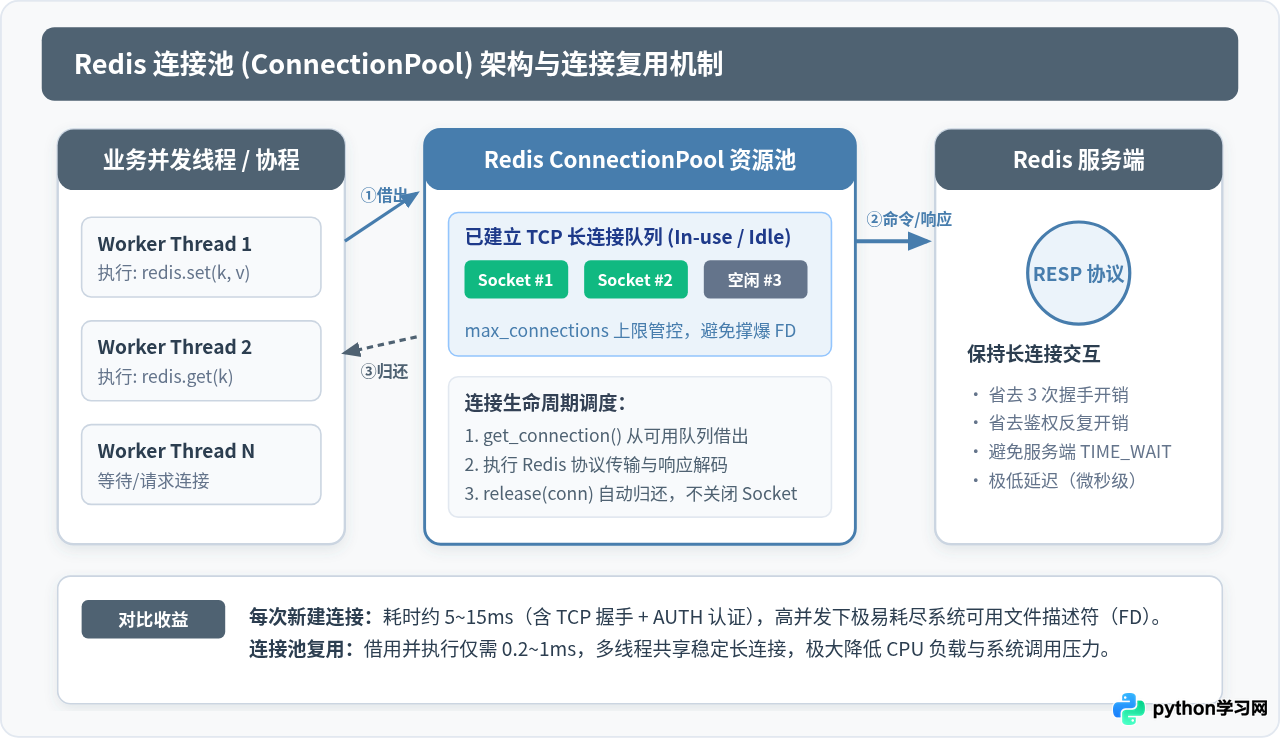
与文档数据库不同,Redis 属于典型的单线程内存执行模型,响应延迟通常在微秒级别。若在每个业务函数中频繁新建和关闭 TCP 连接,3 次握手以及密码认证所产生的网络 RTT 耗时将远超 Redis 命令本身的执行时间。因此,使用 ConnectionPool 维护长连接队列是使用 redis-py 的核心原则。
1. 连接池的工作机制与参数配置
redis.ConnectionPool 内部管理一组已经建立好 TCP 握手的可用 Socket。当 Python 应用调用 Redis 操作命令时,客户端从池中借出一个可用连接,完成命令交互后立刻归还至池中,并不会触发 Socket 关闭。
连接池常用核心参数如下:
decode_responses=True:极为重要的参数。若设为默认值False,Redis 返回的字符串均为bytes类型(例如b'value');开启后,客户端会自动按 UTF-8 进行解码,直接返回 Python 原生str。socket_timeout=3.0:读写 Socket 超时时间(秒),防止网络拥塞导致执行线程挂死。socket_connect_timeout=3.0:初始建立 TCP 连接的超时时间。max_connections=50:连接池允许容纳的最大连接上限。超出时若所有连接均在被使用,将根据配置等待或报错,避免无序创建连接打满 Redis 服务端。db=0:目标逻辑数据库索引编号(默认支持 0~15)。
2. Redis 连接探活与读写验证示例
import redis
from redis.exceptions import ConnectionError, AuthenticationError, TimeoutError

def init_redis_client():
    # 1. 显式创建独立的连接池对象(单例模式)
    pool = redis.ConnectionPool(
        host='127.0.0.1',
        port=6379,
        password=None,             # 若未设置密码则填 None,生产环境务必配置强密码
        db=0,
        decode_responses=True,     # 自动将 bytes 解码为 str
        socket_timeout=3.0,
        socket_connect_timeout=3.0,
        max_connections=50
    )

    # 2. 从连接池创建客户端实例
    client = redis.Redis(connection_pool=pool)

    try:
        # 3. 执行 ping 命令测试连通性
        if client.ping():
            print("[Redis] 数据库连接连通成功!")

        # 4. 基础键值读写与过期时间设置
        client.set("session:user_1001", "active_token_xyz", ex=300) # 300秒过期
        val = client.get("session:user_1001")
        print(f"[Redis] 读取验证成功:session = {val}")

        return client

    except AuthenticationError:
        print("[Redis] 认证失败:密码错误或未提供密码")
        raise
    except (ConnectionError, TimeoutError) as err:
        print(f"[Redis] 网络连接超时或服务未就绪:{err}")
        raise

if __name__ == "__main__":
    redis_client = init_redis_client()
生产级协同实践:MongoDB 持久化与 Redis 缓存联动
在绝大多数实际业务场景中,MongoDB 与 Redis 并非互斥关系,而是紧密协同的上下游组件。最典型的架构方案为 Cache-Aside(旁路缓存)模式:
- 读取数据时:优先根据业务 Key 查询 Redis 内存缓存。若命中,直接返回业务数据(延迟通常 < 1ms);若未命中,再穿透查询 MongoDB 集合,并将获取到的数据反向写入 Redis,同时配置合理的生存周期(TTL)。
- 写入或更新数据时:优先更新 MongoDB 中的数据以确保数据安全落盘;随后主动删除(或淘汰)Redis 中对应的缓存键,保证缓存与持久层的数据最终一致。
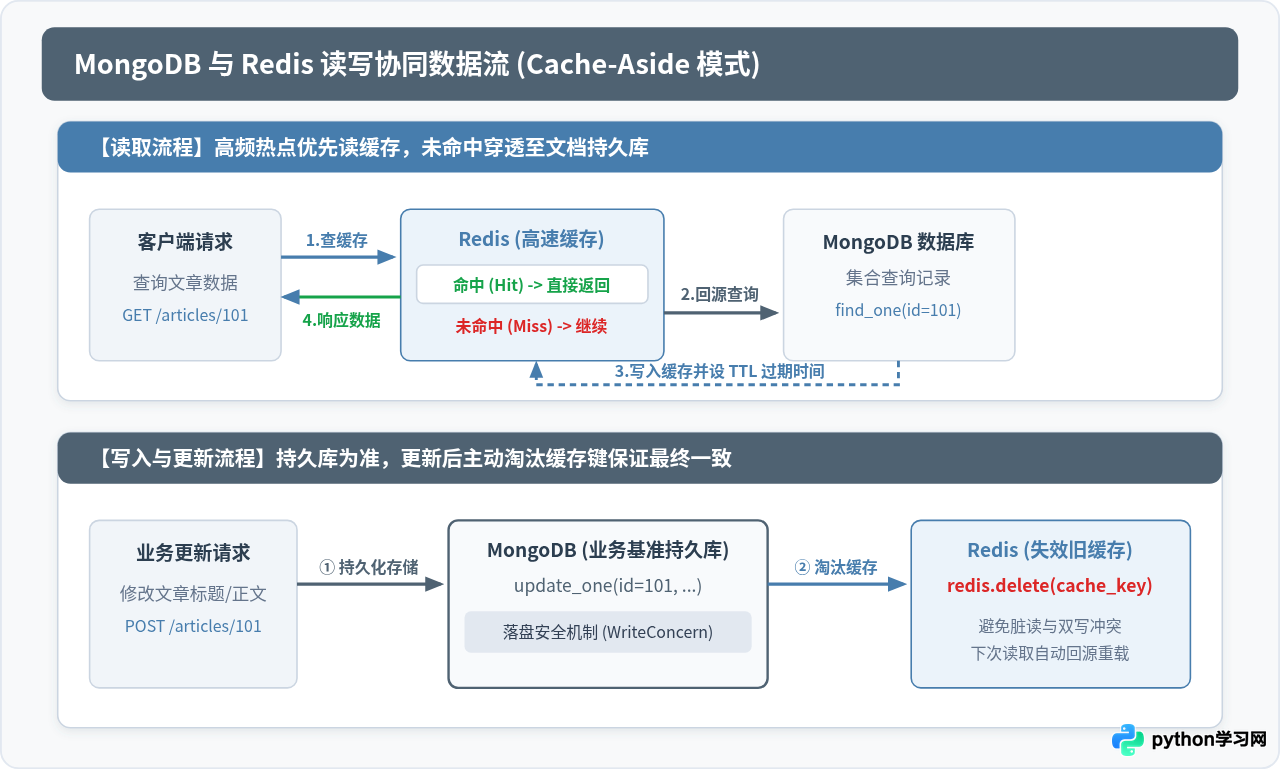
统一连接管理与协同服务示例
以下代码演示如何在单个 Python 模块中封装统一连接管理器,并实现完整的读写协同逻辑:
import json
from pymongo import MongoClient
import redis

class DatabaseManager:
    """统一数据库连接管理器(单例保持)"""
    _mongo_client = None
    _redis_client = None

    @classmethod
    def get_mongo(cls):
        if cls._mongo_client is None:
            cls._mongo_client = MongoClient(
                "mongodb://127.0.0.1:27017/",
                serverSelectionTimeoutMS=3000,
                maxPoolSize=50
            )
        return cls._mongo_client

    @classmethod
    def get_redis(cls):
        if cls._redis_client is None:
            pool = redis.ConnectionPool(
                host='127.0.0.1',
                port=6379,
                decode_responses=True,
                socket_timeout=3.0,
                max_connections=50
            )
            cls._redis_client = redis.Redis(connection_pool=pool)
        return cls._redis_client


class ArticleService:
    def __init__(self):
        self.mongo = DatabaseManager.get_mongo()["cms_db"]["articles"]
        self.redis = DatabaseManager.get_redis()

    def get_article(self, article_id: str) -> dict:
        """读取数据:先读缓存,未命中则回源 Mongo 并回写缓存"""
        cache_key = f"cache:article:{article_id}"

        # 1. 尝试从 Redis 读取
        cached_data = self.redis.get(cache_key)
        if cached_data:
            return json.loads(cached_data)

        # 2. Redis 未命中,回源 MongoDB 查询
        doc = self.mongo.find_one({"_id": article_id})
        if doc:
            # 3. 回写 Redis,设置 600 秒过期时间,防止热点击穿
            self.redis.set(cache_key, json.dumps(doc, ensure_ascii=False), ex=600)
            return doc
        return {}

    def update_article(self, article_id: str, new_title: str):
        """写入数据:更新 MongoDB,并淘汰 Redis 缓存"""
        cache_key = f"cache:article:{article_id}"

        # 1. 持久化存储更新
        self.mongo.update_one(
            {"_id": article_id},
            {"$set": {"title": new_title}},
            upsert=True
        )

        # 2. 淘汰缓存(删除键)
        self.redis.delete(cache_key)
        print(f"[协同更新] 数据已持久化至 MongoDB,且已淘汰缓存键 {cache_key}")
NoSQL 连接工程落地总结与检查清单
数据库连接属于昂贵的系统资源。在高并发和生产微服务环境中,不恰当的连接管理往往是导致性能瓶颈、连接池耗尽、进程假死的主要诱因。请对照以下四个维度的关键点进行上线检查:
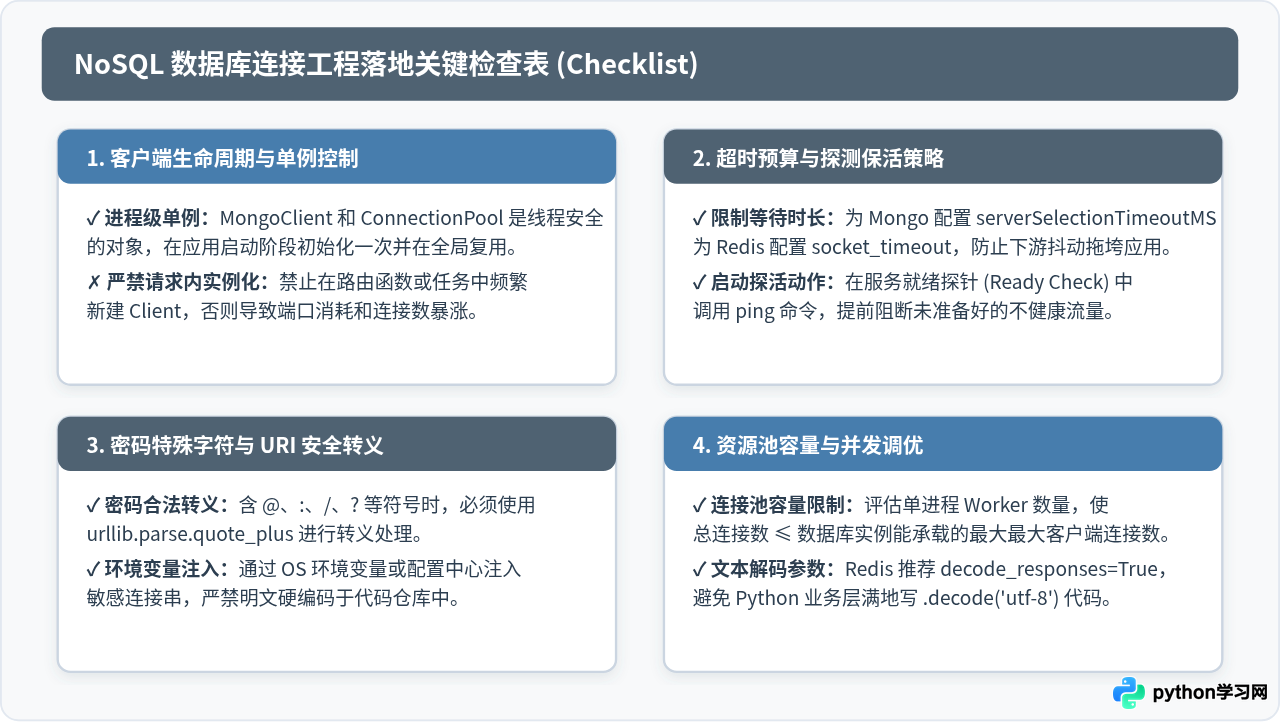
| 检查维度 | MongoDB (PyMongo) 规范 | Redis (redis-py) 规范 |
|---|---|---|
| 对象生命周期 | 在应用启动时构建单个 MongoClient 实例并在进程内共享,严禁在接口内部重复实例化。 |
独立构建 ConnectionPool 并注入给 Redis 实例,全应用共用同一个连接池。 |
| 超时预算 | 必须配置 serverSelectionTimeoutMS(建议 3000ms),避免拓扑发现无限卡死。 |
必须配置 socket_timeout 与 socket_connect_timeout(建议 3.0s)。 |
| 数据编解码 | 天然支持 Python 原生字典与 BSON 映射,日期使用 datetime.datetime。 |
连接池务必指定 decode_responses=True,直接返回 str 而非原生 bytes。 |
| 健康检查 | 调用 client.admin.command('ping') 触发物理连通。 |
调用 client.ping() 验证连接健康状态。 |
| 连接池上限 | maxPoolSize=50~100,结合单机 Worker 数量评估总连接数。 |
max_connections=50~100,严防突发流量下打满 Redis 最大客户端限制。 |
在使用 Gunicorn、uWSGI 或 Celery 等多进程模型部署 Python 服务时,务必注意:不要在 Master 主进程 fork 之前创建全局连接池!必须在 Worker 进程 fork 完成后的子进程初始化钩子(如 Gunicorn 的 post_fork 回调)中再行初始化连接,以避免父子进程共享同一套底层 Socket 描述符而产生竞争死锁或协议乱序。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















