


Python作为胶水语言在系统集成中有什么优势
深入解析Python作为胶水语言在系统集成中的核心优势,涵盖C/C++底层互操作、全协议生态覆盖、敏捷编排与异常治理,并对比全量重构及Shell脚本的实际工程差异。
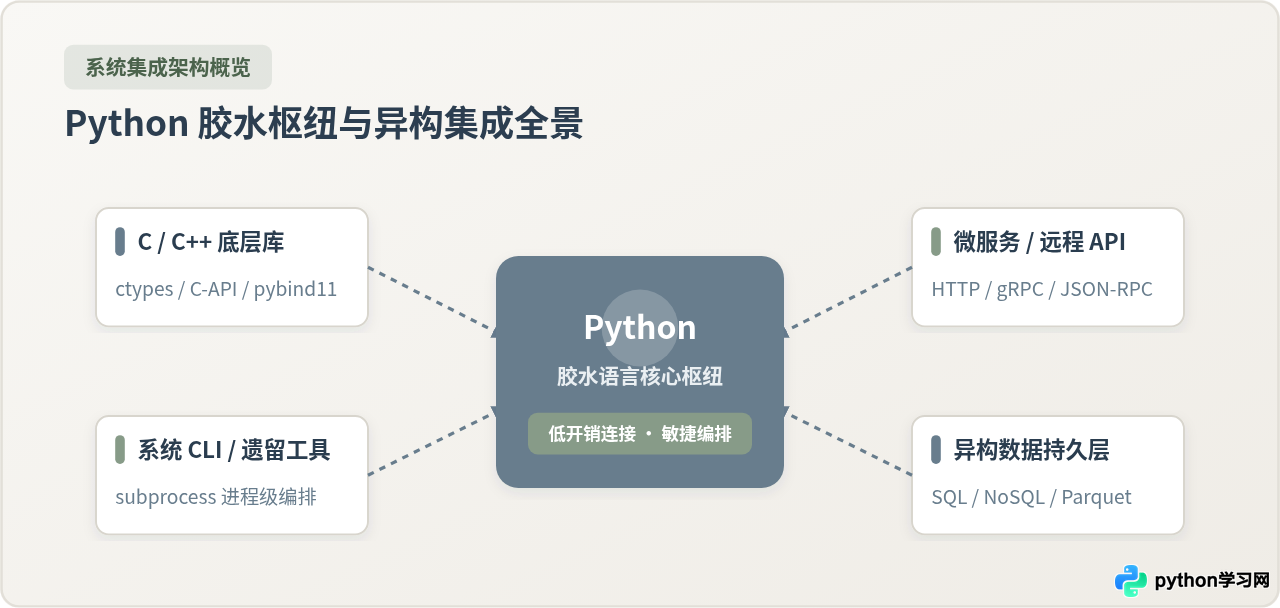
一、什么是“胶水语言”及其在系统集成中的定位
“胶水语言”一词起源于软件组件化思想。在实际生产场景中,企业很少能用同一种语言或同一种框架构建所有子系统。底层高频计算需要 C 或 C++ 保证极致的执行吞吐与实时性;业务管理后台可能运行在 Java 或 Go 编写的微服务集群上;而部分数据处理或自动化维护任务则依赖专属的操作系统 CLI 工具或科学计算库。
这种异构架构带来了两个突出痛点:一是跨语言通信门槛高、协议序列化与反序列化繁琐;二是业务流转变更频繁,若在强类型编译型语言中强行编写所有的适配器,会导致大量样板代码,每次接口微调都需要经历漫长的重新编译、测试与分发周期。
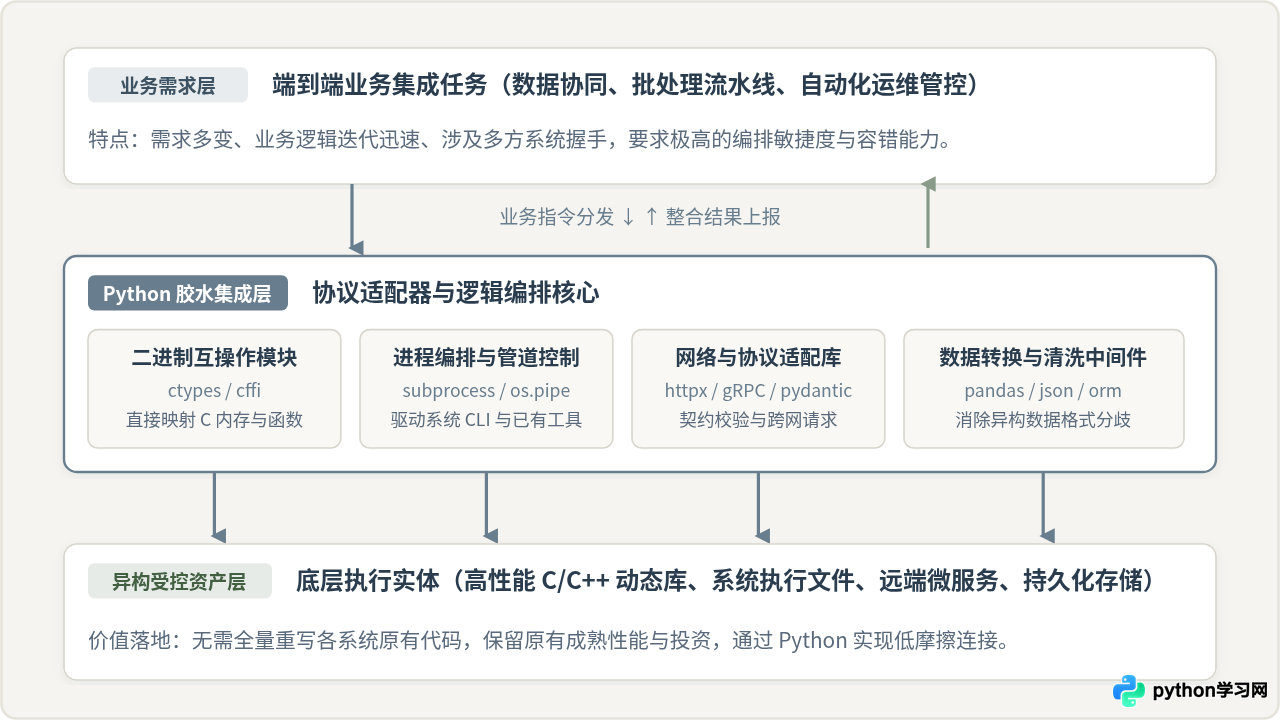
Python 在这一格局中精准定位于连接调度层。它向下能够无缝桥接 C/C++ 动态链接库与系统底层句柄,向横能够解析任意主流网络协议和数据载荷,向上则为工程师提供了几乎即写即用的高表达力语法。Python 不与底层性能库竞争运算速度,而是将这些高性能模块“粘合”起来,承担控制流、参数传递、错误捕获与数据转化的核心职责。
二、核心优势一:无缝的跨语言互操作与底层性能复用
Python 最具决定性的胶水特性,是其解释器(CPython)本身由 C 语言构建,原生提供了健全的 C API。在系统集成中,工程师可以直接调用现有的二进制动态链接库(Linux 下的 .so,Windows 下的 .dll,macOS 下的 .dylib),无需修改底层源码即可将其能力纳入 Python 流水线。
标准库内置的 ctypes 以及第三方的高性能库 cffi、pybind11,允许 Python 开发者以声明式方式定义 C 语言结构体、指定函数入参和返回值类型,并直接在 Python 进程的内存空间内完成高效交互。
实践示例:通过 ctypes 直接调度 C 动态链接库
假设某工程现存一个经过充分优化的 C 语言高性能矩阵处理动态库 libfastmath.so,需要被集成进新的数据清洗流水线:
# 动态链接库调用示例:集成 C 底层算力
import ctypes
from ctypes import c_int, c_double, POINTER, Structure

# 1. 加载操作系统中已编译好的动态链接库
math_lib = ctypes.CDLL("./libfastmath.so")

# 2. 映射 C 端结构体定义
class IntegrationPayload(Structure):
    _fields_ = [
        ("batch_id", c_int),
        ("factor", c_double),
        ("status_code", c_int)
    ]

# 3. 明确定义 C 函数的参数与返回值签名,保证内存安全
math_lib.process_payload.argtypes = [POINTER(IntegrationPayload)]
math_lib.process_payload.restype = c_double

# 4. 在 Python 中实例化并执行调用
payload = IntegrationPayload(batch_id=1024, factor=1.414, status_code=0)
result = math_lib.process_payload(ctypes.byref(payload))

print(f"计算结果: {result}, 更新后的状态码: {payload.status_code}")
通过这种方式,底层的密集计算依旧在原生机器指令下运行,享受 C 语言的极致性能;而外层的参数装配、配置读取、调用逻辑与下游分发则在 Python 中快速完成,做到了“鱼和熊掌兼得”。
三、核心优势二:全协议覆盖与海量生态资产
在企业级集成中,“异构”不仅体现为编程语言不同,更体现为通信接口与数据载荷的碎片化:
- 传输协议多态:同一个系统往往同时依赖本地管道(Unix Domain Socket / Stdin-Stdout)、标准网络协议(HTTP/1.1、HTTP/2、gRPC)、以及消息队列(Kafka、RabbitMQ、MQTT)。
- 数据格式混杂:遗留工具输出固定宽度的文本日志,微服务返回 JSON 或 Protocol Buffers,分析引擎依赖 Parquet 或 CSV,而数据库则采用二进制 TDS/MySQL 协议。
Python 在标准库层面就具备极其完备的开箱即用支持(如 json、csv、sqlite3、socket、urllib),而在第三方生态(PyPI)中更是几乎囊括了所有工业界协议的稳定 SDK。集成人员极少需要手动从零编写解析器,只需关注数据如何在各节点之间流转。
实践示例:通过 subprocess 驱动终端 CLI 工具并结构化输出
在很多集成场景中,旧系统没有对外暴露 HTTP 或 RPC 接口,只有一个运行在服务器上的命令行可执行程序。Python 的 subprocess 模块提供了无缝控制子进程、捕获标准输出与标准错误流的工业级能力:
# 系统集成实践:CLI 进程调用与数据契约转换
import subprocess
import json
import sys

def invoke_legacy_cli_tool(input_file_path: str) -> dict:
    cmd = ["/opt/legacy/bin/data_extractor", "--input", input_file_path, "--json-compat"]

    try:
        # 启动子进程,设定 15 秒超时保护,捕获 stdout/stderr
        process = subprocess.run(
            cmd,
            stdout=subprocess.PIPE,
            stderr=subprocess.PIPE,
            text=True,
            timeout=15,
            check=True
        )
        # 直接将输出流解析为结构化字典
        parsed_data = json.loads(process.stdout)
        return {"status": "success", "data": parsed_data}
    except subprocess.TimeoutExpired:
        return {"status": "error", "detail": "CLI 工具执行超时"}
    except subprocess.CalledProcessError as exc:
        return {"status": "error", "detail": exc.stderr.strip()}
subprocess 编排外部进程时,务必显式指定 timeout 参数并避免使用 shell=True,以防命令注入风险及子进程僵死阻塞整个调度流水线。
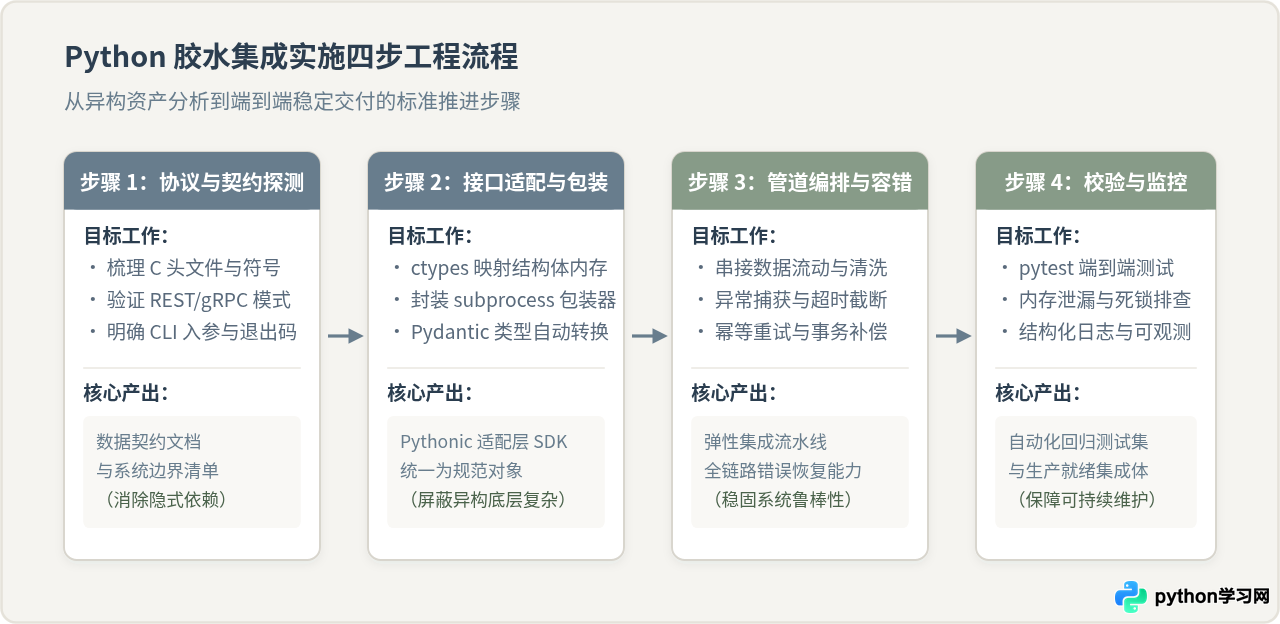
四、核心优势三:极高的交付敏捷度与动态适配弹性
系统集成中最耗费工程精力的往往不是稳定的核心业务,而是由于上下游系统升级、字段扩充、异常重试引发的接口频繁变动。
编译型语言(如 C++、Java)在此类频繁微调的场景下存在显著的摩擦成本:任何字段重命名或可选字段增删,都需要重新定义实体类、通过构建工具打包、再部署上线。而 Python 作为动态类型解释型语言,具备天然的柔性:
- 交互式原型探索(REPL / Jupyter):集成工程师可以在终端中一边测试与外部 API 或 C 库的联调响应,一边逐步沉淀清洗代码,大幅缩短排障周期。
- 动态属性与鸭子类型(Duck Typing):在应对半结构化数据时,无需严格穷举所有字段类型,开发者只需关注当前任务必需的键值,其余冗余数据透传即可。
- 现代渐进式类型支持:结合 Python 3 的 Type Hints 与
pydantic库,集成系统既可以在研发期获得静态检查与 IDE 自动补全,又能在运行时保持动态适应性。
五、横向对比:Python胶水编排 vs 全量统一重构 vs Shell脚本
为了准确评估 Python 在系统集成中的优势,我们需要将其与业界另外两种常见的处理方案进行一致条件下的对比:
- 方案 A(全量重构重写):废弃异构资产,全部使用同一种强类型静态语言(如统一用 Java 或 C++)重写所有系统。
- 方案 B(Shell / Bash 脚本粘合):仅依靠操作系统脚本把各类命令行工具与 curl 串起来。
- 方案 C(Python 胶水编排):保留底层核心系统与二进制资产,外围逻辑与数据转换统一由 Python 编排驱动。
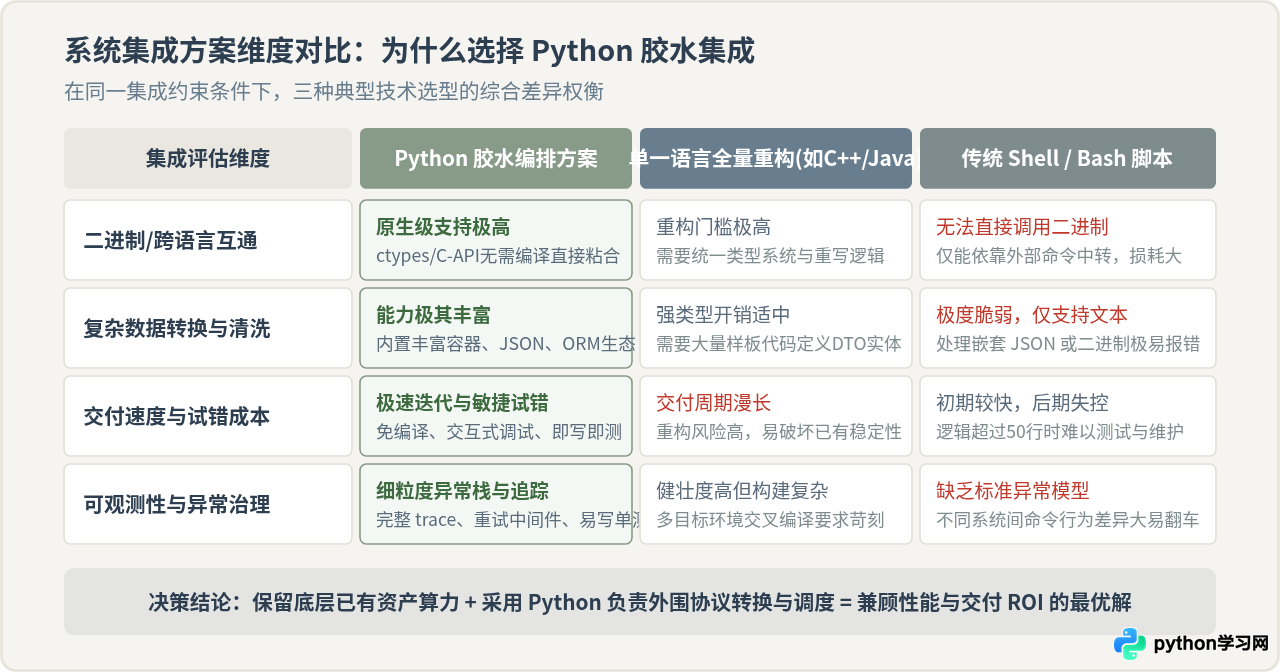
| 对比维度 | Python 胶水编排方案 | 单一语言全量重构 | Shell / Bash 自动化脚本 |
|---|---|---|---|
| 跨语言二进制互通 | 极佳:原生 C-API、ctypes、cffi 免编译直接挂载 | 极差:重写全部遗留代码,风险与工作量极大 | 缺失:无法直接操作内存或动态库,必须经由进程 |
| 数据结构与协议表达 | 极强:内置丰富字典/列表,开箱即用支持任意嵌套 JSON/二进制 | 强:但需维护大量严格的 DTO/POJO 实体样板代码 | 极弱:本质基于纯文本流,复杂结构解析极其脆弱 |
| 调试与可观测性 | 优秀:具备完整调用栈异常、内置 pdb、支持集中式结构化日志 | 优秀:编译期排查能力强,但调试联调周期长 | 较差:排查依靠 echo,缺乏健壮的结构化异常体系 |
| 工程维护与跨平台 | 高:跨 Windows/Linux/macOS 行为一致,标准工程管理 | 高:但跨平台编译与动态链接依赖管理较为苛刻 | 低:不同发行版甚至不同 bash/zsh 版本存在细微兼容性坑 |
对比表明:Shell 脚本虽然轻量,但仅适用于单机简单命令管道,一旦涉及复杂逻辑、重试事务或嵌套数据便难以为继;全量重构虽然理论上统一了技术栈,但工程成本过高、容易引入旧业务逻辑丢失的重大风险。Python 胶水编排在保全原有生产投资的同时,以最低的摩擦成本实现了多源系统的规范统一。
六、工程边界与注意事项
理解 Python 胶水语言的优势,必须同时认清其适用边界与工程约束:
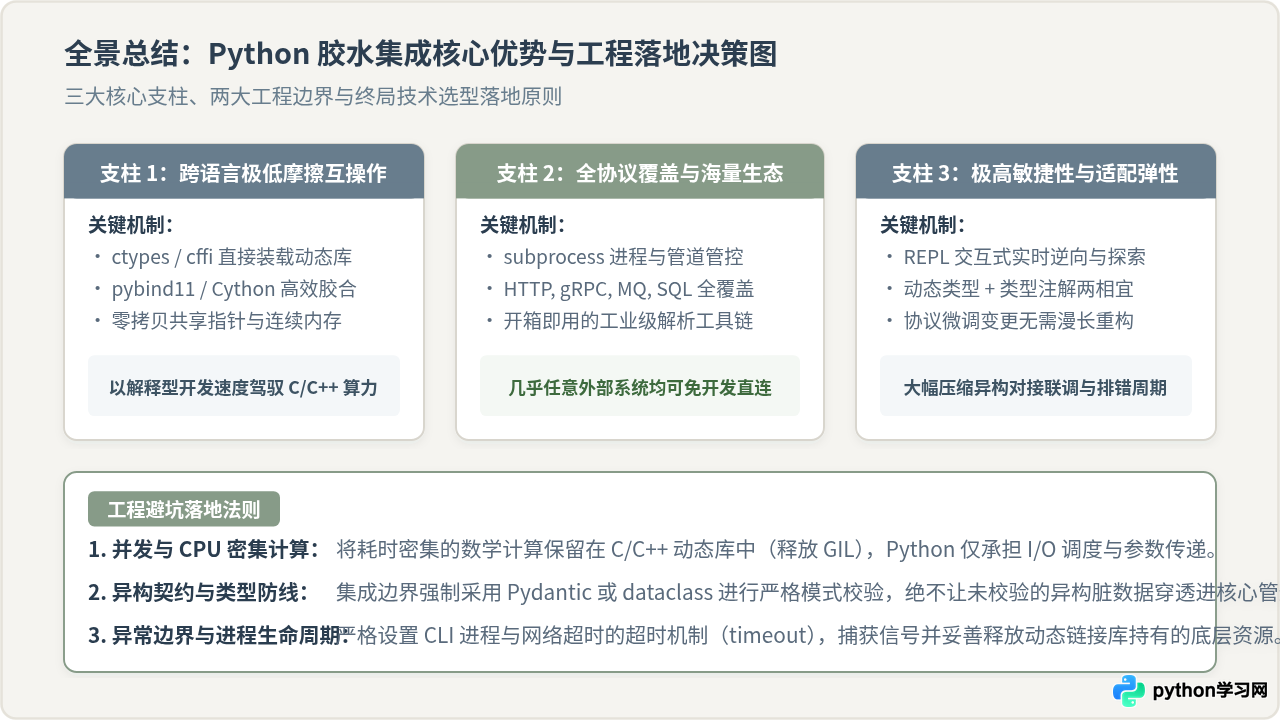
- GIL(全局解释器锁)与多核利用:Python CPython 解释器存在 GIL 限制,纯 Python 代码的多线程无法实现 CPU 密集的真并行。在系统集成中,应当将 CPU 密集型任务(如大批量加密、图像编解码、张量计算)下沉至 C/C++ 动态库中,并在底层库内部释放 GIL(
Py_BEGIN_ALLOW_THREADS),Python 主干则专注于基于asyncio或多进程的高并发 I/O 调度。 - 接口契约与防御性校验:动态类型是一把双刃剑。若下游系统未经过校验就直接使用异构端传来的不可控字典,可能在深层逻辑中爆发
KeyError或类型隐式转换异常。在关键集成边界,应强制使用数据验证框架(如 Pydantic)定义入参边界。 - 底层内存管理界限:通过
ctypes访问 C 函数申请的内存指针时,Python 垃圾回收器(GC)不会自动追踪外部堆空间。必须显式定义内存释放接口,防止长时间运行的集成守护进程发生内存泄漏。
七、总结
系统集成的终极目标不是追求统一的代码美学,而是在受控的风险与时间内,打通异构孤岛、释放业务价值。
Python 之所以成为公认的“胶水语言之王”,核心在于其在底层高性能与上层高生产力之间架起了一座低阻抗的桥梁:它既能贴近底层与 C 库零摩擦对话,又能凭借健全的生态轻松编排任何主流协议。结合良好的契约约束与工程规范,以 Python 为中枢的集成体系能够以最小的改造成本盘活企业复杂的软件资产,实现系统的持续演进。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















