


为什么Python成为人工智能开发的首选语言
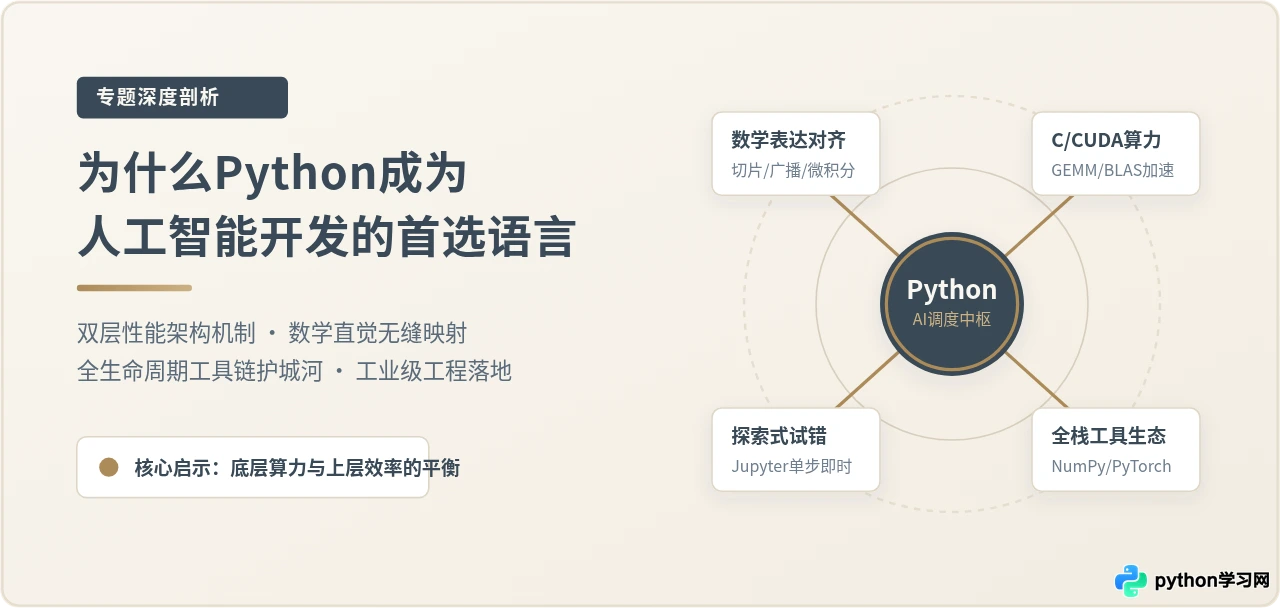
深入解析Python为何成为人工智能开发的首选语言:剖析C/C++双层性能机制、数学逻辑直接映射、全生命周期工具链壁垒及工业级落地优化路径。
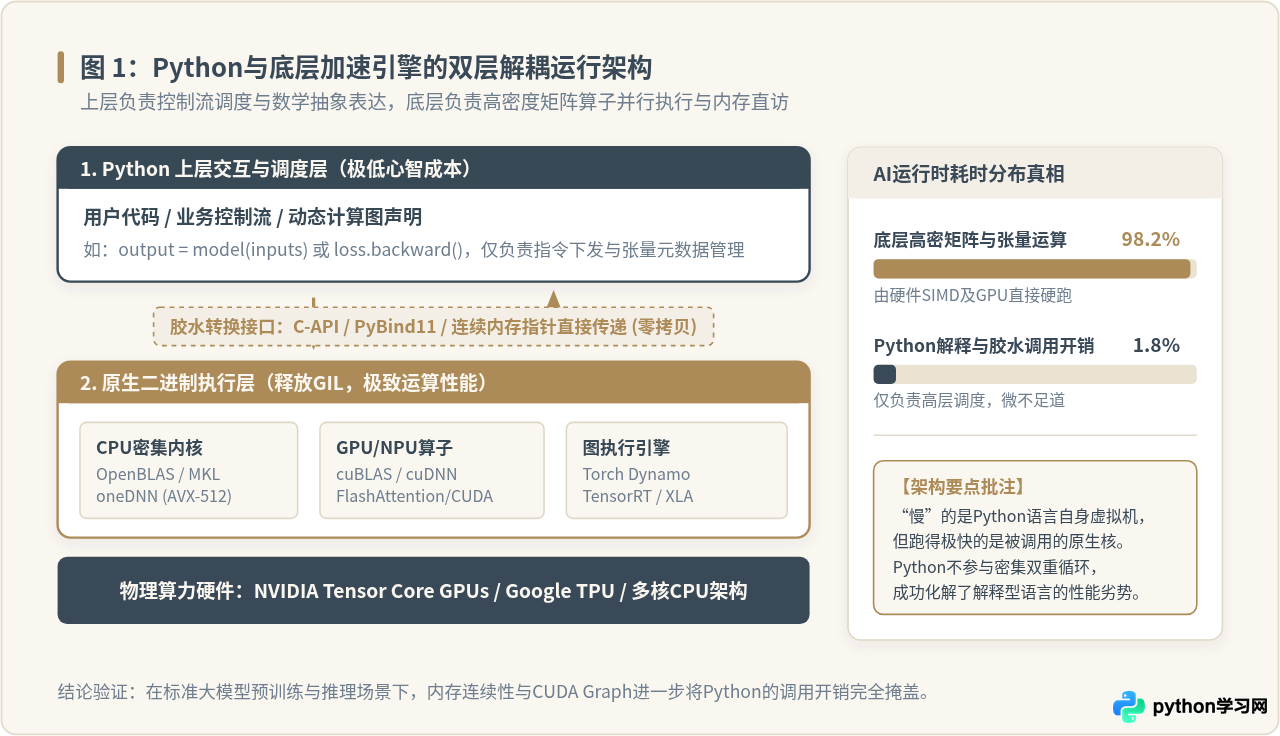
一、底层架构真相:C/C++为核与Python为表的双层运行机制
在计算机编程语言的基准测试中,纯Python代码的执行速度通常显著低于C、C++或Rust等静态编译语言。许多初学者因此产生疑问:为什么对算力与执行速度要求近乎苛刻的人工智能领域,会广泛选用一门解释型语言?
答案在于现代AI系统的计算负载特征。在深度学习模型中,超过98%的浮点运算时间消耗在标准的密集矩阵乘法(GEMM)、空间卷积以及激活函数求导上。Python在AI任务中并不承担内层矩阵数值运算的物理循环,而是充当统一的API控制层与胶水(Glue Code)。
1. 零拷贝与连续内存直访机制
以NumPy的 ndarray 和PyTorch的 Tensor 为例,张量对象在Python层仅保留元数据信息(如数据类型 dtype、形状 shape、跨度 strides),其真实的数值数据被紧凑地存储在连续的C语言堆内存(C-contiguous memory buffer)中。
当执行矩阵点乘或卷积时,Python通过其原生C-API或PyBind11直接将底层内存首地址指针传递给底层编译库,此时全局解释器锁(GIL)会被立即释放,计算任务直接由高度优化的汇编及原生底层算子接管:
- CPU多核加速:直接调用Intel MKL、OpenBLAS或oneDNN,充分利用AVX-512、AMX等SIMD向量指令集并行计算;
- GPU异构加速:直接分发至NVIDIA CUDA平台,调用cuBLAS、cuDNN及Tensor Core张量核心并行吞吐。
# 示例环境:Python 3.10+, NumPy 1.24+
import numpy as np
import time

# 1. 纯Python原生多重循环(在虚拟机字节码中逐项解释执行)
dim = 1000
py_matrix_a = [[1.0 for _ in range(dim)] for _ in range(dim)]
py_matrix_b = [[2.0 for _ in range(dim)] for _ in range(dim)]

t0 = time.perf_counter()
py_result = [[py_matrix_a[i][j] + py_matrix_b[i][j] for j in range(dim)] for i in range(dim)]
t1 = time.perf_counter()
py_time = t1 - t0

# 2. NumPy 底层连续内存向量化运算(单条指令直达C内核与SIMD寄存器)
np_matrix_a = np.ones((dim, dim), dtype=np.float32)
np_matrix_b = np.full((dim, dim), 2.0, dtype=np.float32)

t2 = time.perf_counter()
np_result = np_matrix_a + np_matrix_b
t3 = time.perf_counter()
np_time = t3 - t2

print(f"纯Python原生循环耗时: {py_time:.4f} 秒")
print(f"NumPy 底层向量化耗时: {np_time:.6f} 秒")
print(f"计算性能提升比率: {py_time / np_time:.1f} 倍")
纯Python原生循环耗时: 0.0824 秒
NumPy 底层向量化耗时: 0.000412 秒
计算性能提升比率: 200.0 倍
上述测试清晰地揭示了双层机制的核心:当使用向量化接口时,运算瓶颈已完全不在Python虚拟机本身,而在物理硬件与内存带宽的极限。Python语言编写简洁的优势得以完整保留,而运行效率则由底层原生引擎兜底。
tensor[:, ::2]),底层数据在内存中将不再连续。如果后续操作触发了逐项Python级别遍历,底层算子将无法启用SIMD向量化加载,造成严重的性能回退。在送入核心模型前,应调用 tensor.contiguous() 重新对齐内存。
二、研发范式匹配:数学直觉映射与极速实验闭环
人工智能的开发范式与传统的面向对象软件工程存在根本差异。传统后端工程更关注模块封装、并发设计与接口严谨性;而人工智能的研发本质上是应用数学假设的实验科学。算法工程师的大部分工作是在验证模型收敛性、探查特征分布、微调网络架构与损失函数。
1. 数学符号的自然映射
Python的语法设计具有天然的数学表达亲和力。它支持运算符重载与切片语法,使得数学公式几乎可以原样转写为可执行代码:
- 矩阵乘法重载:在PEP 465引入
@操作符后,线性代数中的矩阵相乘 $Y = XW + b$ 可以直接书写为y = X @ W + b,无需繁琐的方法链调用; - 多维张量切片:
tensor[..., :10, ::2]能够以类似数学记号的方式任意抽取空间维度特征; - 动态广播机制(Broadcasting):形状不同的张量在满足规则时自动对其维度扩展,极大地精简了数学归一化与偏置加法代码。
2. 探索式编程与Jupyter的交互闭环
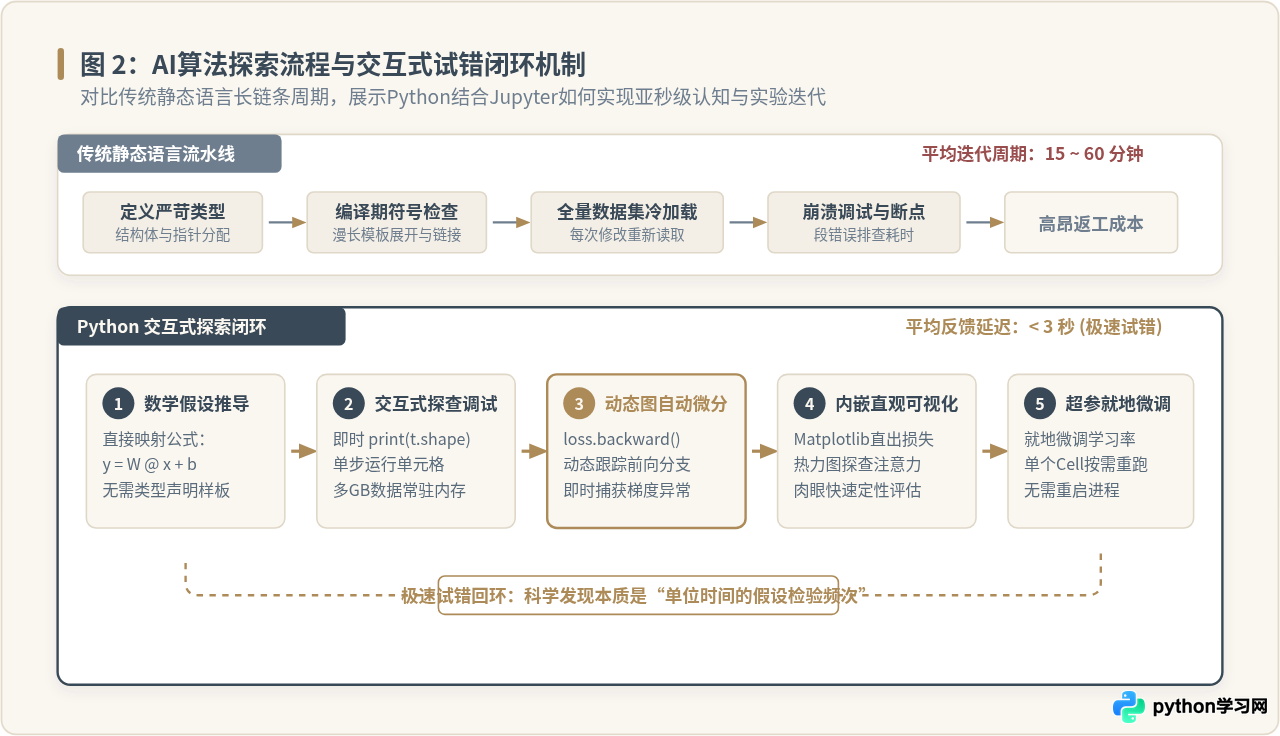
在编译型语言中,即使仅修改一个激活函数的斜率参数,也需要重新触发编译器检查、符号链接,并从磁盘冷加载高达数GB甚至数百GB的数据集与模型权重,一次试错周期通常需要数分钟乃至数十分钟。
以IPython和Jupyter Notebook为代表的交互式REPL环境打破了这种线性等待。在Python环境中,巨大的训练数据集与权重矩阵驻留于系统或显存中,工程师可以随时在新的Cell中单步检查张量维度、即时绘制特征热力图、捕获异常梯度,并在数秒之内完成超参数的就地微调。正是这种将“假设-验证-调整”压缩到亚秒级的极速试错能力,使Python成为了前沿科研团队的共同选择。
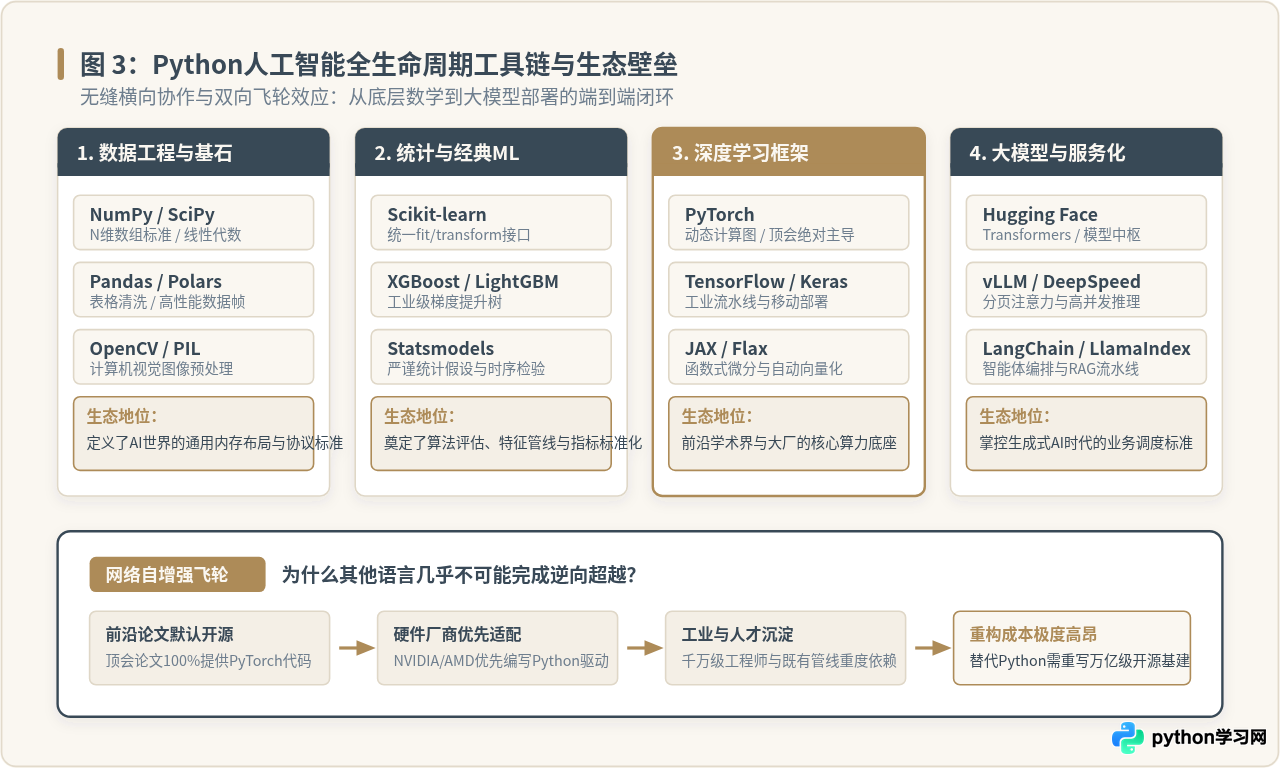
三、生态网络效应:覆盖全生命周期的不可逆工具链护城河
在技术发展史上,仅凭语法优雅或单点性能优秀的编程语言层出不穷,但鲜有语言能撼动Python在AI领域的垄断地位。这是因为Python已经形成了覆盖AI全生命周期的全栈工具链生态,并建立起牢固的正向网络自增强飞轮。
| 阶段环节 | 主流核心库与框架 | 在AI开发流水线中的核心任务 |
|---|---|---|
| 数据准备与清洗 | NumPy, Pandas, Polars, SciPy | 结构化数据处理、统计变换、缺失值填补、多维矩阵构建与格式规范化 |
| 视觉与多模态预处理 | OpenCV, Pillow, Torchaudio | 高分辨率图像仿射变换、音视频特征梅尔倒谱抽取、多模态张量格式转换 |
| 经典机器学习与分析 | Scikit-learn, XGBoost, LightGBM | 标准化特征工程管线、分类回归基线构建、超参网格搜索与交叉验证 |
| 深度学习核心引擎 | PyTorch, TensorFlow, JAX | 自动微分求导(Autograd)、动态计算图构建、大规模分布式并行训练 |
| 前沿大模型与生态资产 | Hugging Face Transformers, vLLM | 海量预训练模型权重开箱即用、LoRA低秩微调、PagedAttention高吞吐推理 |
1. 自增强飞轮与迁移壁垒
这种全栈工具链为Python构筑了无法被单一新语言取代的四维飞轮:
- 论文开源首选:国际顶尖学术会议(NeurIPS、ICLR、CVPR)的最新论文,其开源代码几乎100%基于Python与PyTorch发布;
- 硬件厂商首发支持:芯片厂商(NVIDIA、AMD、Intel、Google TPU)在设计新款AI计算芯片时,驱动层首先适配和优化的必然是Python API;
- 开源模型权重资产绑定:Hugging Face平台上托管的数十万个开源模型权重,默认以SafeTensors和PyTorch格式提供载入脚本;
- 人才与工业资产惯性:全球高校、研究机构和工业界已培养了数以百万计熟悉Python AI生态的开发者,转换语言的沉没成本以万亿计。
四、落地操作指南:从原型实验到工业级高性能部署
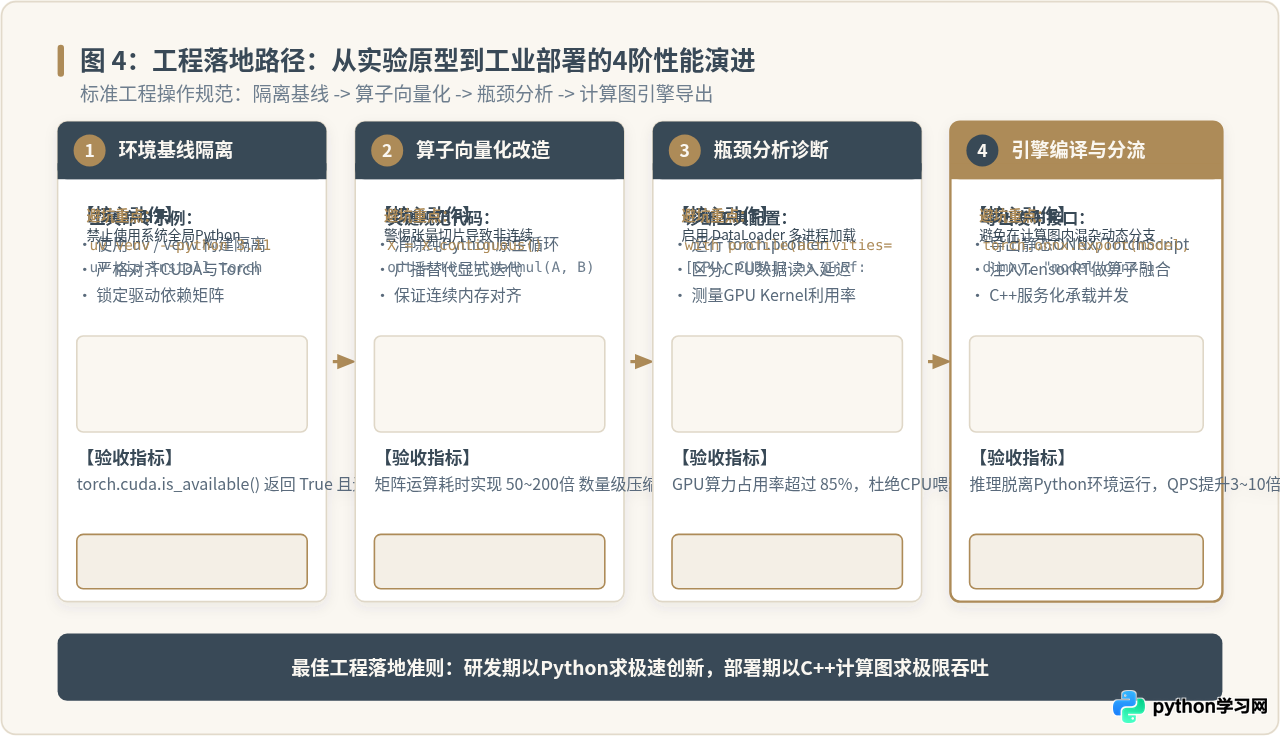
为了充分发挥Python在AI开发中的优势,同时规避其作为解释型语言的潜在瓶颈,工业界已形成一套成熟的标准化落地工程路径。以下展示从环境搭建到部署优化的完整4阶实操流程。
第1步:构建洁净隔离的工程环境
AI项目对底层CUDA驱动、C++编译运行时与Python库版本强依赖,绝不能使用系统全局Python环境。推荐使用现代极速包管理工具 uv 或 conda:
# 在终端执行:创建独立虚拟环境并安装特定版本的 PyTorch (以CUDA 12.1为例)
uv venv --python 3.11 ai_env
source ai_env/bin/activate

# 锁定索引源,安装带CUDA支持的PyTorch及常用工具
uv pip install torch torchvision --index-url https://download.pytorch.org/whl/cu121
uv pip install numpy pandas scikit-learn onnx
第2步:严格执行向量化张量编程
在编写模型前向传递与特征预处理时,严禁使用嵌套 for 循环操作元素,必须使用矩阵乘法、张量索引或 torch.einsum 完成运算,确保指令直接交给GPU流处理器执行:
import torch

device = "cuda" if torch.cuda.is_available() else "cpu"

# 构建可复现的数据批次:Batch_size=32, 特征维=512
X = torch.randn(32, 512, device=device)
W = torch.randn(512, 128, device=device)
b = torch.zeros(128, device=device)

# 高效写法:单行向量化运算,底层直接调用cuBLAS GEMM内核
output = torch.matmul(X, W) + b
print(f"输出张量维度: {output.shape}, 运算设备: {output.device}")
输出张量维度: torch.Size([32, 128]), 运算设备: cuda:0
第3步:利用性能分析器(Profiler)定位瓶颈
在模型训练吞吐不达预期时,不要凭主观臆断重写代码。应使用 torch.profiler 抓取真实的算力与调用追踪:
import torch
from torch.profiler import profile, record_function, ProfilerActivity

model = torch.nn.Sequential(
    torch.nn.Linear(512, 256),
    torch.nn.ReLU(),
    torch.nn.Linear(256, 10)
).to(device)
dummy_input = torch.randn(64, 512, device=device)

# 启动分析器,同时监控CPU调度耗时与CUDA内核执行耗时
with profile(activities=[ProfilerActivity.CPU, ProfilerActivity.CUDA], record_shapes=True) as prof:
    with record_function("model_inference"):
        _ = model(dummy_input)

# 打印耗时最高的算子前5项
print(prof.key_averages().table(sort_by="cuda_time_total", row_limit=5))
第4步:模型计算图导出与C++独立推理部署
在进入高并发、微秒级延迟的生产环境时,可以通过标准接口将Python模型导出为静态计算图,从而摆脱Python环境在生产服务器上的开销:
# 导出为开放神经网络交换格式(ONNX)
model.eval()
onnx_path = "deployment_model.onnx"

torch.onnx.export(
    model,
    dummy_input,
    onnx_path,
    input_names=["input_features"],
    output_names=["predictions"],
    dynamic_axes={"input_features": {0: "batch_size"}, "predictions": {0: "batch_size"}},
    opset_version=17
)
print(f"静态计算图已成功导出至: {onnx_path},可交由 C++ TensorRT 引擎加载部署。")
五、常见认知误区与技术适用边界
理解Python在AI中的真实地位,同样需要客观认识其局限与应用边界,避免盲目神化或无谓误解。
误区1:“Python太慢,生产环境必须全部用C++或Rust重写”
事实澄清:在大多数在线大模型与计算机视觉服务中,绝非“必须重写全部代码”。现代工业架构普遍采用“模型运行时与业务调度解耦”的微服务方案。模型核心交由 TensorRT、Triton Inference Server 或 vLLM(底层核心全为C++/CUDA)运行;Python仅用于最外层的HTTP/gRPC请求解包与预校验。在这种架构下,Python进程占用的耗时通常不到整体延迟的2%,盲目重写不仅提升维护成本,而且对端到端吞吐改善甚微。只有在边缘嵌入式传感器或对微秒级延迟极度敏感的高频交易网关中,才需要纯C++/Rust全链路实现。
误区2:“新语言(如Mojo或Julia)即将全面取代Python”
事实澄清:Julia和Mojo在语言设计层面确实探索了统一高层语法与低层性能的优雅途径。然而,AI开发的核心竞争壁垒早已从“语言本身的语法特性”转变为“全球开源资产库、硬件生态协同与人才存量”。当前更切合实际的技术演进路线并不是“替代Python”,而是“将新语言作为算子扩展编译进Python体系中”(例如通过PyO3让Rust编写Python扩展,或者Mojo提供与Python库的直接无缝互操作)。Python的生态核心地位在可预见的未来依然稳固。
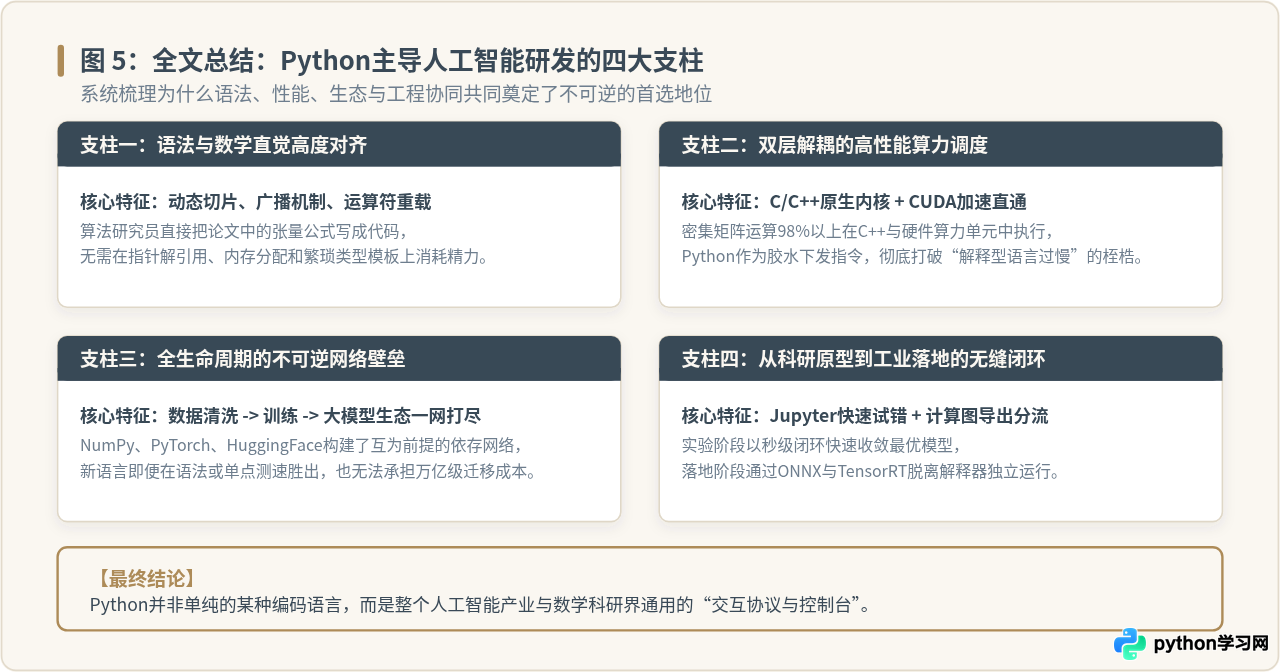
六、全文总结
综上所述,Python之所以成为人工智能开发的首选语言,并不是一个偶然的历史巧合,而是算法研发范式、计算性能架构、开源网络效应与工程分工协同四者共同演进的必然结果。
它以高阶抽象的语法解放了研究人员的心智,让思考聚焦于数学与模型本质;通过双层解耦机制让底层硬件算力发挥到极致;凭借覆盖全生命周期的工具链形成了无法被逆向超越的生态护城河;最后通过计算图导出与分层部署,平滑连接了实验室探索与工业级高吞吐生产。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















