


新手学Python常犯的5个错误:缩进、编码与命名规范
详细解析新手学习Python时最常犯的5个典型错误,涵盖缩进与Tab混用、作用域层级错位、文本读写编码冲突、内建名称覆盖与PEP 8命名混乱,并提供明确的排查与修正方案。
Python以语法精简著称,常被称为“接近自然语言的编程语言”。然而,对于初次接触Python的新手来说,正是这种表面上的“自由”,隐藏了许多看似琐碎却极易导致程序崩溃或产生隐蔽Bug的深坑。最典型的问题集中在三个核心领域:强制缩进引发的格式灾难、跨平台文本与文件处理的字符编码冲突,以及自由命名机制下的作用域污染与风格混乱。本文梳理初学者最常犯的5个典型错误,逐一剖析其底层成因、具体代码表现,并提供明确的预防与修复方案。
错误一:混用空格与Tab键导致缩进崩溃(TabError)
大多数编程语言使用大括号 {} 或特定的关键字(如 begin/end)来界定语句块,而Python则独创性地采用物理缩进来表达逻辑层级。这种设计虽然让代码结构一目了然,但给新手带来了巨大的操作隐患:肉眼看起来整齐划一的代码,在Python解释器眼里可能完全错位。
最隐蔽的错误来自空格(Space)与制表符(Tab)的混用。在常见的文本编辑器中,按一次 Tab 键默认可能显示为占用4个字符宽度的空白,但其底层存储的ASCII码是 \t(十六进制 0x09);而4个空格是4个 0x20 字符。在文本编辑器里两行代码完全对齐,但在Python 3的词法分析器中,二者是绝对不可通用的。
# 常见问题代码示例(混用空格与Tab)
def calculate_discount(price):
    base_rate = 0.9  # 此行使用 4 个空格缩进
	final_price = price * base_rate  # 此行使用 1 个 Tab 键缩进
    return final_price
运行上述代码时,Python 3 会立刻抛出错误:TabError: inconsistent use of tabs and spaces in indentation。这种错误极难通过肉眼查找,尤其在团队协作或复制代码时最容易发生。
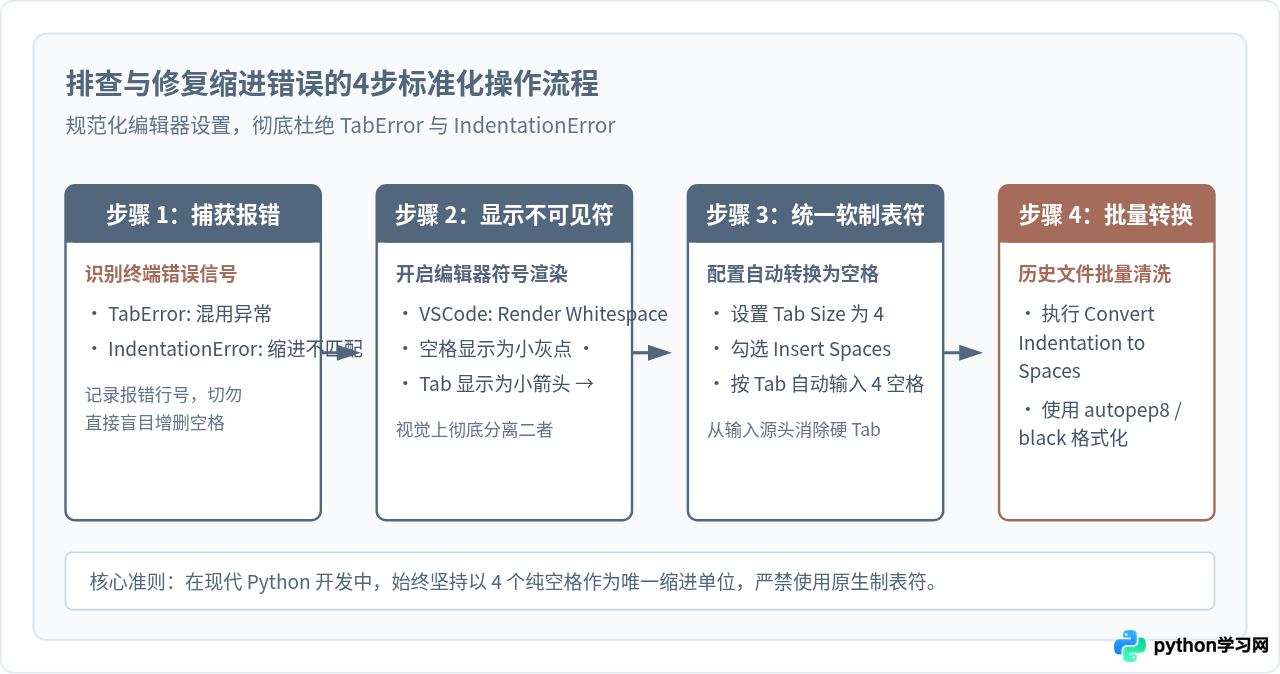
解决对策:
- 在主流代码编辑器(如 VS Code、PyCharm)中,打开“显示不可见字符”(Render Whitespace)。空格会呈现为一个浅灰色的微小圆点
·,而 Tab 则显示为箭头→。 - 修改编辑器设置:将“Tab 键宽度”(Tab Size)设置为 4,并勾选“插入空格”(Insert Spaces)。这样每次在键盘上敲击 Tab 键时,编辑器会自动将其替换为 4 个空格字符。
- 对已存在的旧文件,使用编辑器的“转换缩进为空格”(Convert Indentation to Spaces)功能进行一次性清洗。
错误二:层级缩进偏差——静默发生的作用域逻辑陷阱
如果说 TabError 还会直接抛出语法异常中止程序,那么层级缩进位置偏差所引发的问题要致命得多,因为它属于静默逻辑错误——程序语法完全合法,能够正常运行,但输出的结果与预期完全相反,排查起来极其耗时。
最常见的场景出现在 for / while 循环体与条件分支的嵌套结构中。初学者常常由于疏忽,将本应处于循环内部的代码多回退了一格,或者将本应在循环结束之后才执行的代码缩进到了循环体内部。
# 场景:计算所有正数的累加和,但 return 缩进位置错误
def sum_positive_numbers(numbers):
    total = 0
    for num in numbers:
        if num > 0:
            total += num
        # 错误:return 被缩进在循环内部!
        return total

# 调用示例
data = [1, 2, 3, 4]
result = sum_positive_numbers(data)
print("计算结果:", result) # 输出为 1,循环刚跑完第一轮就被强行终止了!在上面的示例中,return total 语句本意应是在遍历完列表中的所有元素之后返回最终总和。但由于程序员误将其缩进到了 for 循环内部,导致循环在第一轮迭代执行完毕后立刻终止并返回。解释器不会对此发出任何警告,测试用例如果只包含单个元素甚至能侥幸通过,但在生产环境中会造成严重的业务偏差。
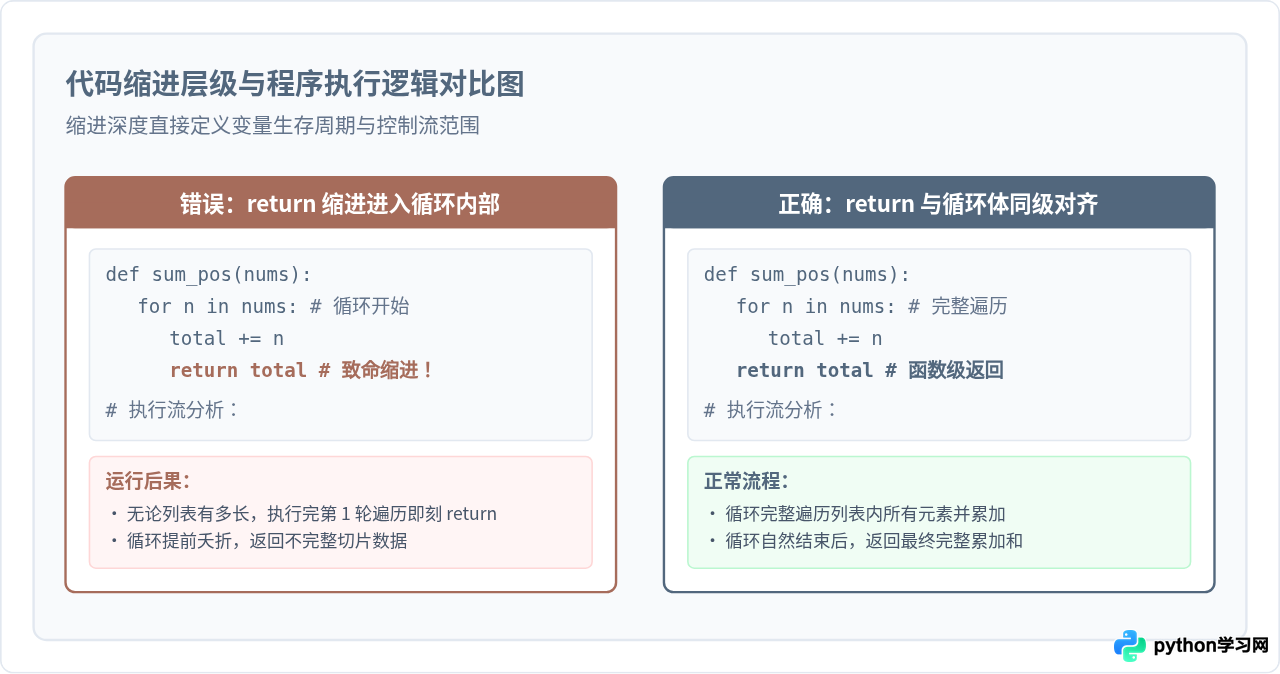
编写循环和分支时,请始终自问:“这一行代码是属于每一轮都要执行,还是所有轮次结束后才执行一次?”若是后者,务必将缩进回退至与 for / while 关键字齐平。
错误三:文件读写未指定编码引发的乱码与解码异常
在 Python 3 中,所有运行时的普通文本字符串(str)在内存中都是以抽象的 Unicode 编码表示的,而磁盘上的文件或网络传输的数据包则都是纯二进制的字节序列(bytes)。将二进制文件读取为文本,本质上是执行解码(decode);将内存文本写入文件,本质上是执行编码(encode)。
很多初学者在写文件读写操作时,习惯性写出 open("data.txt", "r") 这样省略编码参数的代码。在 macOS 或 Linux 系统上,操作系统的默认编码通常是 UTF-8,因此代码看似运行良好;但一旦将同一份脚本移到 Windows 系统上运行,Python 会默认调用 Windows 底层的代码页(如简体中文版的 GBK / CP936)。此时只要文件中包含生僻中文字符或 Emoji,程序就会瞬间崩溃,抛出恶名昭彰的 UnicodeDecodeError: 'gbk' codec can't decode byte ...。
# 错误示范:省略 encoding 参数,在 Windows 下极易崩溃
with open("readme.txt", "r") as f:
    content = f.read()  # 在非 UTF-8 环境直接触发 UnicodeDecodeError

# 正确标准:始终显式传递 encoding="utf-8"
with open("readme.txt", "r", encoding="utf-8") as f:
    content = f.read()

# 写入时同样必须指定
with open("output.txt", "w", encoding="utf-8") as f:
    f.write("保持全流程 UTF-8 编码标准化")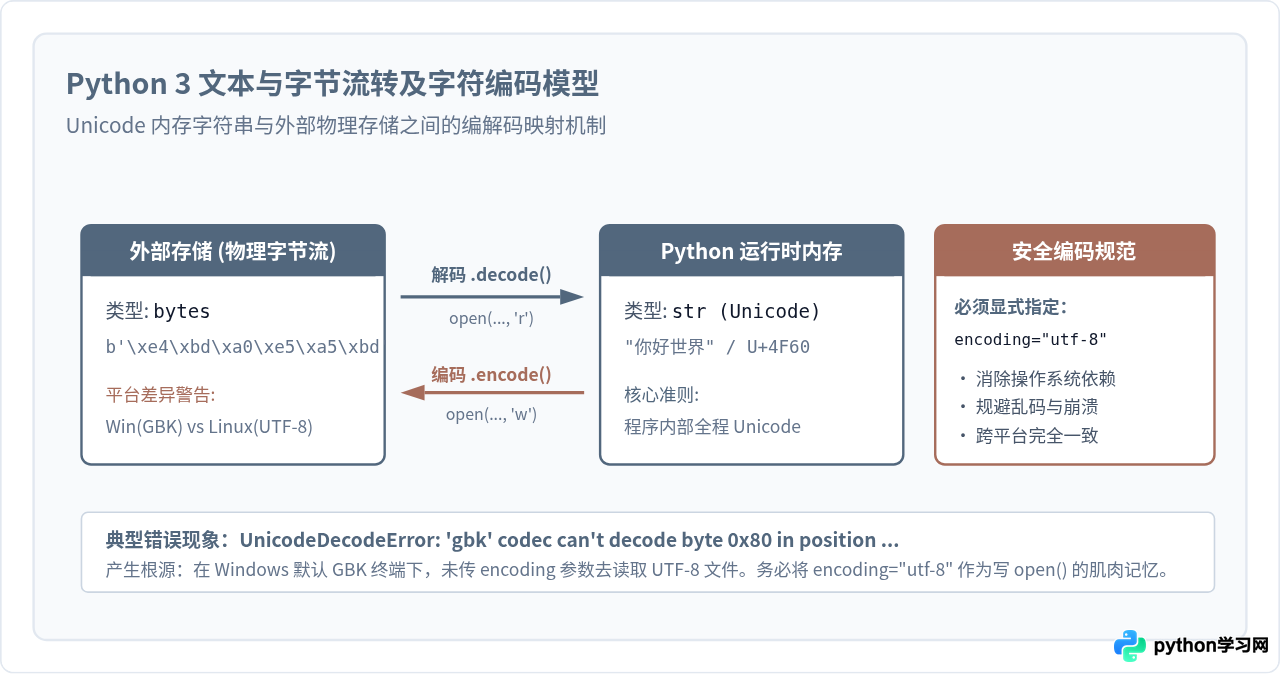
错误四:覆盖Python内建函数与关键字的危险命名
Python 具备高度灵活的动态类型系统,变量名本质上是指向对象的指针。这种灵活性带来了一个极易被新手滥用的副作用:Python 允许你在当前局部或全局命名空间中,重新定义并覆盖大部分内置函数(Built-in Functions)。
很多新手为了图省事,直接拿常见的单词命名变量,例如:
- 使用
list = [1, 2, 3]存储列表数据; - 使用
str = "hello"存储字符串; - 使用
dict = {"a": 1}存储映射字典; - 使用
id = 1001记录用户主键; - 使用
input = "data"保存接收到的参数。
在赋值的那一刻,代码完全不会报错。然而,一旦代码后续需要调用原生的类型转换或内建操作时,灾难就会瞬间降临:
# 危险示范:覆盖了 Python 内置的 list 和 str
list = [10, 20, 30]  # 此时当前作用域中的 list 不再是类型,而变成了一个普通实例!

# 几行代码后,尝试将元组转换为列表:
user_ids = (101, 102, 103)
converted_list = list(user_ids)
# 报错:TypeError: 'list' object is not callable
此时抛出的 TypeError: 'list' object is not callable 经常让新手摸不着头脑:list() 明明是标准内置函数,为什么会变成“不可调用”?原因正是之前的那次变量赋值遮蔽了内建命名空间(Builtins Namespace)。排查此类问题的成本极高,尤其是当这种覆盖发生在大型脚本的前几十行时。
避坑策略:
- 利用现代 IDE 的语法高亮:内建函数在 VS Code 或 PyCharm 中通常会有专属的高亮颜色(如深蓝、紫色或斜体),若发现自己命名的变量呈现出与普通变量不同的特殊颜色,应立刻更换名称。
- 采用具体、有语境的名称:用
item_list、data_list替代list;用user_id替代id;用raw_text替代str。 - 遇到确实必须使用关键字的情况(例如某些第三方库参数为
class),PEP 8 推荐在变量名末尾追加单下划线,写作class_或id_。
错误五:违背PEP 8规范的命名混乱与大小写风格混淆
Python 社区拥有非常成熟、广泛遵守的官方样式指南——PEP 8(Python Enhancement Proposal 8)。许多新手来自 C++、Java 或前端 JavaScript 背景,习惯于在 Python 中滥用小驼峰命名法(如 getUserInfo),甚至将类名写成小写、将普通变量全部大写。
虽然语法上驼峰命名法在 Python 中能够运行,但它破坏了代码的可读性契约。更严重的是,大小写混淆会直接导致概念识别混乱:
# 违背规范与反直觉的命名风格
class user_account:  # 错误:类名使用了小写下划线,极易与普通变量或模块名混淆
    def __init__(self, User_Name):  # 错误:形参首字母大写
        self.User_Name = User_Name

def CalculateTotalPrice(items):  # 错误:函数使用了大驼峰,看似是一个类实例化
    total = sum(items)
    return total

MAX_RETRY = 3  # 正确:全局常量全大写
在 Python 的标准惯例中,大驼峰命名(PascalCase)代表一个类(Class),开发者看到 ClassName() 会下意识认为这是在实例化一个新对象;而小写加下划线(snake_case)代表函数或变量。如果将函数命名为 CalculateTotalPrice,阅读者会误以为这是一个类,从而增加阅读负担并可能引发架构理解偏差。
| 标识符类型 | PEP 8 推荐命名风格 | 正确规范示例 | 新手常犯的反面示例 |
|---|---|---|---|
| 类名(Class) | 大驼峰法(PascalCase) | UserProfile, OrderManager |
user_profile, orderManager |
| 函数与方法 | 小写蛇形(snake_case) | get_user_info(), save_data() |
GetUserInfo(), getUserInfo() |
| 普通变量与属性 | 小写蛇形(snake_case) | total_amount, user_id |
TotalAmount, totalAmount |
| 全局常量 | 全大写蛇形(UPPER_SNAKE) | MAX_RETRY_COUNT, DEFAULT_TIMEOUT |
max_retry, MaxRetry |
| 模块与包(文件名) | 简短全小写蛇形 | file_reader.py, network_utils.py |
FileReader.py, fileReader.py |
| 私有属性/内部方法 | 单下划线开头(_snake_case) | _cache, _internal_parse() |
无下划线标识,直接公开发布 |
总结:新手防御性编码速查矩阵
要想在学习 Python 的过程中避开上述 5 个高频陷阱,关键在于培养“防御性编码习惯”。在编写代码和提交运行之前,可以通过下面的核心速查图进行对照检查。
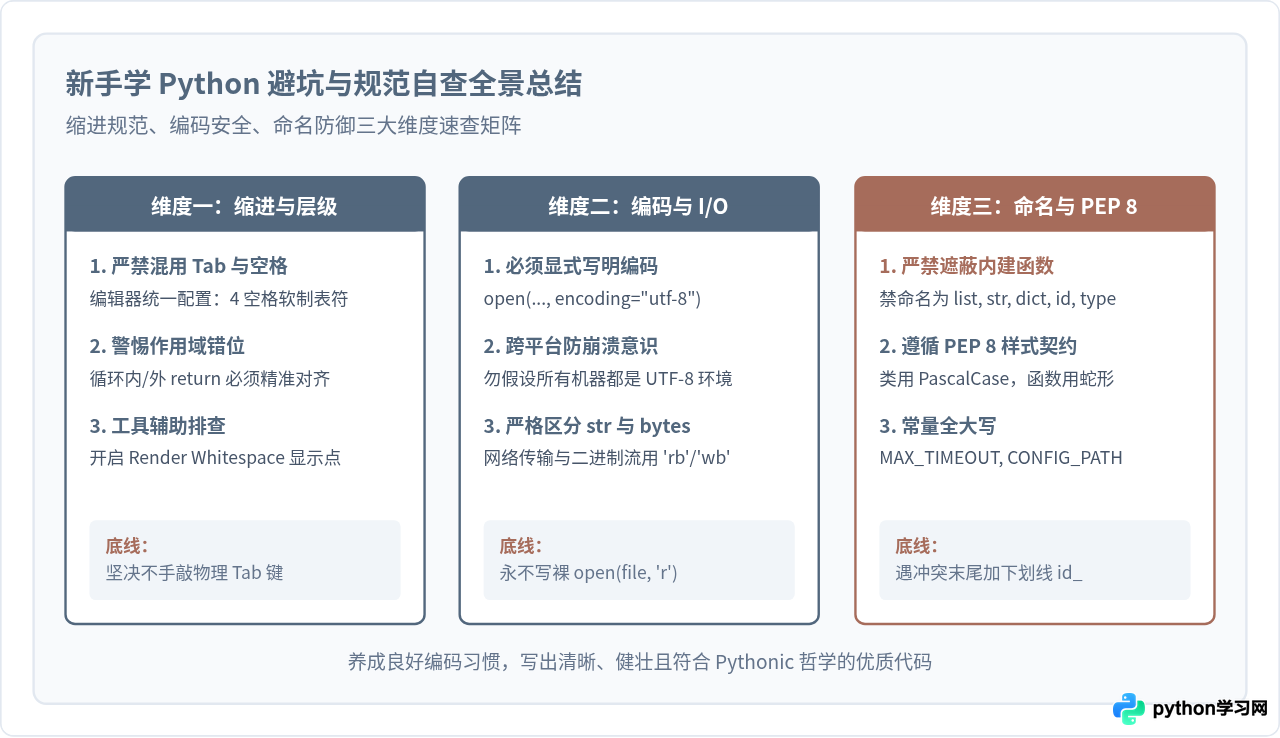
掌握 Python 语法并不困难,真正拉开开发者水平差距的,恰恰是对这些基础规则的敬畏与严谨态度。在起步阶段将编辑器配置好 4 空格软制表符,把 encoding="utf-8" 形成肌肉记忆,并在命名时自觉对照 PEP 8 规范,不仅能帮助你远离低级 Bug,更能为日后参与大型开源项目与团队协作打下坚实的基础。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















