


Python怎么实现不区分大小写的字符串比较
详细讲解在Python中实现不区分大小写字符串比较的标准方法与场景实践,深入解析casefold与lower的区别、Unicode标准化处理及性能优化策略。
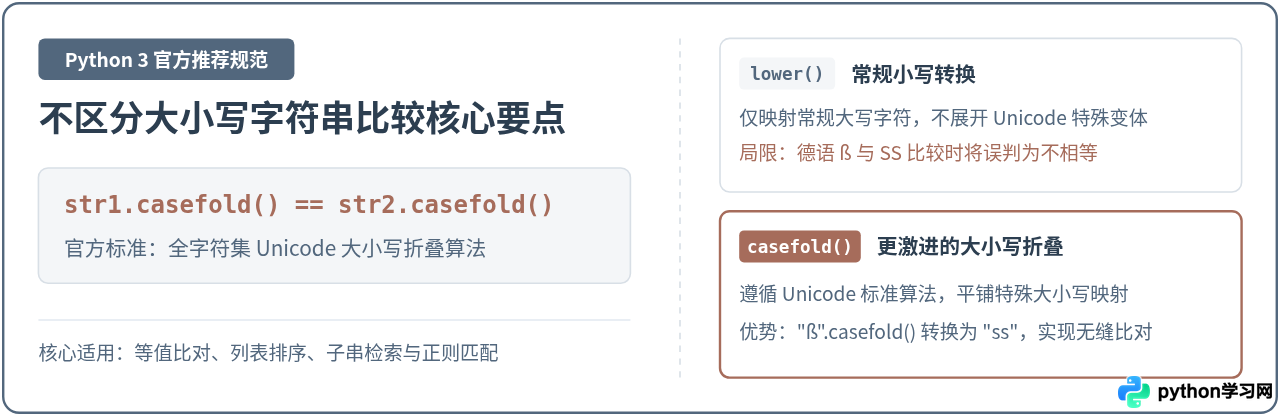
str.casefold() 方法:通过 str1.casefold() == str2.casefold() 即可直接判断两串字符是否相等。相较于传统的 str.lower(),casefold() 严格遵循 Unicode 规范中的大小写折叠算法,能够全面处理多语言环境下的特殊字符变换。
一、核心结论:为什么直接选择 casefold()
许多初学 Python 的开发者在面对大小写无关的判定需求时,第一反应往往是调用 .lower() 或 .upper() 将两端文本转换为统一形态后再使用 == 比较:
# 常见但存在局限性的写法
is_equal = str1.lower() == str2.lower()
如果应用场景严格限制在纯英文字符(ASCII 码范围:A-Z、a-z)内,这种做法并不会出现逻辑错误。然而,从 Python 3.3 开始,标准库就引入了专门为字符串等价匹配设计的 casefold() 方法。官方文档对其定义是:返回原字符串消除所有大小写区别后的副本,适用于不区分大小写的匹配。
# Python 官方推荐的标准写法
is_equal = str1.casefold() == str2.casefold()
这一方法在纯英文字符下的执行性能与 lower() 几乎没有差别,但在面对包含多语言字符、特定重音或区域符号的真实输入时,能有效避免因编码规则差异产生的误判。
二、深入原理:casefold() 与 lower() 的根本区别
要理解 casefold() 的必要性,必须厘清“转换为小写(Lowercasing)”与“大小写折叠(Case Folding)”在计算机字符处理中的概念分工。
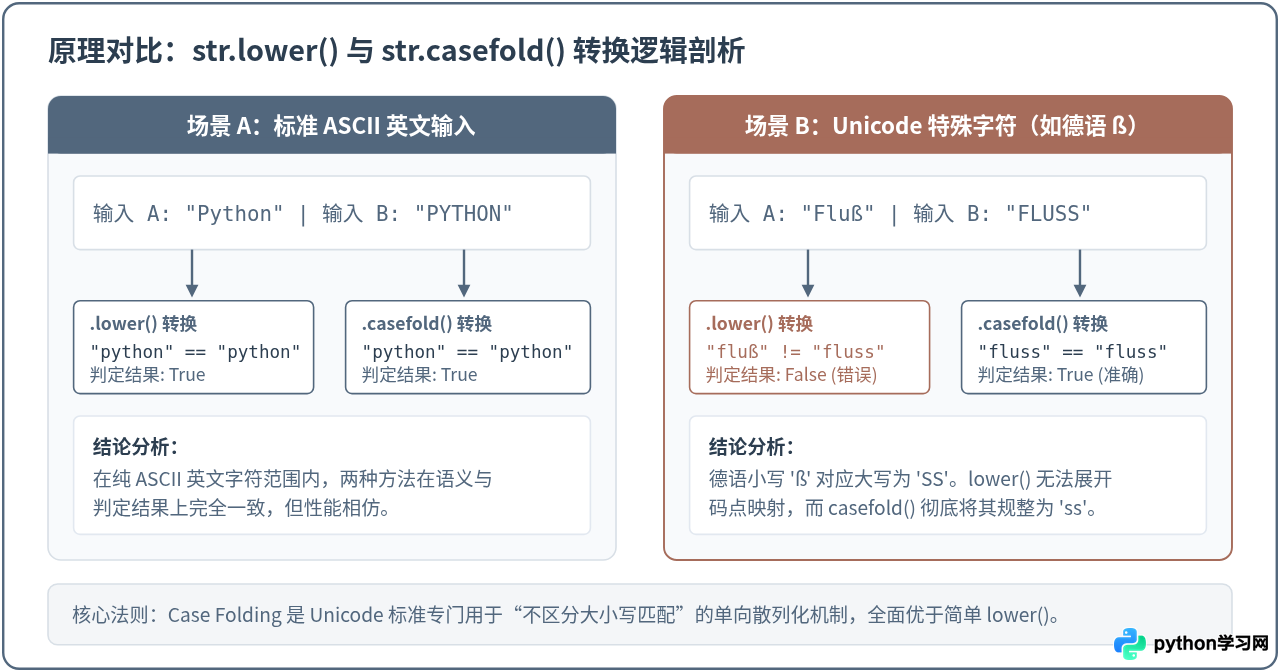
lower() 的职责是将字符映射为其对应的排版小写形态,它保留了特定语种的书写规范。而 casefold() 属于无损规范化映射,它的目的不是为了给人阅读,而是为了让不同书写变体在机器比对时归一到相同的码点流。
最典型的案例是德语字母“ß”(Eszett)。在德语书写中,“ß”本身就是小写字母,它的标准大写写法通常写作“SS”。当我们分别使用两种方法进行测试时:
s1 = "Straße"
s2 = "STRASSE"

# 使用 lower() 比对
print(s1.lower())             # 输出示例: straße
print(s2.lower())             # 输出示例: strasse
print(s1.lower() == s2.lower()) # 输出示例: False

# 使用 casefold() 比对
print(s1.casefold())             # 输出示例: strasse
print(s2.casefold())             # 输出示例: strasse
print(s1.casefold() == s2.casefold()) # 输出示例: True
在上述代码中,由于 "ß".lower() 依然是 "ß",导致德语单词的大写全拼与小写写法在 lower() 下比较失败;而 casefold() 依照 Unicode 折叠表,精准地将 "ß" 折叠为 "ss",使两端得到了符合人类语言习惯的一致结果。类似的现象还存在于希腊语的小写终字“ς”与普通小写“σ”等字符中。
三、标准操作步骤:如何安全编写不区分大小写的比较代码
在实际生产环境中编写健壮的比较逻辑时,不能只简单写下一行表达式,还需要兼顾参数的合法性与国际化字符的潜在隐患。以下是推荐的 4 个规范步骤:
- 步骤一(输入类型防御):确认待比对的对象均为
str类型。如果从外部接口、数据库或 JSON 载入的数据中可能混入None或数字,直接调用方法会触发AttributeError。 - 步骤二(Unicode 规范化处理,可选):如果数据来源涉及用户手写输入或跨平台重音符号(例如带音标的法语、西班牙语),字符可能以合成形式(如单个码点
é即é)或分解形式(基础字符e加上音标码点́)存在。调用unicodedata.normalize('NFKC', s)可消除这类结构差异。 - 步骤三(大小写折叠转换):对规范化后的两个字符串调用
.casefold()。 - 步骤四(执行操作与判定):进行相等性判定(
==)或后续操作。
综合以上步骤,一个通用的安全比对辅助函数示例如下:
import unicodedata

def case_insensitive_equal(s1, s2, normalize=False) -> bool:
    """
    安全地比对两个字符串是否在忽略大小写的前提下等价
    """
    if not isinstance(s1, str) or not isinstance(s2, str):
        return False

    if normalize:
        s1 = unicodedata.normalize('NFKC', s1)
        s2 = unicodedata.normalize('NFKC', s2)

    return s1.casefold() == s2.casefold()

# 示例验证
print(case_insensitive_equal("Admin", "admin"))          # 输出示例: True
print(case_insensitive_equal("straße", "STRASSE"))        # 输出示例: True
print(case_insensitive_equal(None, "admin"))              # 输出示例: False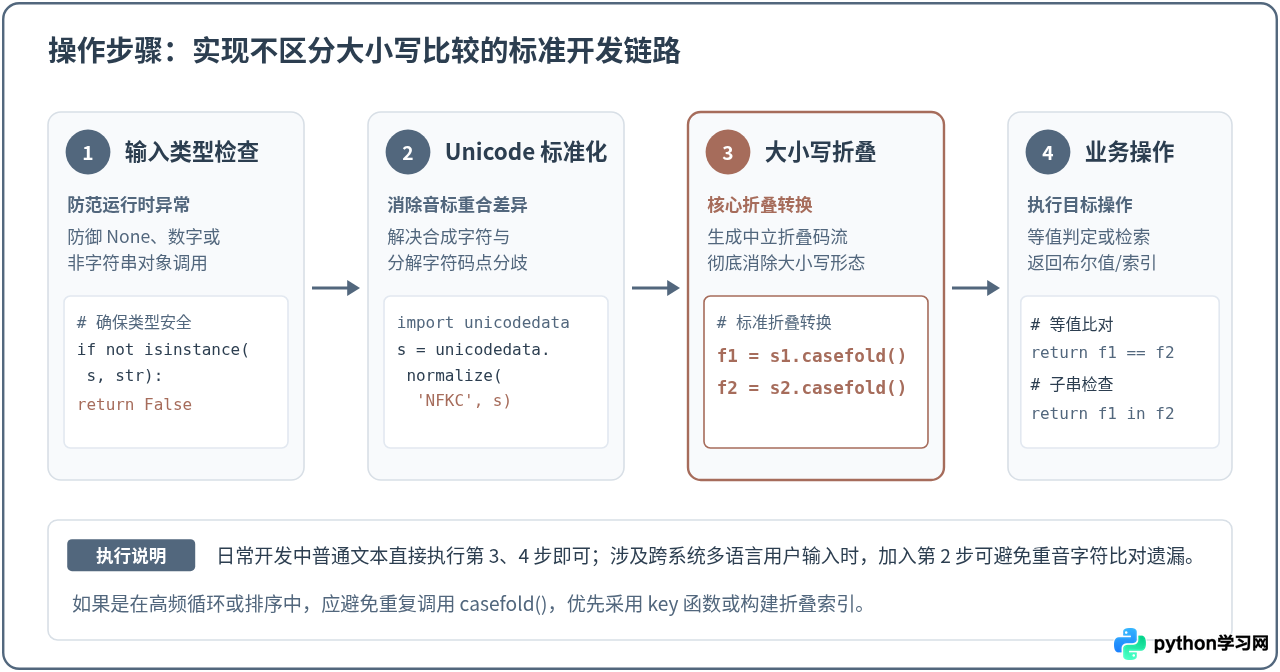
四、覆盖多种实际场景的实现方案
除了基础的两变量相等判断外,日常开发中还常有子串搜索、序列排序、正则模式匹配以及字典键查找等需求。每种场景下的最佳语法各有侧重。
1. 子串包含判断(Substring Search)
判断某个子字符串是否存在于目标文本中,且忽略大小写,只需将两端均执行 casefold() 后使用 in 运算符:
haystack = "Welcome to the Python Programming World!"
needle = "PYTHON"

if needle.casefold() in haystack.casefold():
    # 命中匹配逻辑
    pass
2. 序列与列表排序(Sorting)
在默认情况下,Python 的 sorted() 依据 ASCII / Unicode 码点数值排序,导致所有大写字母('A' 为 65)排在所有小写字母('a' 为 97)之前,例如 ["banana", "Apple", "cherry"] 排序后为 ["Apple", "banana", "cherry"]。
若要实现人类阅读习惯中的不区分大小写字母序,可以将 str.casefold 函数本身作为 key 传递:
words = ["banana", "Apple", "cherry", "avocado"]
sorted_words = sorted(words, key=str.casefold)

print(sorted_words)
# 输出示例: ['Apple', 'avocado', 'banana', 'cherry']
3. 正则表达式不区分大小写匹配(Regex Matching)
当比对规则涉及通配符、多选分支或需要提取特定位置的内容时,正则表达式是首选工具。Python 的 re 模块提供了 re.IGNORECASE 标志(简写为 re.I):
import re

pattern = r"hello\s+python"
text = "Hello   PYTHON, how are you?"

# 使用 re.IGNORECASE 标志
match = re.search(pattern, text, flags=re.IGNORECASE)
if match:
    print(match.group(0))  # 输出示例: Hello   PYTHON
在正则表达式模式内部,也可以在开头嵌入修饰符 (?i) 达到同样的效果,例如 re.search(r"(?i)hello\s+python", text)。
4. 字典键的高频查找与映射
如果需要在一个映射表(如 HTTP Header 或配置项)中频繁进行大小写不敏感的查找,切忌每次遍历所有键并调用 casefold(),这会将查找的时间复杂度从 O(1) 退化为 O(n)。
合理的做法是在存入字典时,将折叠后的键作为索引存储;或者使用现成成熟的封装结构:
# 预存折叠键模式
headers = {}

def set_header(k, v):
    headers[k.casefold()] = (k, v)  # 保存折叠键与原始键值对

def get_header(k, default=None):
    res = headers.get(k.casefold())
    return res[1] if res else default

set_header("Content-Type", "application/json")
print(get_header("content-type"))  # 输出示例: application/json
print(get_header("CONTENT-TYPE"))  # 输出示例: application/json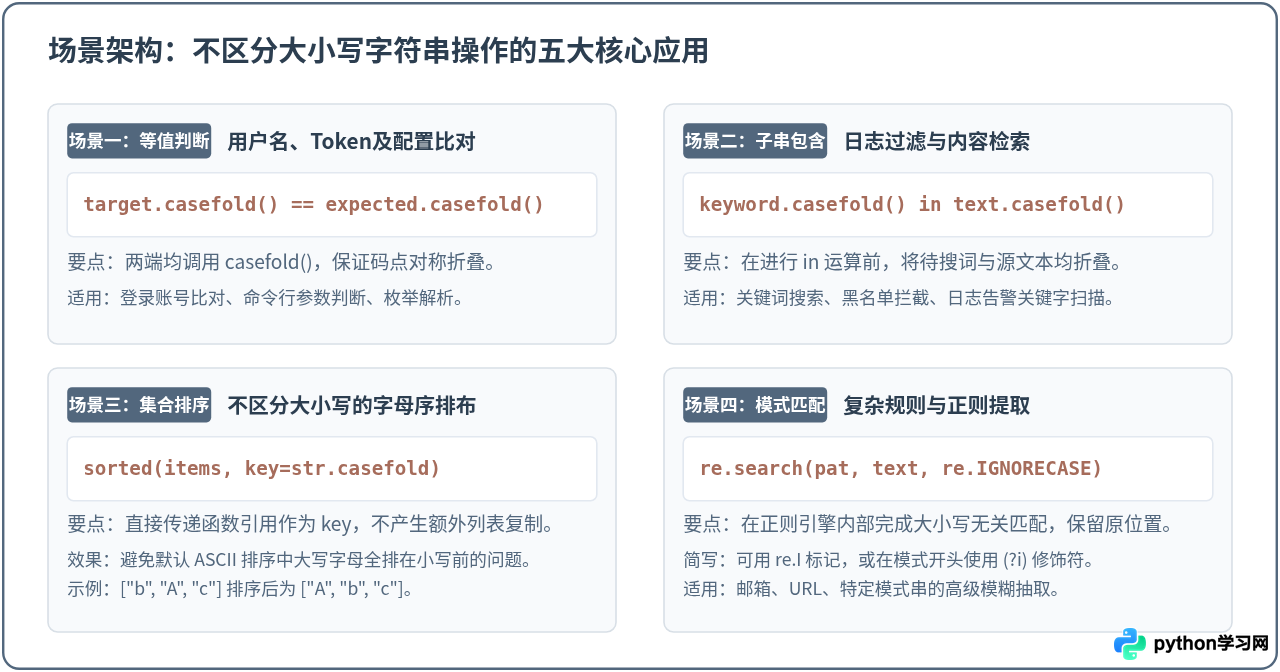
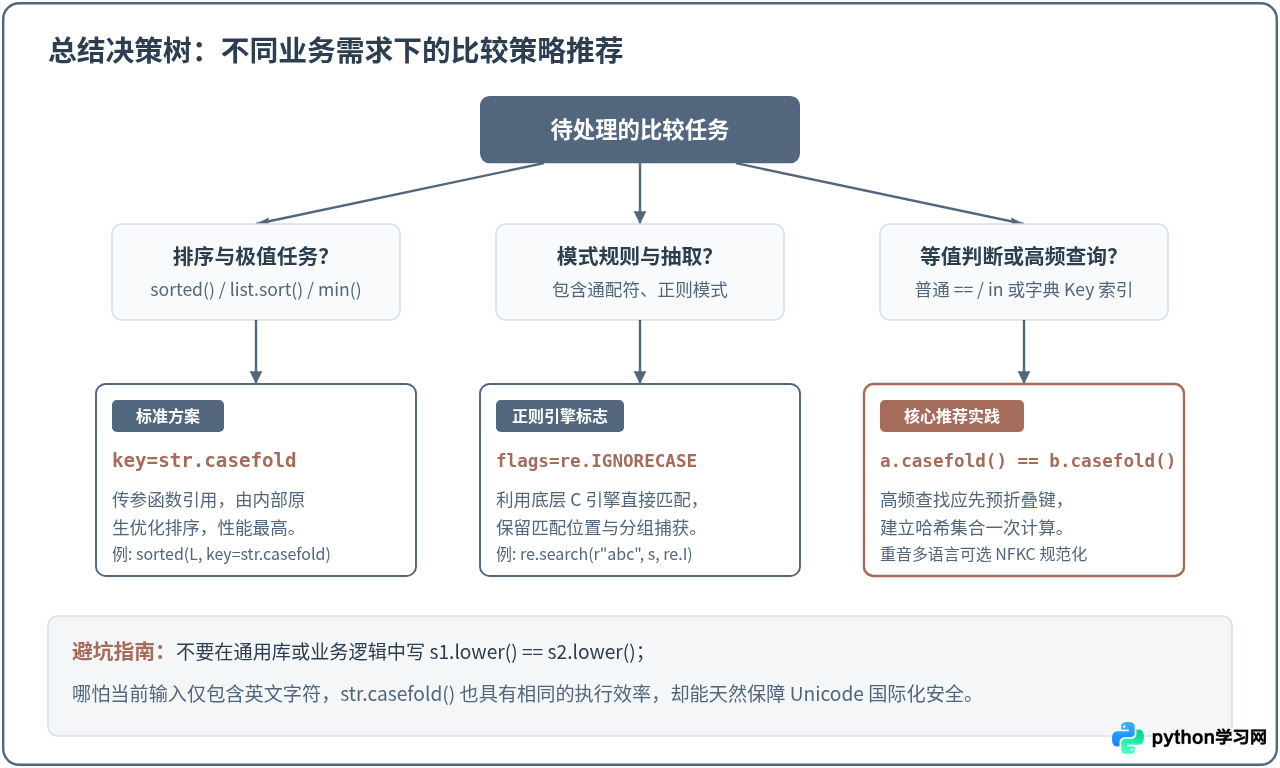
五、工程考量与性能决策
在工程实践中,任何操作都有其资源消耗。str.casefold() 在调用时会分配内存并返回一个全新的字符串对象。
| 方法 / 场景 | 适用字符集 | 内存开销 | 推荐使用场景 |
|---|---|---|---|
s1.casefold() == s2.casefold() |
全语言 Unicode | 新建 2 个临时字符串 | 常规单次比较、业务参数校验 |
sorted(seq, key=str.casefold) |
全语言 Unicode | 排序内部临时映射 | UI 列表展示、文本序列排序 |
re.search(pat, s, re.I) |
ASCII / Unicode 模式 | 正则引擎内部状态 | 复合模板匹配、文本抽取 |
| 预折叠哈希集合(Set / Dict) | 全语言 Unicode | 仅建表时一次性开销 | 关键词高频查询、白名单判定 |
casefold() 并存入 set,查询时只需对查询词做一次转换,即可保持单次 O(1) 的查询效率。
六、常见问题解答(FAQ)
Q1:为什么 Python 官方没有像 Java 那样提供 equalsIgnoreCase() 方法?
Python 的设计哲学强调“显式优于隐式(Explicit is better than implicit)”和正交性。Java 的 equalsIgnoreCase 本质上封装了字符比较并对局部编码进行判定;而 Python 将字符串形态转换(casefold())与操作符比较(==)解耦,使得同一套转换结果可以毫无摩擦地复用在 in、sorted()、字典键索引等所有容器与语法中,更具通用性。
Q2:在确定只有英文数字的环境下,改用 lower() 是否会有明显的性能优势?
在现代 CPython 解释器中,纯 ASCII 字符串的 casefold() 底层直接复用了高效的 ASCII 小写映射表,其运行耗时与 lower() 的差异通常在纳秒级别,对绝大多数业务系统完全可忽略不计。保持代码风格统一使用 casefold() 可以杜绝后续引入国际化数据时潜在的隐蔽缺陷。
Q3:使用 re.IGNORECASE 时,还需要先将文本 casefold() 吗?
不需要。当传入 re.IGNORECASE 标志后,正则编译引擎会在匹配状态转移时自动按照 Unicode 大小写规则进行判定。如果额外先执行一次 casefold(),不仅属于重复计算,还会丢失原文本的字符偏移量,影响提取结果的真实位置。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















