


学术论文PDF翻译选什么AI工具?专业术语准确性对比
针对科研人员阅读外文文献的痛点,本文不罗列参数,而是从跨页图表对照、长难句逻辑还原、专业术语一致性三个核心场景,深度评析主流AI翻译工具在处理学术PDF时的实际表现。文章指出,单纯追求翻译速度往往牺牲了学术严谨性,选择工具时应优先考虑其对排版结构的保留能力及对特定学科术语库的支持,而非盲目迷信大模型的通用能力。
深夜的实验室灯光下,屏幕左侧是几十页全英文的IEEE论文,右侧是打开的翻译软件窗口。你试图理解一段关于“卷积神经网络稀疏化”的描述,但机器翻译给出的“稀疏性卷积”让你眉头紧锁。更糟糕的是,当你翻到下一页,原本紧密关联的公式和解释被强行切断,翻译软件还在为上一页的断句纠结。这种割裂感,是每一位需要快速消化海外前沿成果的科研工作者最熟悉的煎熬。
我们常误以为AI翻译已经解决了语言障碍,但在学术领域,“读懂”和“译对”之间存在巨大的鸿沟。通用的翻译引擎擅长处理日常对话或新闻简报,却往往在面对高度凝练、逻辑严密且充满行话的学术文本时显得力不从心。选择翻译工具,本质上不是在选一个“字典”,而是在选一种“工作流”。
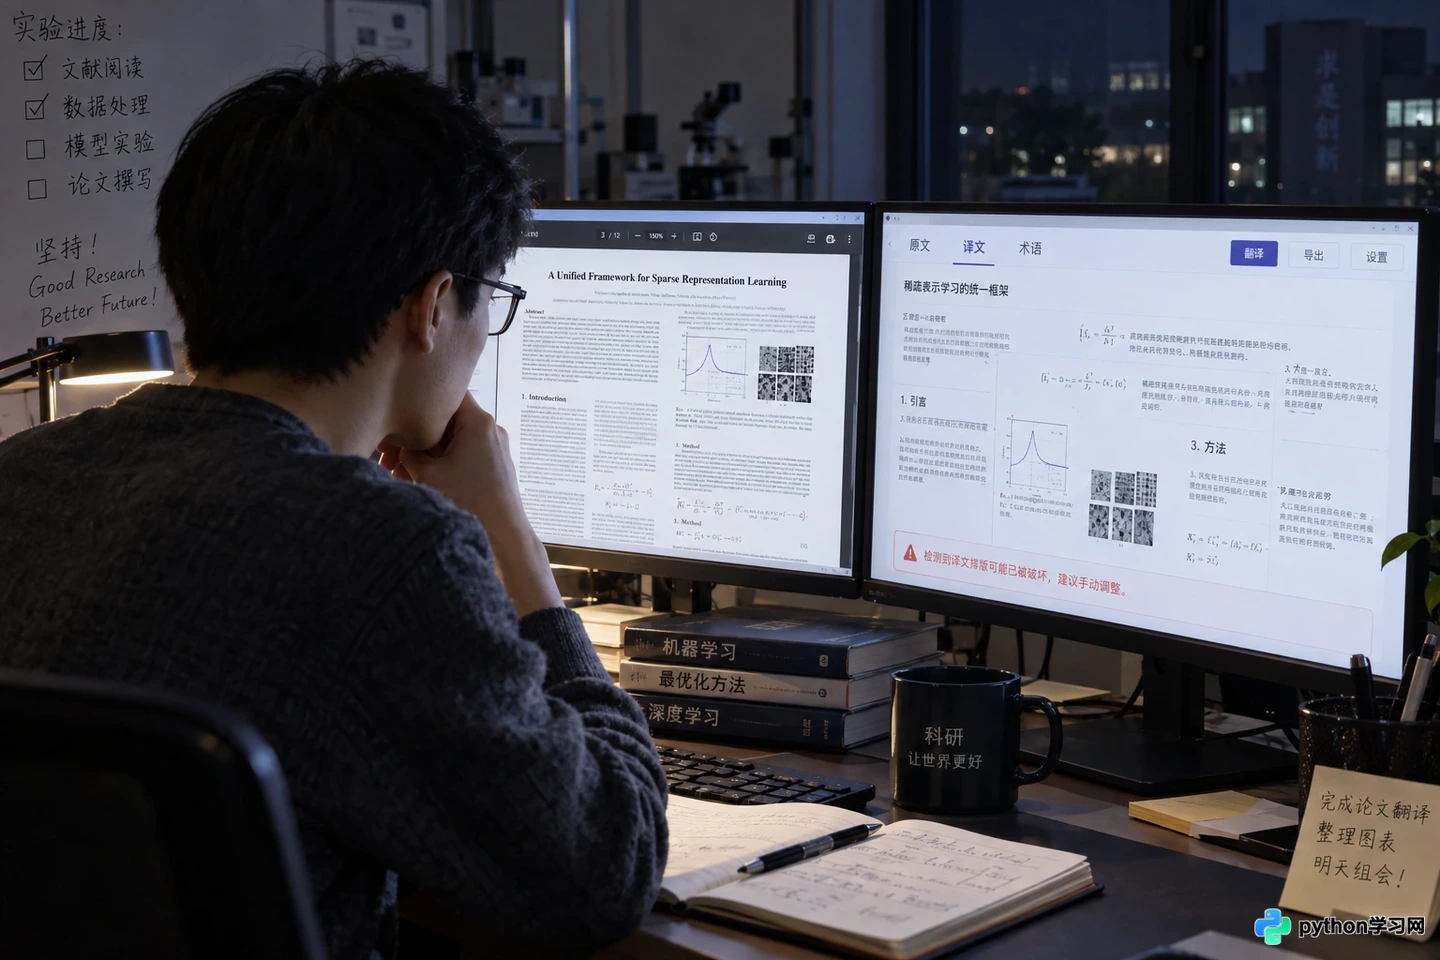
深夜实验室中,研究者在双屏环境下对比原文与译文,面临排版割裂的困扰。
排版即逻辑:跨页图表与公式的完整性考验
学术论文不仅仅是文字的堆砌,图表、公式和参考文献构成了其严密的论证骨架。许多主打“极速翻译”的在线工具,在处理PDF时采取的是“提取纯文本-翻译-重新生成文档”的策略。这种做法在遇到双栏排版、跨页表格或复杂数学公式时,往往会灾难性地破坏原文的逻辑结构。
在这种场景下,优秀的工具应当具备“视觉保持”能力。例如,当一篇计算机视觉论文中,Figure 3展示了模型架构,而正文第三段正在引用该图进行解释时,翻译后的文档必须确保图文对应关系不发生偏移。如果工具将双栏强制合并为单栏,或者将公式渲染为不可编辑的图片甚至乱码,研究者就需要花费大量时间去回溯原文,这完全违背了使用AI提效的初衷。
部分基于OCR(光学字符识别)技术的工具虽然能保留版面,但容易引入识别错误,比如将希腊字母 $\alpha$ 误识为英文字母 a,导致后续公式推导完全失效。因此,理想的学术翻译工具应支持原生PDF解析,或在OCR后提供便捷的校对界面,让用户能快速定位并修正那些因排版重组而产生的结构性错误,而不是在一大段混乱的文字中寻找丢失的脚注。
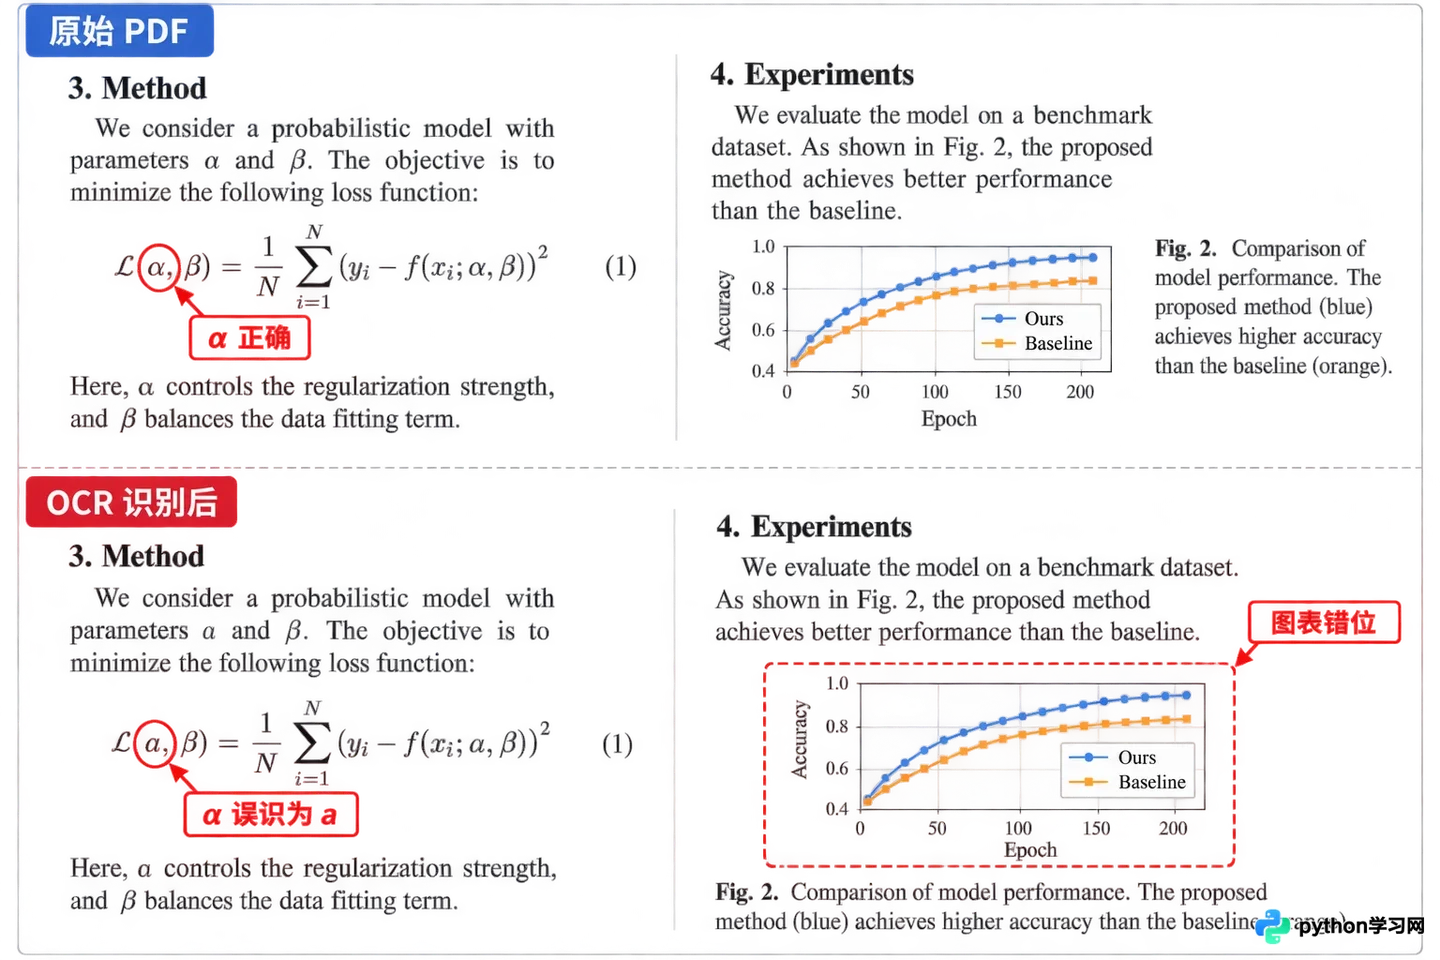
OCR识别错误或排版重组导致公式符号混淆,如α被误识为a,破坏逻辑结构。
语境决定词义:长难句与逻辑连接词的还原度
学术英语以长难句著称,一个句子往往包含多重从句、被动语态和倒装结构。通用AI模型在处理这类句子时,容易出现“主谓宾丢失”或“逻辑反转”的问题。例如,在生物医学文献中,“A inhibits B, which is mediated by C”这样的结构,如果被简单直译为“A抑制B,这是由C介导的”,虽然字面没错,但中文语序的别扭会让读者难以瞬间抓住因果链条。
更深层次的挑战在于指代消解。在长达十页的方法论章节中,作者可能多次使用“this approach”、“the latter”或“such mechanisms”。如果翻译工具缺乏长上下文记忆能力,它可能会将这些代词错误地指向最近出现的名词,而非逻辑上真正所指的对象。高质量的学术翻译工具,应当展现出对篇章级语境的理解能力,它不仅能翻译单句,还能根据前文内容,智能地将“it”还原为具体的实验方法或理论模型,从而保证中文译文的连贯性和可读性。
此外,对于否定之否定、虚拟语气等表达假设或限制条件的语法结构,工具的敏感度直接决定了研究的严谨性。将“may not be suitable”(可能不适用)误译为“不适合”(绝对不适用),可能会误导读者对算法适用边界的判断。因此,在测试工具时,不妨特意选取摘要中的结论部分和讨论部分的限制性陈述进行对比,观察其是否保留了原文的谨慎语气。
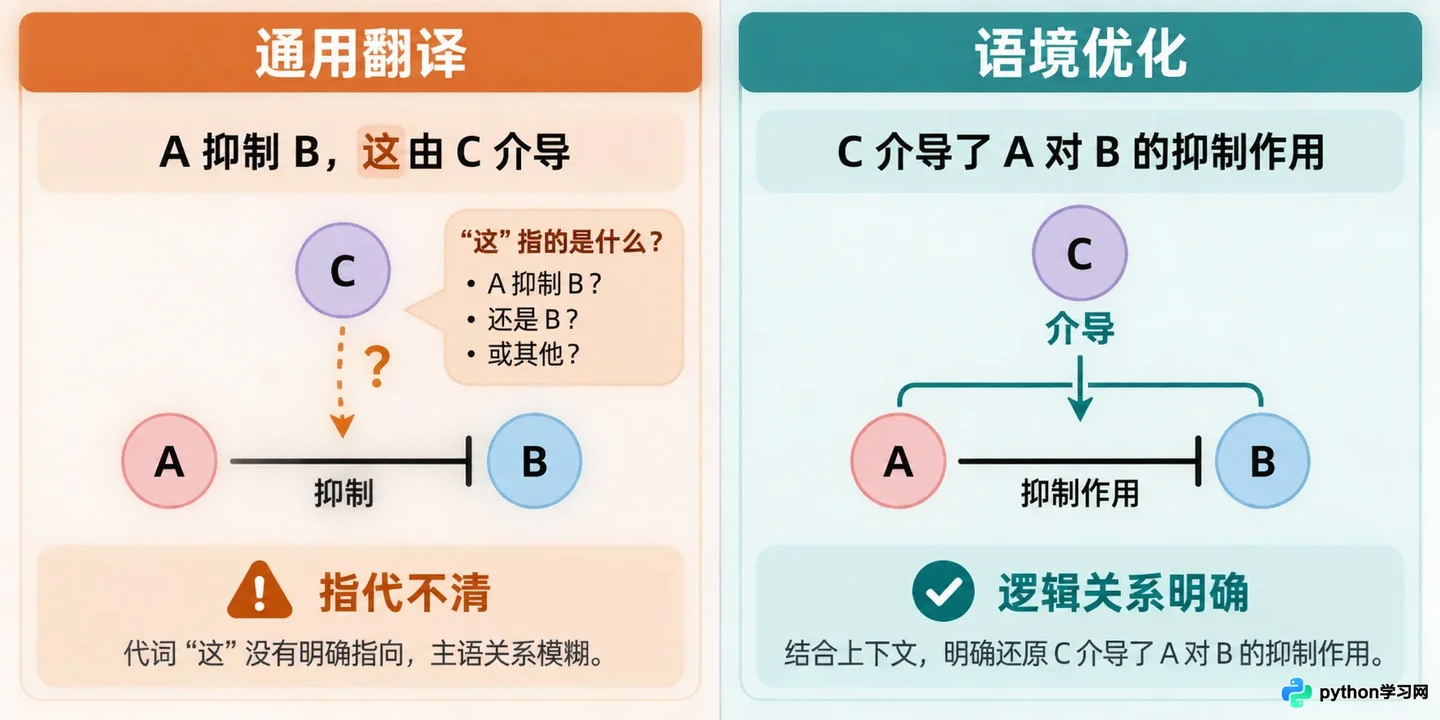
通用翻译容易丢失长难句中的逻辑主语,而专业工具能还原指代关系。
术语的一致性:垂直领域知识库的价值
如果说排版和语法是基础,那么专业术语的准确性则是学术翻译的灵魂。不同学科对同一词汇有着截然不同的定义。在物理学中,“momentum”是动量,而在金融工程中,它可能指动量因子;在计算机科学中,“attention”是注意力机制,而在心理学中则是注意。通用大模型往往倾向于选择最高频的日常释义,这在专业文献中是致命的。
真正适合科研场景的工具,必须具备挂载或内置垂直领域术语库的能力。 例如,针对材料科学的翻译,工具应能准确区分“stress”(应力)和“strain”(应变),而不是统一翻译成“压力”或“紧张”。一些先进的平台允许用户上传自定义的词表,或者自动识别文档所属的学科领域并切换相应的翻译引擎。这种“千人千面”的定制化能力,能显著减少后期人工校对的工作量。
更重要的是术语的全局一致性。在一篇三十页的论文中,同一个概念“feature extraction”不应在前半部分被译为“特征提取”,在后半部分变成“特性抽取”。这种不一致会严重干扰读者的认知负荷。优秀的工具会在后台维护一个临时的项目术语表,确保全文翻译风格的统一。对于从事交叉学科研究的用户来说,能够手动干预和锁定关键术语的译文,比全自动的流畅翻译更具实用价值。
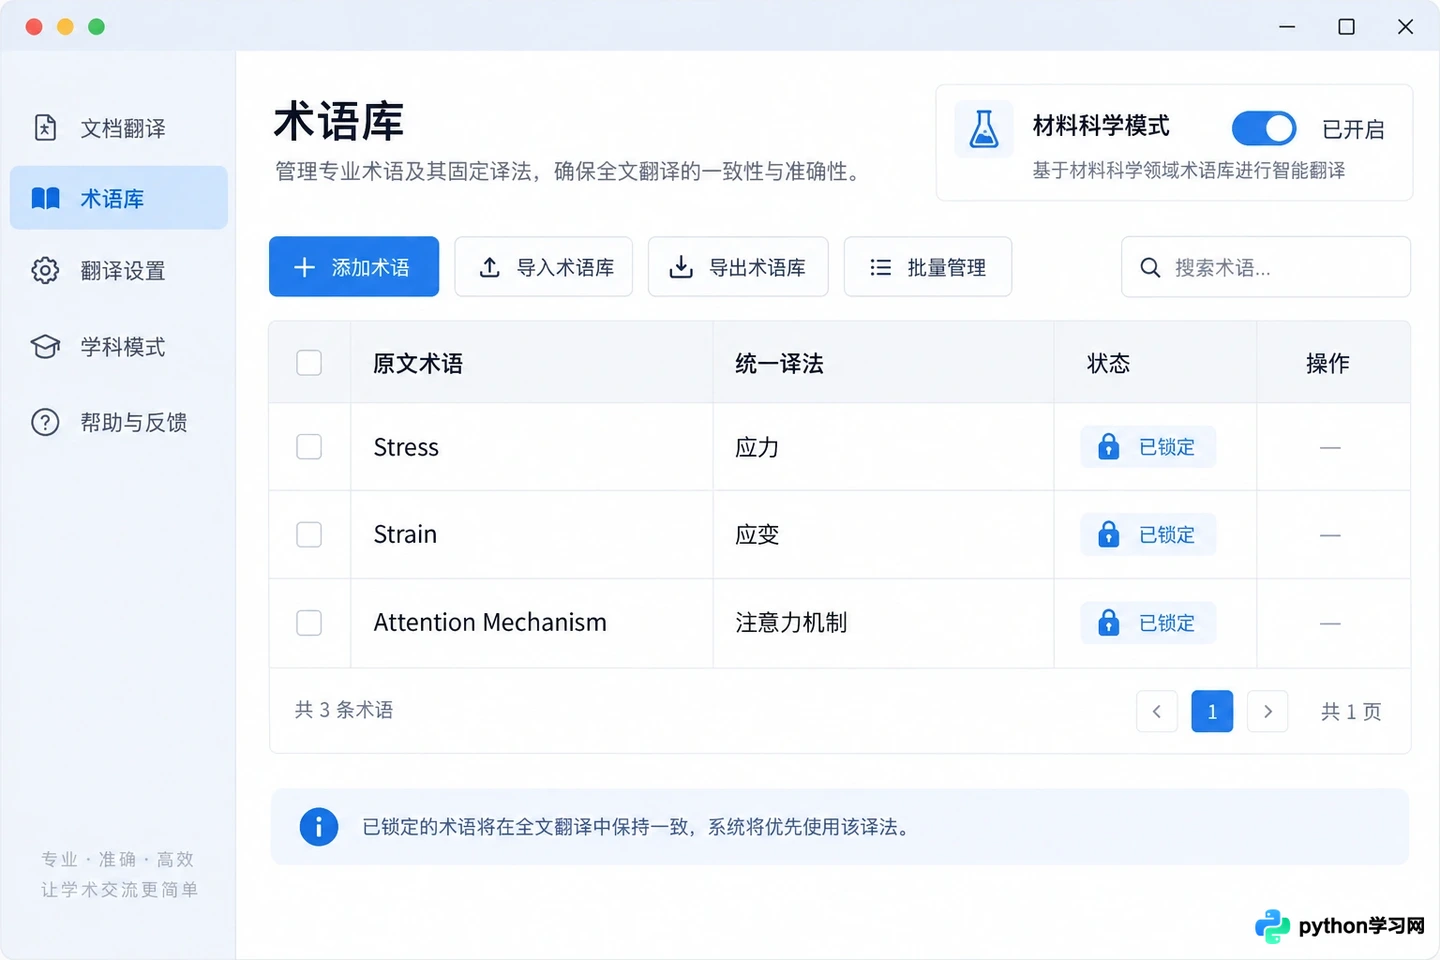
支持自定义术语库的工具能确保全文关键概念翻译的一致性。
交互与迭代:从“一次性输出”到“辅助研读”
最后,我们需要审视工具的工作流形态。传统的翻译软件往往是“上传-等待-下载”的黑盒模式,用户无法干预中间过程。而新一代的AI辅助研读工具,开始强调“交互式翻译”。它们允许用户在侧边栏选中某一段落,即时获取多种译法建议,甚至提供原文与译文的逐句对照高亮。
这种模式改变了我们与文献的互动方式。你不再是被动的接收者,而是可以主动质疑和修正的参与者。当遇到存疑的翻译时,工具若能提供引用的来源或类似的例句,将极大地增强用户的信任感。对于深度研读而言,翻译只是第一步,理解才是终点。 因此,那些集成了笔记功能、支持划词搜索背景知识、并能导出带有双语对照标注的PDF的工具,更能融入科研工作者的日常习惯。
当然,没有任何工具是完美的。目前的AI翻译在处理极度晦涩的古籍文献或最新发表的、尚未被训练数据覆盖的前沿概念时,仍会出现幻觉或生硬拼接。因此,工具的定位应是“高效的初稿生成器”和“智能辅助助手”,而非最终的权威裁决者。
回到开头的那个深夜场景,选择正确的工具,意味着你不再需要在破碎的排版和错误的术语中挣扎。你可以将精力集中在思考实验设计的巧妙之处,而非纠结于某个介词的翻译。对于科研人员来说,最好的AI翻译工具,是那个能让你忘记翻译本身,直接沉浸于知识流动的工具。它不一定是最快的,但一定是最懂你学科语言的伙伴。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















