


Python面向对象编程经典考题实例详解
深入解析Python面向对象编程中最核心、最高频的四大经典考题:命名空间与影子效应、实例化双阶段生命周期与单例陷阱、钻石继承MRO与super()机制,以及双重属性拦截。结合完整代码与底层架构图解,彻底理清Python对象模型。
class 与 def 语法,而在于解释器底层对命名空间、生命周期、继承拓扑与属性拦截的具体调度机制。本文精选技术面试与工程实践中出现频率最高的四大经典面向对象考题,通过最小可复现代码示例、执行结果对比以及底层架构图解,逐层还原 Python 对象模型的本质逻辑。
考题 01 类属性与实例属性:赋值重绑与原地修改的“影子效应”
在面试中,考官常常给出一段包含类属性、列表与整数操作的代码,要求考生预测各实例以及类本身的最终输出。这道经典题目旨在考查属性查找的层级次序,以及不可变类型重新赋值与可变类型就地操作的区别。
经典考题代码
class Widget:
    count = 0
    tags = []

    def __init__(self, name):
        self.name = name

# 创建两个独立实例
w1 = Widget("A")
w2 = Widget("B")

# 操作一:通过实例递增计数
w1.count += 1

# 操作二:通过实例追加标签
w1.tags.append("alpha")print(w2.count) # 输出: 0
print(Widget.count) # 输出: 0
print(w1.tags) # 输出: ['alpha']
print(w2.tags) # 输出: ['alpha']
print(Widget.tags) # 输出: ['alpha']
核心机制深度拆解
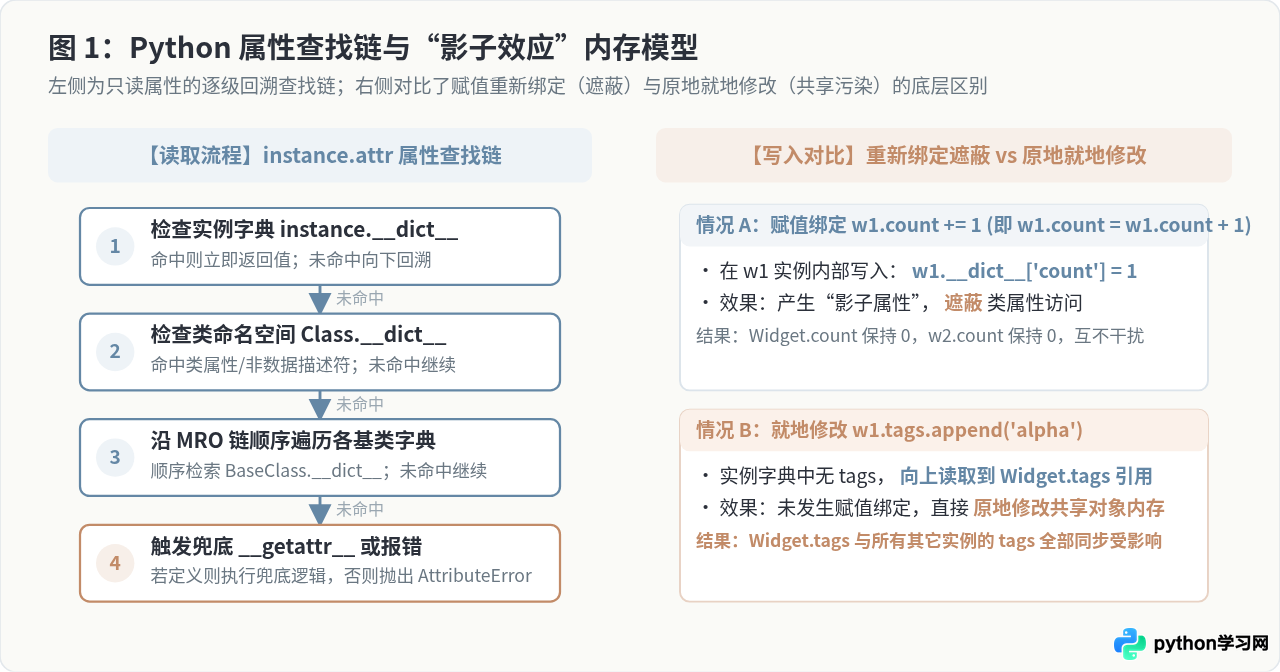
为什么 count 只有 w1 变成了 1,而 tags 的变化却同步扩散到了 w2 和类对象 Widget 上?其底层原因可分为两个关键机制:
- 属性读取的逐级回溯(Lookup Chain):当通过
w1.count读取属性时,解释器首先检索w1.__dict__。若键不存在,则回溯检索其类对象Widget.__dict__;若仍不存在,则沿着继承链(MRO)逐级向上查找。 - 赋值重新绑定的“影子属性(Shadowing)”:表达式
w1.count += 1在底层展开为w1.count = w1.count + 1。等号右侧在读取时命中类属性Widget.count(值为 0),计算结果为 1;但等号左侧的赋值操作直接作用于w1,即执行了w1.__dict__['count'] = 1。这在w1的本地命名空间中新建了一个同名键,像影子一样“遮蔽”了类属性,但类属性Widget.count和其他实例w2的查找链并未受到任何改变。 - 原地修改(In-Place Mutation)的引用共享:在执行
w1.tags.append("alpha")时,右侧属性访问w1.tags命中Widget.__dict__['tags']引用的列表对象。随后的.append()是方法调用,并未发生对w1.tags的重新赋值绑定,而是直接就地修改了该列表在堆内存中的内容。因为所有实例默认共享同一个类属性引用,所有读取该引用的对象都会看到这一变更。
__init__ 中显式声明为实例属性:self.tags = []。
考题 02 对象的两阶段构建:__new__ 与 __init__ 的本质差异与单例陷阱
很多开发者误以为 __init__ 是 Python 对象的“构造函数”。然而在底层机制中,Python 对象的构建是一个典型的双阶段过程:__new__ 负责分配内存创建骨架,而 __init__ 仅负责填充属性注入状态。
经典考题代码:简易单例模式中的“重复初始化”
class Singleton:
    _instance = None

    def __new__(cls, *args, **kwargs):
        if cls._instance is None:
            # 委派基类 object 分配堆内存并创建对象实例
            cls._instance = super().__new__(cls)
        return cls._instance

    def __init__(self, value):
        print(f"调用 __init__,写入 value = {value}")
        self.value = value

# 连续两次获取单例对象
s1 = Singleton(10)
s2 = Singleton(20)调用 __init__,写入 value = 20
print(s1 is s2) # 输出: True (两者确实是同一个内存实例)
print(s1.value) # 输出: 20 (意外:s1 的初始值 10 被第二次实例化覆盖了!)
核心机制深度拆解
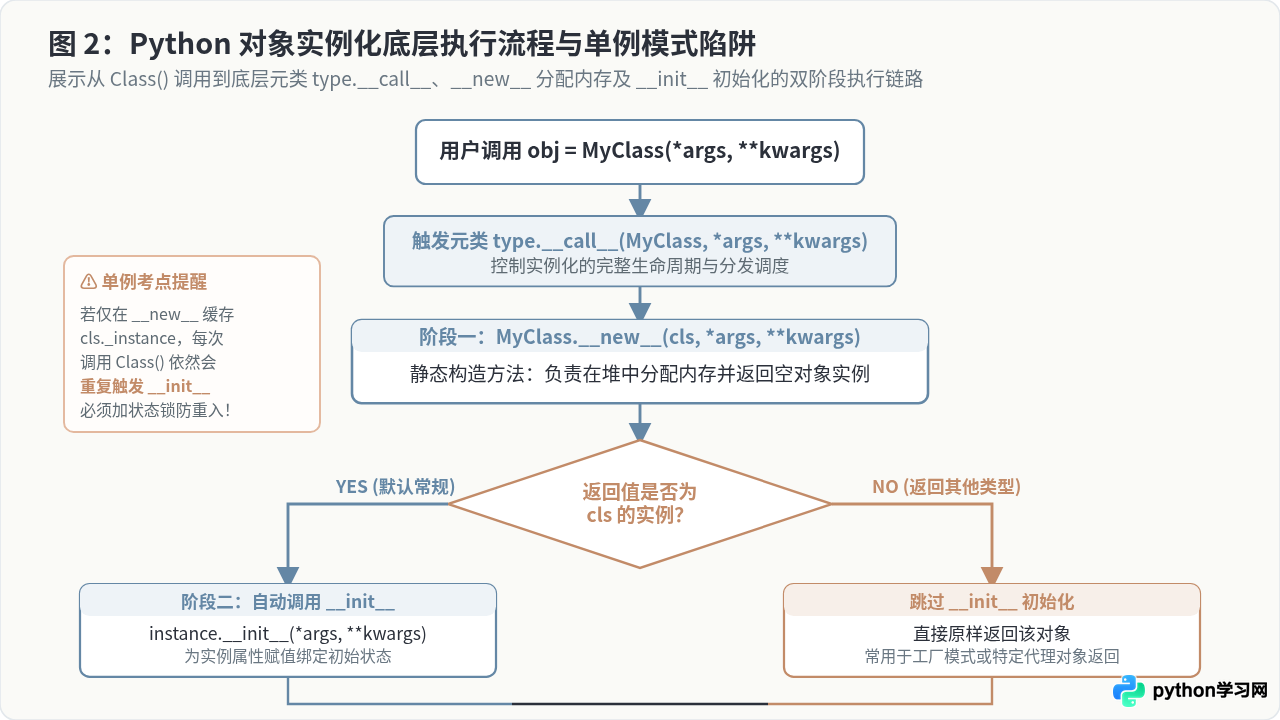
这道题的核心考点在于元类 type.__call__ 的调度逻辑:
- 当调用
Singleton(10)时,Python 解释器首先调用Singleton.__new__(cls, 10)。这是一个静态方法,其返回值必须是一个实例。 - 关键判定条件:解释器检查
__new__的返回值。只有当返回的对象是当前类(或其子类)的实例时,解释器才会接着调用该实例的__init__(*args, **kwargs)方法。 - 在上述单例实现中,第二次调用
Singleton(20)时,__new__直接返回了此前缓存的cls._instance。因为该对象恰好是Singleton的实例,解释器依然会恪尽职守地再次触发__init__(20),从而重写了self.value。
__init__ 中检查标记位:
def __init__(self, value):
    if not hasattr(self, '_is_initialized'):
        self.value = value
        self._is_initialized = True
此外,当需要继承 Python 内置不可变类型(如 tuple、float、str)时,由于不可变对象的内部值在创建完成后无法在 __init__ 中修改,必须通过重写 __new__ 在分配内存阶段预先绑定数值。
考题 03 钻石继承下的 MRO 线性化算法与 super() 协同调度
多重继承是面向对象中最容易产生歧义与 Bug 的领域。经典考题通常构造一个钻石(菱形)继承结构,让考生预测 super() 的真实调用次序。绝大多数初学者会误答为“调用直接父类”,而其真实逻辑完全受控于 C3 算法计算出的 MRO 列表。
经典考题代码
class A:
    def __init__(self):
        print("A 进入")
        print("A 退出")

class B(A):
    def __init__(self):
        print("B 进入")
        super().__init__()
        print("B 退出")

class C(A):
    def __init__(self):
        print("C 进入")
        super().__init__()
        print("C 退出")

class D(B, C):
    def __init__(self):
        print("D 进入")
        super().__init__()
        print("D 退出")

# 实例化叶子节点类 D
d = D()B 进入
C 进入 <-- 注意:B 中的 super() 并没有跳转到 A,而是跳转到了 C!
A 进入
A 退出
C 退出
B 退出
D 退出
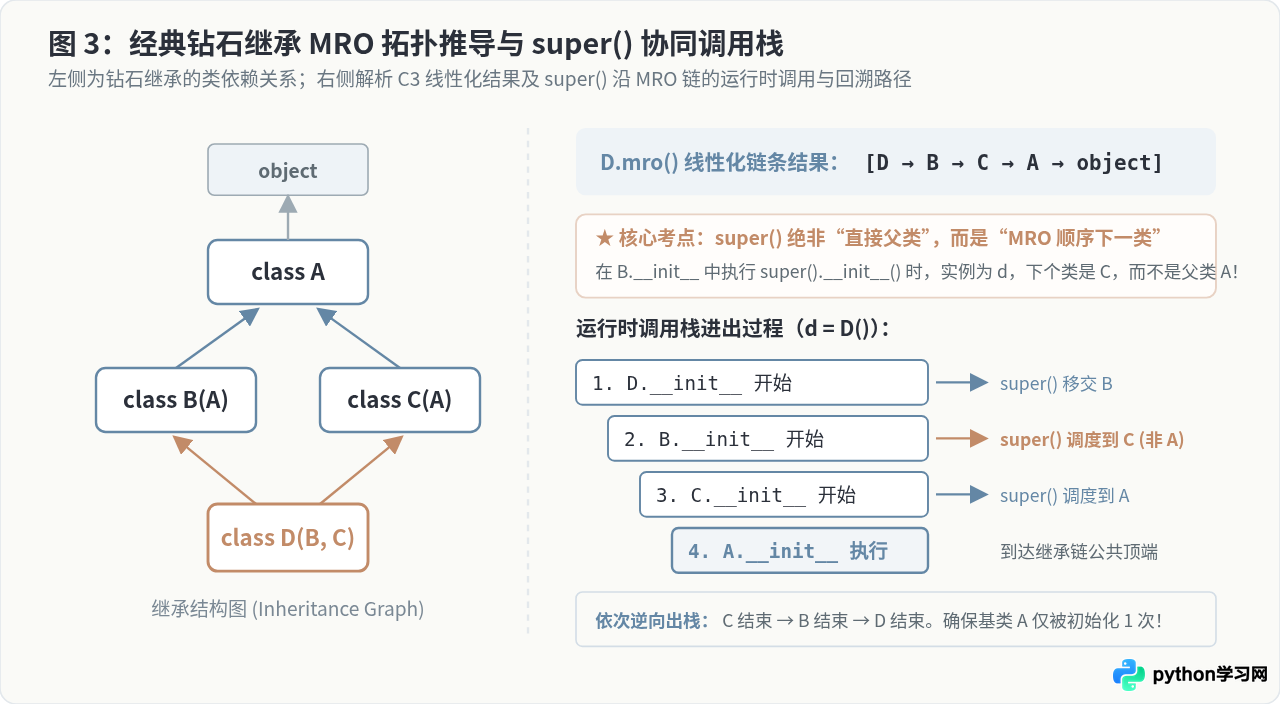
核心机制深度拆解
打破认知的关键在于:super() 从不寻找直接父类,而是寻找当前调用上下文对象的 MRO 链表中的“下一个元素”。
- C3 线性化算法(C3 Linearization):Python 使用 C3 算法保证继承链的局部优先权与单调性。对于类
D(B, C),其解析算法为:L[D] = [D] + merge(L[B], L[C], [B, C])
通过算法合并后,计算出的唯一线性顺序为:[D, B, C, A, object]。可以通过D.mro()随时查看该列表。 - 动态绑定的运行期追踪:当实例化
d = D()时,传入所有方法的self都是d,因此全链路的 MRO 顺序牢牢锁定为[D, B, C, A, object]。- 在
D.__init__中,super()沿着链条找到下一个类B; - 在
B.__init__中,super()寻找在B后面的下一个类,即C,而不是B的直接父类A; - 在
C.__init__中,super()继续向下推进到A; - 公共基类
A执行完成后开始依次逆向返回出栈。
- 在
- 避免重复初始化的工业价值:如果采用传统硬编码的
A.__init__(self)显式调用,在菱形结构下A将被重复初始化两次。而super()机制协同工作,确保整个拓扑链条中的每个类恰好被访问一次。
考题 04 属性拦截协议:__getattr__ 与 __getattribute__ 的边界与递归死循环
动态属性拦截是实现 RPC 远程调用代理、ORM 对象关系映射以及数据权限控制的基石。在面试中,考官常常要求解释两者的触发时机,并要求排查 RecursionError: maximum recursion depth exceeded(递归栈溢出)的常见陷阱。
经典考题代码:安全代理对象的拦截实现
class DynamicProxy:
    def __init__(self, target):
        # 错误写法:self.target = target 会在 __setattr__ 中引发死锁
        super().__setattr__('_target', target)

    def __getattribute__(self, name):
        # 无条件拦截:任何属性读取都必经此地
        print(f"[拦截] 正在尝试访问属性: {name}")
        # 严正警告:此处若书写 return self._target 会再度触发 __getattribute__ 引发死循环
        # 正确做法:通过父类 object 代理获取底层属性
        return super().__getattribute__(name)

    def __getattr__(self, name):
        # 兜底机制:仅在上述常规查找完全失败后才被激活
        print(f"[兜底] 原生属性未找到,转发至底层目标: {name}")
        target = self._target
        if hasattr(target, name):
            return getattr(target, name)
raise AttributeError(f"目标对象无此属性: {name}")print(proxy._target) # 命中 __getattribute__,正常返回 [1, 2, 3]
proxy.append(4) # 先走 __getattribute__ 查找 append 失败,触发 __getattr__ 成功转发
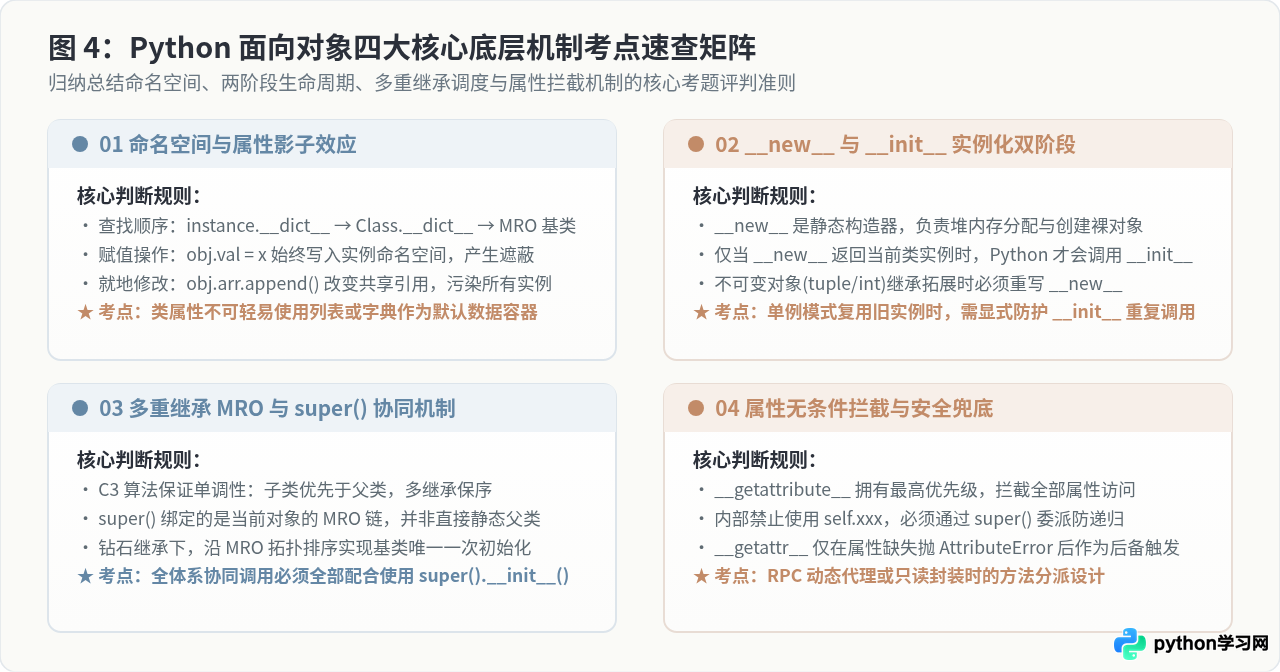
核心机制深度拆解
理解两者的差异,关键在于掌握属性解析的分级防火墙模型:
| 对比维度 | __getattribute__ | __getattr__ |
|---|---|---|
| 触发时机 | 无条件优先触发(任何属性、方法访问的第一入口) | 兜底后备触发(仅在正常查找失败抛出 AttributeError 后) |
| 递归风险 | 极高:方法内若使用 self.attr 会自调用导致栈溢出 |
极低:仅在确定缺失时介入,通常不会引发隐式自调用 |
| 安全访问手段 | 必须使用 super().__getattribute__(name) |
可安全使用常规属性访问或代理转发 |
| 适用典型场景 | 全局访问日志审计、权限校验拦截、安全沙箱包装 | 动态 RPC 方法合成、懒加载(Lazy Loading)、接口适配 |
总结 面向对象经典考题的解题思维模型
透彻掌握 Python 面向对象高级特性的关键,在于抛弃对语法的表面记忆,建立基于内存和运行期调度的数据流模型:
- 看命名空间:遇到属性值诡异变化,立即在草稿纸上分别画出
instance.__dict__和Class.__dict__,区分清“赋值重绑(遮蔽)”与“容器就地修改”。 - 看生命周期:遇到对象构造与单例问题,拆解为
__new__内存分配和__init__属性填充两个独立阶段,注意防御非首次调用的重入初始化。 - 看 MRO 链条:遇到多继承与
super(),不要看语法上的直接父类,先用 C3 规则写出Class.mro(),顺着拓扑序列一步步推进执行栈。 - 看拦截入口:遇到动态代理与魔法方法,始终以
__getattribute__为总关卡,内部访问私有字段坚决调用super(),依靠__getattr__优雅兜底。
掌握了这一套底层心智模型,无论是应对高难度技术面试中的连环追问,还是在大型开源框架中阅读复杂的元编程代码,都能清晰洞察每一行调用的真实流向。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















