


Python集合应用实例:用数学集合思维解决数据去重与匹配
深入讲解如何运用数学集合思维在Python中高效解决海量数据去重与跨源数据匹配问题,剖析底层哈希机制、常用集合运算符及典型实战场景。
在日常数据清洗与业务逻辑处理中,重复记录过滤和跨表数据对账是两类高频出现的需求。许多初学者习惯编写多重嵌套循环或使用列表进行条件判断,当数据规模从几百条上升到几十万条时,程序执行时间会从秒级剧增至小时级。解决这一性能瓶颈的关键,在于跳出面向过程的列表遍历方式,转而运用数学集合思维。Python 内置的 set 数据类型不仅具备互异性与无序性的数学特征,还在底层通过哈希表提供了接近 \(O(1)\) 时间复杂度的寻址能力。本文将通过具体应用实例,系统解析如何将数学集合概念转化为高效的数据去重与多源匹配代码方案。
一、数学集合特征与底层哈希寻址机制
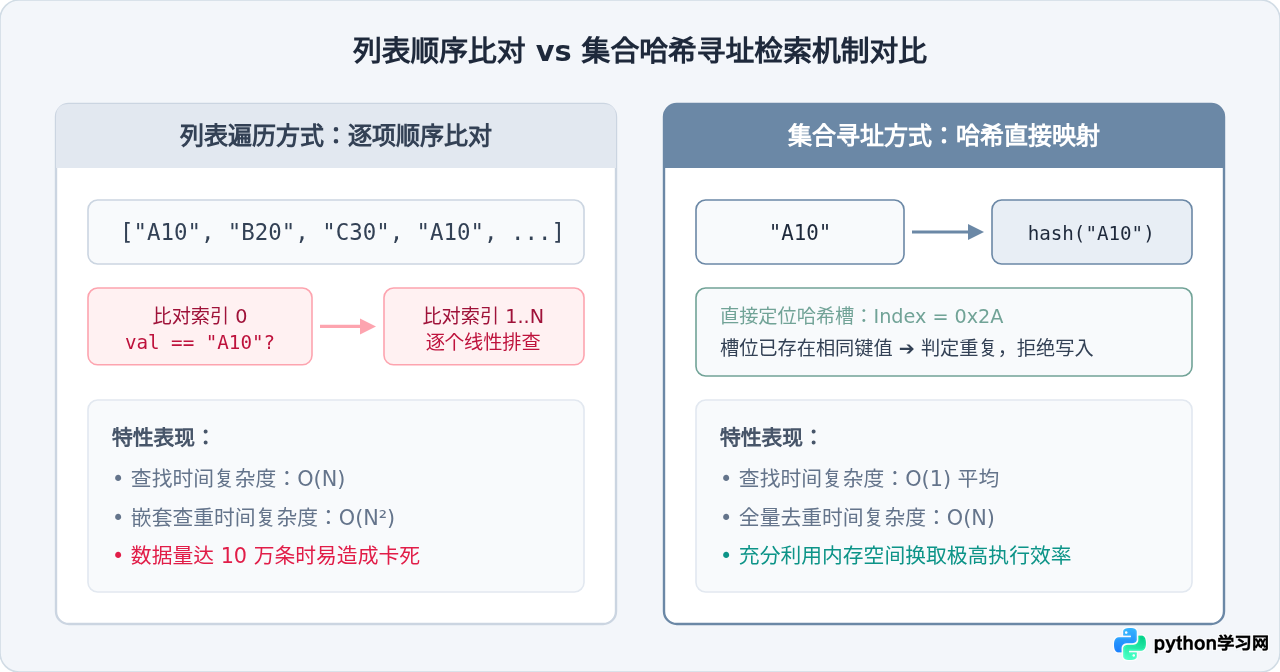
数学中的集合具有三个核心特征:确定性、无序性与互异性。其中互异性规定集合中的元素不能重复,无序性则表明元素排列不分先后。Python 的 set 完整继承了这些数学定义。理解集合高效性的前提,是认识到它与列表(List)在内存组织方式上的根本差别。
当我们在包含 \(N\) 个元素的列表中查找某个值是否存在时,解释器必须从第一个元素逐一向后比对,最坏情况下需要比对 \(N\) 次,时间复杂度为 \(O(N)\)。如果对包含 \(N\) 个元素的列表执行去重,通过双重遍历比对,整体时间复杂度将达到 \(O(N^2)\)。而 Python 集合底层基于哈希表(Hash Table)实现,解释器首先对目标元素计算哈希值(Hash Code),再将其映射到特定内存桶槽位中。判定元素是否存在只需单次哈希运算与槽位探测,平均耗时仅为 \(O(1)\)。
二、数据去重实操:从基础无序去重到保序提取
去重是集合最直接的应用。在实际生产场景中,需求通常细分为两种:只关心提取唯一元素的“极速去重”,以及必须保留数据原始到达次序的“保序去重”。
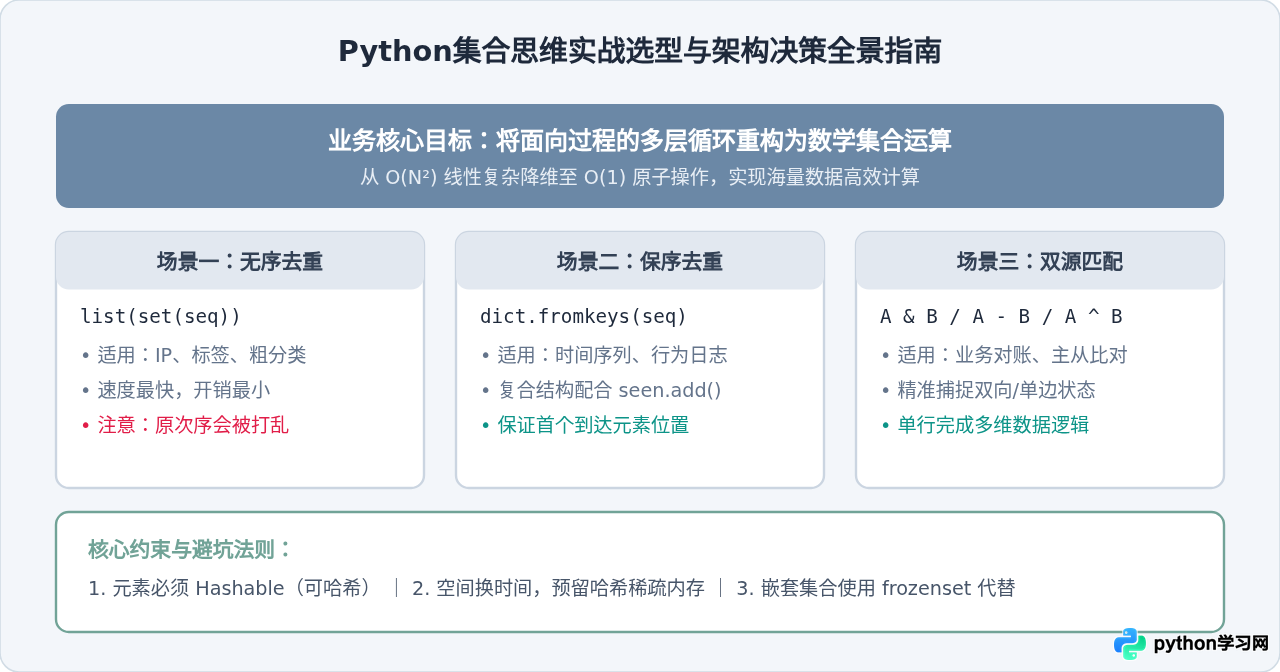
1. 极速无序去重:list(set(sequence))
如果业务逻辑对元素顺序完全没有要求(例如统计访客独立 IP、汇总品类标签),最简洁的做法就是直接将序列转为集合再转回列表:
# 示例:基础无序去重
raw_user_ids = ["U102", "U891", "U102", "U334", "U891", "U506"]
unique_user_ids = list(set(raw_user_ids))

print("无序去重结果示例:", unique_user_ids)
# 示例输出可能为: ['U102', 'U334', 'U506', 'U891'](顺序被哈希表重排)
这种方法速度极快,时间复杂度仅为 \(O(N)\)。但其副作用在于哈希表的散列分布会打乱元素原有的排列顺序。
2. 保序去重:结合字典或集合辅助跟踪
如果处理的是时间序列日志、流水明细或需要保留用户首次访问顺序的数据流,直接使用 set() 会导致次序混乱。解决这一问题有两种推荐做法:
方案 A:利用 Python 3.7+ 字典的键保序特性
从 Python 3.7 开始,标准字典严格维持插入顺序。利用 dict.fromkeys() 可以兼顾集合的哈希去重性能与列表的保序需求:
# 示例:利用字典键保序去重
ordered_unique = list(dict.fromkeys(raw_user_ids))
print("保序去重结果示例:", ordered_unique)
# 示例输出: ['U102', 'U891', 'U334', 'U506']
方案 B:集合辅助标记法(灵活支持复合数据结构)
当待处理数据是字典列表(如数据库查询结果),且需要按特定字段去重时,可通过维护一个辅助集合 seen 来实现过滤:
# 示例:针对复合数据结构按关键字段去重
orders = [
    {"order_id": "ORD_01", "amount": 120.5, "user": "Tom"},
    {"order_id": "ORD_02", "amount": 340.0, "user": "Jerry"},
    {"order_id": "ORD_01", "amount": 120.5, "user": "Tom"},  # 重复订单
    {"order_id": "ORD_03", "amount": 89.0, "user": "Spike"}
]

seen_order_ids = set()
deduplicated_orders = []

for item in orders:
    oid = item["order_id"]
    if oid not in seen_order_ids:
        seen_order_ids.add(oid)
        deduplicated_orders.append(item)

print("复合结构去重结果示例:")
for od in deduplicated_orders:
    print(od)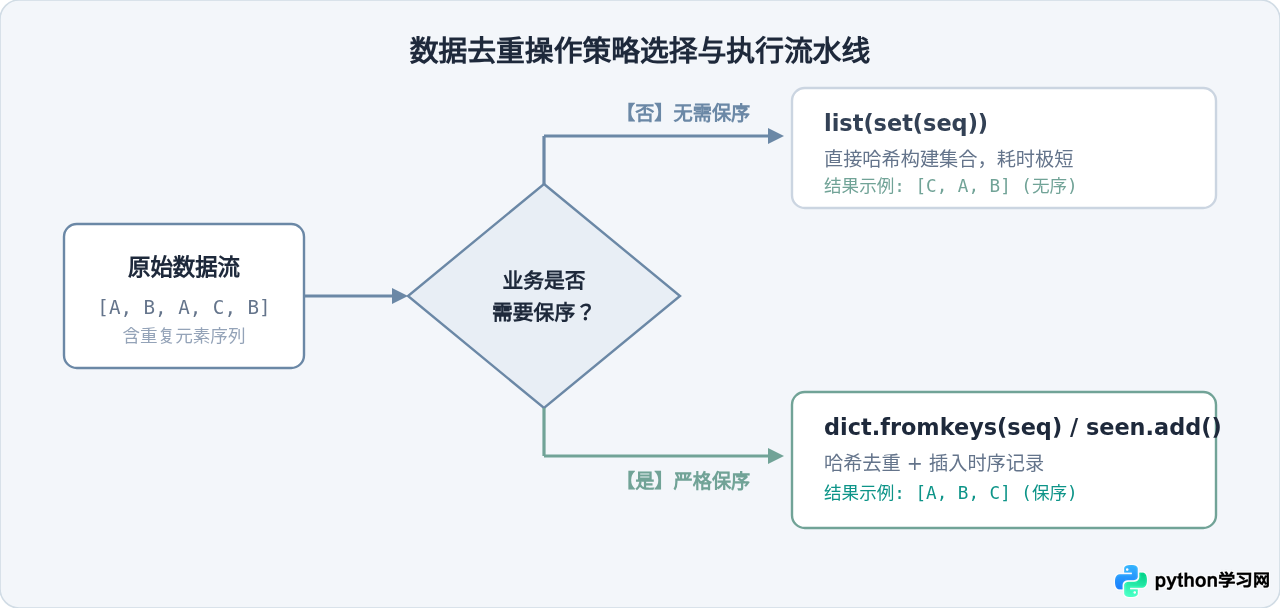
三、跨源数据匹配:四大集合运算的实战应用
在财务对账、用户行为分析与系统数据迁移等业务场景中,我们经常需要对比两组来源不同的数据集。传统的做法是编写多层 if ... in ... 判断,代码冗长且极易遗漏边界条件。若将两组数据视为数学集合,利用交集、并集、差集和对称差集,只需一行代码即可清晰表达匹配逻辑。
1. 交集运算(Intersection):匹配双向一致
数学表达为 \(A \cap B\),Python 中可用运算符 & 或方法 intersection()。它提取同时存在于两个集合中的共有元素。
业务场景:识别同时在 App 和小程序端下单的高价值活跃用户;或者核对本地支付订单中已被银行流水确认的记录。
app_users = {"U101", "U102", "U103", "U105"}
web_users = {"U102", "U105", "U106", "U107"}

# 双端共有活跃用户
common_active_users = app_users & web_users
print("双端活跃用户匹配结果:", common_active_users)
# 示例输出: {'U102', 'U105'}
2. 差集运算(Difference):排查单边缺失
数学表达为 \(A - B\),Python 中使用减号 - 或方法 difference()。它提取只存在于集合 \(A\)、但在集合 \(B\) 中缺失的元素。
业务场景:对账时发现“本地系统显示已扣款,但第三方支付机构未收到账”的异常单边订单(local_orders - bank_orders);或者排查“已注册但尚未完成首购的用户”。
registered_users = {"U101", "U102", "U103", "U104", "U105"}
purchased_users = {"U102", "U105"}

# 已注册但未产生购买的用户
pending_users = registered_users - purchased_users
print("未购买用户清单:", pending_users)
# 示例输出: {'U101', 'U103', 'U104'}
3. 对称差集运算(Symmetric Difference):快速定位双向差异
数学表达为 \((A \cup B) - (A \cap B)\),Python 中使用脱字符 ^ 或方法 symmetric_difference()。它提取仅在某一端存在、但未在双端同时出现的全部差异记录。
业务场景:两台数据库主从同步校验,快速获取两表之间所有不一致的主键集合。如果返回空集 set(),则表明两端完全同步一致。
db_primary_keys = {"ID_1", "ID_2", "ID_3", "ID_5"}
db_replica_keys = {"ID_1", "ID_2", "ID_4", "ID_5"}

discrepancy = db_primary_keys ^ db_replica_keys
print("主从数据不一致记录:", discrepancy)
# 示例输出: {'ID_3', 'ID_4'}(ID_3 仅在主库,ID_4 仅在从库)
4. 并集运算(Union):全量汇聚去重
数学表达为 \(A \cup B\),Python 中使用竖线 | 或方法 union()。它合并所有集合出现的元素并自动剔除重复项。
业务场景:合并多个渠道导出的客户名单以构建全量用户池。
channel_a = {"13800000001", "13800000002"}
channel_b = {"13800000002", "13800000003"}

all_leads = channel_a | channel_b
print("全渠道唯一线索总数:", len(all_leads))  # 输出 3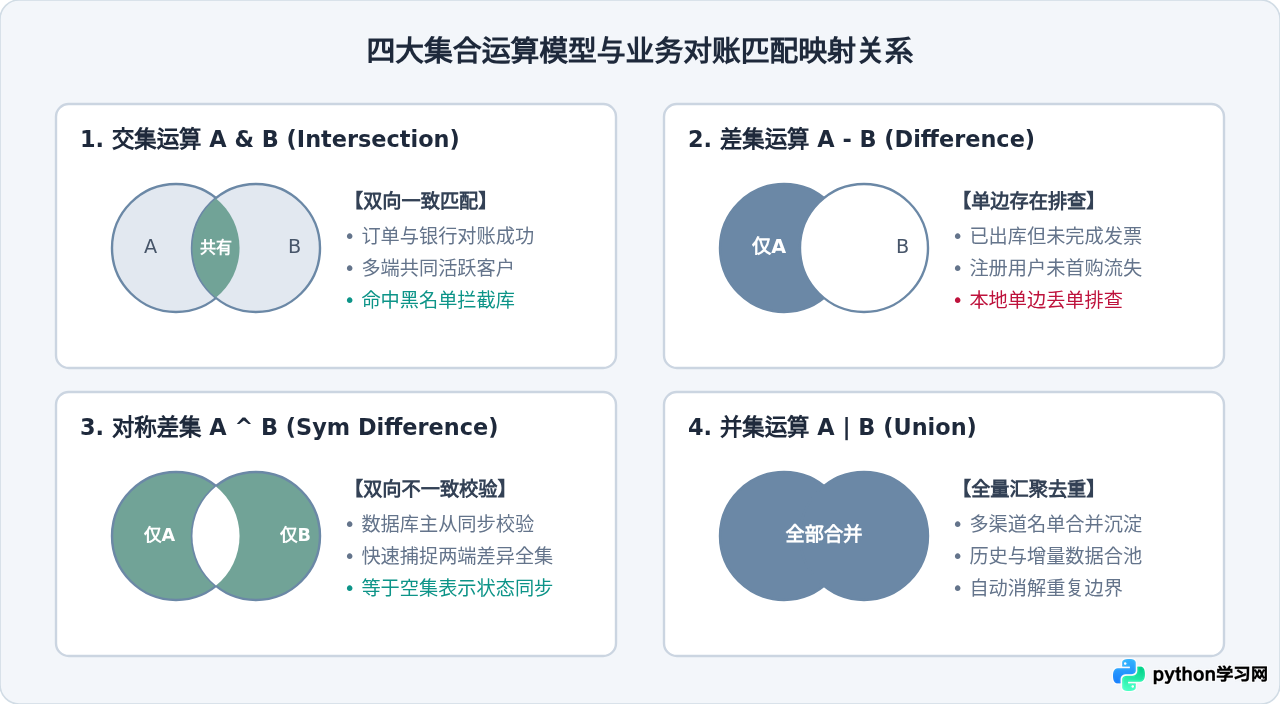
s1 & s2)时,两边变量都必须是集合对象;如果调用内置方法(如 s1.intersection(iterable)),参数可以是任何可迭代对象(如列表、元组),Python 会自动完成转换。在涉及多种类型的混合处理中,调用方法往往具备更好的容错性。
四、工程实战:企业级账单数据对账核验
为了完整展现数学集合思维在工程实践中的威力,下面编写一段模拟实际业务的对账脚本。假设系统从自有数据库中导出了当日订单交易记录,同时收到了合作支付渠道提供的流水明细对账单,我们需要迅速生成三份核心报告:
- 对账完全一致的成功订单(双方均有对应记录且金额核实无误);
- 本地单边存在记录(本地显示支付成功,但支付渠道未结算);
- 渠道单边存在记录(支付渠道有扣款流水,本地数据库因超时丢单漏单)。
# 完整对账核查实例
local_transactions = [
    {"trans_id": "T1001", "amount": 100.0},
    {"trans_id": "T1002", "amount": 250.0},
    {"trans_id": "T1003", "amount": 80.0},
    {"trans_id": "T1004", "amount": 500.0},
]

gateway_transactions = [
    {"trans_id": "T1002", "amount": 250.0},
    {"trans_id": "T1003", "amount": 80.0},
    {"trans_id": "T1004", "amount": 500.0},
    {"trans_id": "T1005", "amount": 99.0},  # 渠道有,本地无
]

# 提取关键唯一标识集合
local_id_set = {item["trans_id"] for item in local_transactions}
gateway_id_set = {item["trans_id"] for item in gateway_transactions}

# 1. 双方共有流水(交集)
matched_ids = local_id_set & gateway_id_set

# 2. 本地单边多余(本地差集)
local_only_ids = local_id_set - gateway_id_set

# 3. 渠道单边漏单(渠道差集)
gateway_only_ids = gateway_id_set - local_id_set

print("=== 对账结果汇总 ===")
print("双向核对成功订单:", matched_ids)       # {'T1002', 'T1003', 'T1004'}
print("本地单边异常(需追查未结算):", local_only_ids)   # {'T1001'}
print("渠道单边异常(需紧急补单):", gateway_only_ids) # {'T1005'}
借助集合解析式 {item["trans_id"] for item in ...},我们将原始字典序列转化为轻量的字符串集合,后续的对账核对只消耗了几条原子指令,即便原始数据规模扩大至百万级别,对账处理依然能在秒级完成。
五、集合应用的性能边界与避坑法则
集合虽然功能强大且运行迅速,但并非所有场景的万能解药。在实际工程编码中,需要注意以下边界条件与设计取舍:
- 空间复杂度开销:哈希表为了降低碰撞概率、保证 \(O(1)\) 的查询速度,通常会预留较大的稀疏内存空间。相比紧凑存储的列表或元组,
set会消耗 2 到 4 倍的内存空间。在内存受限的环境(如嵌入式设备或低配容器)中处理亿级数据时,需监控内存用量,必要时可考虑分批哈希处理或使用 Bloom Filter(布隆过滤器)。 - 嵌套复合集合的不可变约束:集合内的元素必须是不可变的。如果你试图向集合中添加另一个集合(如
{ {1, 2}, {3, 4} }),会直接触发TypeError: unhashable type: 'set'。若需要表达“集合的集合”,应改用不可变集合frozenset。 - 无法通过下标切片访问:因为集合没有顺序概念,不能使用
my_set[0]或my_set[1:3]进行下标索引与切片取值。若需要按位置访问元素,必须先转换回list或使用next(iter(my_set))获取任意单个元素。
总结
掌握 Python 集合不仅是熟悉一种语法数据类型,更是建立用离散数学思想重构工程代码的思维方式。面对庞大而繁杂的数据集,先提取核心业务主键构建集合,再运用交、并、差等集合代数运算,能够帮助我们以最具表达力、最少出错率的方式编写出执行迅速且结构优雅的专业代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















