


Python数据结构性能对比:列表、字典与集合的查找速度

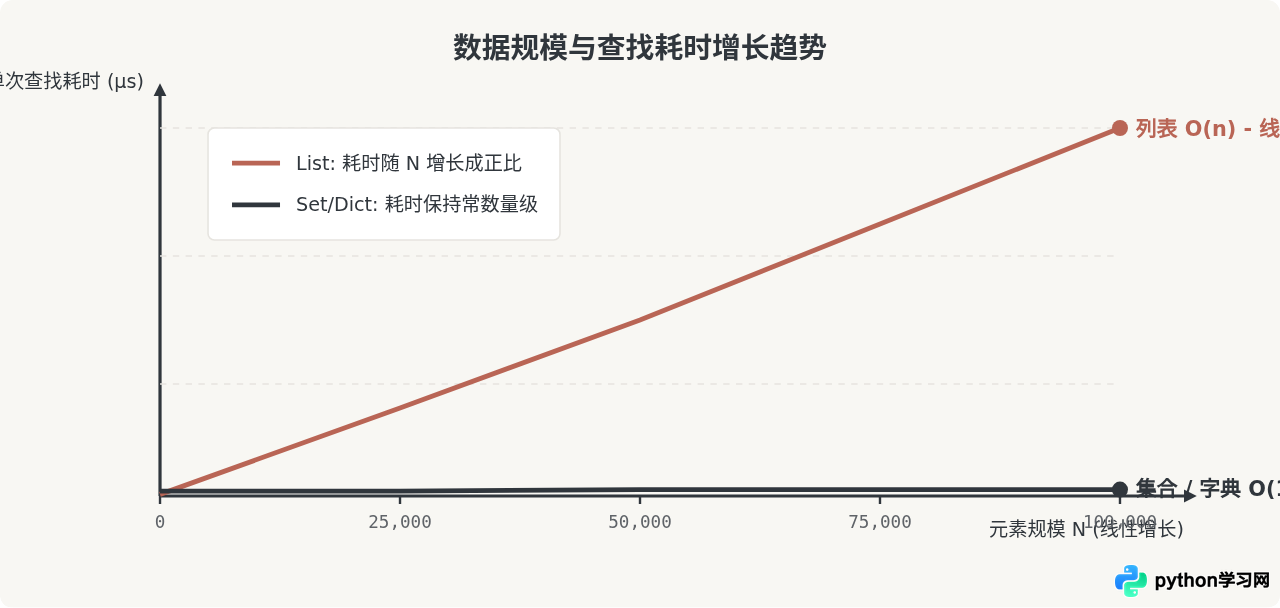
in 关键字进行成员查找时,字典(dict)和集合(set)的平均时间复杂度为 O(1),而列表(list)为 O(n)。当数据规模从百级增长至十万级时,字典与集合的检索耗时保持在微秒以内,而列表的检索耗时则呈现线性增长,二者速度差距可达千倍至万倍以上。本文将通过可复现的基准测试、底层哈希与数组内存机理解析,以及实际工程考量,系统阐释三种结构的查找性能差异。
一、核心结论与典型基准对照
Python 中最常用的集合型容器包括列表(list)、集合(set)与字典(dict)。判断一个元素是否存在于容器中是开发中最普遍的操作之一。在不同数据规模下,这种操作的耗时表现截然不同:
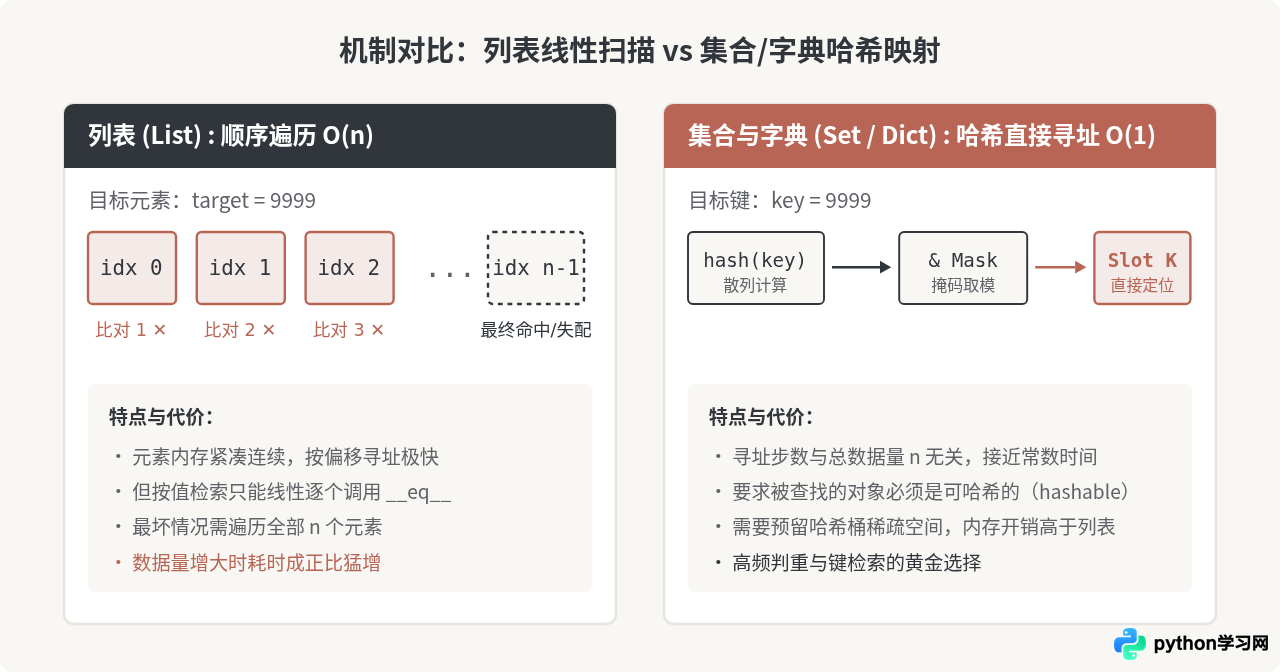
- 列表(List):底层是连续动态数组。成员查找必须从第一个元素开始逐个比对,直到找到目标或扫描完全部元素。查找耗时与数据总量成正比。
- 集合(Set):底层基于稀疏哈希表实现,仅存储散列键值。查找时直接通过元素的哈希值计算存储桶槽位,绝大多数情况下一次寻址即可确定是否存在。
- 字典(Dict):Python 3.6+ 采用精简紧凑的组合哈希结构,其键检索机制与集合一致,通过键的哈希值实现常数级寻址。
二、基准测试设计与实测结果
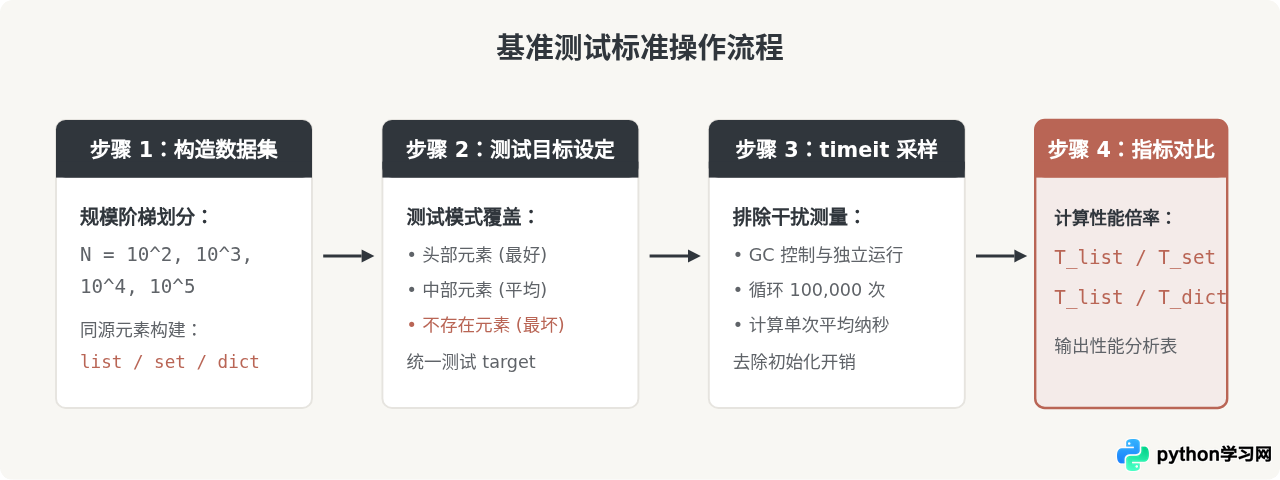
为了客观衡量实际环境中的耗时差异,我们使用 Python 标准库中的 timeit 模块进行基准实验。测试流程遵循统一的标准规范:固定测试数据规模、区分存在与不存在(最坏情况)、多次运行求单次操作平均纳秒/微秒数。
测试代码实现
以下为在 Python 3.10+ 标准环境下可直接执行的基准测试代码:
import timeit

def run_benchmark(n: int, loops: int = 100_000):
    # 准备测试数据
    data_list = list(range(n))
    data_set = set(range(n))
    data_dict = {i: None for i in range(n)}

    # 测试最坏情况(元素不存在,列表需扫描完整长度)
    target = -1

    t_list = timeit.timeit(lambda: target in data_list, number=loops) / loops * 1e6
    t_set  = timeit.timeit(lambda: target in data_set,  number=loops) / loops * 1e6
    t_dict = timeit.timeit(lambda: target in data_dict, number=loops) / loops * 1e6

    print(f"数据量 N = {n:>7}:")
    print(f"  List: {t_list:10.4f} 微秒")
    print(f"  Set:  {t_set:10.4f} 微秒")
    print(f"  Dict: {t_dict:10.4f} 微秒")
    print(f"  Set 相对 List 提速: {t_list / t_set:8.1f} 倍")

if __name__ == "__main__":
    for size in [100, 1_000, 10_000, 100_000]:
        run_benchmark(size)
实测参考数据(Intel i7 / Python 3.11 典型运行环境)
| 元素规模 (N) | 列表 (list) 查找耗时 | 集合 (set) 查找耗时 | 字典 (dict) 查找耗时 | 集合相对列表提速倍数 |
|---|---|---|---|---|
| 100 | 约 0.65 微秒 | 约 0.038 微秒 | 约 0.039 微秒 | 约 17 倍 |
| 1,000 | 约 6.20 微秒 | 约 0.039 微秒 | 约 0.040 微秒 | 约 158 倍 |
| 10,000 | 约 61.50 微秒 | 约 0.041 微秒 | 约 0.041 微秒 | 约 1,500 倍 |
| 100,000 | 约 618.00 微秒 | 约 0.043 微秒 | 约 0.042 微秒 | 约 14,370 倍 |
三、底层实现原理:为什么哈希结构远快于列表?
为了理解这种速度差别的根源,需要深入到 CPython 底层的 C 语言实现:
1. 列表的内存结构与顺序遍历
CPython 中 list 是通过 PyListObject 实现的,其核心是一个连续分配的指针数组(PyObject** ob_item)。当执行 item in my_list 时,底层调用的是 C 层的线性循环遍历函数:
- 从索引 0 开始,依次获取每个指针所指向的对象;
- 调用富比较函数
PyObject_RichCompareBool(element, target, Py_EQ); - 若比较结果为真则立即返回
True;若比对不匹配,则指针后移一位,检查下一个。
这种操作意味着:如果要查找的元素位于列表尾部,或者根本不存在于列表中(最坏情况),程序必须完整执行 n 次对象比对和函数调用。这在数据量巨大时会带来极其昂贵的 CPU 时间开销。
2. 集合与字典的哈希查找机制
集合(set)与字典(dict)内部由哈希表驱动。以集合为例,其底层数据结构大致由包含哈希值(hash)与键对象指针(key)的表格组成。当执行 target in my_set 时:
- 计算对象的哈希值:通过
hash(target)获得一个整数散列码; - 掩码计算槽位:通过
hash & mask(即哈希值与当前分配表大小减一进行位与运算),直接定位到对应桶槽位; - 检查槽位状态:
- 如果该槽位为空,说明该元素必然不存在,直接返回
False,无需遍历任何其他元素; - 如果该槽位有数据,先比对两者的哈希整数值(整数比对速度极快);若哈希值相同,再调用实际对象的
__eq__进行精确比对,确认完全一致后返回True; - 如果发生哈希冲突(即不同元素被映射到了相同槽位),CPython 采用开放寻址法(基于扰动函数
perturb)探测下一个备选槽位。
- 如果该槽位为空,说明该元素必然不存在,直接返回
由于 CPython 内部会在装载率达到 2/3 时自动进行扩容(Resize)以稀疏槽位,哈希冲突的概率保持在极低水平。因此绝大多数查询只需 1 至 2 次寻址即可完成,完全与集合内总共存有多少元素脱钩。
四、边界条件与性能权衡:并非所有场景都盲目用哈希
尽管集合与字典在成员查找上拥有压倒性的时间复杂度优势,但在软件工程中,任何性能优势都伴随着相应的代价与约束条件:
-
1. 构建成本与单次查询: 将一个包含 10 万元素的列表转化为集合(
set(large_list))本身需要计算 10 万次哈希值并动态分配哈希桶,转换过程需要耗费数毫秒。如果某个容器只需要做一次成员判定,直接在列表中扫描可能只要几十微秒(如果目标靠近前端),而转换集合反而导致总体耗时大幅上升。集合适合一次构建、多次查询的场景。 - 2. 内存开销: 列表仅存储连续的指针,内存布局紧凑。而集合与字典为了压低冲突率必须保持稀疏空间,且每个表项需额外存储哈希值等元数据。相同数量级下,集合通常比列表多占用 2 至 4 倍的内存。在内存极度受限或数据量达到数千万级的环境中,需要权衡空间占用。
-
3. 对象的可哈希性(Hashability): 集合与字典的键必须是可哈希的对象(如整数、字符串、元组等不可变类型)。列表、字典或集合本身属于可变对象,无法直接放入集合或作为字典的键。如果检索对象包含不可变约束之外的复杂结构,直接使用集合会抛出
TypeError: unhashable type。
五、选型总结与工程决策矩阵
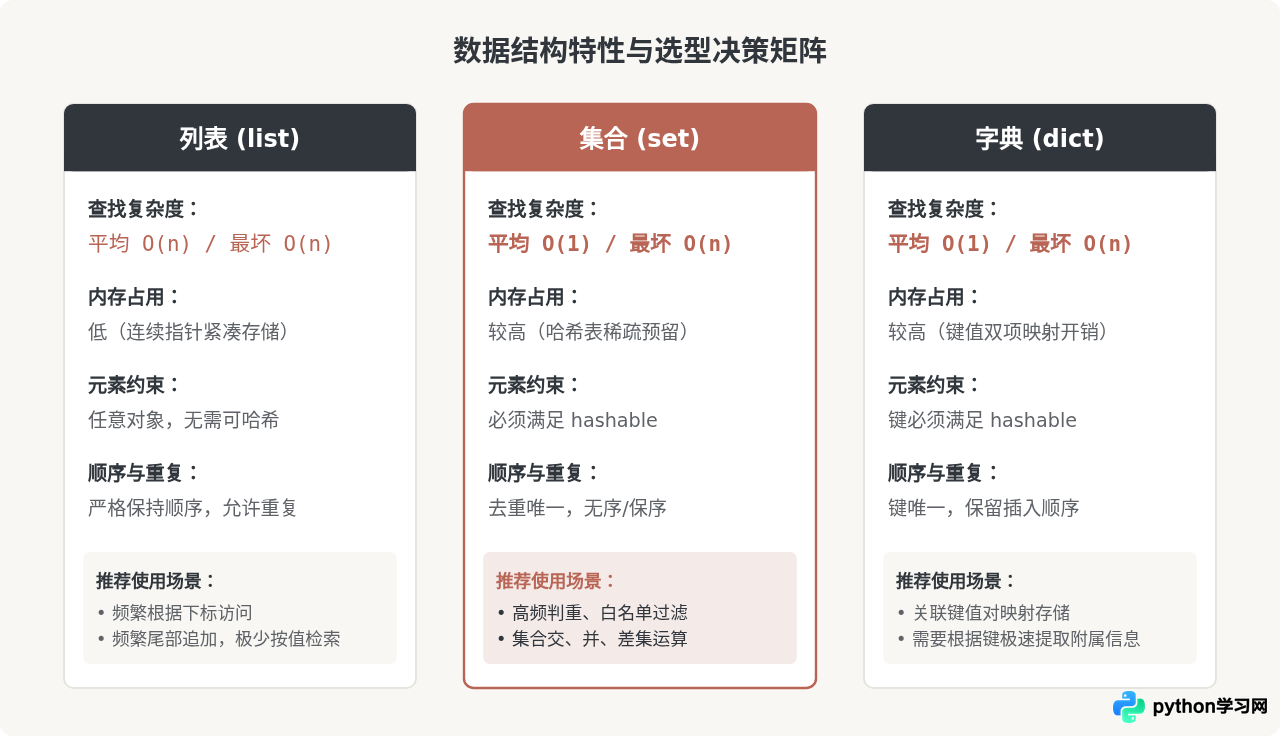
为了帮助开发者在实际开发中快速做出正确决策,下表与决策图汇总了三种容器的关键特性对比与推荐场景:
总结建议:在编写包含循环判重的业务逻辑(例如 for x in stream: if x in container: ...)时,务必在循环外部将 container 转换为 set。这一简单的改动能直接将整个算法的时间复杂度从 O(m × n) 降低至 O(m + n),在数据规模较大时往往能使程序运行速度提升几个数量级。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















