


怎么用re.split在Python中按正则表达式分割文本
本文详细讲解如何在Python中使用re.split按照正则表达式规则分割文本,涵盖多重标点匹配、空白字符合并、捕获组保留分隔符机制、maxsplit截断控制及常见边界问题排查。
在 Python 中,当待处理字符串包含多种不同的标点、长度不定的连续空格或需要根据某种复杂格式切分时,原生 str.split() 只能匹配单一固定子串的限制往往无法满足需求。此时使用 Python 标准库中的 re.split() 函数,通过传入正则表达式模式(pattern),即可按规则灵活地将目标文本切分为由片段组成的列表。
一、re.split 基本语法与工作原理
使用 re.split() 前需要先导入内置的 re 模块。该函数的标准调用形式如下:
import re

re.split(pattern, string, maxsplit=0, flags=0)
核心参数说明:
- pattern:用于匹配分隔符的正则表达式字符串或已编译的正则对象。
- string:待切分的目标原始字符串。
- maxsplit:最大切分次数。默认值为
0,表示不限制切分次数,直到遍历完整个字符串。 - flags:可选的正则匹配标志位,例如
re.IGNORECASE(忽略大小写)或re.MULTILINE(多行模式)。
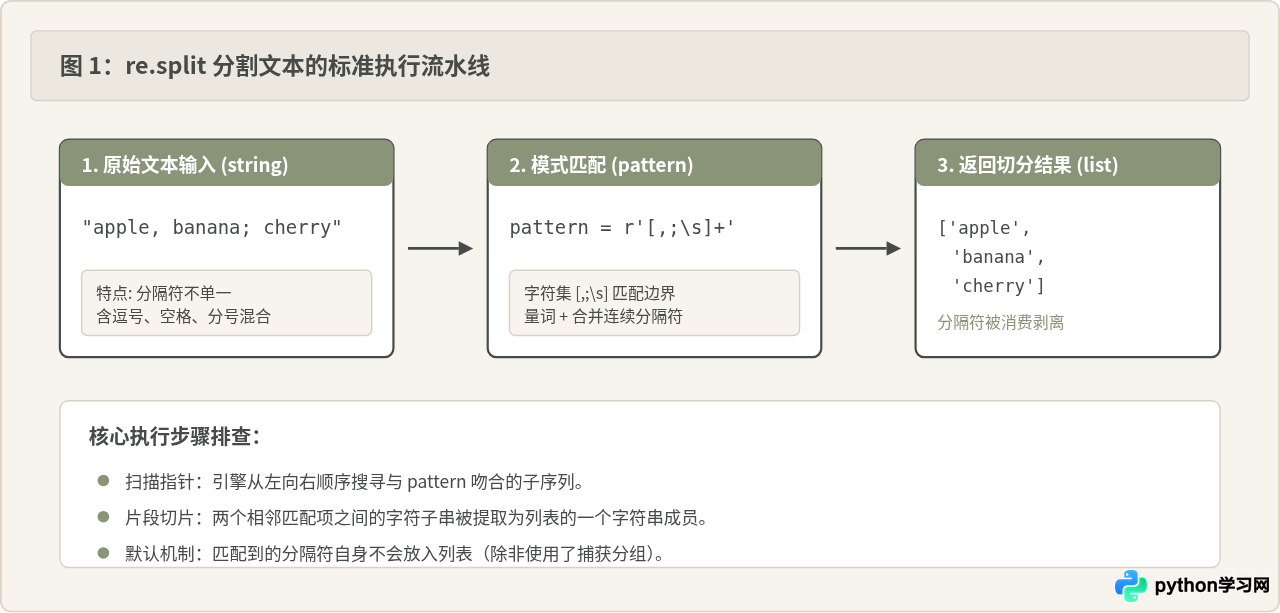
来看一个最直观的基础示例。假设有一段同时包含逗号、分号及多个连续空格的文本,需要将其中的单词提取出来:
import re

text = "apple, banana;  cherry   date"
# 匹配一个或多个连续出现的逗号、分号或空白字符
result = re.split(r'[,;\s]+', text)
print(result)
# 示例输出: ['apple', 'banana', 'cherry', 'date']在上述代码中,[ ,;\s]+ 是一个字符集结合数量词 + 的模式。正则引擎在扫描文本时,一旦发现连续出现的逗号、分号或空白,就会把它们当作一个完整的分隔符边界,将两侧的子串切出并存入结果列表。
二、常见实战切分场景
在实际开发中,文本数据的杂乱程度各不相同。以下展示三种最典型的应用模式。
1. 按照多种不同符号混合切分
当文本中混杂着逗号、竖线、分号或斜杠等多种标点时,可以使用字符集 [...] 声明所有可选符号:
import re

line = "python|java,c++;golang/rust"
# 按 | 或 , 或 ; 或 / 切分
items = re.split(r'[|,;/]', line)
print(items)
# 示例输出: ['python', 'java', 'c++', 'golang', 'rust']
2. 合并连续不规则空白字符
如果日志或数据导出的表格文本是由制表符(\t)、空格或换行混合对齐的,直接用普通空格切分会产生很多无意义的空项。给 \s 搭配量词 + 即可完美合并:
import re

log_line = "2026-10-25\t\tERROR   DatabaseConnectionTimeout\n"
tokens = re.split(r'\s+', log_line.strip())
print(tokens)
# 示例输出: ['2026-10-25', 'ERROR', 'DatabaseConnectionTimeout']
3. 按照句子结束标点断句
在自然语言处理或文本预处理中,常常需要按照句号、叹号、问号(包含全角与半角)对文章进行断句:
import re

paragraph = "你好!这是第一句。你想学Python吗?当然想!"
sentences = re.split(r'[。!?.!?]+', paragraph)
# 过滤掉末尾可能产生的空字符串
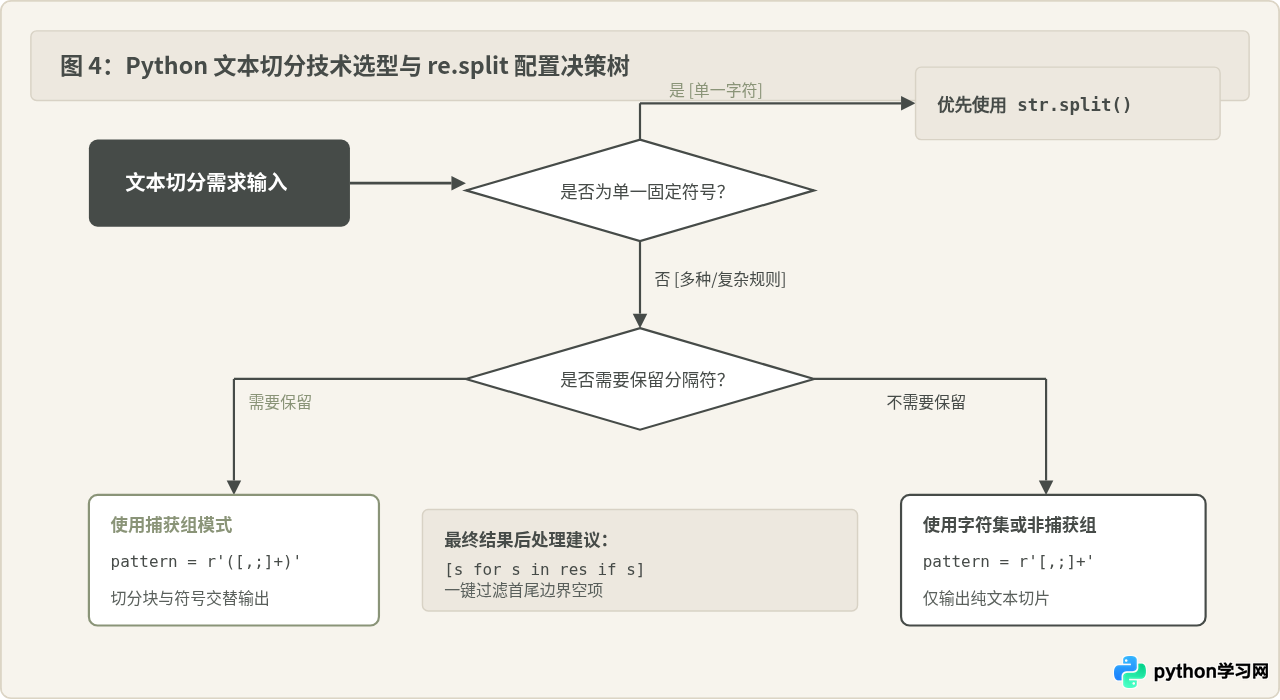
clean_sentences = [s for s in sentences if s]
print(clean_sentences)
# 示例输出: ['你好', '这是第一句', '你想学Python吗', '当然想']
三、核心机制辨析:为什么结果列表里会出现分隔符?
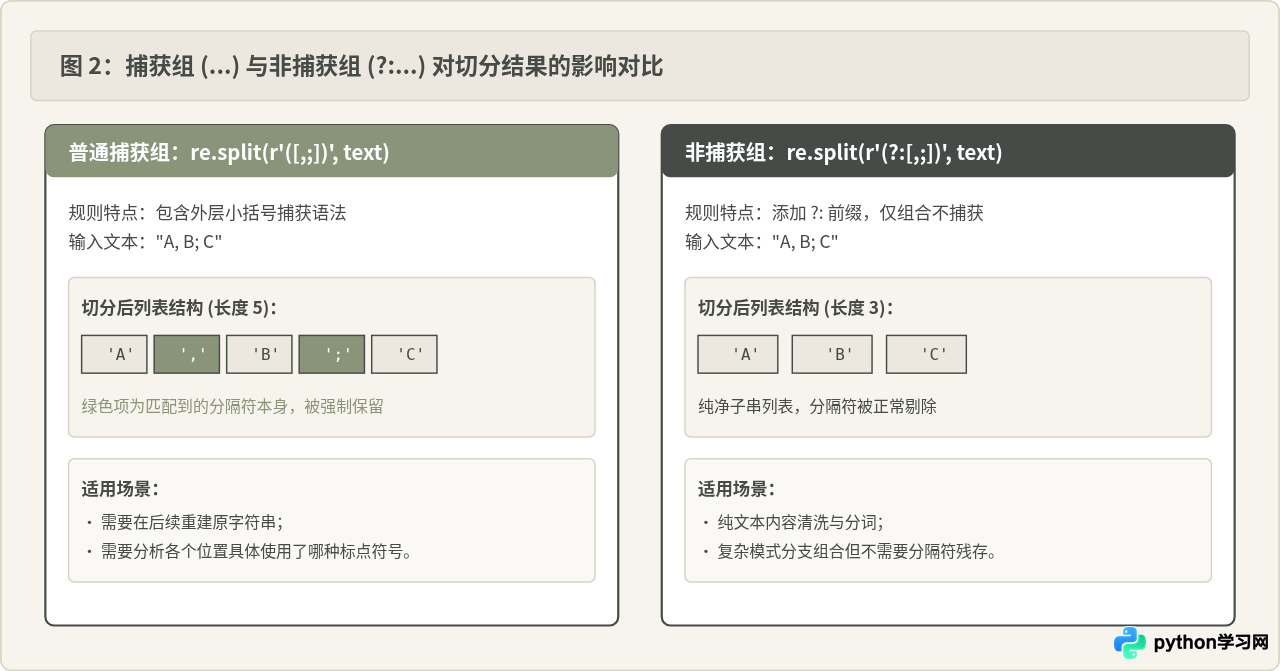
很多开发者在初次使用 re.split() 时会遇到一个困惑:明明只是想切分字符串,但返回的列表中却多出了匹配到的分隔符本身,导致列表元素翻倍。例如:
import re

text = "A, B; C"
# 开发者误写了捕获圆括号
bad_result = re.split(r'([,;]\s*)', text)
print(bad_result)
# 示例输出: ['A', ', ', 'B', '; ', 'C']原因解释:在正则表达式中,普通小括号 (...) 代表“捕获分组(Capturing Group)”。re.split() 在官方文档中专门定义了一项特性:如果 pattern 中存在捕获分组,那么匹配到的分组文本也会作为结果列表的一部分原样返回。
解决方案:
- 如果并不需要保留分隔符,不要在模式外围加圆括号;
- 如果由于优先级逻辑(如使用管道符
|)必须使用括号,请改用非捕获分组语法(?:...)。例如写成r'(?:[,;]\s*)',这样既能组合逻辑,又不会把分隔符插入到返回列表中。
四、精准控制切分行为与常见边界陷阱
1. 使用 maxsplit 限制切分次数
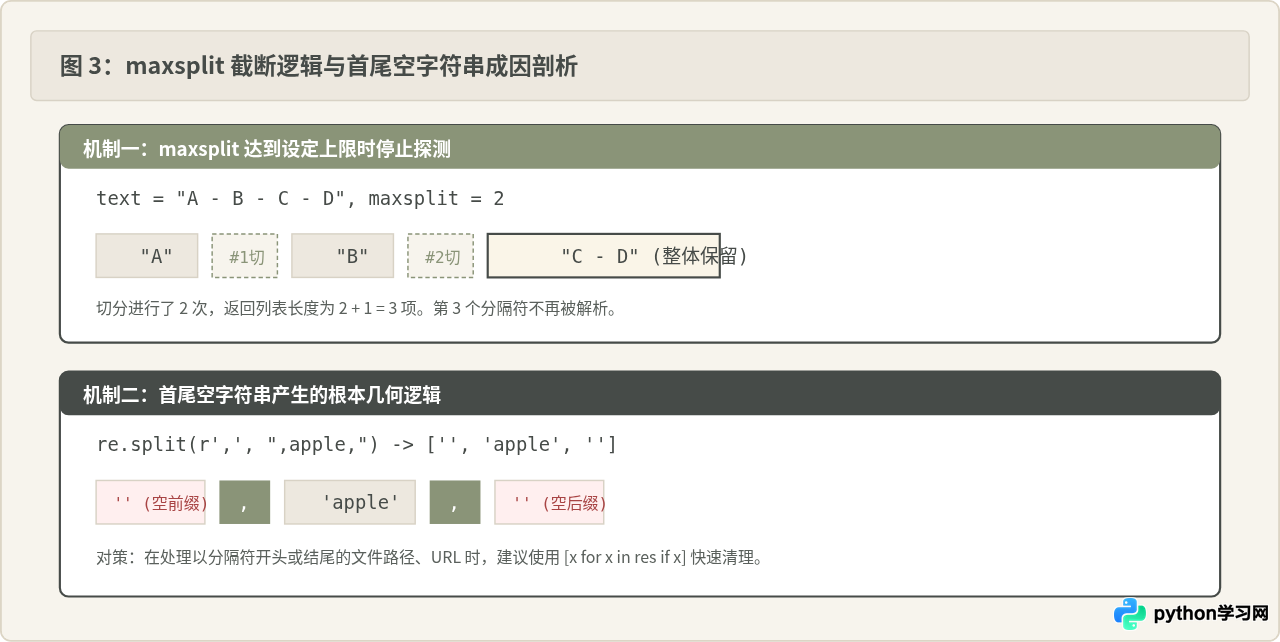
参数 maxsplit 用于指定最多执行几次切分操作。当完成指定次数的切分后,字符串剩余的所有文本将被原封不动地作为最后一个元素存入列表。这在解析键值对或日志前缀时非常实用:
import re

config_entry = "server_name: nginx.corp.internal:8080:active"
# 仅根据冒号切分前 2 次
parts = re.split(r':\s*', config_entry, maxsplit=2)
print(parts)
# 示例输出: ['server_name', 'nginx.corp.internal', '8080:active']在上面的例子中,maxsplit=2 保证了只有前两个冒号起到了分割作用,第三个冒号及后面的内容保留为一个整体。
2. 首尾匹配产生的空字符串现象
当目标字符串以符合正则模式的分隔符开头或结尾时,列表的首部或尾部会出现一个 ''(空字符串元素):
import re

text = "/usr/local/bin/"
parts = re.split(r'/', text)
print(parts)
# 示例输出: ['', 'usr', 'local', 'bin', '']成因分析:切分操作的本质是取匹配位置左侧和右侧的子串。当第一个 / 出现在索引 0 时,其左侧是长度为 0 的前缀,因此产生 '';末尾同理。解决此问题通常有两种做法:
- 在切分前对字符串进行
strip()预处理:re.split(r'/', text.strip('/')); - 使用列表推导式直接过滤空项:
[item for item in parts if item]。
五、性能优化与日常使用建议
1. 高频使用时预编译正则表达式
如果在一个需要循环处理成千上万行文本的数据管道中频繁调用 re.split(),反复传入正则字符串会导致底层不断进行正则语法的重新解析。此时推荐使用 re.compile() 将模式预编译为正则对象:
import re

# 提前编译模式,避免循环内重复解析正则 AST
SPLIT_PATTERN = re.compile(r'[\t,;|]')

lines = ["a,b,c", "x|y|z", "1\t2\t3"]
for line in lines:
    tokens = SPLIT_PATTERN.split(line)
    # 处理 tokens ...
2. 能用 str.split 时不要强行用正则
虽然 re.split() 极其强大,但如果切分需求只是简单的单一固定字符(如单逗号或单空格),原生 str.split() 的执行速度比正则快 3 到 5 倍。只有当面临多重符号、动态空白或复杂上下文时,才应当选择 re.split()。
六、总结速查表
为了便于日常编码快速查阅,以下将 re.split 的核心技巧整理为速查表:
| 目标场景 | 推荐写法 (示例代码) | 返回结果特征 |
|---|---|---|
| 按多种标点切分 | re.split(r'[,;\s]+', s) |
纯文本列表,连续分隔符被整体吞掉 |
| 保留分隔符号本身 | re.split(r'([,;])', s) |
文本块与分隔符交替排列在列表中 |
| 使用分组但不想保留分隔符 | re.split(r'(?:ab|cd)', s) |
使用 (?:...) 非捕获组,分隔符不进入列表 |
| 仅切分前 N 次 | re.split(r':', s, maxsplit=2) |
切分 2 次后剩余内容整体保留为最后一项 |
| 高频批量切分 | p = re.compile(r'...'); p.split(s) |
避免循环内反复重新解析正则表达式 |
| 清理首尾多余空串 | [x for x in re.split(...) if x] |
剔除由于首尾命中分隔符带来的 '' 元素 |
掌握了正则表达式模式的编写逻辑、捕获组特性以及 maxsplit 的控制边界后,re.split() 将成为你在 Python 中处理非结构化与半结构化文本时最为得力的利器。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















