


Python datetime时间处理太复杂?标准库高效用法指南
深入解析Python标准库datetime的高效实战方法,涵盖核心类职责、ISO 8601与时间戳转换、timedelta边界与计算、zoneinfo时区最佳实践,助你摆脱第三方依赖困扰。
许多 Python 开发者在遇到时间与时区问题时,第一反应往往是抱怨 datetime 模块繁琐晦涩,甚至习惯性地在项目中引入诸如 arrow、pendulum 等第三方库。然而,随着 Python 3.7+ 引入更完备的 fromisoformat() 以及 Python 3.9+ 内置 zoneinfo 模块,Python 标准库的时间处理体系已经足够精简与健全。处理时间之所以让人感到混乱,核心往往在于没有厘清各个类别的职责边界、混淆了格式解析函数,或在无意识间踩中了“朴素时间(Naive)”与“感知时间(Aware)”的暗坑。本文将直接拆解标准库核心组件,理清常用操作流程与边界限制,建立一套清晰、可复用且不依赖任何外部库的高效实践范式。
一、理清核心边界:五大类的分工与协同
初学者感到 datetime 模块复杂,很大程度上源于 datetime 模块内部同名类 datetime.datetime 的存在,以及 date、time、datetime、timedelta 和时区类之间的交织。实际上,标准库在面向对象设计上有着非常明确的单一职责分工:
datetime.date:纯日历维度,仅记录公历的年、月、日。它完全不包含几点几分几秒,也没有时区概念。适用于出生日期、财务记账日、节假日等纯粹的日历标签。datetime.time:纯时钟维度,记录一天内的时、分、秒、微秒,可附带时区信息,但完全不绑定到任何具体日期。适用于每日固定作息、营业起止时间等周期性时刻。datetime.datetime:时钟与日历的复合体,继承并整合了date与time的全部属性,是业务开发中记录某一绝对或相对事件发生时刻的核心实体。datetime.timedelta:持续时长与时间差量,用于表达两个时间点之间的物理跨度(如 3 天 4 小时 20 分钟),或者作为基准时间的加减偏移量。zoneinfo.ZoneInfo(Python 3.9+):IANA 时区数据库的标准实现,用来赋予时间点明确的地理时区语义,彻底取代旧有的第三方pytz库。
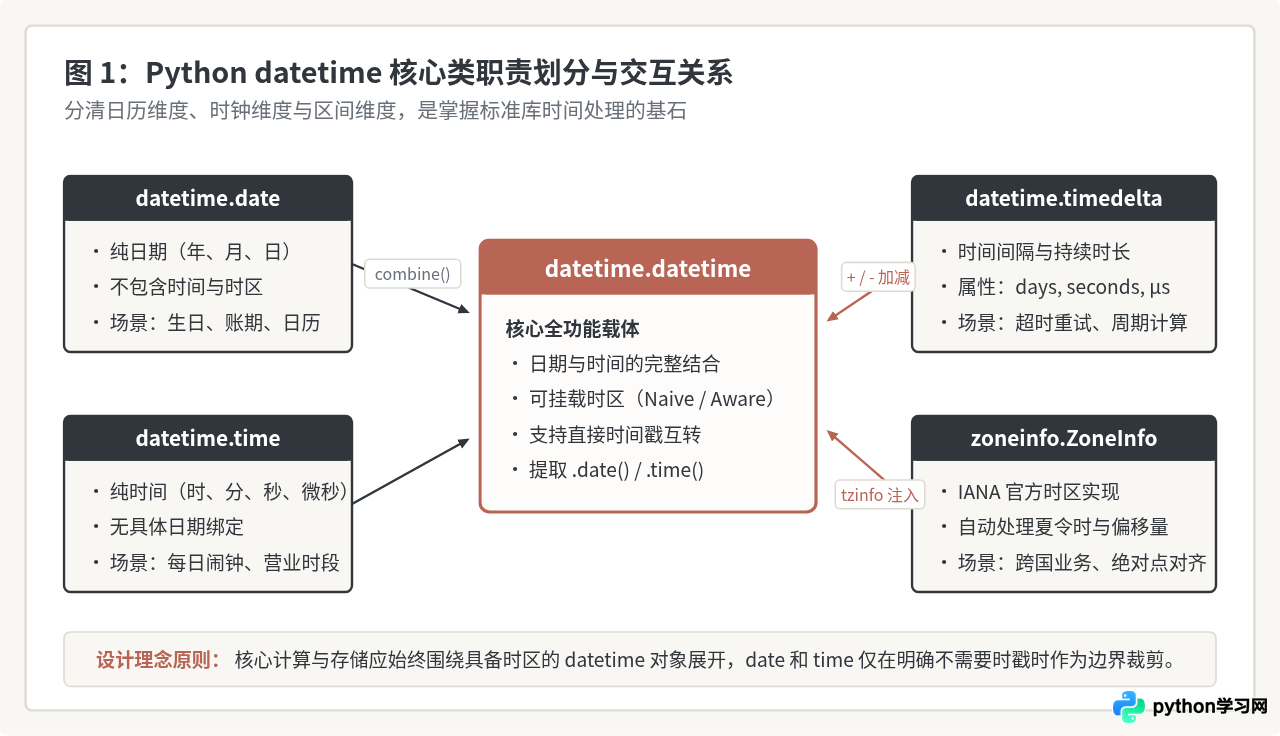
在日常编码中,组合与拆解这些类是最高频的基础操作。掌握 datetime.combine() 以及 .date()、.time() 方法,可以自由地在不同粒度之间切换:
from datetime import date, time, datetime
from zoneinfo import ZoneInfo

# 1. 单独定义纯日期与纯时间
d = date(2026, 10, 30)
t = time(15, 30, 0)

# 2. 合成具体时刻并挂载时区
meeting = datetime.combine(d, t, tzinfo=ZoneInfo("Asia/Shanghai"))
print(meeting)  # 2026-10-30 15:30:00+08:00

# 3. 从复合对象中逆向提取纯日期与时间
extracted_date = meeting.date()
extracted_time = meeting.time()在核心业务逻辑、数据库持久化和网络 API 传输中,请始终将 datetime.datetime 作为通用数据载体。date 与 time 仅用于业务边界输入校验或无需时序追踪的纯日历/作息场景,避免在多模块之间频繁来回拆装。
二、字符串与时间戳互转:标准转换四步决策
在实际工程中,时间处理超过一半的代码都在与外部输入输出打交道:从 JSON 中解析字符串,或将时间戳存入 Redis/数据库。很多人感到吃力是因为反复去查 %Y-%m-%d %H:%M:%S 等繁杂的格式占位符,且容易把解析函数与格式化函数混淆。
1. 优先采用 ISO 8601 标准:抛弃复杂的 strptime
如果业务前后端交互或微服务接口遵循主流标准,其传输的日期时间字符串大多是 ISO 8601 格式(例如 2026-10-30T15:30:00+08:00 或以 Z 结尾的 UTC 时间)。针对此类数据,Python 标准库提供了原生支持的 fromisoformat() 与 isoformat():
from datetime import datetime

# 解析 ISO 8601 字符串(无需记忆任何格式化代码,Python 3.11+ 原生支持末尾 'Z')
iso_str = "2026-10-30T15:30:00+08:00"
dt = datetime.fromisoformat(iso_str)

# 转换回标准字符串
output_str = dt.isoformat()
print(output_str)  # 2026-10-30T15:30:00+08:00
fromisoformat() 底层基于 C 实现,解析速度不仅比 strptime 快数倍,而且彻底杜绝了由于手写 %m(月份)与 %M(分钟)、%H(24小时制)与 %I(12小时制)搞混导致的格式错误。
2. 自定义格式解析与格式化:strptime 与 strftime 的记忆诀窍
当面对非标准历史数据(例如 "2026/10/30 15:30")时,才需要动用 strptime 与 strftime。两者的命名差异有明确的语义设计:
strptime(Parse):字符串解析器。把不可运算的文本按格式串“解析(Parse)”为datetime内存对象。strftime(Format):字符串格式化。把内存中的datetime对象按指定格式“格式化(Format)”为前端展示文本。
from datetime import datetime

# 场景:解析遗留接口自定义格式
custom_str = "2026-10-30 15:30:45"
fmt = "%Y-%m-%d %H:%M:%S"
dt_obj = datetime.strptime(custom_str, fmt)

# 场景:生成用户界面友好展示文案
display_text = dt_obj.strftime("%Y年%m月%d日 %H时%M分")
print(display_text)  # 2026年10月30日 15时30分
3. Unix 时间戳互转:警惕隐式本地时区陷阱
Unix 时间戳定义为自 1970 年 1 月 1 日 00:00:00 UTC 起经过的物理秒数,是一个绝对数值。从时间戳还原 datetime 时,如果直接调用 datetime.fromtimestamp(ts) 而不传入时区参数,标准库会隐式读取当前操作系统的本地时区。一旦该代码迁移至服务器(默认容器往往设置为 UTC),时间转换将凭空产生数小时的逻辑偏差。
from datetime import datetime, timezone
from zoneinfo import ZoneInfo

timestamp = 1793345400.0

# 推荐做法:显式指定 UTC 时区,获得无歧义的 Aware 时间对象
dt_utc = datetime.fromtimestamp(timestamp, tz=timezone.utc)

# 转换为业务所需的目标时区
dt_shanghai = dt_utc.astimezone(ZoneInfo("Asia/Shanghai"))
print(dt_shanghai)  # 2026-10-30 15:30:00+08:00

# 从 Aware datetime 提取时间戳(全球任意机器执行结果均完全相同)
extracted_ts = dt_shanghai.timestamp()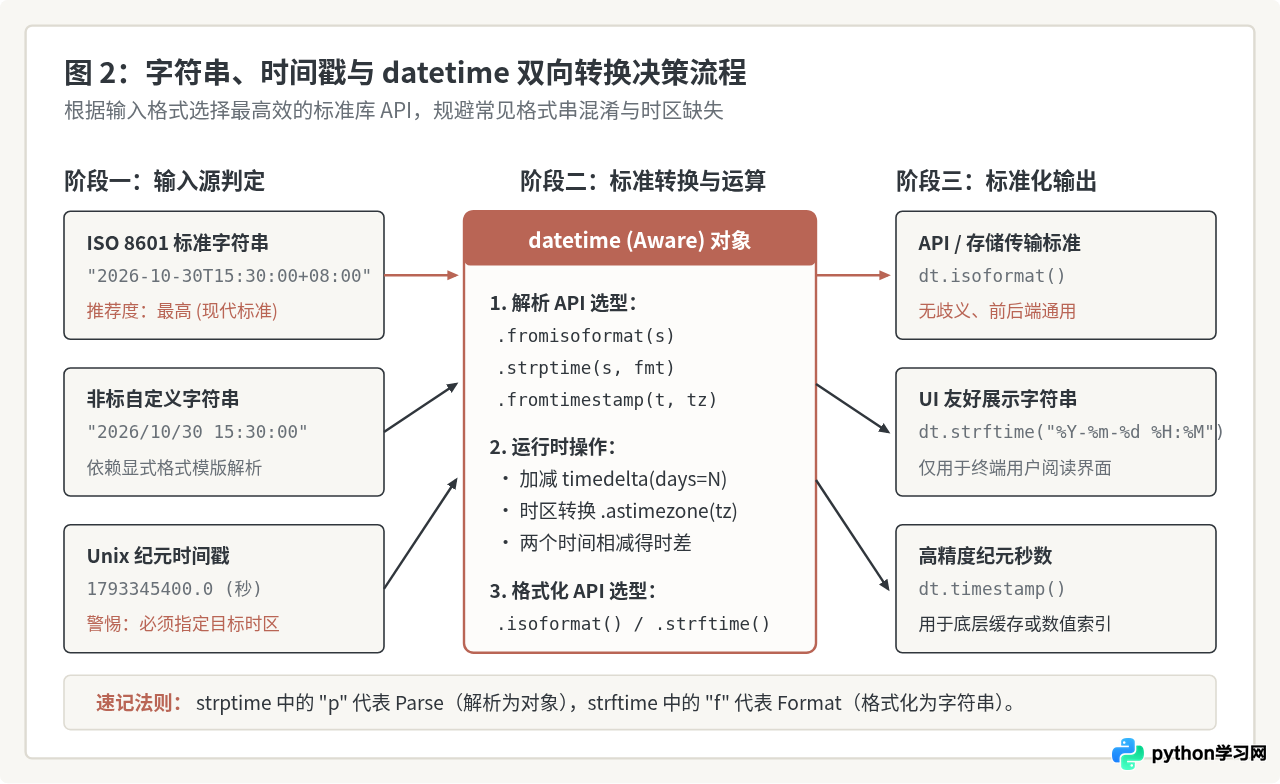
三、时间运算与范围推算:掌握 timedelta 的物理边界
进行时间计算时,timedelta 是标准库的核心工具。但在使用 timedelta 前,必须理解其数学本质与物理边界:timedelta 内部只存储 days(天)、seconds(秒)和 microseconds(微秒),其表达的是固定物理时长的流逝。
1. 为什么 timedelta 不支持 months(月)和 years(年)?
很多开发者在调用 timedelta(months=1) 报错后感到困惑。Python 标准库之所以严格禁止这一操作,是因为“一个月”和“一年”在数学上不是固定时长:二月份可能是 28 天或 29 天,其他月份可能是 30 天或 31 天;平年有 365 天,闰年有 366 天。如果在底层假定 1 个月为 30 天,在涉及财务结账、会员到期等严谨业务中将引发严重资产偏差。
from datetime import datetime, timedelta, timezone

now = datetime.now(timezone.utc)

# 常见合理运算:加减固定时长
after_7_days = now + timedelta(days=7)
retry_time = now + timedelta(minutes=15, seconds=30)

# 计算两个时间点的间隔
duration = after_7_days - now
print(duration.days)            # 7
print(duration.total_seconds()) # 604800.0当需要计算两个时间点之间的总秒数或耗时时,务必调用 duration.total_seconds()。直接访问 duration.seconds 仅代表不足 1 天的秒数余数(0 到 86399),如果间隔超过 24 小时,读取 .seconds 会遗漏天数部分,导致严重的耗时统计失真。
2. 日期序列遍历与自然月份跨度处理
生成时间序列(如按天切片抓取日志、按小时统计指标)是数据处理的经典场景,利用 timedelta(days=1) 可以写出非常简洁的生成器:
from datetime import date, timedelta

def date_range(start_date: date, end_date: date):
    curr = start_date
    while curr <= end_date:
        yield curr
        curr += timedelta(days=1)

# 打印 2026-10-28 至 2026-10-30 的所有日期
for d in date_range(date(2026, 10, 28), date(2026, 10, 30)):
    print(d)
四、时区困局破解:从 Naive 到 Aware 的工程标准
在所有时间处理问题中,时区是产生 Bug 最多的重灾区。要彻底解决时区问题,关键是掌握标准库中 Naive(朴素) 与 Aware(感知) 的本质区别。
1. Naive 与 Aware 的本质差异
- Naive(朴素对象):
tzinfo为None。它只包含年月日时分秒的数字,缺乏地理上下文。系统无法获知这是北京时间、伦敦时间还是纽约时间。不同时区的两台机器对其可能产生截然相反的理解,直接将 Naive 时间与 Aware 时间做比对会抛出TypeError。 - Aware(感知对象):挂载了合法的时区实例(如
ZoneInfo("Asia/Shanghai")或timezone.utc)。在全世界任意时刻,一个 Aware 对象精准代表宇宙时间线上的唯一物理绝对点。
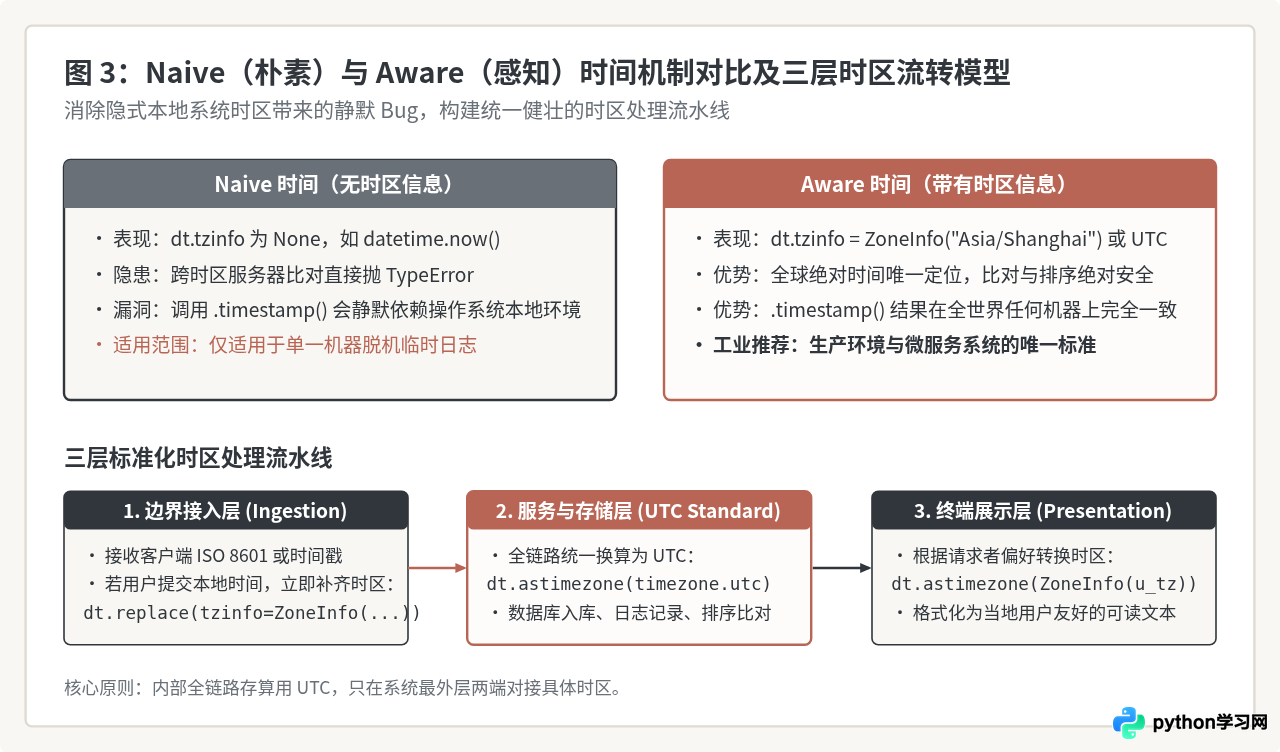
2. 现代 Python 时区利器:zoneinfo 与 astimezone
在 Python 3.9 之前,开发者大多依赖第三方的 pytz,而 pytz 因为非标实现,要求开发者在转换后显式调用 tz.normalize(dt),一旦直接赋值便会产生偏移量错误的臭名昭著陷阱。Python 3.9 推出的标准库 zoneinfo 模块彻底终结了这一混乱:
from datetime import datetime, timezone
from zoneinfo import ZoneInfo

# 1. 产生时区感知时间(推荐直接传入 tz 参数)
beijing_tz = ZoneInfo("Asia/Shanghai")
tokyo_tz = ZoneInfo("Asia/Tokyo")

dt_beijing = datetime(2026, 10, 30, 15, 0, 0, tzinfo=beijing_tz)

# 2. 安全时区转换(时间线上的同一瞬间,在不同时区下的投影)
dt_tokyo = dt_beijing.astimezone(tokyo_tz)
dt_utc = dt_beijing.astimezone(timezone.utc)

print(dt_beijing) # 2026-10-30 15:00:00+08:00
print(dt_tokyo)   # 2026-10-30 16:00:00+09:00
print(dt_utc)     # 2026-10-30 07:00:00+00:00

# 3. 跨时区时间可以直接比对大小
print(dt_beijing == dt_tokyo) # 打印 True(物理绝对时间完全相同)
.replace(tzinfo=...) 是覆盖修改:它保持原有数值不变,强行贴上新时区标签(例如把 15:00 的标签从北京换成东京,物理时间实际上瞬间漂移了 1 小时)。
.astimezone(...) 是投影转换:它保持物理瞬间绝对不变,自动换算对应时区的本地钟表数值。日常时区转换必须使用 astimezone。
3. 企业级三层时区流水线
为了保证系统长期演进不出现时区混乱,建议在工程架构中建立统一的流水线规范:
- 系统入口层:对用户输入或外部回调进行时区对齐。若仅为朴素时间,结合调用方的所属时区补充为 Aware 对象。
- 业务与存储核心层:系统内部(内存缓存、消息队列、MySQL/PostgreSQL 数据库)全链路使用
UTC时区的 Aware 时间,或统一存储标准 Unix 时间戳。 - 展示出口层:只在面向特定客户端渲染视图或返回本地化文本时,通过
astimezone(user_tz)转换回目标用户的当地时区。
五、实战总结:标准库高效法则速查
将 Python 标准库 datetime 用好并不需要背诵全部 API,只要在日常开发中贯彻以下四条核心原则,就能在保持轻量无依赖的同时,写出高可读性、高鲁棒性的时间处理代码:
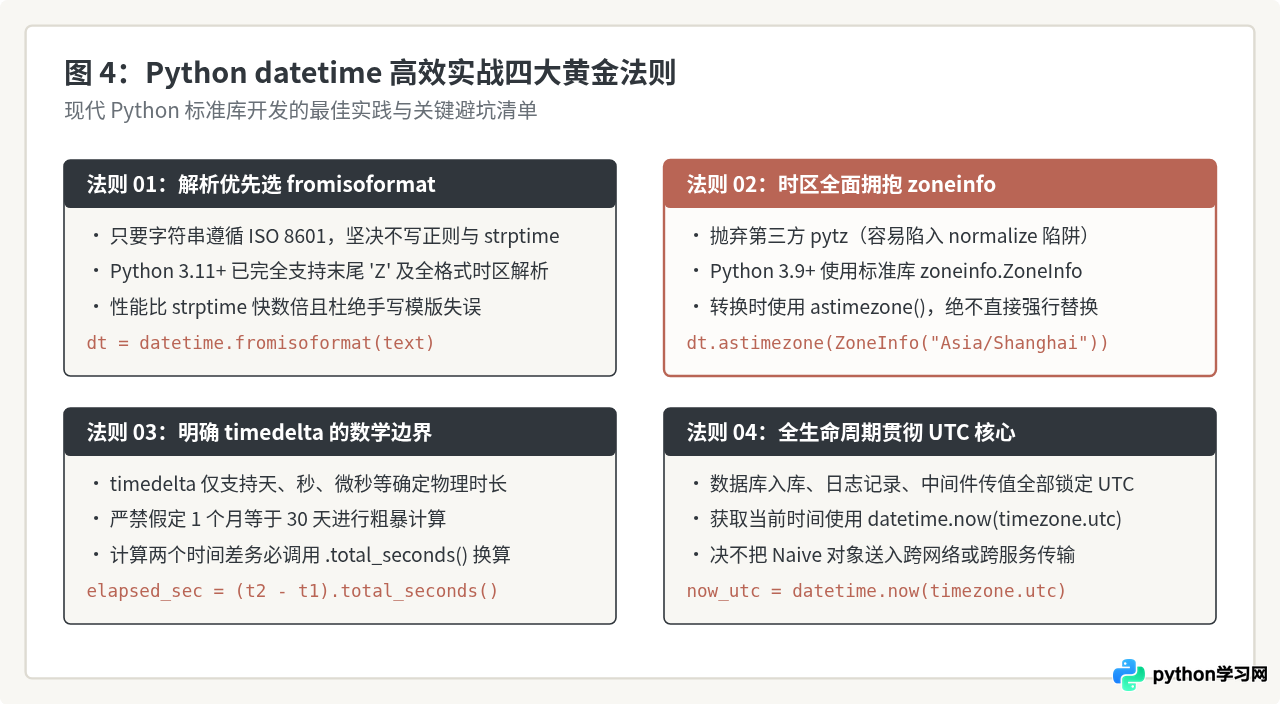
| 场景需求 | 推荐标准库方案 | 应避免的常见反模式 |
|---|---|---|
| 解析 ISO 8601 标准字符串 | datetime.fromisoformat(s) |
编写长串正则表达式或手写 %Y-%m-%d... 模板 |
| 获取当前系统时间 | datetime.now(timezone.utc) |
无参调用 datetime.now() 导致生成不可靠的 Naive 时间 |
| 时区定义与管理 | zoneinfo.ZoneInfo("Region/City") |
继续引用已废弃且易错的第三方 pytz 库 |
| 跨时区转换 | dt.astimezone(target_tz) |
使用 .replace(tzinfo=...) 导致物理时刻发生位移 |
| 计算时间差耗时 | (t2 - t1).total_seconds() |
直接读取 delta.seconds 遗漏超过 24 小时以上的天数 |
| 输出标准时间文本 | dt.isoformat() |
手工字符串拼接或非标格式输出 |
Python 标准库的时间模块经历多个大版本的迭代沉淀,其内在逻辑严谨、性能卓越且历经考验。摒弃旧有对第三方库的盲目依赖,从理解核心类的职责划分开始,全面践行以 Aware UTC 为中枢的数据流设计,时间处理将成为你代码库中最稳定可靠的基础设施之一。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















