


Python字符串切片语法详解:start、end与step参数用法
深入详解Python字符串切片语法,全面解析start、end与step三个核心参数的工作原理、正负索引映射、默认缺省值推导与安全边界特性,助你掌握精准高效的切片技巧。
假设你正在处理一份包含固定格式文本的日志数据,或者需要从形如 "2026-10-25" 的日期字符串中分别提取年份、月份与日份,甚至需要把一段编码文本直接倒序排列。在很多编程语言中,完成这类提取通常需要调用截取函数或编写循环计数器,而在 Python 中,只需使用简洁的切片语法即可一次性搞定。Python 的字符串切片语法格式为 string[start:end:step],通过合理配置起始索引、结束边界与步长方向,我们能够精确抽取子字符串。本文将深入拆解 start、end 与 step 三个参数的具体行为、双向索引映射机制以及边界边界安全特性,帮助读者在实践中游刃有余地运用切片操作。
一、切片基本形式与双向索引机制
切片最核心的前提是理解 Python 字符串的索引体系。Python 提供了两套无缝协同的索引机制:从 0 开始自左向右递增的正向索引,以及从 -1 开始自右向左递减的负向索引。无论使用哪种索引,切片语法均遵循经典的左闭右开区间规则,即包含 start 位置处的字符,但不包含 end 位置处的字符(数学记法为 [start, end))。
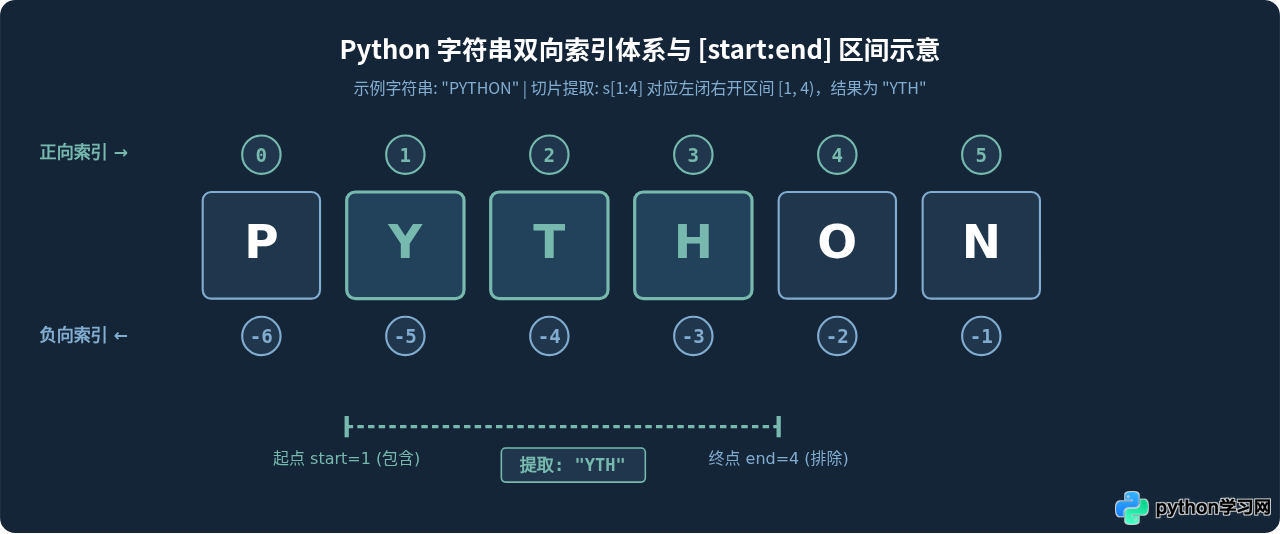
当只使用两个参数 string[start:end] 时,第三个参数 step 默认被赋予正向步长 1。此时切片从 start 对应的位置开始,逐字符向右收集,直至遇到 end 索引之前停止。下面我们通过具体的代码验证这一过程:
# 定义示例字符串
text = "PYTHON"

# 基础正向切片:提取索引 1 到 3 的字符
res1 = text[1:4]
print(res1)  # 输出: 'YTH'

# 使用负向索引:提取倒数第 5 个到倒数第 2 个之前
res2 = text[-5:-2]
print(res2)  # 输出: 'YTH'

# 正负索引混用:start 为正索引 1,end 为负索引 -2
res3 = text[1:-2]
print(res3)  # 输出: 'YTH'
从上面的示例可以看出,无论是 text[1:4]、text[-5:-2] 还是 text[1:-2],最终得到的子串完全一致。这是因为在 Python 底层,负索引 -k 会自动转换为等价的非负索引 len(text) + (-k)。例如长度为 6 的 "PYTHON",索引 -5 对应 6 + (-5) = 1,而 -2 对应 6 + (-2) = 4,因此三者指向相同的物理截取区间。
二、参数缺省规则与执行推导流程
在日常开发中,我们经常会看到形如 s[:3]、s[2:] 甚至 s[:] 的切片书写形式。切片表达式中冒号两旁的参数并不是必须显式给出的。当某个参数被省略时,Python 会根据 step 的符号自动推导缺省值:
- 省略
start:当step > 0时,默认起点为字符串首端(索引0);当step < 0时,默认起点为字符串末端(索引-1)。 - 省略
end:当step > 0时,默认终点延伸至字符串末尾之后(取满到最末字符);当step < 0时,默认终点延伸至字符串最左端之前(包含索引 0 对应的首字符)。 - 省略
step:默认为1,即沿正向相邻连续提取。
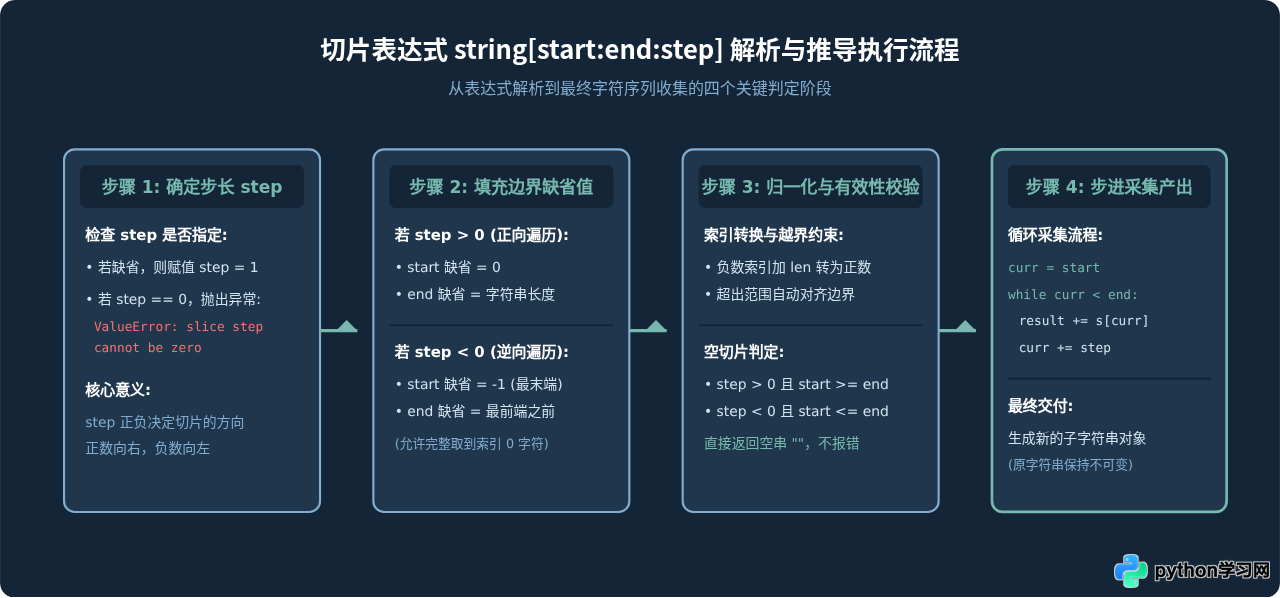
我们来看这组省去不同参数的典型代码,观察缺省值的实际表现:
message = "HelloWorld"

# 省略 start:等价于 message[0:5],提取前 5 个字符
prefix = message[:5]
print(prefix)  # 输出: 'Hello'

# 省略 end:等价于从索引 5 提取至末尾
suffix = message[5:]
print(suffix)  # 输出: 'World'

# start 和 end 均省略:完整复制原字符串内容
full_copy = message[:]
print(full_copy)  # 输出: 'HelloWorld'
三、step 步长深度剖析:方向、采样与逆序反转
step 参数是切片功能强大的关键所在。它同时承担了两个职责:决定抽样间隔和决定遍历方向。
当 step > 0 时,索引由小向大移动(自左向右)。例如 step = 2 表示每隔一个字符抽取一个。当 step < 0 时,索引由大向小移动(自右向左)。在逆向切片中,start 必须位于 end 的右侧(即 start > end),否则由于移动方向与目标区间相悖,切片将直接返回空字符串 ""。
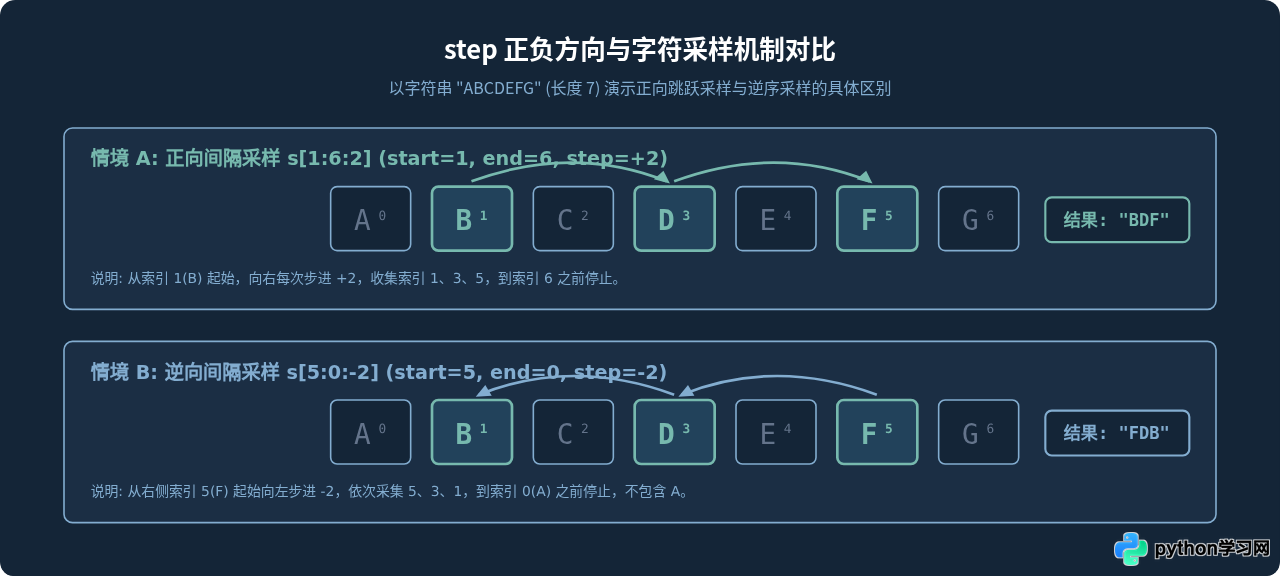
最经典的负步长应用莫过于全字符串翻转表达式 string[::-1]。它的执行机制非常精妙:省略 start 时,由于 step < 0,起点自动设定为末尾;省略 end 时,终点自动设定为最前端之前的虚拟边界;步长为 -1 表示逐字符向左移动,从而将整串完整倒置:
raw = "PythonSlice"

# 字符串完整倒序翻转
reversed_str = raw[::-1]
print(reversed_str)  # 输出: 'ecilSnohtyP'

# 步长方向冲突的常见错误:start < end 但 step 为负数
empty_res = raw[2:7:-1]
print(repr(empty_res)) # 输出: '' (空字符串,无法向左移动命中该区间)step 绝对不能为 0!如果传入 step=0,Python 会立即触发运行时异常 ValueError: slice step cannot be zero。因为步长为零意味着原地停滞,无法形成有效的迭代推进。
四、切片的安全边界特性与高频注意点
初学者容易将单个索引访问与切片操作混淆。在 Python 中,通过单索引访问字符(如 s[100])如果超出字符串实际长度,会直接抛出 IndexError: string index out of range。然而,切片操作对索引越界具有极高的容错性。无论 start 或 end 设置得多大或多小,Python 都绝不会抛出异常,而是会自动将索引值收敛约束在合法的数据边界内:
s = "Data"  # 长度为 4,合法正向索引为 0 到 3

# 1. end 远超字符串实际长度:自动截取到字符串末尾
print(s[1:999])  # 输出: 'ata'

# 2. start 和 end 均超出范围:返回空字符串,不报错
print(s[100:200])  # 输出: ''

# 3. 负索引超出范围:自动对齐到最左端 (相当于从索引 0 开始)
print(s[-999:3])  # 输出: 'Dat'
这种宽容的设计使得我们在处理长短不一的输入文本时,往往不需要在每次切片前显式调用 min(len(s), end) 进行繁琐的边界防御校验。
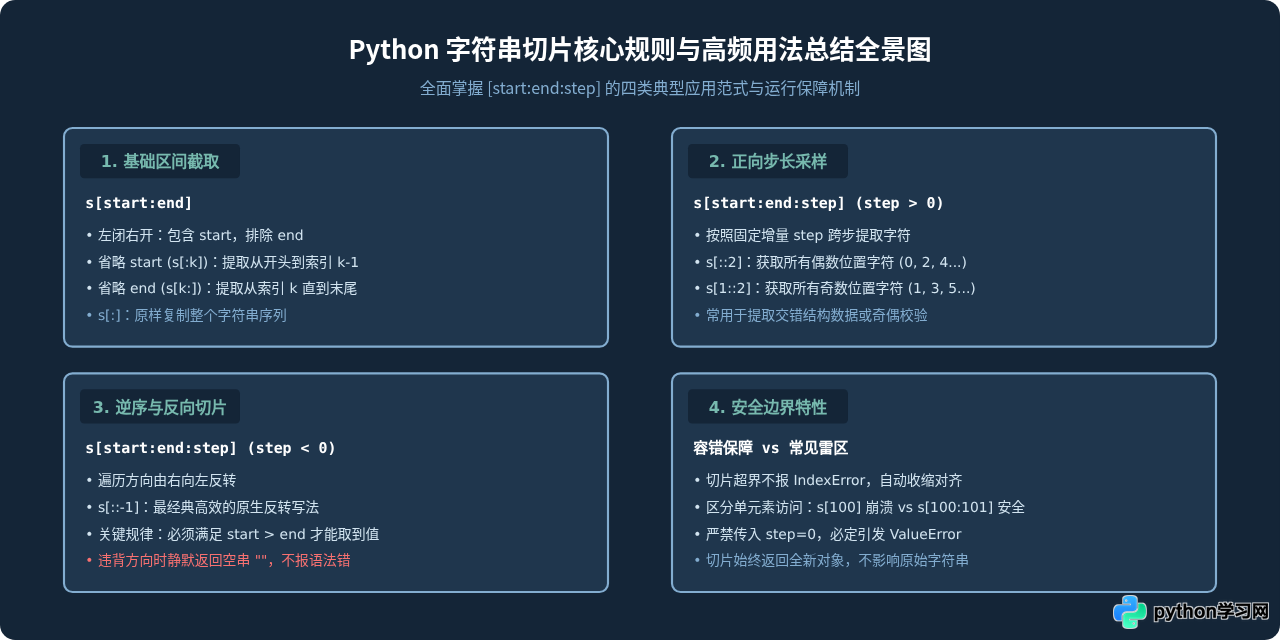
五、参数用法速查与总结
为了便于在实际编码中快速查阅与对齐规则,下表整理了 start、end 与 step 在各种组合下的表现形式及对应语义:
| 表达式形式 | start 缺省值 | end 缺省值 | 遍历方向 | 典型用途 / 语义说明 |
|---|---|---|---|---|
s[a:b] |
用户指定 a | 用户指定 b | 自左向右 (+1) | 截取索引区间 [a, b) 内的连续子串 |
s[:b] |
0 (首字符) | 用户指定 b | 自左向右 (+1) | 截取前 b 个字符(前缀提取) |
s[a:] |
用户指定 a | len(s) (末尾) | 自左向右 (+1) | 从第 a 位开始截取至末尾(去除前缀) |
s[::2] |
0 | len(s) | 自左向右 (+2) | 隔位取样,提取所有偶数索引字符 |
s[::-1] |
-1 (末尾字符) | 首字符左侧边界 | 自右向左 (-1) | 将整个字符串进行完全逆序反转 |
s[:-1] |
0 | -1 (排除末尾) | 自左向右 (+1) | 去除字符串最后一个字符(常用于剔除末尾换行符) |
总的来说,Python 的切片语法设计兼顾了简洁性与安全性。只要牢记“左闭右开确定区间、step 符号决定方向、缺省值按方向自动填充”这三大铁律,无论是面对复杂的多段文本解析还是逆序变换,你都能写出直观、优雅且高容错的代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















