


真人驱动vs文本驱动:AI数字人制作该选哪种方案
面对AI数字人制作,是选择高保真的真人动作捕捉,还是便捷的文本驱动生成?本文从设备门槛、表现力上限和适用场景三个维度拆解两种技术路线,帮你根据实际需求做出最具性价比的选择,避免在不需要高精度的场景下过度投入硬件成本。
刚接触AI数字人时,最让人头大的往往不是“怎么让脸动起来”,而是“到底该怎么让它动”。你是打算坐在摄像头前,挤眉弄眼地实时表演,还是只想敲几行字,就让数字人自动播报新闻?这两种路径——真人驱动和文本驱动,看起来都能出片,但背后的工作流和最终效果简直是两个世界。
很多新手容易陷入一个误区:觉得只要买了昂贵的动捕设备,做出来的数字人就一定高级。其实,如果你的应用场景只是做个口播短视频,真人驱动带来的额外肢体细节可能完全是资源浪费;反之,如果你要做一场需要强互动的直播,纯文本驱动那种略显僵硬的点头摇头,又会让观众瞬间出戏。
真人驱动:拼的是设备精度和表演功底
真人驱动的核心逻辑很直接:你做什么,数字人就做什么。这需要一套能够实时捕捉你面部表情、头部姿态甚至全身动作的系统。
这种方案的上限极高。因为人类的面部肌肉运动极其复杂,微表情的传递往往比语言本身更有感染力。当你皱眉、挑眉或嘴角微微抽动时,高精度摄像头或专业动捕服能将这些细微变化映射到数字人模型上,产生一种“这就是真人”的错觉。
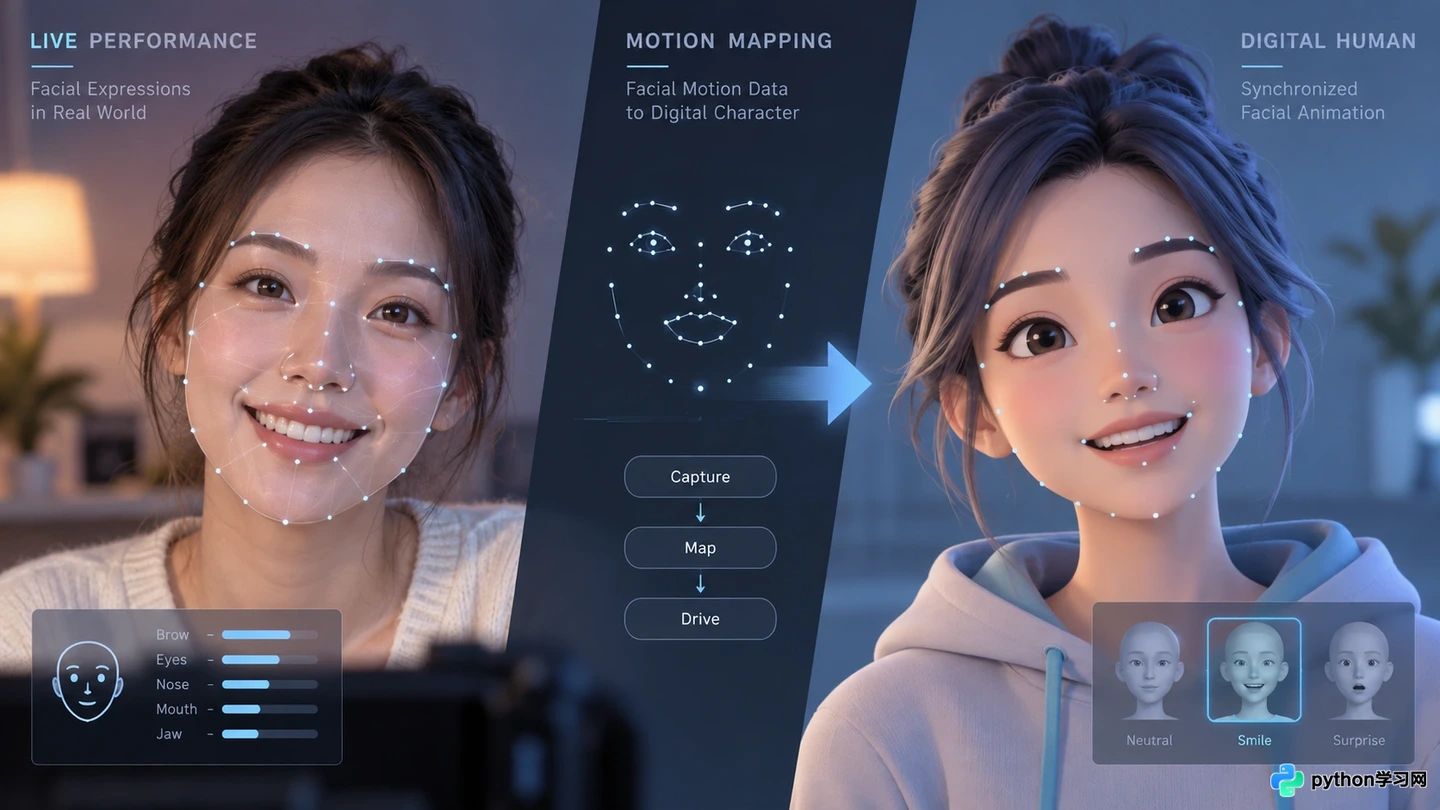
真人驱动依赖高精度摄像头捕捉面部关键点,实时映射到数字人模型
但代价也不小。首先你得有硬件:普通的Webcam只能捕捉大概的头颈转动和基础口型,想要精细的眼球追踪和手指动作,通常需要深度相机(如Intel RealSense)或光学动捕系统。其次,它对网络和环境光有要求,光线不均会导致面部关键点识别漂移,出现数字人“五官乱飞”的尴尬场面。
更重要的是,它要求操作者具备表演能力。数字人不会自己加戏,如果你对着镜头面无表情地念稿,生成的视频也会显得呆板。适合需要强互动、高情感浓度的场景,比如虚拟主播直播、在线一对一教学或高端品牌发布会。
文本驱动:胜在标准化和低成本量产
文本驱动则是另一套逻辑:输入文字,AI算法根据语义和情感标签,自动生成对应的口型、眨眼频率和头部摆动。
这是目前大多数企业级数字人服务的主流方案。你不需要摄像头,不需要打光,甚至不需要露脸。只要在后台输入文案,选择好音色和情感模式(如“开心”、“严肃”),系统就会渲染出一段视频。
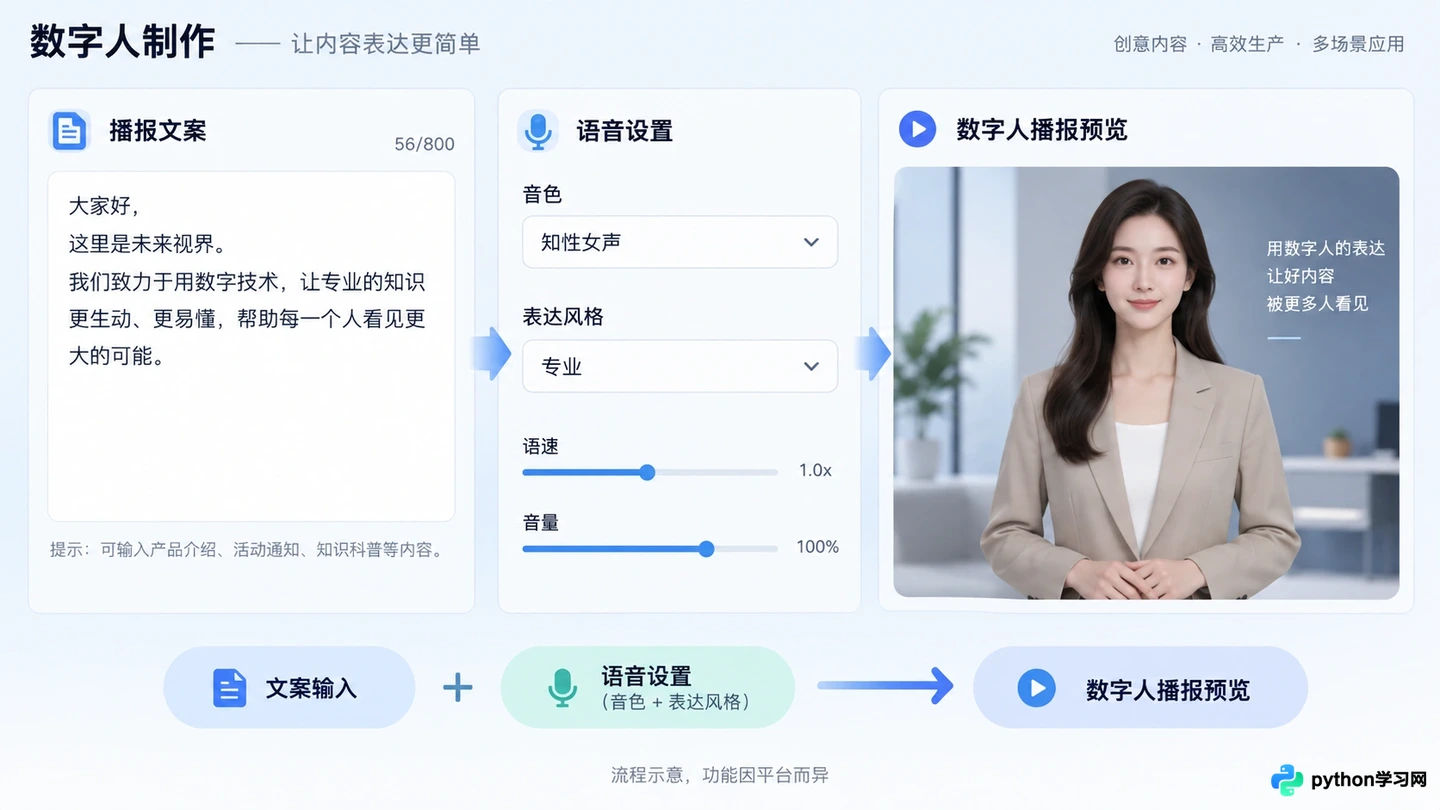
文本驱动只需输入文案和选择音色,即可自动生成口型和动作
它的优势在于极致的效率和一致性。无论凌晨三点还是下午两点,数字人的状态永远稳定,不会出现嗓子哑了或者状态不佳的情况。对于需要大规模生产内容的场景,比如每日新闻播报、产品说明书讲解、多语言客服视频,文本驱动是无可替代的。
不过,短板也很明显。目前的AI虽然能模拟自然的呼吸感和轻微晃动,但在处理复杂情绪转换时,仍显得略微机械。比如从“愤怒”突然转到“悲伤”,中间的表情过渡可能不够细腻,眼神交流感也弱于真人驱动。此外,长段落的口型同步偶尔会出现偏差,需要后期人工微调。
关键决策点:看互动需求而非预算
怎么选?别只看预算,先看你的核心需求是什么。
如果你追求的是“效率”和“规模”,比如要为一百种不同语言的产品制作介绍视频,或者需要一个24小时在线的银行大堂经理,文本驱动是唯一可行的选择。它把制作门槛降到了最低,只要有文案就能出片,且修改成本极低,改个字重新渲染即可。
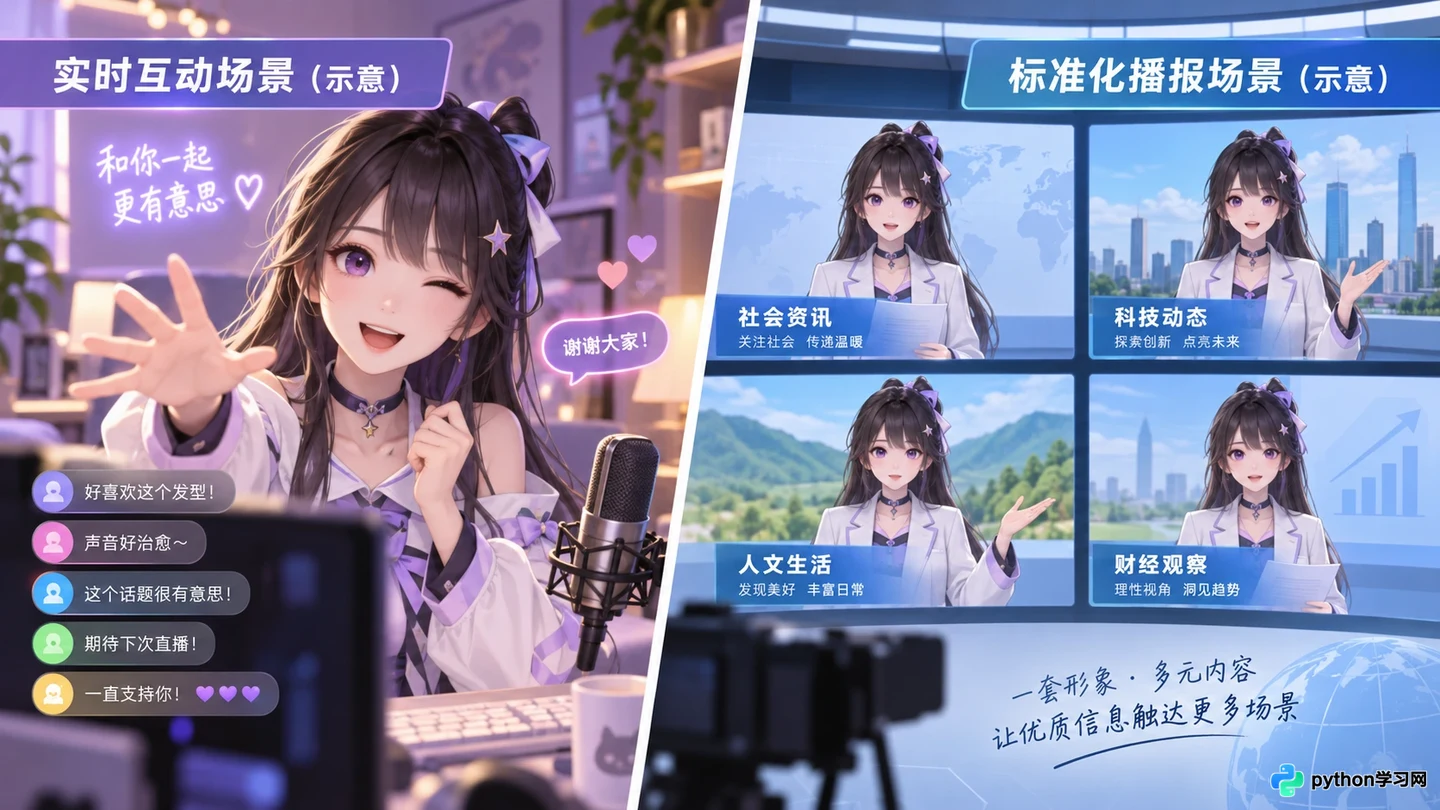
左侧为高频互动的直播场景,右侧为批量生产的资讯播报场景
如果你追求的是“连接感”和“个性化”,比如打造一个有鲜明性格的虚拟偶像,或者进行需要即时反馈的情感陪伴聊天,那么真人驱动带来的真实感是文本无法比拟的。观众能感知到屏幕背后那个“人”的情绪波动,这种信任感的建立是商业转化的关键。
还有一种折中方案值得关注:混合驱动。即在文本驱动的基础上,允许操作员通过简单的键盘快捷键或鼠标拖拽,干预数字人的关键动作(如挥手、点头、指向特定区域)。这在一定程度上弥补了文本驱动的僵硬,同时保留了无需全身动捕设备的便利性。
避坑指南:不要为了技术而技术
最后给个实在的建议:在决定方案前,先拿你的手机拍一段自己念稿的视频,再找一个主流的文本驱动平台生成同一段内容的视频。
对比两者,问自己一个问题:我的目标受众,真的在意那一点点微表情的差异吗?如果答案是“不在意,他们只想知道产品信息”,那就果断选择文本驱动,把省下的硬件钱投入到文案优化和分发渠道上。如果答案是“他们在意,因为他们买的是情感寄托”,那你才需要考虑搭建一套专业的真人驱动工作流。
技术只是工具,适合的场景才是王道。别让昂贵的动捕设备吃灰,也别让僵硬的文本视频劝退用户,找准定位,才能做出真正有用的数字人。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















