


Python对比Java和C++:流行背后的权衡与选择
深入对比Python、Java和C++在执行模型、类型系统、内存管理与生态体系上的核心权衡,为工程实践提供清晰务实的语言选型依据。
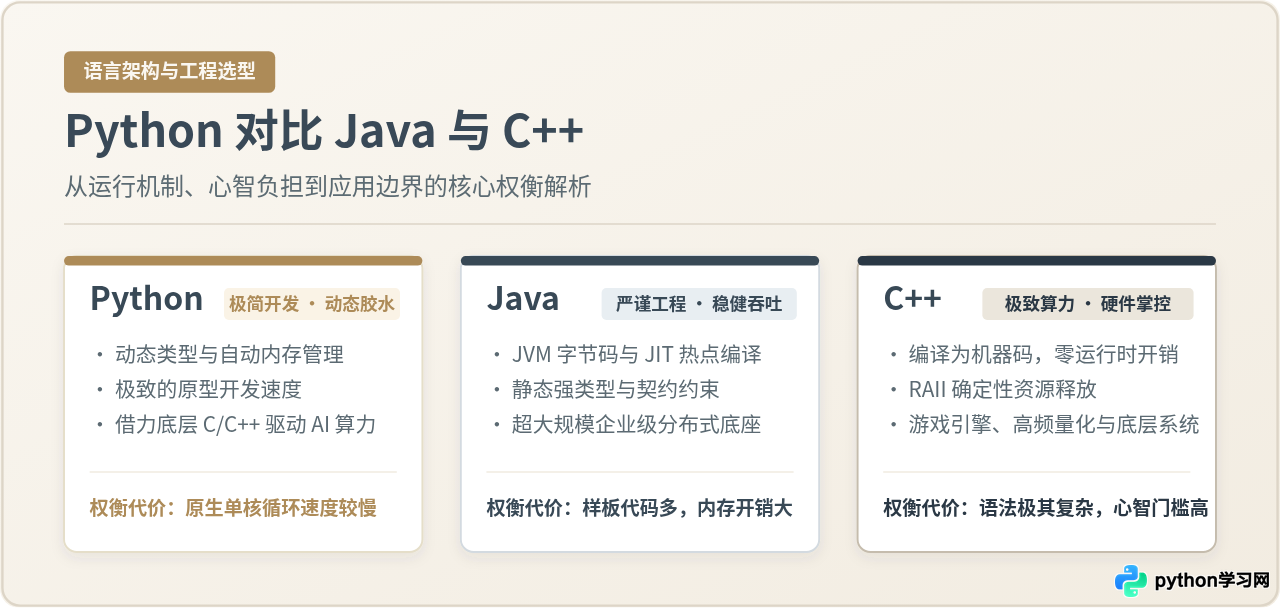
图 0:Python、Java 与 C++ 的定位与核心工程特质概览
一、底层执行模型:机器开销与开发敏捷的根本分水岭
理解这三门语言的本质差异,必须从它们的底层执行流程谈起。源码如何被计算机硬件理解并执行,直接决定了程序执行的延迟下限、内存基础占用以及多核利用率。
Python 的动态解释路径:标准实现 CPython 将 .py 脚本编译为平台中立的字节码,随后由虚拟机(PVM)的主循环逐条解释执行。由于缺乏编译期类型信息,每一次属性查找、运算符调用都会触发动态字典查询和类型拆装箱。更关键的是,CPython 内部依赖全局解释器锁(GIL)来保护内存引用计数的线程安全,导致原生 Python 多线程无法利用多核 CPU 进行并行纯计算。
Java 的 JIT 渐进优化路径:Java 源码通过 javac 编译为 .class 字节码。JVM(如 HotSpot)在启动时使用解释器快速运行,同时内置的热点探测器实时统计代码调用频次。一旦识别出热点方法,C1/C2 JIT 编译器会将其动态编译并深度优化为本地机器码。结合现代分代式垃圾回收算法(G1、ZGC),Java 兼顾了“一次编写到处运行”的跨平台便利性与接近本地编译的运行吞吐。
C++ 的直接机器码路径:C++ 遵循经典的“源文件 → 预处理 → 编译优化 → 汇编 → 链接”流程。编译器(GCC、Clang)将抽象语法树彻底降解为对应硬件架构的底层汇编与 ELF/PE 二进制文件。没有虚拟机层、没有运行时解释开销、没有垃圾回收停顿,所有内存与硬件寄存器均受程序员精确控制,换取的是确定性的微秒级延迟响应。
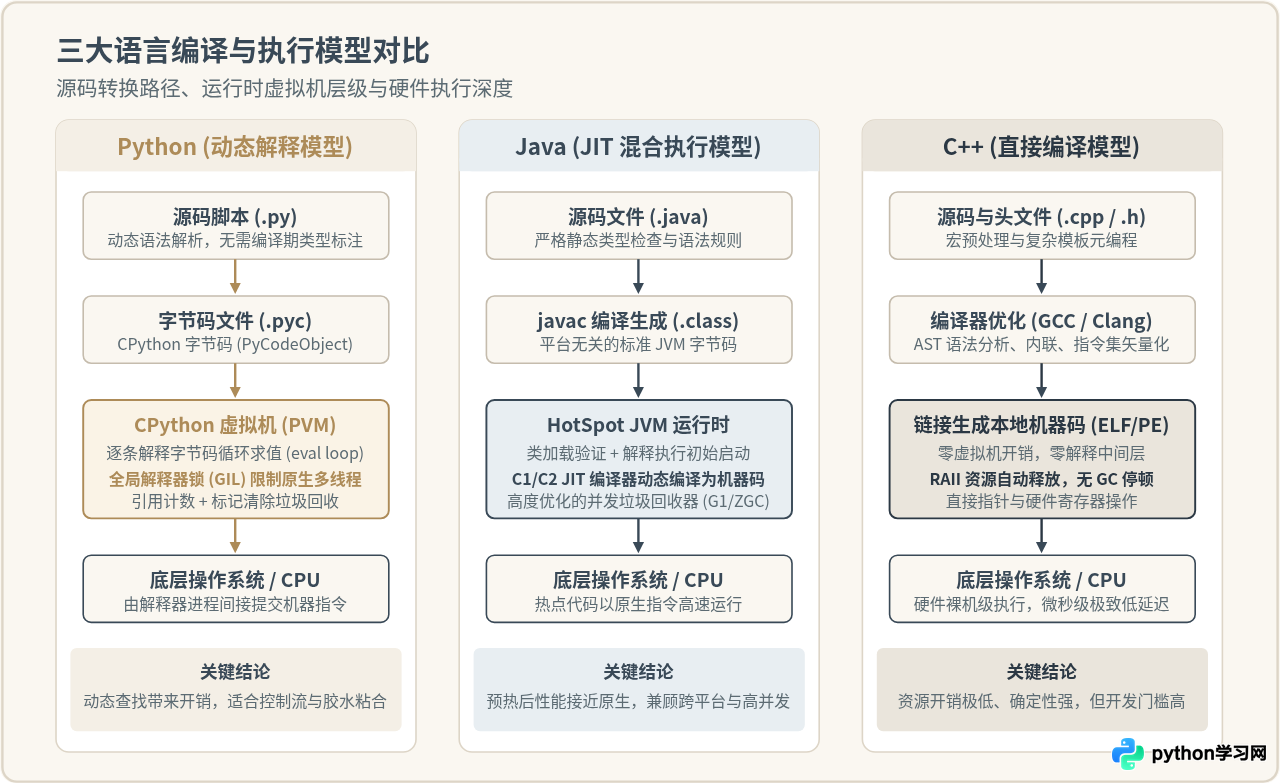
图 1:三大语言编译与执行模型对比
许多初学者误以为 Python 完全无法并发。需要澄清的是:GIL 仅限制 Python 字节码在多线程下的并行 CPU 计算。对于以网络 I/O 为主的 Web 应用或爬虫,asyncio 协程足以提供高并发吞吐;而在高性能科学计算中,调用底层 C/C++ 模块时会自动释放 GIL,多核利用由底层算子负责。
二、类型系统与心智负担:静态防御与动态敏捷的取舍
编程语言的类型系统决定了开发人员在编码时的大脑负荷,也决定了错误被暴露的时间节点。究竟是在编译期将类型错误扼杀在摇篮,还是在运行期保持最大灵活性,是 Python 与 Java、C++ 的第二大分歧。
为了直观展现三者在语法表达和类型契约上的差异,我们以一段典型的业务逻辑为例:给定一组交易金额,过滤出大于 100 的有效记录,计算其含税价格并汇总求和。
1. Python:极简的函数式推导
# Python 3 示例:列表推导与动态求和
def calculate_total_tax(amounts: list[float], tax_rate: float = 0.08) -> float:
    return sum(amount * (1.0 + tax_rate) for amount in amounts if amount > 100.0)

# 测试数据
transactions = [45.0, 120.0, 85.5, 300.0, 95.0]
total = calculate_total_tax(transactions)
print(f"Total: {total:.2f}")  # 示例输出: Total: 453.60
Python 的代码量极短,开发心智完全聚焦于算法逻辑本身。虽然引入了类型提示(Type Hints),但解释器在运行时默认不强制校验,灵活度极高,适合单兵作战或快速验证概念。
2. Java:强类型契约与流式处理
// Java 17+ 示例:强类型接口与 Stream API
import java.util.List;

public class TransactionCalculator {
    private static final double DEFAULT_TAX_RATE = 0.08;

    public static double calculateTotalTax(List<Double> amounts, double taxRate) {
        if (amounts == null) {
            throw new IllegalArgumentException("Amounts cannot be null");
        }
        return amounts.stream()
            .filter(amount -> amount != null && amount > 100.0)
            .mapToDouble(amount -> amount * (1.0 + taxRate))
            .sum();
    }

    public static void main(String[] args) {
        List<Double> transactions = List.of(45.0, 120.0, 85.5, 300.0, 95.0);
        double total = calculateTotalTax(transactions, DEFAULT_TAX_RATE);
        System.out.printf("Total: %.2f%n", total); // 示例输出: Total: 453.60
    }
}
Java 要求清晰的类边界、显式的空值防范与类型签名。虽然样板代码较多,但在大型团队中,任何成员修改接口时,IDE 与编译器能即时给出所有受影响调用的静态报错,大幅降低多人协作时的重构风险。
3. C++:零成本抽象与确定性管理
// C++20 示例:标准算法与确定性内存控制
#include <iostream>
#include <vector>
#include <numeric>
#include <iomanip>

double calculate_total_tax(const std::vector<double>& amounts, double tax_rate = 0.08) {
    return std::accumulate(amounts.begin(), amounts.end(), 0.0,
        [tax_rate](double acc, double val) {
            return val > 100.0 ? acc + val * (1.0 + tax_rate) : acc;
        });
}

int main() {
    const std::vector<double> transactions = {45.0, 120.0, 85.5, 300.0, 95.0};
    double total = calculate_total_tax(transactions);
    std::cout << std::fixed << std::setprecision(2) << "Total: " << total << std::endl;
    return 0; // 示例输出: Total: 453.60
}
C++ 提供了极深的可控性,包括值传递或常量引用传递、内存连续存储的向量容器,以及可直接内联优化的 Lambda 算子。但开发者必须时刻注意对象生命周期、指针有效性与内存所有权,稍有不慎便可能引入未定义行为(Undefined Behavior)。
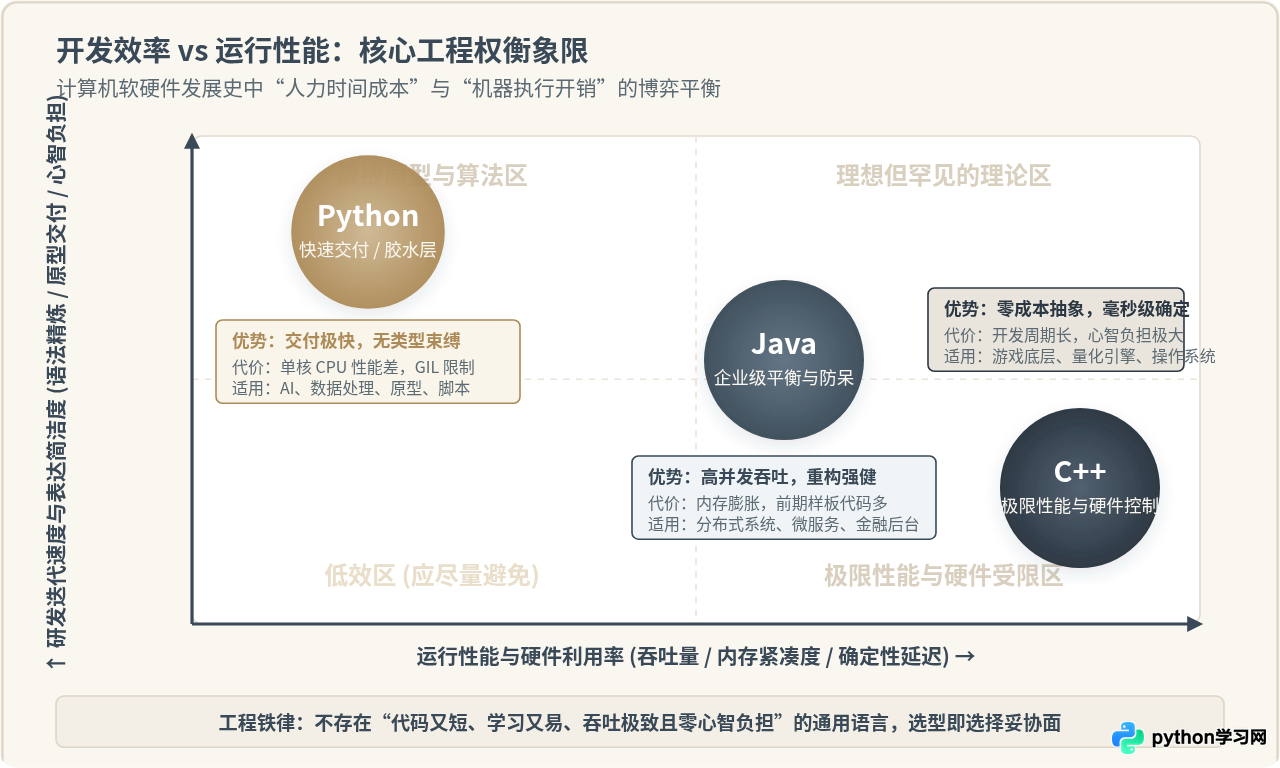
图 2:开发效率 vs 运行性能 二维权衡象限
三、核心谜题:Python 为什么能在性能劣势下主导 AI 领域?
一个经常被提及的技术悖论是:Python 的原生循环执行速度通常比 C++ 慢几十倍甚至上百倍,为什么它反而在计算密集度最高的深度学习与人工智能领域占据了统治地位?
答案在于现代计算系统的分层架构创新:把计算密集型任务下沉,把交互控制型逻辑上浮。
在 AI 系统中,程序的时间开销呈现极端的“二八定律”——甚至“一九九定律”。开发者编写的代码大多用于:定义神经网络拓扑、读取训练配置、划分数据集 batch、调用优化器接口。这些编排逻辑占用了开发者 90% 的编写时间,但在运行时仅消耗不到 1% 的机器时钟周期。真正的算力黑洞在于数以亿计的浮点张量矩阵乘加运算(GEMM)。
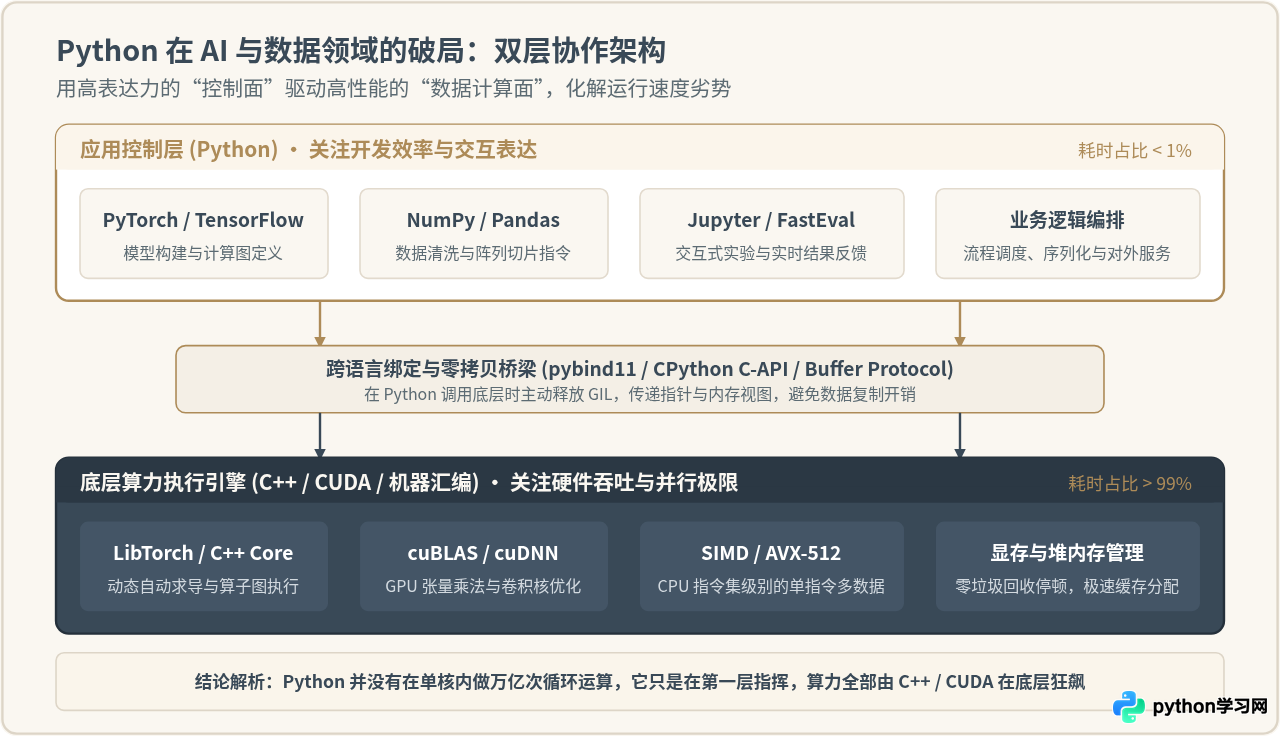
图 3:AI与科学计算技术栈中 Python 与 C++ 的双层协作分工机制
主流深度学习框架(如 PyTorch、TensorFlow)的底层核心引擎全部由 C++ 和 CUDA 编写,利用硬件厂商深度优化的算子库(如 NVIDIA cuBLAS、Intel MKL)。Python 通过 pybind11、C-API 以及内存缓冲区协议(Buffer Protocol)与底层 C++ 共享内存地址,数据传递零拷贝。在执行实际计算时,底层代码会主动释放 GIL,直接压榨 GPU 的数万个并行流处理器。
这种架构赋予了 Python 独特的定位:它不是计算的执行者,而是顶级的“控制面板”。研究员只需用优雅的 Python 语法描述算法思想,而性能损耗几乎被完全掩盖在底层的 C++ 算力风暴之下。
四、工程技术选型决策路径
脱离具体业务约束谈论语言优劣毫无意义。在实际工程项目中,选型应当基于系统延迟容忍度、团队组织形态、长期维护成本与业务迭代诉求来逐步收敛判断。
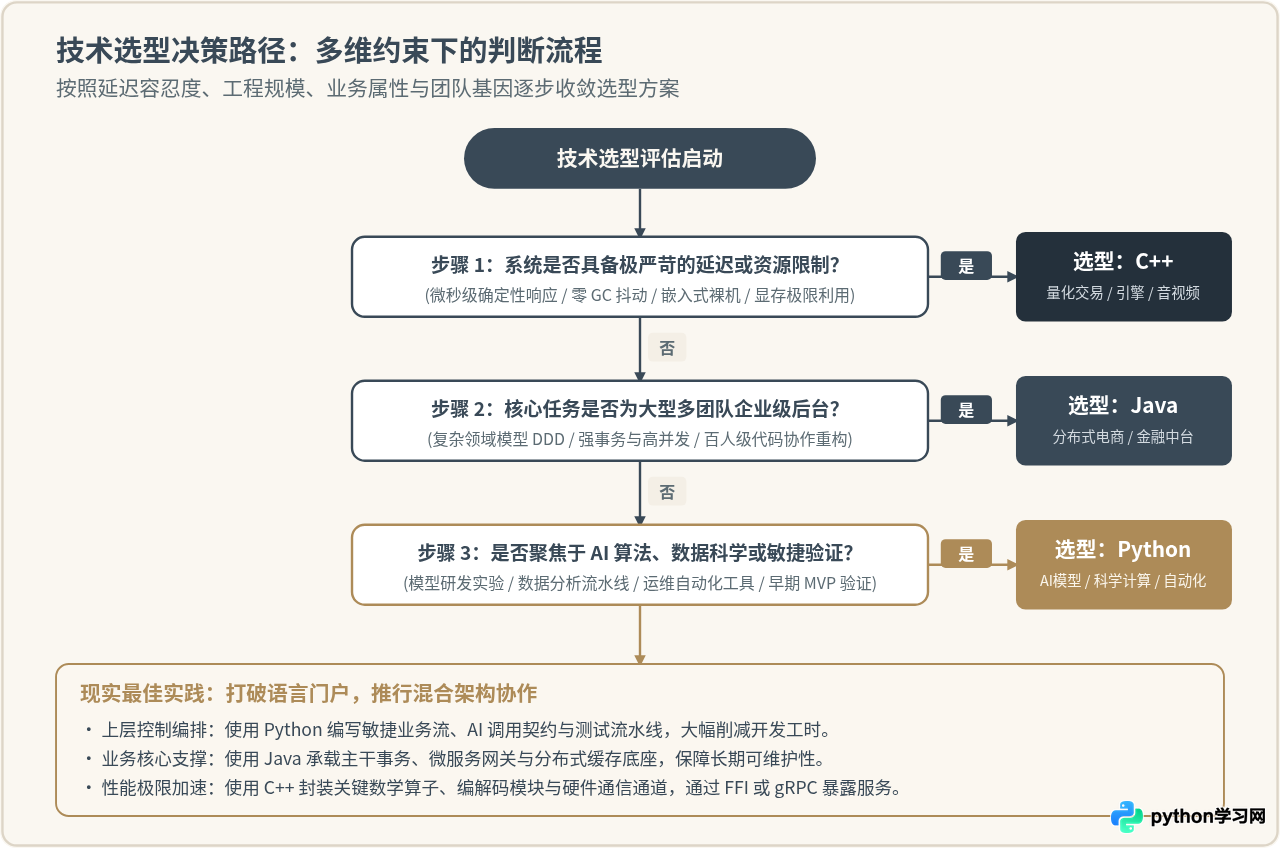
图 4:技术选型多维度决策树与逻辑路径流程图
选型判断的四个关键维度:
- 硬件与延迟边界(优先判定 C++):若系统运行在内存仅有数十兆的嵌入式设备上,或业务要求响应延迟必须在亚毫秒甚至微秒级别(如高频量化交易撮合引擎、第一人称射击游戏物理引擎、自动驾驶感知模块),无法容忍任何垃圾回收引起的 STW(Stop-The-World)停顿,C++ 是不可替代的严肃选择。
- 团队协作与企业级吞吐(优先判定 Java):若系统服务于复杂的企业级业务,涉及上百个微服务解耦、海量日常并发事务,且开发团队规模在数十人以上,Java 严苛的接口契约、成熟的 Spring/Dubbo 生态、强大的 APM 监控诊断工具链(Arthas、JProfiler)能提供极高的大规模可维护性与故障兜底能力。
- 实验探索与数据算力编排(优先判定 Python):若业务目标是构建数据管道、训练机器学习模型、验证新产品的核心原型(MVP),或者开发自动化测试与云原生运维脚手架,Python 能以最低的开发工时交付可用成果,抢占市场先机。
- 现代工程的复合形态:成熟的技术架构往往不是单一语言的单打独斗,而是“Python 控制与算法研究 + Java 业务分布式中台 + C++ 底层计算/流媒体算子”的有机组合。通过 gRPC、共享内存或 RESTful API 进行服务边界隔离,能够最大化释放各语言的比较优势。
五、全维度技术指标对照总结
为了让不同背景的工程师与技术管理者能够系统化评估决策,下表汇总了三门语言在核心工程维度上的横向对比:
| 对比维度 | Python (CPython) | Java (HotSpot JVM) | C++ (Modern C++17/20) |
|---|---|---|---|
| 核心执行机制 | 字节码解释执行 (含 GIL 限制) | 字节码 + 运行时 JIT 动态编译 | 直接编译为本地硬件机器码 |
| 纯 CPU 计算性能 | 较低 (依靠底层 C 扩展弥补) | 高 (长时间热点预热后接近原生) | 极高 (硬件指令集极致优化) |
| 内存开销与管理 | 开销大,引用计数 + 分代 GC | 对象头与元数据开销大,高级 GC | 极低且紧凑,RAII 确定性析构 |
| 类型检查与安全性 | 动态强类型 (运行期报错) | 静态强类型 (编译期强制校验) | 静态多范式 (编译期严谨检查) |
| 多核并行并发 | GIL 限制多线程,侧重多进程/协程 | 多线程支持完备,虚拟线程 (Loom) | 原生操作系统线程,细粒度锁/无锁 |
| 代码研发与交付周期 | 极快 (简洁精炼,心智负担低) | 中等 (结构规范,工具链完备) | 较慢 (语法复杂,心智门槛高) |
| 主导生态领域 | 人工智能、数据分析、脚本自动化 | 企业级微服务、金融后台、大数据平台 | 系统底层、游戏引擎、高频交易、嵌入式 |
编程语言的流行趋势不是一场零和博弈。Python 的流行证明了“开发人员的脑力时间比廉价的服务器算力更加昂贵”这一工业现实;Java 的长盛不衰证明了大规模软件工程对“规范、约束与稳定防御”的深刻依赖;而 C++ 的不可撼动则证明了人类对“极限性能、物理现实与底层控制”的终极追求。明晰三者的权衡,才能在瞬息万变的技术浪潮中做出清醒而长远的架构抉择。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















