


Python使用scipy.stats计算t检验统计量与p值
本文详细讲解如何在Python中使用scipy.stats模块进行单样本、独立双样本以及配对样本t检验,计算t统计量与p值,并深入解析计算原理、参数设置与结果判定。
scipy.stats 提供了封装完备的计算接口,核心包括单样本检验 ttest_1samp、独立双样本检验 ttest_ind 以及配对样本检验 ttest_rel。调用这些函数可一步直接返回 t 统计量 (Statistic) 和 显著性 p 值 (p-value),帮助我们在设定的显著性水平下完成量化推断。
一、t 检验的核心目标与函数选型决策
假设你正在对比一个算法优化前后系统的响应耗时,或者分析 A/B 测试中新老两个版本界面的用户平均购买金额。直接比对样本平均值并不充分,因为有限的样本总会存在随机波动。t 检验的核心目标,正是计算这种平均值差异相对于样本自身离散程度(标准误)的比值,进而求出在“两组其实没有差异”这一原假设(H₀)成立的前提下,观察到当前或更极端差异的概率,即 p 值。
在编写 Python 代码前,首要任务是根据实验设计和数据采集方式选择正确的函数。如果选错了检验方法,即使运行无报错,输出的 p 值也会失去统计学意义:
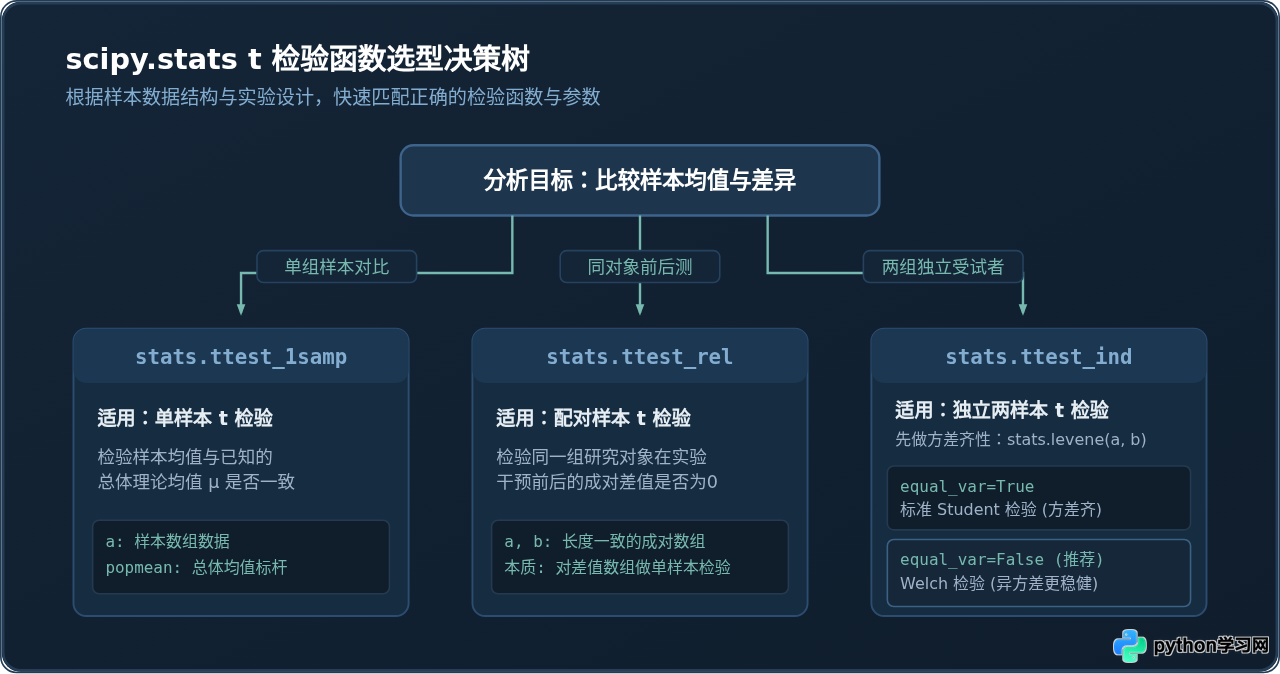
- 单样本 t 检验 (
ttest_1samp):仅有一组样本数据,目标是检验该组均值是否与某一个已知的理论期望值(如工业标准标杆值)存在显著偏离。 - 独立双样本 t 检验 (
ttest_ind):比较两个完全独立、互不干扰的受试群体(例如 A 组用户与 B 组用户)。此时需要注意方差齐性问题,默认为等方差假设,但实践中更推荐设置equal_var=False采用 Welch's t 检验。 - 配对样本 t 检验 (
ttest_rel):两个样本数据来自于同一组受试对象在不同状态下的成对测定(例如同一批受试者用药前与用药后的指标对比)。其本质是对成对差值做单样本 t 检验。
二、Python 调用 scipy.stats 的完整执行流程
完成一次规范的 t 检验不仅仅是调用一行函数,它包含数据组织、前提检验、方向设定和结果对象解析四个环节。
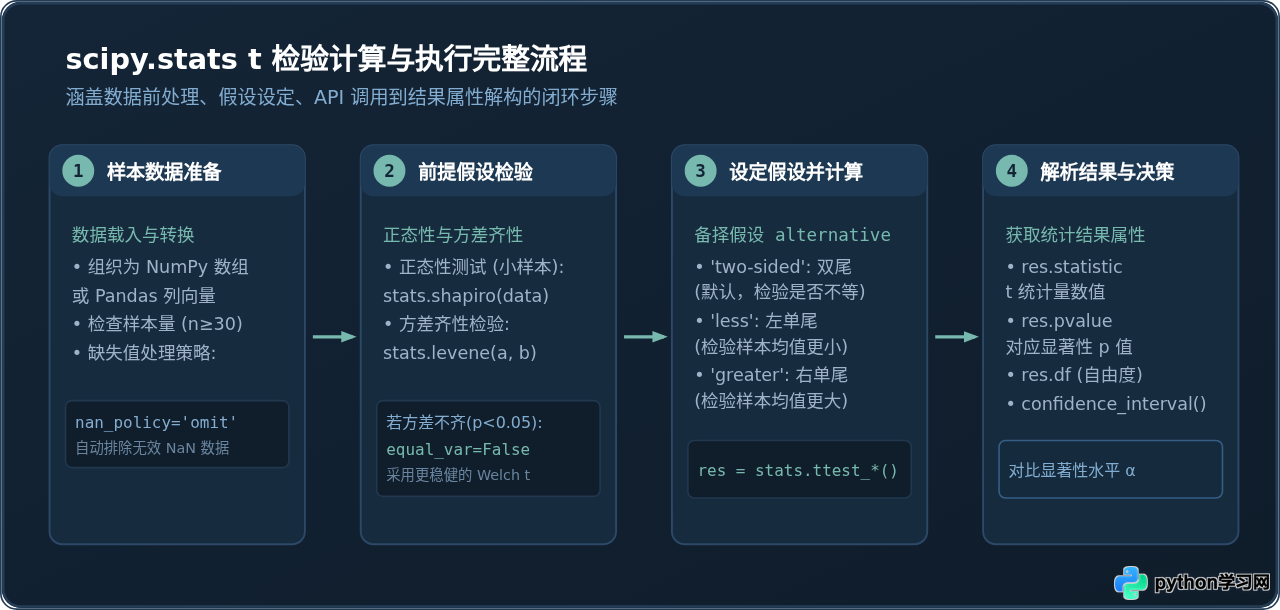
1. 环境准备与数据清洗
在开始之前,确保环境中已安装 numpy 和 scipy。如果原始数据中可能夹带无效测量值(例如 np.nan),可以通过指定参数 nan_policy='omit' 直接在函数内部忽略空值,避免其传递污染整个计算过程:
import numpy as np
from scipy import stats

# 统一固定随机种子以保证演示可复现
np.random.seed(42)
三、三种典型场景的代码实现与结果解析
场景 1:单样本 t 检验 (stats.ttest_1samp)
假设某零件出厂设定的标准长度为 50.0 毫米。质检部门从生产线随机抽取了 20 个成品进行精密测量,需要检验当前批次均值是否符合出厂标准。
# 假设零件出厂标准值为 50.0mm,抽取20个样本
sample_parts = np.array([
    50.2, 49.8, 50.5, 50.3, 50.1, 49.9, 50.4, 50.6, 50.2, 50.0,
    50.3, 49.7, 50.5, 50.2, 50.4, 50.1, 50.3, 49.9, 50.4, 50.2
])

target_mean = 50.0

# 计算单样本 t 检验:alternative 默认为 'two-sided'
res_1samp = stats.ttest_1samp(sample_parts, popmean=target_mean)

print(f"样本均值: {sample_parts.mean():.4f}")
print(f"t 统计量: {res_1samp.statistic:.4f}")
print(f"p 值:     {res_1samp.pvalue:.4e}")
print(f"自由度: {res_1samp.df}")t 统计量: 4.1378
p 值: 5.4851e-04
自由度: 19
解读:样本均值为 50.22 毫米。计算得到的 t 统计量为 4.1378,对应的 p 值为 0.00055,远小于常见的显著性水平 α = 0.05。这意味着在原假设“该批零件平均长度等于 50.0 毫米”的前提下,出现当前这种偏差的概率只有万分之五左右,因此我们拒绝原假设,认为当前批次零件尺寸存在显著系统性偏大。
场景 2:独立两样本 t 检验 (stats.ttest_ind)
在网络产品 A/B 测试中,两组相互独立的用户分别使用现有页面(Control 组)与实验页面(Treatment 组),记录其停留时长(秒)。
# 生成两组相互独立的用户停留时长数据
group_control = np.random.normal(loc=24.5, scale=4.0, size=35)
group_treatment = np.random.normal(loc=27.0, scale=5.5, size=35)

# 步骤 A:检验两组样本方差是否齐性
levene_stat, levene_p = stats.levene(group_control, group_treatment)
print(f"Levene 方差齐性检验 p 值: {levene_p:.4f}")

# 步骤 B:执行独立样本 t 检验
# 强烈建议显式设定 equal_var=False (Welch's t-test),在方差不齐时依然可靠
res_ind = stats.ttest_ind(group_control, group_treatment, equal_var=False)

print(f"Control 均值:   {group_control.mean():.4f}")
print(f"Treatment 均值: {group_treatment.mean():.4f}")
print(f"t 统计量:       {res_ind.statistic:.4f}")
print(f"p 值: {res_ind.pvalue:.4f}")Control 均值: 24.2384
Treatment 均值: 26.9745
t 统计量: -2.4364
p 值: 0.0177
equal_var=True 容易导致第一类错误率膨胀。而基于 Satterthwaite 近似自由度的 Welch's t 检验(即 equal_var=False)在方差相等时几乎不损失统计功效,在方差不齐时表现格外稳健,已成为现代统计学界公认的更优默认实践。
场景 3:配对样本 t 检验 (stats.ttest_rel)
同一批 15 名技术学员在参加专项编程训练营之前和之后分别参加了一次相同难度的技能测评,记录前测与后测成绩:
# 同一批学员前测与后测分数
pre_scores = np.array([65, 70, 68, 72, 60, 75, 69, 71, 64, 73, 67, 70, 62, 74, 66])
post_scores = np.array([72, 75, 74, 78, 67, 80, 76, 77, 70, 81, 73, 78, 69, 82, 74])

# 执行配对样本 t 检验
res_rel = stats.ttest_rel(pre_scores, post_scores)

print(f"前测均分: {pre_scores.mean():.2f}, 后测均分: {post_scores.mean():.2f}")
print(f"成对平均提升: {(post_scores - pre_scores).mean():.2f}")
print(f"t 统计量:     {res_rel.statistic:.4f}")
print(f"p 值: {res_rel.pvalue:.4e}")成对平均提升: 6.93
t 统计量: -22.1837
p 值: 1.8214e-12
解读:两组向量的对应元素一一对应,配对消除了学员自身基础能力不同带来的个体间差异,因此拥有极高的统计敏感度。计算结果呈现极高的显著性(p = 1.82e-12),证明培训效果真实可靠。
四、理解 t 统计量与 p 值的统计学原理
为了在分析报告中清晰阐述结论,我们需要透彻理解 t 统计量与 p 值的几何对应关系以及单双尾备择假设的配置方式。
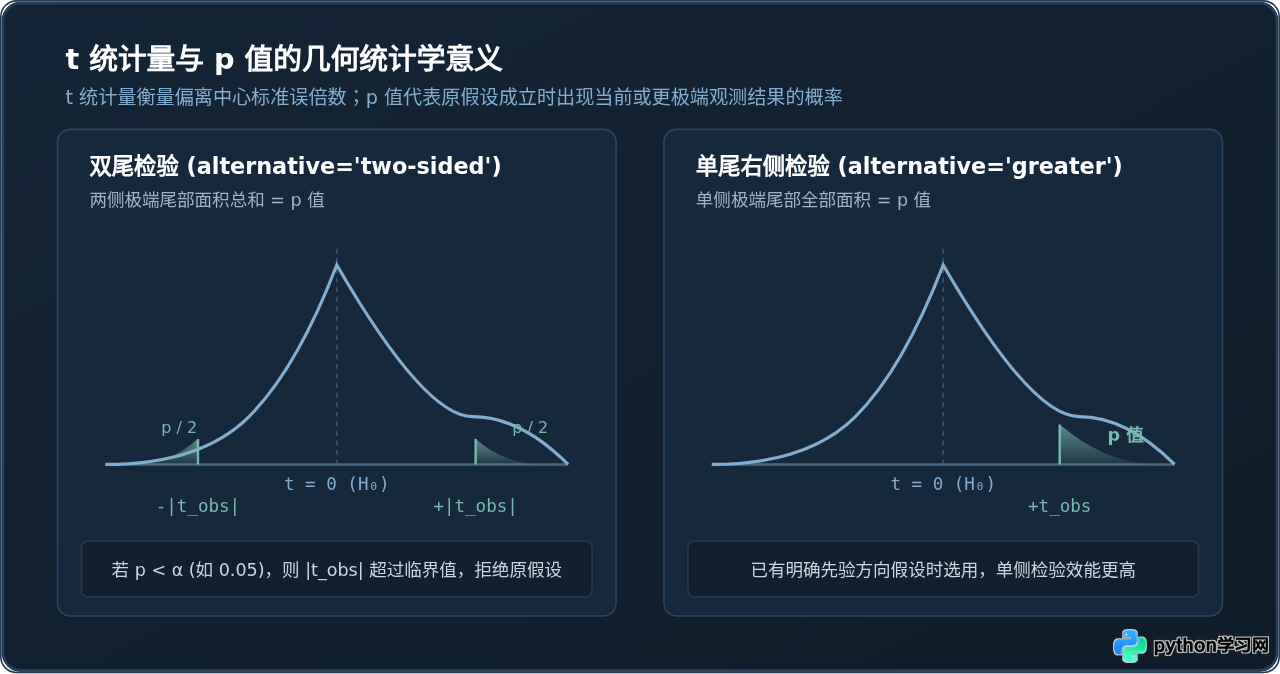
1. t 统计量的物理意义
t 统计量的本质是一个无量纲的“信噪比”:
- 分子(信号):样本观测均值与待对比基准(或两组均值之间)的实际差值。
- 分母(噪声):样本的标准误差(Standard Error, SE = s / √n),反映抽样过程固有的自然波动范围。
若 t = 3.0,说明观测到的均值差异是随机误差的 3 倍。t 统计量的正负号仅代表偏离方向:为正说明样本均值大于基准或第一组均值大于第二组;为负则相反。
2. p 值的计算与单双尾参数 (alternative)
在 SciPy 1.6.0 及以上版本中,上述三个函数均原生支持 alternative 关键字参数,取值含义如下:
alternative='two-sided'(默认):双尾检验。检验原假设 μ₁ = μ₂,备择假设为 μ₁ ≠ μ₂。p 值为两侧尾部绝对值大于等于 |t| 的面积之和。alternative='less':单尾左侧检验。备择假设为第一组均值显著小于第二组(或已知期望)。p 值为左侧尾部小于等于 t 的面积。alternative='greater':单尾右侧检验。备择假设为第一组均值显著大于第二组(或已知期望)。p 值为右侧尾部大于等于 t 的面积。
五、结果解读、效应量与避坑指南
计算出统计量与 p 值之后,不可孤立地根据“p 是否小于 0.05”做出一刀切的商业或科研决策。
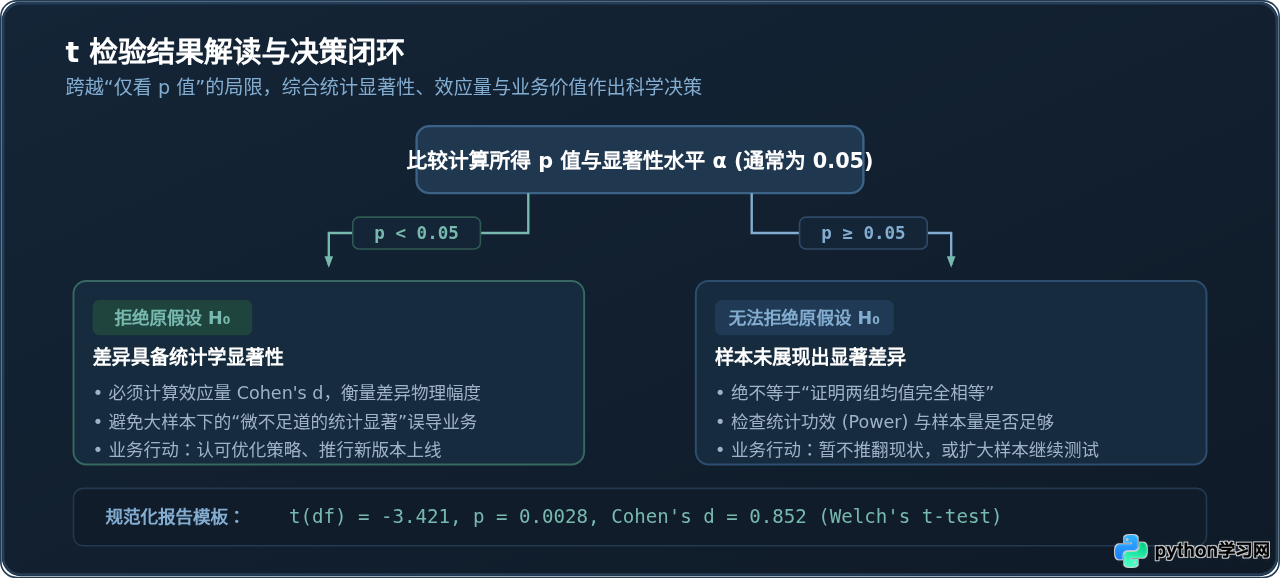
1. 引入效应量 (Cohen's d):区分“统计显著”与“实际业务价值”
在大数据场景下,当样本量 n 达到数万甚至数十万时,微小到毫无实用价值的均值差异(例如页面加载耗时仅相差 0.001 秒)也能轻易跑出极其微小的 p 值(如 p < 0.0001)。为了避免被大样本虚假显著性误导,必须配套计算效应量(Effect Size, Cohen's d):
def calculate_cohens_d(group1, group2):
    # 计算两独立样本的 Cohen's d 效应量
    n1, n2 = len(group1), len(group2)
    s1, s2 = np.var(group1, ddof=1), np.var(group2, ddof=1)
    # 合并标准差
    pooled_std = np.sqrt(((n1 - 1) * s1 + (n2 - 1) * s2) / (n1 + n2 - 2))
    diff = np.mean(group1) - np.mean(group2)
    return diff / pooled_std

d_val = calculate_cohens_d(group_control, group_treatment)
print(f"Cohen's d 效应量: {d_val:.4f}")| Cohen's d 绝对值范围 | 效应强弱级别 | 业务与工程解读 |
|---|---|---|
|d| < 0.20 |
极小效应 (Negligible) | 差异极微弱,即使 p 显著通常也不值得投入工程重构成本。 |
0.20 ≤ |d| < 0.50 |
小效应 (Small) | 差异初步显现,常见于成熟产品细节优化或微调。 |
0.50 ≤ |d| < 0.80 |
中等效应 (Medium) | 差异肉眼可见,具有明确的商业或应用价值。 |
|d| ≥ 0.80 |
大效应 (Large) | 强烈的核心性能提升,极具推广价值。 |
2. 前提假设违背时的应对方案
t 检验建立在样本数据近似服从正态分布的理论前提上。当样本量较小(例如 n < 30)且正态性检验 stats.shapiro(data) 的 p 值显著小于 0.05(严重偏态)时,强行使用 t 检验可能造成误判:
- 独立双样本非正态替代:使用曼-惠特尼 U 检验
stats.mannwhitneyu(group_a, group_b)。 - 配对样本非正态替代:使用威尔科克森符号秩检验
stats.wilcoxon(pre, post)。
六、常用参数与函数速查
| 函数名称 | 关键参数 | 适用场景 | 核心返回值属性 |
|---|---|---|---|
stats.ttest_1samp |
a, popmean, alternative, nan_policy |
单样本与常数目标值对比 | statistic (t值), pvalue (p值), df (自由度) |
stats.ttest_ind |
a, b, equal_var=False, alternative |
两组独立样本均值对比 | statistic, pvalue, confidence_interval() |
stats.ttest_rel |
a, b, alternative, nan_policy |
成对前后测或匹配实验对比 | statistic, pvalue, df |
通过合理结合数据预处理、选用 stats.ttest_* 系列函数、核查单双尾方向并附带计算效应量,即可在 Python 现代数据科学栈中快速、规范地完成 t 检验,得出严谨可靠的分析结论。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















