


Python能做什么?初学者必知的Web开发与数据分析应用

对于刚接触编程的学习者而言,掌握一门语言的语法只是第一步,更关键的是清楚它在实际生产中究竟能解决什么问题。Python 作为一门语法凝练、生态完善的高级语言,其最为成熟且适合初学者的两大落地领域是 Web 后端开发 与 数据分析。本文将针对这两个方向展开具体剖析,梳理其架构模型、常用工具栈、入门开发步骤以及选型方法,帮助你明确接下来的实践目标。
一、Python 技术生态全景概览
Python 具备跨平台的解释型执行机制与丰富的第三方包管理生态。虽然它在自动化运维、网络爬虫、人工智能算法等方向同样表现优异,但在工程应用与商业产品中,需求规模最大、学习路径最清晰的依然是 Web 服务与数据分析处理。
Web 开发解决的是“系统与系统、用户与系统之间的信息流转与服务暴露”;数据分析解决的则是“从杂乱事实中提取信息规律、辅助业务决策”。理解两者的底层支撑关系,能够帮助我们合理分配学习精力。
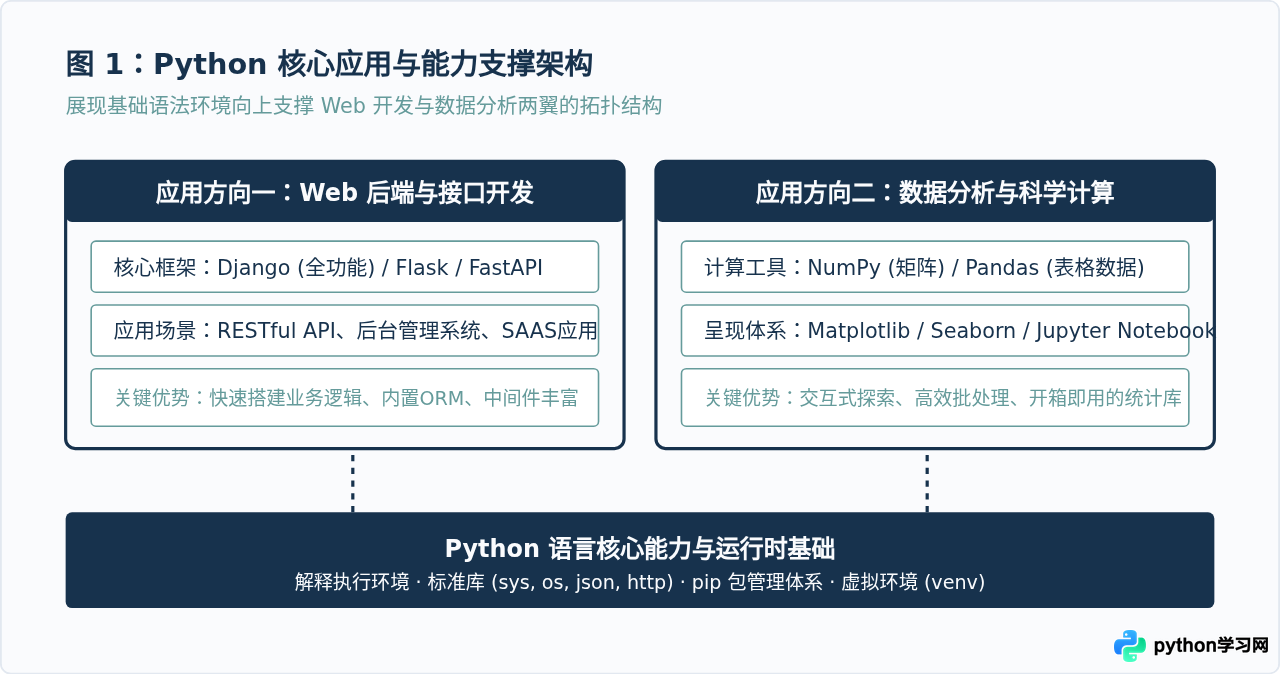
二、Web 开发应用深度拆解
在 Web 工程中,Python 主要承担后端的角色。它负责监听 HTTP 请求,处理用户认证,操作数据库(如 PostgreSQL 或 MySQL),并将组装好的数据以 JSON 格式或 HTML 页面形式返回给客户端浏览器或手机端 App。
1. 主流框架选型策略
- Django:开箱即用的“全栈式”框架,自带对象关系映射(ORM)、管理员后台系统(Django Admin)、密码安全处理和表单验证模块。非常适合需要快速产出完整后台管理或多功能内容站点的团队。
- Flask:极简灵活的微框架(Micro-framework),核心只保留路由与请求处理上下文,其他如数据库连接、权限校验均由开发者自由引入插件。适合组件自选或小型工具服务。
- FastAPI:基于现代 Python 类型提示(Type Hints)构建的高性能异步框架,自带自动化 Swagger API 文档生成,现已成为构建独立接口(Microservices)的热门选择。
2. Web 请求处理的生命周期
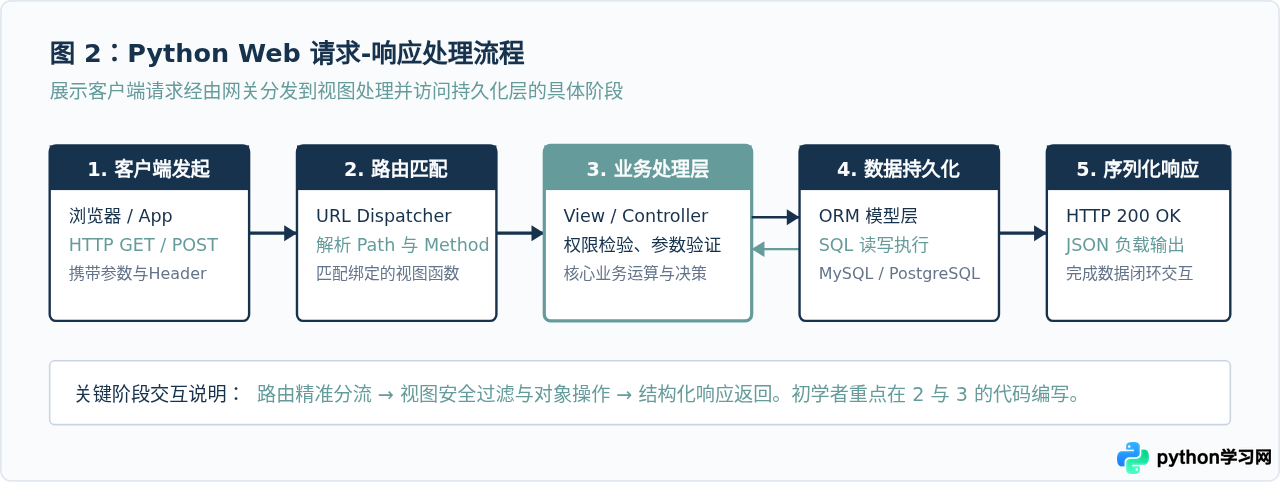
无论使用上述哪款框架,一次典型的 Web 交互都遵循严格的请求分发链路。理解此流程能让你在定位后端逻辑时有的放矢。
3. 极简实战示例:基于 Flask 的 API 接口
以下示例展示如何用不到 20 行代码构建一个标准 JSON 服务。安装依赖只需执行 pip install flask:
# app.py
from flask import Flask, jsonify, request

app = Flask(__name__)

# 模拟数据源
MEMBERS = [
    {"id": 1, "name": "张三", "role": "Developer"},
    {"id": 2, "name": "李四", "role": "Data Analyst"}
]

@app.route('/api/members', methods=['GET'])
def get_members():
    # 处理查询参数,例如按角色过滤
    role = request.args.get('role')
    if role:
        filtered = [m for m in MEMBERS if m['role'].lower() == role.lower()]
        return jsonify({"code": 200, "data": filtered})
    return jsonify({"code": 200, "data": MEMBERS})

if __name__ == '__main__':
    app.run(host='127.0.0.1', port=5000, debug=True)
运行后终端会提示本地服务已启动。在浏览器或 API 客户端访问 http://127.0.0.1:5000/api/members,即可收到结构化数据返回:
// 示例响应结果
{
  "code": 200,
  "data": [
    {"id": 1, "name": "张三", "role": "Developer"},
    {"id": 2, "name": "李四", "role": "Data Analyst"}
  ]
}
三、数据分析应用深度拆解
如果说 Web 开发侧重于“实时交互与事务处理”,数据分析则重在“离线计算、清洗与洞察提炼”。传统 Excel 在处理数十万行以上的数据、或执行复杂统计归并时容易卡顿,而 Python 能够以脚本化的形式实现自动化和批处理。
1. 数据分析核心三剑客
- NumPy:底层基于 C 语言编写的高性能多维数组(ndarray)计算库,提供了向量化与广播运算机制,是几乎所有科学计算库的基石。
- Pandas:初学者最核心的工具。提供
DataFrame(类似于超级内存数据表)对象,可以轻松读取 CSV、Excel、SQL 数据库或 JSON,并完成清洗、空值填充、分组聚合(GroupBy)与透视计算。 - Matplotlib & Seaborn:数据可视化库。将统计后的指标直接转变为折线图、柱状图、散点图或热力图,使规律一目了然。
2. 数据分析标准四步流水线
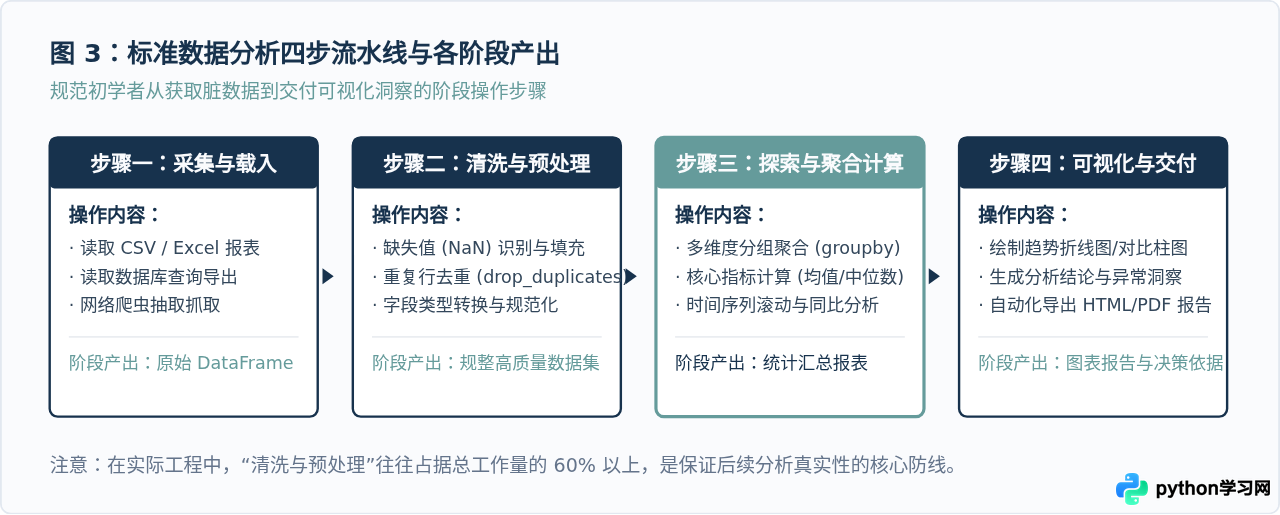
掌握数据分析不需要一上来就钻研深奥的算法,绝大部分实际工作都遵循一个标准化的处理闭环:
3. 极简实战示例:Pandas 销售数据汇总
假设我们有一张每日商品交易表格,需要计算各部门的总销售额及均价。安装依赖执行 pip install pandas:
import pandas as pd

# 1. 模拟原始数据
raw_data = {
    '部门': ['技术部', '运营部', '技术部', '市场部', '运营部'],
    '订单金额': [3200, 1500, 4800, 2100, 1800],
    '商品数量': [2, 3, 4, 1, 2]
}

# 2. 载入为 DataFrame
df = pd.DataFrame(raw_data)

# 3. 计算单品平均价格
df['单件均价'] = df['订单金额'] / df['商品数量']

# 4. 按部门聚合汇总
summary = df.groupby('部门').agg(
    总销售额=('订单金额', 'sum'),
    平均单价=('单件均价', 'mean'),
    订单笔数=('订单金额', 'count')
).reset_index()

print("--- 汇总分析结果 ---")
print(summary)
执行该脚本后,终端直接输出矩阵化整齐的结果:
--- 汇总分析结果 ---
    部门   总销售额     平均单价  订单笔数
0  市场部   2100  2100.00     1
1  技术部   8000  1400.00     2
2  运营部   3300   700.00     2
四、初学者方向选择与落地建议
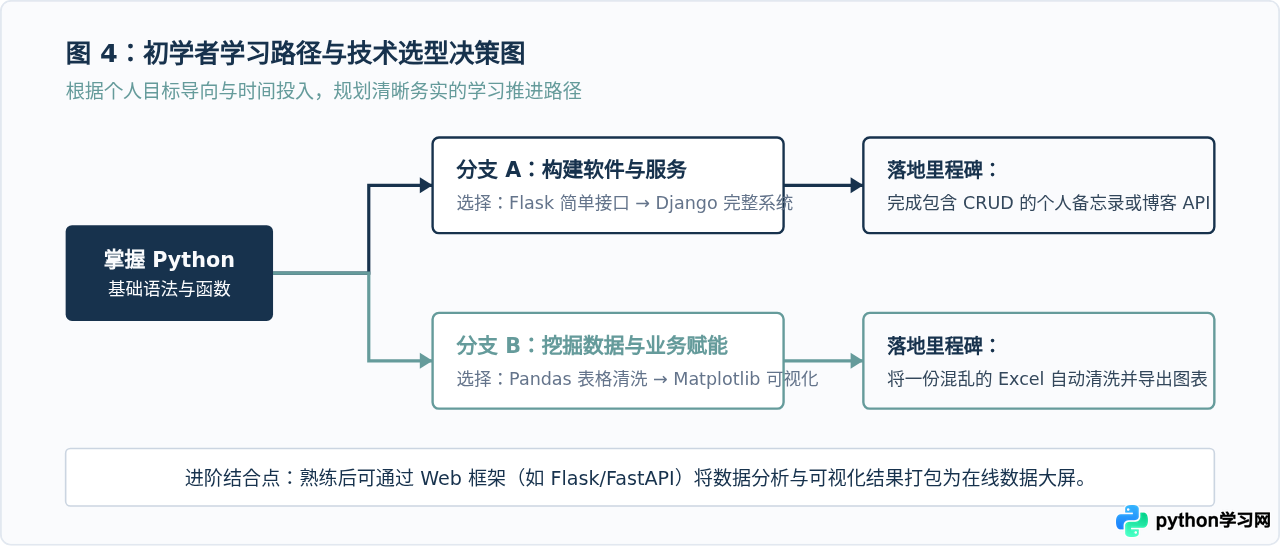
很多初学者会纠结是先学 Web 开发还是先学数据分析。实际上两者并不对立,但侧重点完全不同。下面列出两者的核心维度对照,帮助你根据自身诉求做出选择:
| 对比维度 | Web 开发方向 | 数据分析方向 |
|---|---|---|
| 思维模式 | 工程与系统思维:注重稳定性、并发、接口契约与安全性 | 分析与探索思维:注重指标含义、统计分布、业务洞察与可视化 |
| 前置补充知识 | HTTP 协议、SQL、前后端通信、Linux 基础操作 | 基础统计学指标、Excel 数据处理逻辑、SQL 查询 |
| 产出物形态 | 线上服务、RESTful 接口、管理后台、独立网站 | 分析报告、交互式看板、清洗脚本、商业洞察图表 |
| 推荐切入场景 | 想独立做工具产品、开发个人项目或从事后端研发 | 日常需要高频处理 Excel、做业务数据复盘或从事运营/商业分析 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















