


Python爬虫数据解析库推荐:lxml、json与正则表达式应用
深入对比与解析Python网络爬虫中三大核心数据提取工具:lxml(XPath)、json模块与re正则表达式的适用场景、底层运行机制、实战代码及最佳组合选型策略。
一、爬虫响应格式识别与解析分流链路
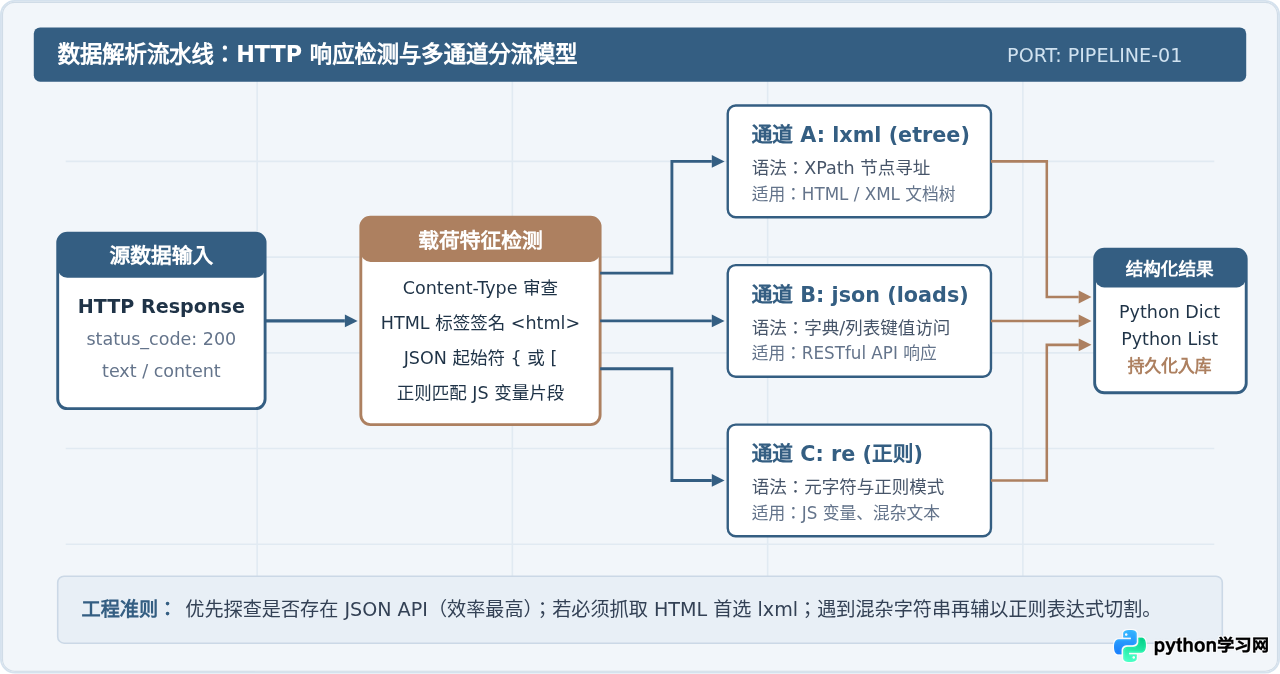
构建高可用爬虫的前提,是建立清晰的响应数据形态判定机制。服务端返回的载荷形态主要分为三类:
- 服务端渲染页面(HTML/XML):包含完整的标签层级树,标签闭合度与书写规范参差不齐。此类内容应交给具备文档树自动补全能力的结构化解析器。
- RESTful / GraphQL 接口载荷(JSON):现代前后端分离网站的主流传输格式。字段结构标准、自解释性强,应走序列化快速反转链路。
- 内嵌数据片段与纯文本(Raw Text / Embedded JS):通常出现在页面模板的
<script>标签内(例如window.__INITIAL_STATE__ = {...}),无法直接通过 DOM 寻址,也不属于纯净 JSON 文件,必须先通过模式匹配进行文本切割。
在实际编写爬虫处理函数时,应根据响应标头(Content-Type)以及响应正文特征进行分流路由,如下图所示:
二、lxml 与 XPath:高性能 HTML 结构化解析
在处理服务端渲染的网页时,lxml 是业界公认的标准解决方案。许多初学者首先接触的是 BeautifulSoup4,但 BS4 本身只是一个高层解析包装器;当底层使用默认的 html.parser 时,解析大体积网页的速度与 C 底层的 lxml 相比往往存在数倍乃至数十倍的差距。
1. 底层机制与 DOM 树构建
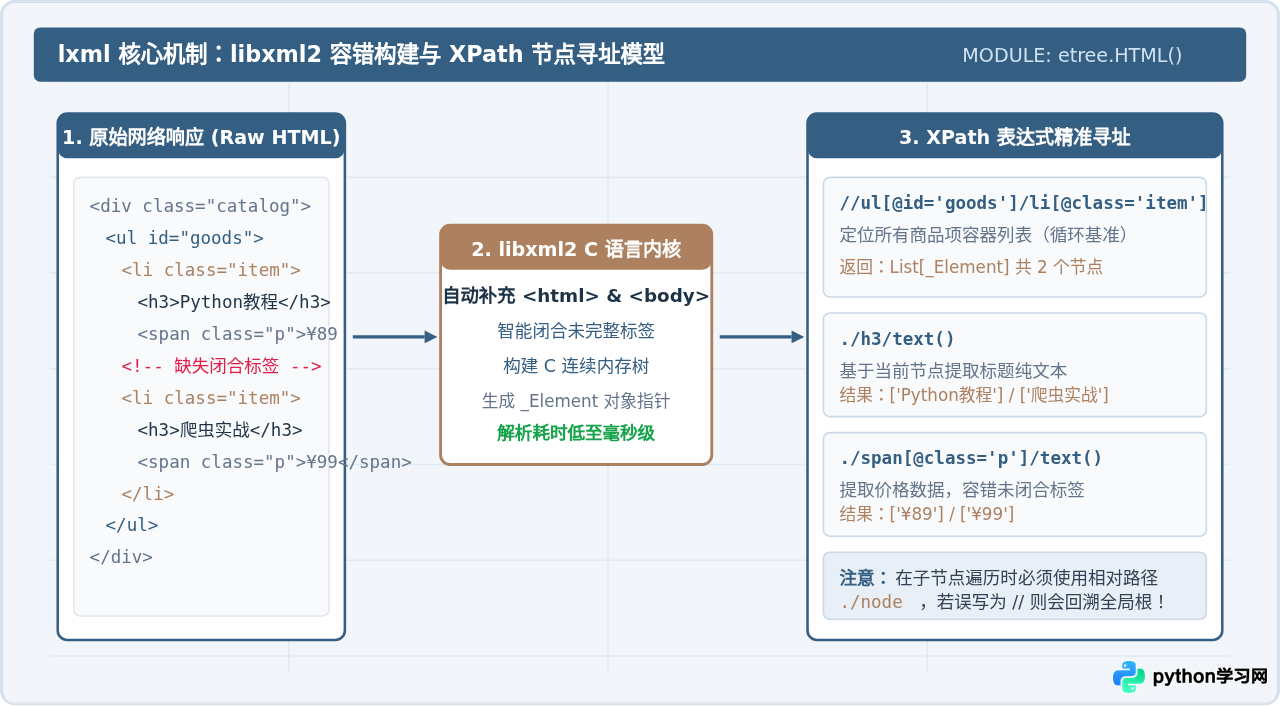
lxml 深度整合了高效的 C 语言库 libxml2 和 libxslt。当原始 HTML 被喂给 etree.HTML() 解析器时,引擎会执行以下关键动作:
- 自动修复与容错:自动补充确实闭合的
<p>、<li>或<tr>标签,纠正标签交错嵌套错误。 - 内存化 DOM 树:在 C 语言层面生成连续分配的 ElementTree 节点树,使后续通过 XPath 查找节点时避免高昂的 Python 解释器对象开销。
- 标准化编码转换:接收
bytes或str,并按照 HTML 声明或指定编码规范转换为内部统一表示。
2. lxml + XPath 实战代码示例
以下代码演示了从一段典型的电商列表 HTML 中提取商品名称、详情页链接与价格。请特别注意在循环提取每个商品卡片时使用 ./(以当前节点为上下文):
from lxml import etree

html_content = """
<div class="product-wrap">
  <div class="item-card" data-sku="1001">
    <h3 class="title"><a href="/item/1001.html">高性能Python网络编程</a></h3>
    <div class="price-box">
      <span class="symbol">¥</span><span class="val">79.00</span>
    </div>
  </div>
  <div class="item-card" data-sku="1002">
    <h3 class="title"><a href="/item/1002.html">分布式爬虫架构设计</a></h3>
    <div class="price-box">
      <span class="symbol">¥</span><span class="val">108.50</span>
    </div>
  </div>
</div>
"""

# 1. 转换为 ElementTree 根节点
tree = etree.HTML(html_content)

# 2. 定位所有条目容器(以列表形式返回节点)
cards = tree.xpath("//div[contains(@class, 'item-card')]")

results = []
for card in cards:
    # 提取商品SKU属性
    sku = card.xpath("./@data-sku")

    # 提取标题文本与链接(./ 相对路径非常关键)
    title = card.xpath("./h3[@class='title']/a/text()")
    link = card.xpath("./h3[@class='title']/a/@href")

    # 提取价格并拼接
    price = card.xpath("./div[@class='price-box']/span[@class='val']/text()")

    results.append({
        "sku": sku[0] if sku else None,
        "title": title[0].strip() if title else "",
        "link": link[0] if link else "",
        "price": float(price[0]) if price else 0.0
    })

print("解析结果:", results)
# 示例输出:
# 解析结果: [
#   {'sku': '1001', 'title': '高性能Python网络编程', 'link': '/item/1001.html', 'price': 79.0},
#   {'sku': '1002', 'title': '分布式爬虫架构设计', 'link': '/item/1002.html', 'price': 108.5}
# ]//table/tbody/tr... 中的 tbody 标签。浏览器渲染引擎在解析表格时会自动注入 <tbody>,但服务端的原始 HTML 很可能没有该标签。若在 lxml 中原样使用带 tbody 的 XPath,会导致匹配结果为空。建议在编写 XPath 时去除不必要的 tbody,或改用 //table//tr 进行通配匹配。
三、json 模块:API 接口与结构化数据的映射利器
随着现代 Web 前后端架构的演进,越来越多的数据通过 XHR/Fetch 请求以异步接口形式输出。一旦通过浏览器网络面板(Network)捕获到了这类接口,应当直接请求接口数据,彻底绕过复杂的 HTML 解析。
1. 为什么优先走 json 解析
- 解析性能高:Python 内置的
json模块底层用 C 实现(_json),对于数兆字节的文本,反序列化仅耗时几十毫秒;在更极端的高并发流水线中,还可无缝平替为orjson或ujson。 - 完全免疫 UI 改版:前端 DOM 样式 class 名变更极为频繁,而提供给移动端或前端展示的业务 JSON 接口往往具有严格的向下兼容规范,长期稳定性极高。
- 原生类型直映射:数字、布尔值、嵌套数组直接映射为 Python 的
int、float、bool、list与dict,无需额外的文本类型强转。
2. json 模块核心解析与深层防御实战
在实际项目中,直接调用 dict["key"] 极易触发 KeyError 导致爬虫任务崩溃,尤其是面对部分字段存在缺失或为 null 的复杂业务时,必须采用防御式取值:
import json

raw_json_str = """
{
  "code": 0,
  "msg": "success",
  "data": {
    "page": 1,
    "total": 120,
    "items": [
      {
        "id": 8901,
        "name": "无线降噪耳机",
        "tags": ["数码", "声学", "新品"],
        "stock_info": {"in_stock": true, "warehouse": "华东一仓"}
      },
      {
        "id": 8902,
        "name": "机械键盘",
        "tags": null,
        "stock_info": {"in_stock": false, "warehouse": null}
      }
    ]
  }
}
"""

try:
    payload = json.loads(raw_json_str)
except json.JSONDecodeError as err:
    print(f"JSON 反序列化失败: {err}")
    payload = {}

# 安全取值范例:使用 .get() 设定默认兜底值
items_data = payload.get("data", {}).get("items", [])

clean_records = []
for item in items_data:
    item_id = item.get("id")
    name = item.get("name", "未知商品")
    tags = item.get("tags") or []  # 处理 tags 为 None 的场景

    # 嵌套字典安全提取
    stock_dict = item.get("stock_info") or {}
    is_available = stock_dict.get("in_stock", False)
    warehouse = stock_dict.get("warehouse") or "暂未分配"

    clean_records.append({
        "item_id": item_id,
        "name": name,
        "tag_count": len(tags),
        "is_available": is_available,
        "warehouse": warehouse
    })

print("清洗后数据:", clean_records)
# 示例输出:
# [
#   {'item_id': 8901, 'name': '无线降噪耳机', 'tag_count': 3, 'is_available': True, 'warehouse': '华东一仓'},
#   {'item_id': 8902, 'name': '机械键盘', 'tag_count': 0, 'is_available': False, 'warehouse': '暂未分配'}
# ]
四、re 正则表达式:非结构化与混杂文本的终极兜底
在爬虫工程中,切忌使用正则表达式来全量解析 HTML 树结构。HTML 的标签自闭合、随意换行、嵌套深浅多变,编写复杂的全局正则容易产生严重的性能退化甚至“灾难性回溯”(Catastrophic Backtracking)。
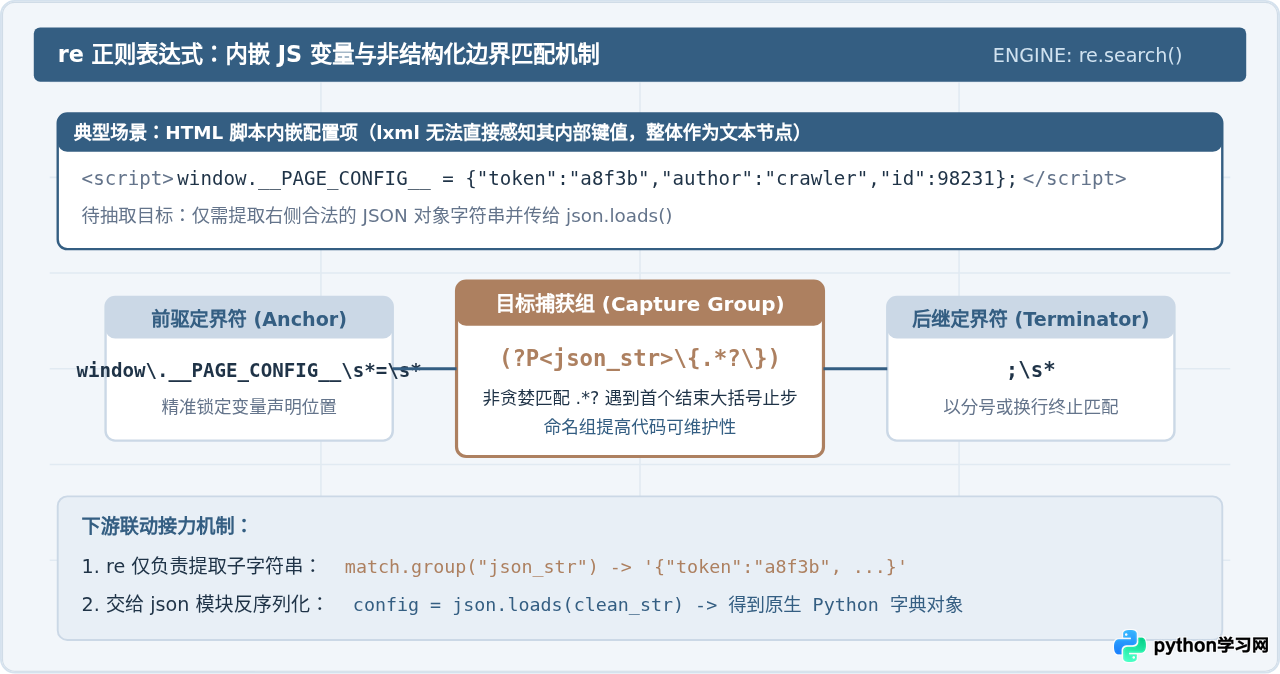
正则表达式的真正价值在于:当目标处于非标准文档流中,且具备明确的前驱与后继边界特征时,充当外科手术式的数据切割器。
1. 正则编写关键守则:预编译与非贪婪模式
在批量爬取流程中,使用 re.compile() 将正则表达式编译为 Pattern 对象,能够节省成千上万次循环重复解析正则模式的耗时。同时,对于包含成对符号的文本,务必使用 .*? 非贪婪匹配:
import re
import json

raw_html = """
<html>
  <body>
    <script type="text/javascript">
      var clientContext = {
        "sessionId": "x91a-772b-9901",
        "timestamp": 1729819200,
        "isLogin": true
      };
      var extra = "other info";
    </script>
  </body>
</html>
"""

# 1. 预编译带命名分组的正则表达式
PATTERN_CONTEXT = re.compile(r'var\s+clientContext\s*=\s*(?P<payload>\{.*?\});', re.DOTALL)

# 2. 执行安全检索
match = PATTERN_CONTEXT.search(raw_html)
if match:
    json_literal = match.group("payload")
    # 3. 交由标准 json 库解析,而不是用正则逐个字段提取
    context_data = json.loads(json_literal)
    print("成功解析内嵌上下文:", context_data)
else:
    print("未在页面中检索到目标 JS 变量")

# 示例输出:
# 成功解析内嵌上下文: {'sessionId': 'x91a-772b-9901', 'timestamp': 1729819200, 'isLogin': True}
五、三者多维度对比与技术选型矩阵
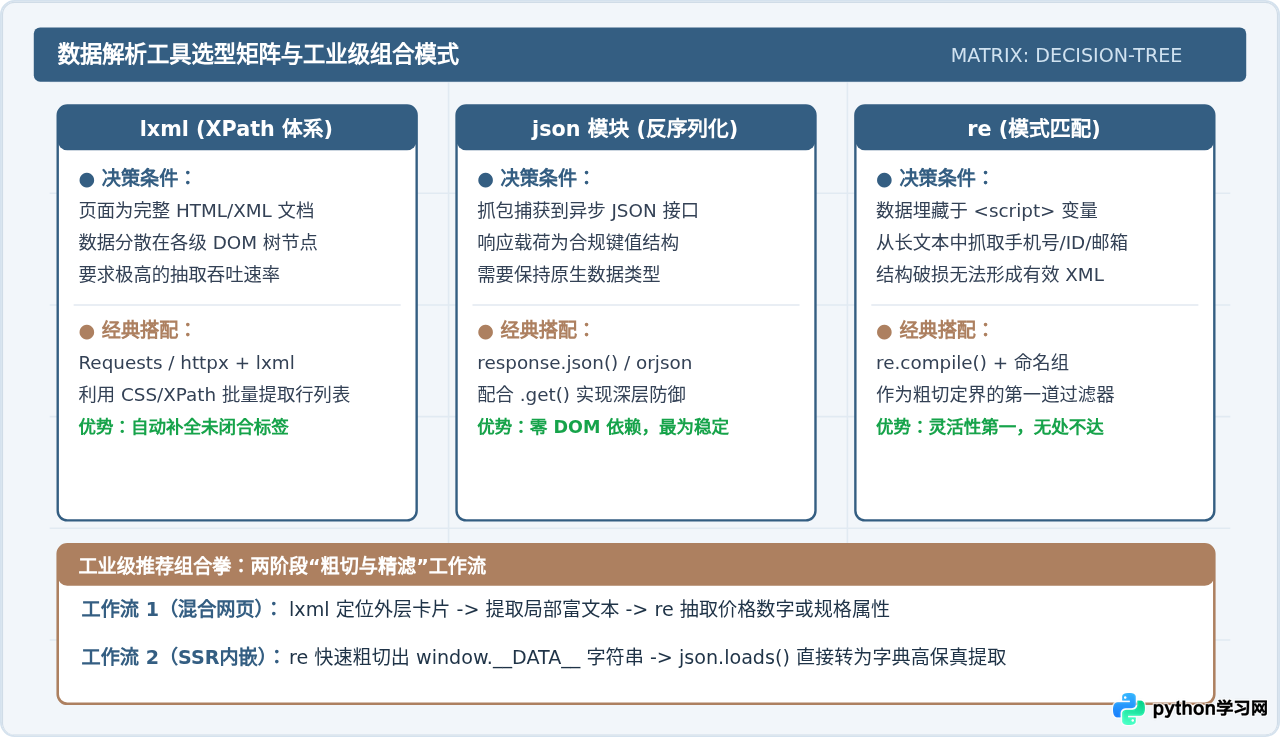
为帮助在实际项目中快速决断,下表从执行性能、容错能力、语法维护成本、适用载体四个核心工程维度对三者进行客观对比:
| 对比维度 | lxml (etree / XPath) | json (Python 内置) | re (正则表达式) |
|---|---|---|---|
| 底盘与执行效率 | C 库 libxml2,C 内存树,解析大文件毫秒级响应 | C 底层 _json 模块,时间复杂度近 O(1),速度极快 | C 语言正则引擎,复杂度依赖模式,防范回溯风险 |
| 对破损结构容错 | 极高:自动闭合缺失标签、修复层级错位 | 零容错:单双引号混用或缺逗号即报错 | 无结构依赖:只要命中特征字符即可提取 |
| 语法与可读性 | XPath 标准规范,层级关系清晰,学习曲线适中 | 纯 Python 字典/列表操作,无额外学习负担 | 紧凑但可读性较低,复杂模式维护成本较高 |
| 首选适用场景 | 服务端渲染的 HTML 网页、XML 接口数据 | 前后端分离的 API、移动端端接口返回的 JSON | 提取内嵌 JS 变量、Token、手机号、文本清洗 |
六、工程实践中的健壮性建议
为了保证爬虫在目标网站更新或数据异常时具有足够的容错与自愈能力,建议在编写数据解析逻辑时遵循以下守则:
- 永远假定列表可能为空:在 XPath 获取结果后,不要直接写
tree.xpath("//div[@class='info']/text()")[0]。若页面稍有变动,该表达式会引发IndexError。应封装类似nodes[0] if nodes else ""的安全取值函数。 - 优先寻找并固定唯一锚点:写 XPath 时尽量避开长串的绝对路径(如
/html/body/div[2]/div[1]/...),这类路径极度脆弱。优先利用具备业务语义的属性(如id="product-detail"或data-testid="...")作为相对路径起点。 - 清洗不可见空白字符:从 HTML 提取文本时经常会附带
\r\n\t以及连续空格。可使用 Python 的" ".join(text.split())快速消除多余空行和制表符。 - 规避灾难性正则模式:严禁在未加限定的情况下书写如
(a+)+或过于宽泛的.*套嵌套结构。对于超长响应正文,若正则检索超过预设时间,应当设置超时机制或通过局部截取减小匹配窗口。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















