


Python列表切片索引越界为什么不报错?边界规则解析
深入解析Python中单元素索引越界抛出IndexError而列表切片越界安全返回子列表的核心机制、底层C实现逻辑与边界规整规则。
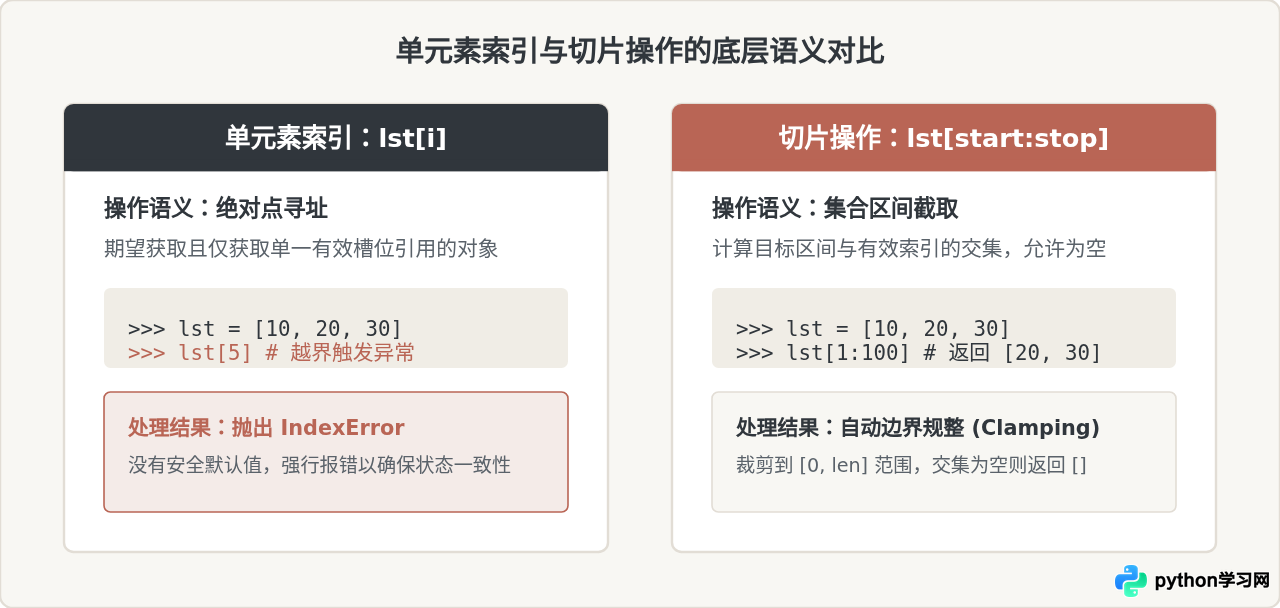
lst[10])如果超出范围会立即触发 IndexError: list index out of range,而使用切片截取(如 lst[2:100])即便数值远超列表长度也不会报错,只会返回截取到的元素或空列表。这种区别源于两者的底层语义设计:单索引强调“精确获取某个位置上的实体”,不存在即是异常;切片则遵循“区间子集抽取”与“边界自动钳位(Clamping)”机制,计算有效范围的交集,因此始终保持安全容错。
一、核心语义差异:点寻址与区间截取
要理解切片不报错的原因,首先必须分清 Python 对“单项索引”与“范围切片”所赋予的不同语义。
在单索引访问(lst[i])中,程序表达的意图是:“请把列表中第 i 个位置所保存的对象引用交给我”。由于列表内每个有效槽位都严格对应一个对象引用,如果给定的 i 超出实际存在的元素范围,Python 无法给出合法的返回值。如果返回 None,程序将无法区分该位置是原本就存着 None 还是索引越界;如果静默忽略,赋值或读取操作便失去了确定性。因此,单索引越界抛出 IndexError 是保证数据访问确定性的必然选择。
相比之下,切片访问(lst[start:stop])表达的意图是:“请在当前列表中提取位于指定区间范围内的子序列”。这在数学上等同于求目标区间与列表实际有效区间的交集。如果切片范围完全落在列表有效区间外,两者的交集就是空集,直接返回一个空列表 [] 即可;如果只有部分重叠,则返回重叠部分的元素。在子集操作中,返回空集是符合数学与逻辑直觉的正常运算结果,并不构成运行期致命故障。
二、切片的几何模型:栅栏坐标系
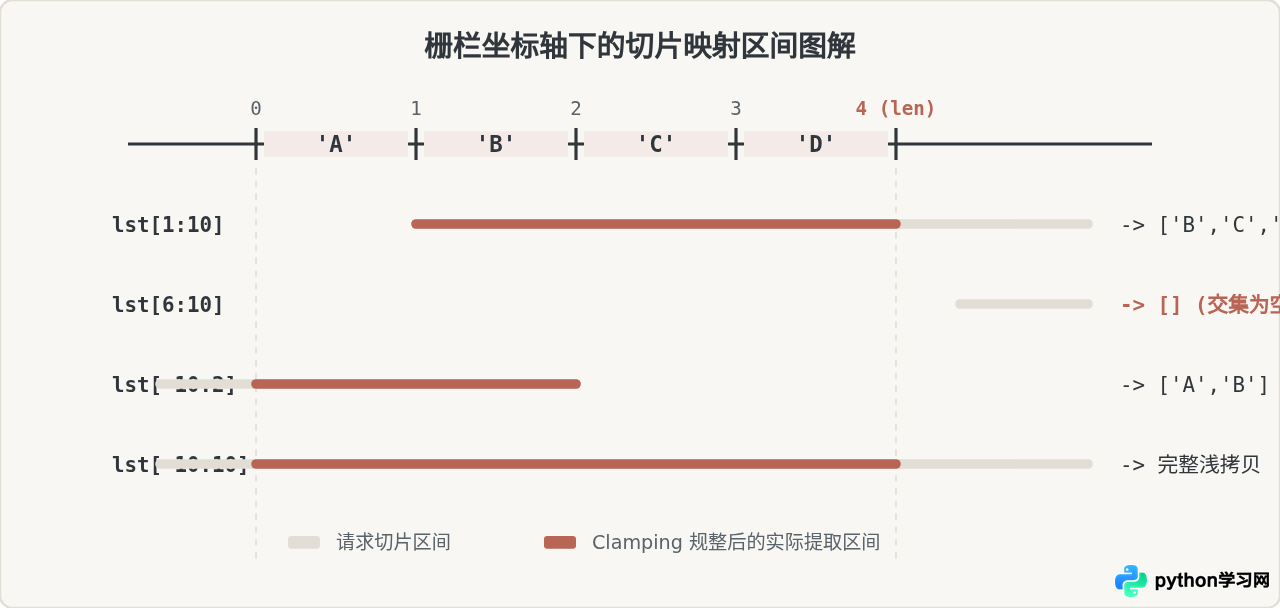
许多初学者认为切片索引直接对应元素槽位,这种直觉在面对越界和半开区间时容易产生困惑。在 Python 官方设计中,切片索引更准确的理解方式是“栅栏柱(Fence-post)坐标系”或“元素间隙坐标系”。
设有长度为 n 的列表,其元素占据的是坐标之间的格子,而索引 0, 1, 2, ..., n 标记的是各格子左右两侧的边界分界线:
- 索引
0位于第 0 个元素的最左边缘。 - 索引
k位于第k-1个元素与第k个元素之间的分割线上。 - 索引
n位于最后一个元素的最右边缘。
当执行 lst[start:stop] 时,切片获取的是从分割线 start 到分割线 stop 之间包含的全部格子。如果给定的 start 或 stop 超过了最右侧分割线 n,或者小于最左侧分割线 0,Python 会直接将分割线定位吸附到列表的物理边界上,这就是切片天生容忍越界在几何视角下的直观体现。
三、底层边界规范化:CPython 的 Clamping 算法
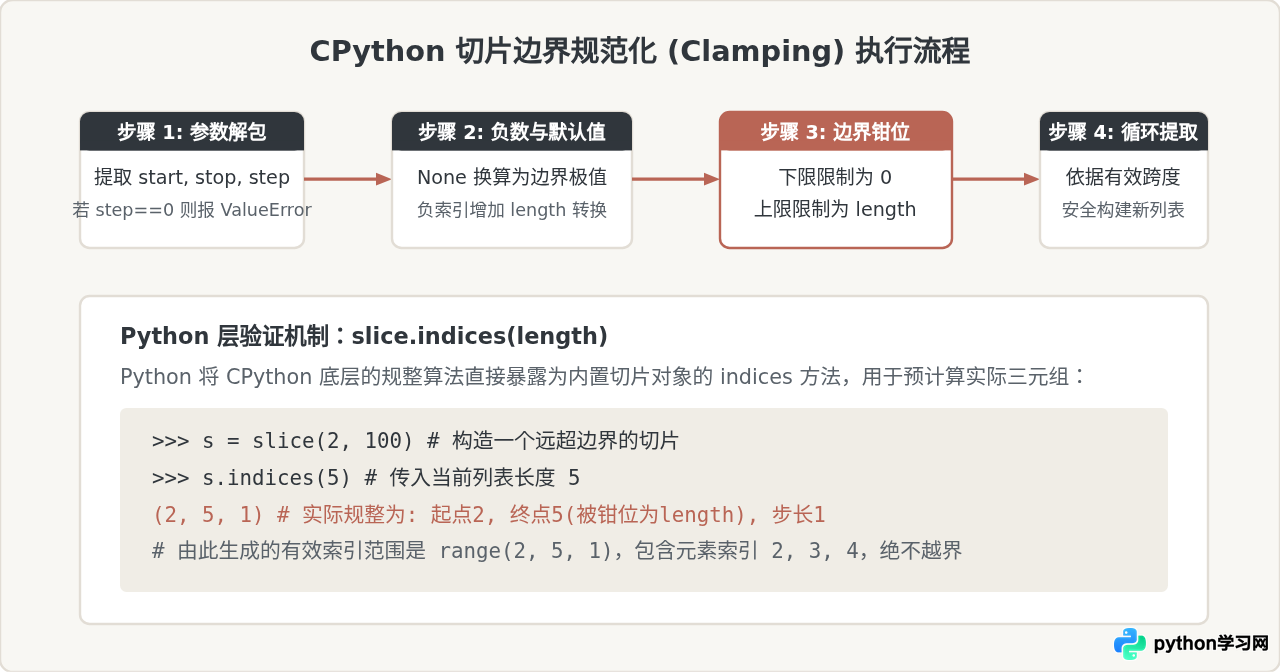
在 CPython 解释器源码中,切片越界不报错有着严密且确定性的 C 语言算法实现。在执行任何切片操作时,解释器内部都会调用 slice.indices(length) 所映射的底层辅助函数(如 PySlice_Unpack 与 PySlice_AdjustIndices)。
1. 内部处理流程与公式
当步长 step > 0 时,边界规范化的核心逻辑如下:
- 默认值补全:若
start is None,则设start = 0;若stop is None,则设stop = length。 - 负索引转换:若
start < 0,将其换算为start + length;若转换后仍小于 0,则直接钳位到0。 - 正向越界裁剪:若
start >= length,则直接钳位为length。 - 结束边界规整:对
stop执行相同逻辑:负数加length,小于 0 钳位到 0,超过length则钳位到length。 - 有效长度判定:若规整后
start >= stop,则截取长度为 0,直接返回空子序列。
当 step < 0(反向切片)时,规整方向反转:start 默认值为 length - 1,正向越界上限截断到 length - 1;stop 默认指向 -1(表示一直截取到索引 0 包含在内),负向越界下限截断到 -1。
四、常见切片越界场景分类解析
在日常开发中,切片涉及的边界情况主要分为右侧越界、左侧负向越界、完全超界以及带负步长越界四大类。以下结合具体列表 lst = ['A', 'B', 'C', 'D'] 进行对照说明。
具体场景代码示例
# 基础列表,长度为 4
items = ['A', 'B', 'C', 'D']

# 1. 结束索引右侧越界:自动截断到列表末尾
print(items[1:100])
# 示例输出: ['B', 'C', 'D']

# 2. 起始索引与结束索引均越过右侧边界:有效交集为空
print(items[10:20])
# 示例输出: []

# 3. 起始索引向左越界:负数换算后仍小于0,自动钳位到 0
print(items[-100:2])
# 示例输出: ['A', 'B']

# 4. 两侧全范围越界:等同于提取 [0:len(items)]
print(items[-999:999])
# 示例输出: ['A', 'B', 'C', 'D']

# 5. 反向步长越界:自动规整到有效头部
print(items[10::-1])
# 示例输出: ['D', 'C', 'B', 'A']
五、切片赋值的边界规则与潜在陷阱
切片不仅用于读取,还可以作为左值进行赋值(Slice Assignment)。理解切片赋值在越界时的表现尤为关键,因为其行为可能与直觉存在偏差。
1. 越界切片赋值并不会报错,而是就地插入/追加
对一个越界的切片进行赋值,Python 依然会先执行边界规整,然后用右侧可迭代对象中的元素替换掉规整后的区间。
data = [1, 2, 3]

# 切片 [10:20] 规整后等价于在索引 3 处截取空区间
data[10:20] = [88, 99]
print(data)
# 示例输出: [1, 2, 3, 88, 99]如上述代码所示,data[10:20] 规整为 [3:3],即列表末尾的一个零长度区间。向零长度区间赋值的效果就是直接在末端追加新元素,而不是报错,也不会在中间填充 None 或空位。
2. “过于宽容”可能掩盖逻辑缺陷
虽然切片的容错性带来了极佳的语法便利性(例如无需显式判断 min(end, len(lst)) 即可实现安全分页与截取),但这种宽容也意味着它会静默吞掉可能由算法缺陷导致的越界错误:
- 分页计算偏移量溢出:如果由于公式写错导致
page_start远大于数据总数,代码不会崩溃报错,而是静默产生空列表[],若缺乏对空数据的专门校验,可能导致前端展示空白却难以追溯根因。 - 意图修改单项却使用了切片语法:开发者若误将
lst[5:6] = [x]当作修改第 5 项,当列表长度小于 5 时,该代码不会抛出IndexError,而是静默将x追加在列表尾部,导致数据顺序与预期发生隐蔽偏差。
lst[index])或在切片前显式检查 len(lst),以便在参数异常时及时捕获错误;只有在确实需要“尽可能多地提取有效子序列”时,才依赖切片的自动 Clamping 特性。
六、总结与规则速查
Python 列表切片越界不报错是经过深思熟虑的语言设计规范,总结其核心要点如下:
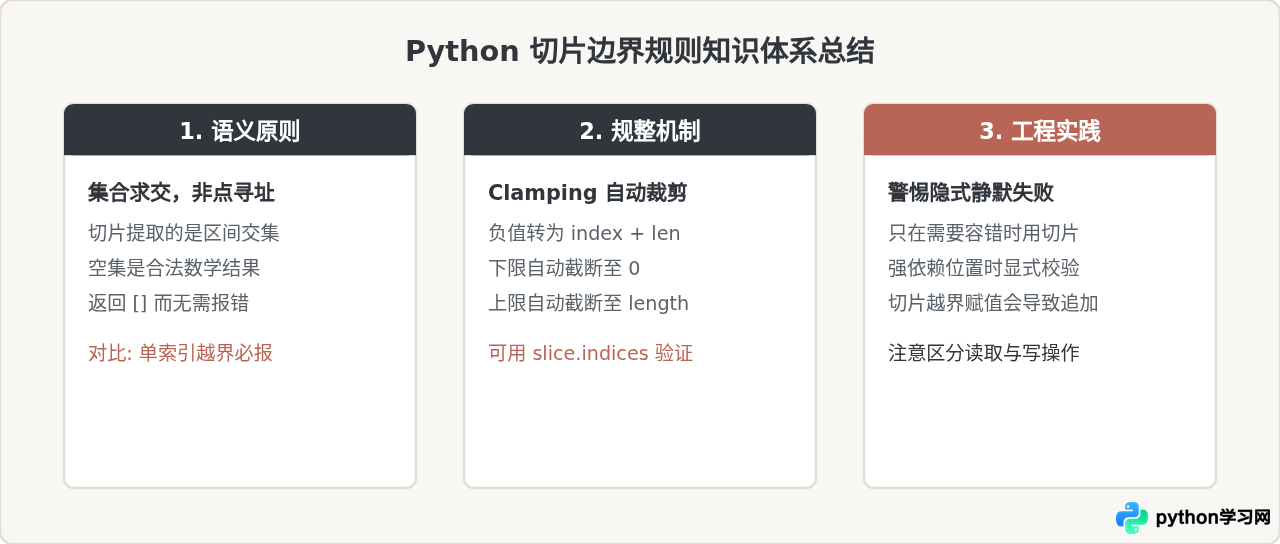
| 操作语法 | 索引越界表现 | 底层依据 | 典型应用场景 |
|---|---|---|---|
lst[i] (单元素访问) |
抛出 IndexError |
点寻址语义,必须返回唯一确定的对象引用 | 精确提取特定位置数据 |
lst[start:stop] (切片读取) |
静默规整,返回子列表或 [] |
区间交集语义,执行 Clamping 算法 | 安全截断、分页、流式数据缓冲读取 |
lst[start:stop] = items (切片赋值) |
静默规整,可能在末尾变为追加 | 在规整后的区间执行替换插入 | 批量替换、批量插入、清空列表 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















