


怎么根据业务需求选择合适的Python机器学习模型
深入讲解如何根据业务目标、可解释性要求、延迟吞吐及数据形态选择合适的Python机器学习模型。提供四大核心维度的量化评估、主流模型家族对比、五步选型流程及典型业务场景速查指南。
一、以终为始:必须厘清的四大业务硬性约束
脱离业务约束单纯对比模型准确率,是机器学习项目落地中最常见的失误。不同业务场景对错误代价的敏感度、审计监管的标准以及系统的吞吐性能有着截然不同的底线要求。在启动 Python 建模前,必须先量化评估以下四个维度的业务边界:
1. 业务目标与损失不对称性
业务问题首先需要被精准映射为对应的算法任务(如二分类、多分类、连续值回归、排序或异常检测)。更关键的是理解正负样本预测错误的成本不对称。在信用卡欺诈拦截或癌症筛查中,漏报一例高危事件的代价数十倍于误报一次正常行为;而在信息流推荐中,误推一条低质内容的负面体验远高于偶发漏推。这决定了模型选型时不能仅看整体准确率(Accuracy),而必须选择能够方便调节阈值、精准输出概率校准值或支持自定义非对称损失函数的模型架构。
2. 业务合规与可解释性底线
在金融风控、医疗决策、信用授信等强监管领域,模型不仅要给出预测结果,还必须向监管机构或用户说明“为什么拒绝”或“基于哪些特征得出诊断”。此时,即使复杂的深度神经网络或集成树模型能提升1%的离线指标,但若无法提供稳定、无歧义的特征归因(如评分卡分箱单调性或线性权重),也无法通过合规审计。而在商品搜索召回、广告点击预估等弱监管场景,则可以优先追求预测精度的极限。
3. 在线推理延迟与计算资源预算
模型最终是运行在批处理脚本中,还是嵌入高并发实时接口中?实时反欺诈和推荐排序接口通常要求在 10ms 至 30ms 内完成单次特征提取与推理计算,且每秒承受数万次 QPS。此时,拥有数百万参数的深度模型往往会因显卡硬件成本过高或推理超时被排除,而经由高度优化的 LightGBM 浅层树或线性模型便成为首选。对于每日离线跑一次的流失预警任务,算力约束则相对宽松。
4. 数据形态、样本量级与特征质量
现实中的业务数据往往充斥着高维离散稀疏特征(如用户ID、搜索词)、大量空缺值或非线性关联。样本量在数千级别的小样本场景下,参数量过大的模型极易发生过拟合;而在千亿规模的特征交互场景下,单机内存无法装入的算法无法直接投产。明确数据形态是决定采用 scikit-learn 轻量工具链还是分布式树模型的决定性前提。
二、Python 主流机器学习模型家族的核心特性与权衡
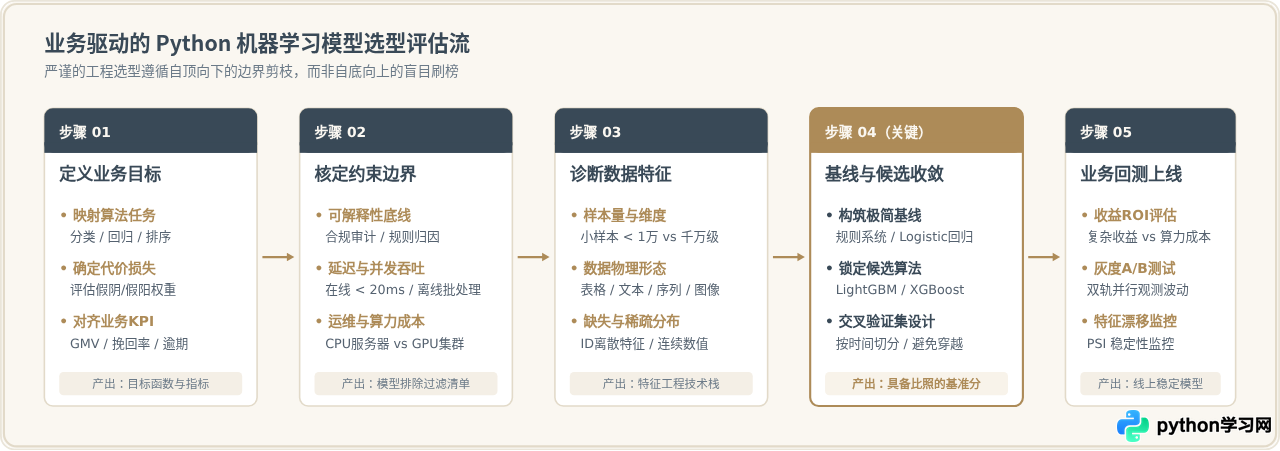
Python 生态提供了极其丰富的算法库。掌握每类模型家族在解释性、拟合能力、吞吐效率及维护复杂度上的根本差异,是做出明智选型的前提。
1. 线性模型与广义线性模型(Linear Models)
代表库包括 scikit-learn 中的 LogisticRegression、Ridge、Lasso 及 ElasticNet。
- 核心优势:计算复杂度极低,训练与推理均为矩阵乘法级操作,微秒级响应;系数权重直接对应特征影响方向与幅度,是可解释性最强的模型;天然适合大规模高维稀疏特征(如文本 TF-IDF、高基数 One-Hot 编码)。
- 业务局限:无法直接捕捉特征之间的非线性相互作用,必须依赖人工或自动化特征工程构造交叉特征;对于复杂非线性决策边界表现乏力。
- 最佳业务落地点:信贷风控评分卡、高并发广告 CTR 粗排预估、法律或医疗初审规则辅助。
2. 梯度提升决策树家族(GBDT / Gradient Boosted Trees)
代表库包括 LightGBM、XGBoost、CatBoost 以及 scikit-learn 的 HistGradientBoostingClassifier。
- 核心优势:当前业界处理结构化表格数据(Tabular Data)的绝对首选。对特征量纲不敏感、天然支持缺失值与混合数据类型、无需复杂的标准化预处理,能极其高效地自动拟合高阶特征交叉与非线性关系。
- 家族成员细分选择:
LightGBM:基于直方图分箱和带深度限制的 Leaf-wise 生长,内存占用最小、训练与预测速度极快,是千万级以下表格数据的默认首选。XGBoost:工程生态成熟度最高,精确贪心分割在小样本中往往极其扎实,支持高度定制化的目标函数与多机分布式训练。CatBoost:针对大量高基数类别特征(Categorical Features)有独特的 Target Encoding 优化,在电商、用户画像密集场景下开箱即用表现优异。
- 业务局限:树模型对未见过的特征取值范围缺乏外推能力(无法直接外推趋势性时间序列);缺乏原生的一阶数学导数权重,需借助 TreeSHAP 辅助解释。
3. 深度学习与序列模型(Deep Neural Networks)
代表库包括 PyTorch、TensorFlow 以及面向 NLP/CV 预训练的 HuggingFace Transformers。
- 核心优势:在图像、长文本、语音及图关系等非结构化数据领域具有无可替代的表征学习能力;支持端到端联合训练与多模态特征融合。
- 业务局限:对表格数据的拟合效果和调参成本往往劣于 LightGBM;模型参数量巨大,强依赖 GPU 算力,推理延迟在数十至数百毫秒,可解释性极差,排查线上异常归因成本极高。
- 最佳业务落地点:智能客服文本意图识别、票据图片 OCR 结构化提取、多模态商品图文检索。
4. 距离度量与异常检测模型(Metric & Unsupervised Models)
代表库包括 scikit-learn 中的 IsolationForest、KMeans、DBSCAN 以及 PyOD 库。
- 核心优势:无需标签数据即可运行,非常适合冷启动业务;基于密度或隔离切分的思想能够快速捕捉偏离正常业务分布的离群点。
- 业务局限:对高维噪声极度敏感;阈值设定往往需要业务专家主观经验介入,误报率波动较大。
- 最佳业务落地点:系统日志入侵预警、新上线业务欺诈初筛、用户人群冷启动聚类分群。
三、从数据形态与规模推导技术路线
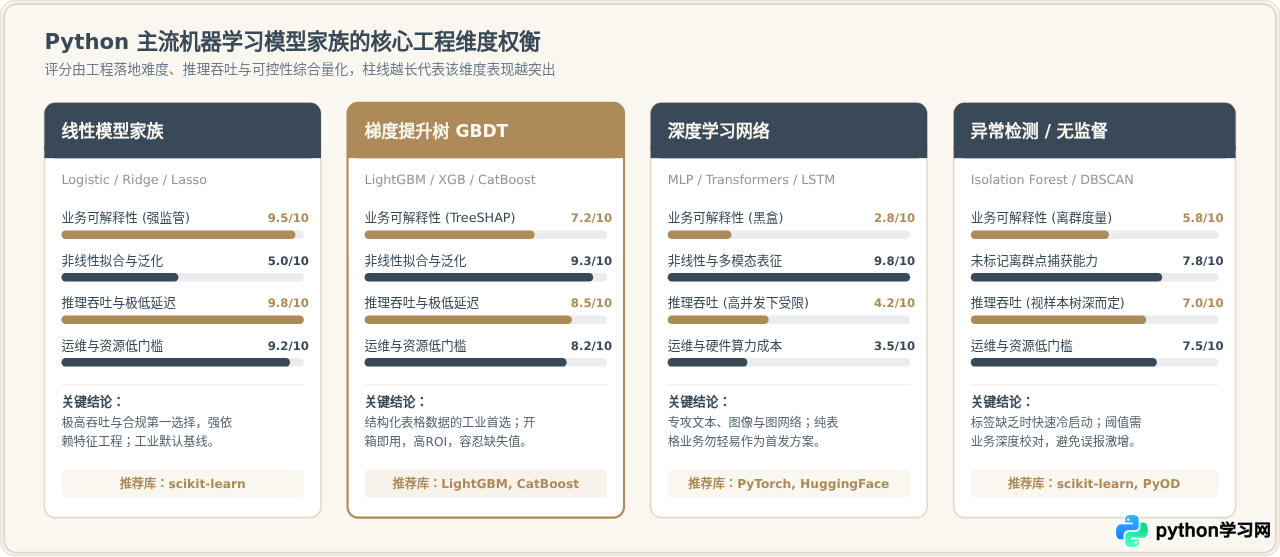
除了业务目标,数据本身的体量与物理结构直接划定了模型家族的适配空间。根据数据的样本量级与特征形态,可以清晰地绘制出一条直接的技术路线映射:
四、标准 Python 工程落地实现:构建强健的选型基线
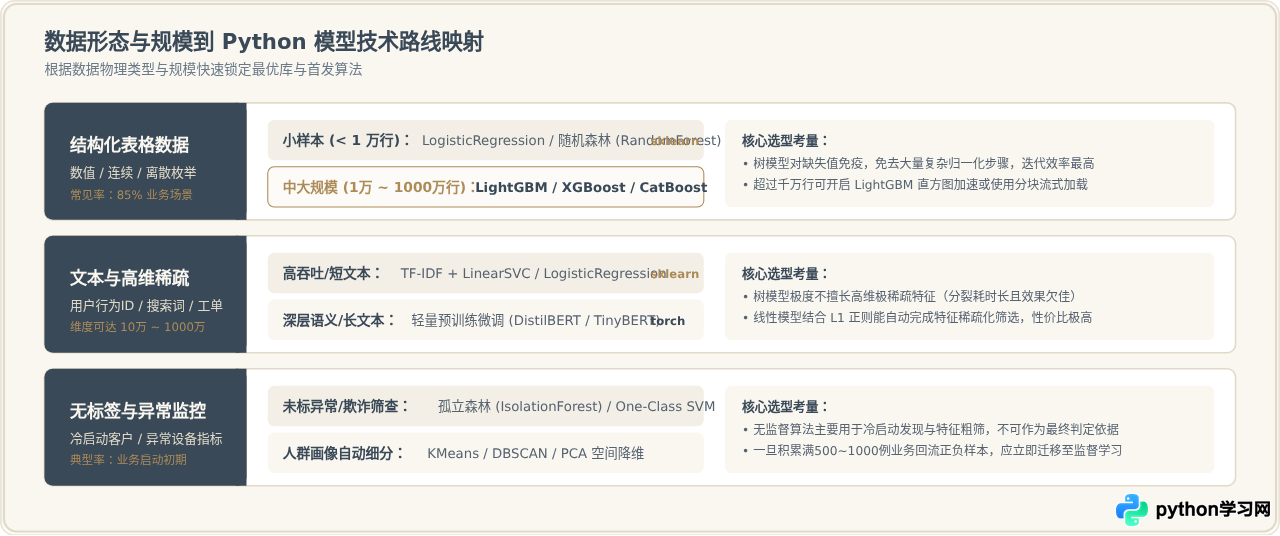
建立模型选型代码时,最忌讳的是直接手写零散的脚本训练单一算法。成熟的做法是利用 scikit-learn 的 Pipeline 与 ColumnTransformer 将数据预处理标准化,并无缝插拔不同的候选模型。以下提供一份可以直接运行的标准选型基线模板:
import numpy as np
import pandas as pd
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split, StratifiedKFold, cross_val_score
from sklearn.compose import ColumnTransformer
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler, OneHotEncoder
from sklearn.impute import SimpleImputer
from sklearn.linear_model import LogisticRegression
from sklearn.ensemble import HistGradientBoostingClassifier
from sklearn.metrics import roc_auc_score, precision_recall_curve

# 1. 模拟业务数据生成(包含连续特征与离散类别特征)
X_raw, y = make_classification(
    n_samples=10000, n_features=12, n_informative=8,
    n_classes=2, weights=[0.9, 0.1], random_state=42
)
df = pd.DataFrame(X_raw, columns=[f"num_{i}" for i in range(10)] + ["cat_0", "cat_1"])
# 将最后两列模拟为类别型离散编码
df["cat_0"] = pd.qcut(df["cat_0"], q=4, labels=["L1", "L2", "L3", "L4"]).astype(str)
df["cat_1"] = pd.qcut(df["cat_1"], q=3, labels=["TypeA", "TypeB", "TypeC"]).astype(str)

# 2. 区分连续特征与类别特征
numeric_features = [f"num_{i}" for i in range(10)]
categorical_features = ["cat_0", "cat_1"]

# 3. 构建可复用的特征预处理流水线
numeric_transformer = Pipeline(steps=[
    ('imputer', SimpleImputer(strategy='median')),
    ('scaler', StandardScaler())
])

categorical_transformer = Pipeline(steps=[
    ('imputer', SimpleImputer(strategy='constant', fill_value='missing')),
    ('onehot', OneHotEncoder(handle_unknown='ignore', sparse_output=False))
])

preprocessor = ColumnTransformer(transformers=[
    ('num', numeric_transformer, numeric_features),
    ('cat', categorical_transformer, categorical_features)
])

# 4. 定义候选模型字典(用于业务选型横向评测)
candidate_models = {
    # 极简业务基线:带平衡权重的逻辑回归(强可解释、微秒级推理)
    "Baseline_Logistic": LogisticRegression(
        class_weight="balanced", max_iter=1000, random_state=42
    ),
    # 工业标准选型:高拟合度梯度提升树(可直接替换为 LightGBM)
    "Candidate_GBDT": HistGradientBoostingClassifier(
        class_weight="balanced", max_iter=150, random_state=42
    )
}

# 5. 按照严格分层K折交叉验证,比较业务关注的 ROC-AUC 指标
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)

print("===== 业务模型选型评估结果 (ROC-AUC) =====")
for name, model in candidate_models.items():
    clf_pipeline = Pipeline(steps=[
        ('preprocessor', preprocessor),
        ('classifier', model)
    ])
    scores = cross_val_score(clf_pipeline, df, y, cv=cv, scoring='roc_auc')
    print(f"[{name}] 5折平均 AUC: {scores.mean():.4f} (标准差: {scores.std():.4f})")
fit 操作被完整封装在 Pipeline 内部。这意味着缺失值中位数和标准化均值严格只在训练折上计算,决不泄露验证集信息。在处理带有时序特性的业务数据(如销量、交易流水)时,必须使用 TimeSeriesSplit 替代随机 K-Fold,确保永远是用“过去的数据”预测“未来的数据”。
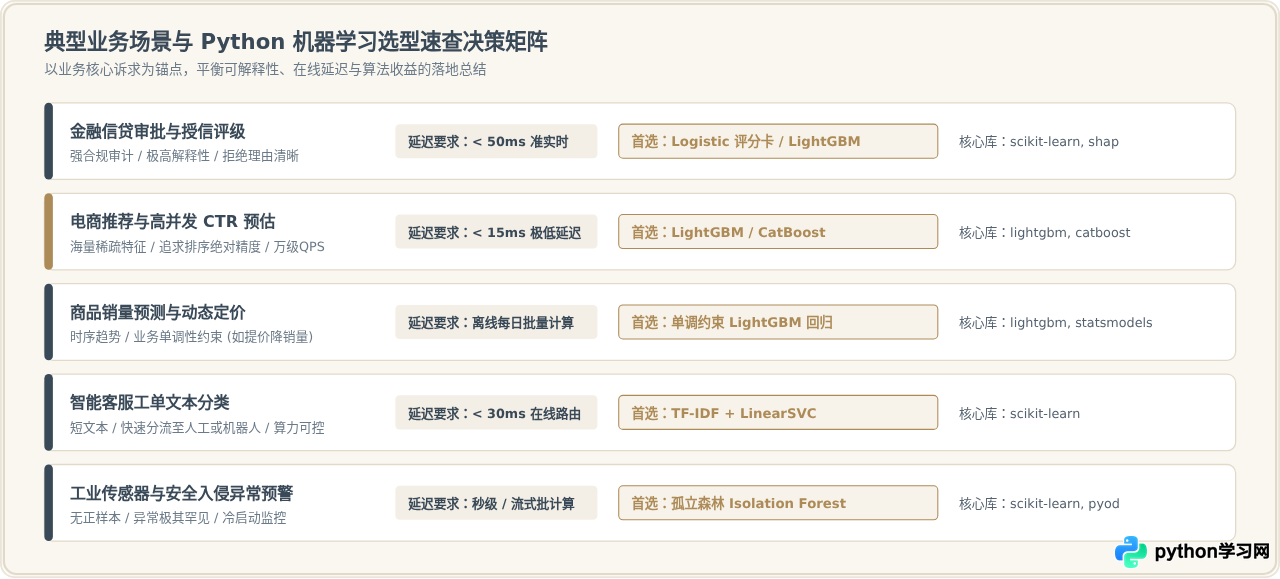
五、典型业务场景与 Python 模型选型速查矩阵
为了帮助技术团队在面对新业务需求时迅速达成共识,下表与图示总结了业界最典型的五大业务场景、对应的硬性考量与首选算法配置:
| 业务场景 | 核心业务诉求 | 延迟与吞吐要求 | 推荐首选模型及 Python 库 | 进阶备选方案 |
|---|---|---|---|---|
| 信贷审批 / 授信评级 | 强监管合规、严格解释拒贷原因、极度拒绝漏报 | 在线接口 < 50ms | LogisticRegression(分箱评分卡)scikit-learn |
LightGBM + TreeSHAP 归因解释 |
| 电商推荐 / 点击率预估 | 海量离散高维特征、极高并发、最大化排序精度 | 极苛刻 < 15ms,QPS > 10,000 | LightGBM / CatBoostlightgbm |
双塔深度模型(DeepFM / PyTorch) |
| 商品销量 / 供应链需求 | 时序趋势拟合、单调性约束(价格越高销量越低) | 离线每日批量调度 | 带单调约束的 LightGBM 回归lightgbm |
Prophet + 树模型残差融合 |
| 客服工单分类 / 意图识别 | 短文本快速归类、客服分流、成本可控 | 在线接口 < 30ms | TF-IDF + LinearSVCscikit-learn |
轻量 DistilBERT(HuggingFace) |
| 设备故障早期预警 | 正样本极度稀缺、未标记异常行为捕捉 | 近实时流式计算 | IsolationForest(孤立森林)scikit-learn |
自编码器(AutoEncoder / PyTorch) |
六、避免误入歧途:业务选型中的四大常见陷阱
在实际业务落地过程中,以下四个认知陷阱极其常见,往往导致项目研发周期严重拖延或线上效果未达预期:
1. 忽视极简基线(No Baseline, No Progress)
许多团队直接上手微调超大模型或复杂集成算法,并在离线验证集上取得了 85% 的准确率。但由于没有提前搭建简单的业务规则(如“按历史均值预测”或“过去7天未活跃即判定流失”)作为基线比照,往往无法判断这 85% 究竟是模型学到了有效规律,还是单纯被类别不平衡带偏。没有 Baseline 的模型改进全无意义。
2. 脱离业务后果的“唯指标论”
算法工程师常热衷于将 AUC 从 0.82 优化至 0.83,但如果在线推理延迟因此从 10ms 激增至 150ms,导致接口超时率上升 2%,或者服务器硬件开销翻倍,那么这种技术提升对整体商业回报(ROI)其实是负向的。模型选型必须把算力账、运维账与业务增量账放在一张报表上综合审计。
3. 忽略模型的可维护性与概念漂移(Concept Drift)
结构越复杂的模型,在线上环境发生性能退化(如用户习惯改变、大促活动冲击)时,排查根本原因的难度呈指数级增加。如果一个简单的 LightGBM 结合 TreeSHAP 能让业务运营人员在10分钟内定位是哪几个特征发生了分布漂移,那么它的生产运维价值就远高于难以归因的多层深度神经网络。
4. 试图用模型复杂度弥补数据质量的贫瘠
业内常言“数据和特征决定了机器学习的上限,而模型和算法只是逼近这个上限”。在业务选型中,花费两周时间挖掘两个贴近业务本质的高价值衍生特征(如“近30天退货率与浏览时长的比值”),其对模型效果的提升通常远超花费两周时间去尝试各类前沿的神经网络架构。
- 业务目标:是否已用公式量化正负样本错误代价,并选定了对应的非对称评估指标?
- 合规门槛:当前业务是否必须提供单调性保证或确切的因果特征归因解释?
- 推理预算:单次预测所允许的最大超时阈值(P99)是多少?当前硬件预算是否支持?
- 基线比照:是否已经实现并锁定了以逻辑回归或专家规则为代表的基准跑分?
- 监控与回滚:模型上线后是否具备特征分布稳定性指标(如 PSI)的持续监控机制?
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















