


Python中&能代替and做条件判断吗
深入解析在Python中&能否代替and进行条件判断。从逻辑运算本质、短路求值特性、运算符优先级陷阱到Pandas向量化场景,全面阐明两者的核心区别与正确选型方法。
在 Python 中,& 绝对不能代替 and 做常规条件判断。很多初学者在编写 if 分支语句时,偶尔尝试用 & 代替 and 并发现简单的布尔表达式似乎输出了预期的结果,便误以为两者可以互换。事实上,and 是专用的逻辑运算符,而 & 是按位与运算符。盲目用 & 替代 and,不仅会使程序丧失关键的短路保护引发空指针异常崩溃,还会因运算符优先级陷阱产生极其隐蔽的逻辑偏差。
一、核心机制对比:为什么两者性质完全不同
要理解为什么 & 不能代替 and,首先需要看清它们在 Python 底层运算体系中所承担的职责。and 用于计算布尔真值逻辑,而 & 用于逐位操作二进制数值。
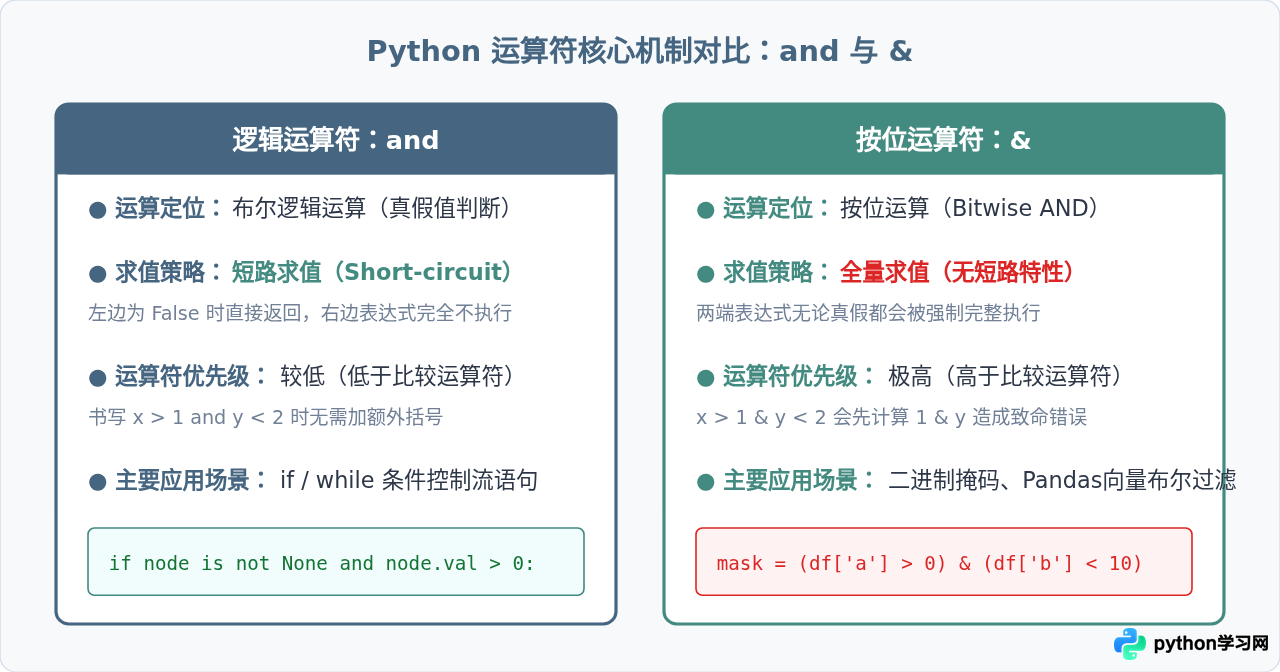
由上述机制对比可知,由于 bool 在 Python 中是 int 的子类(True == 1,False == 0),在执行单纯的 True & False 时,虽然结果是 0(在条件判断中等效于 False),但这只是巧合,并不意味着 & 可以替代 and 执行复杂的逻辑分支。
二、不可替代的关键原因一:短路求值与安全守卫
and 具备短路求值(Short-circuit Evaluation)特性:当计算 expr1 and expr2 时,如果 expr1 的计算结果为假,整个表达式必然为假,Python 将完全跳过 expr2 的执行。
这种短路特性是编写“前置守卫条件”(Guard Clause)的基石。例如在检查对象是否为空、列表索引是否越界或字典键是否存在时,必须确保前置检查不通过时后续代码不被触发:
# 示例 1:安全的短路条件判断(使用 and)
node = None
if node is not None and node.val > 0:
    print("节点值大于0")
else:
    print("节点为空或值不符合要求")
# 执行结果:正常输出,node.val 不会被执行,不会报错
如果将上述代码中的 and 替换为 &,结果将截然不同:
# 错误示例:使用 & 导致崩溃
node = None
if (node is not None) & (node.val > 0):
    print("节点值大于0")
# 运行报错:AttributeError: 'NoneType' object has no attribute 'val'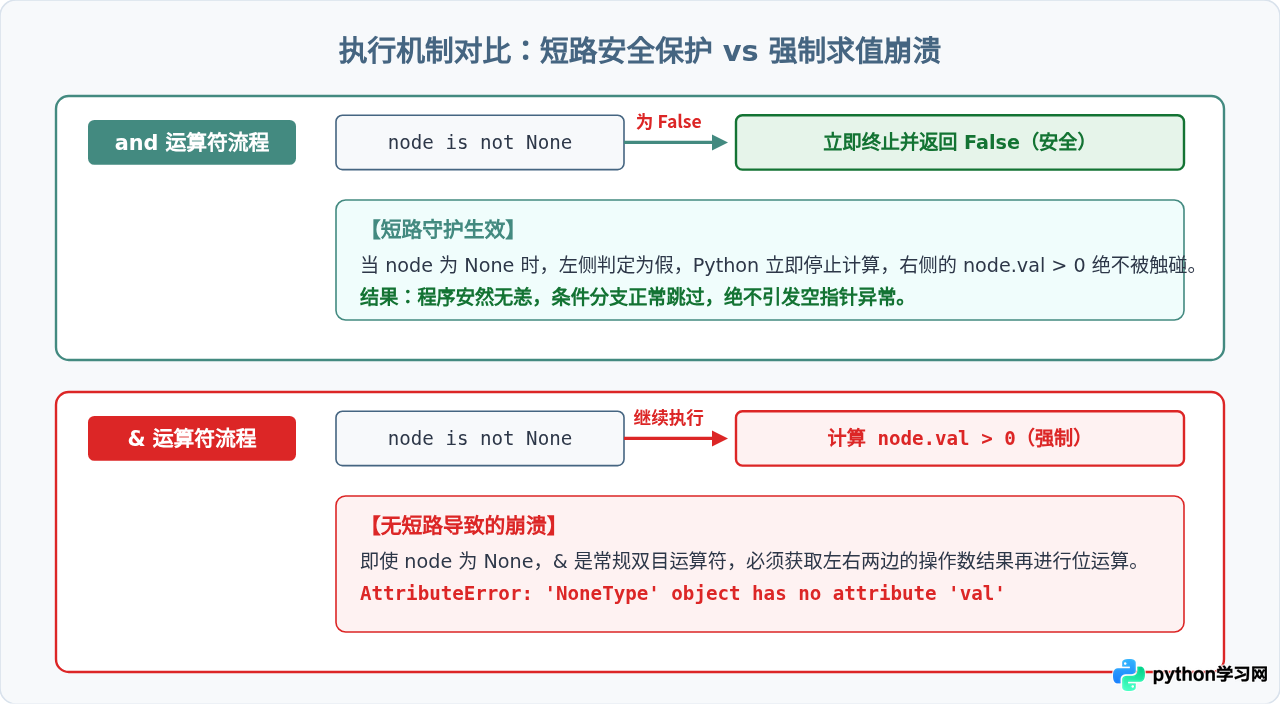
由于 & 是标准二元运算符,Python 解释器在求值时必须先求出左右两侧的实际返回值。这就导致右侧的 None.val 被立即调用,抛出无法挽回的 AttributeError。
三、不可替代的关键原因二:运算符优先级陷阱
在日常编写判断条件时,我们通常会写 a > 1 and b < 5。比较运算符(如 >、<、==)的优先级天然高于逻辑运算符 and,因此 Python 会先分别计算左右两边的比较结果,再执行 and 逻辑组合,完全不需要加额外括号。
然而,按位运算符 & 的优先级远高于比较运算符!如果直接将 and 换成 &,运算顺序将被彻底打乱。
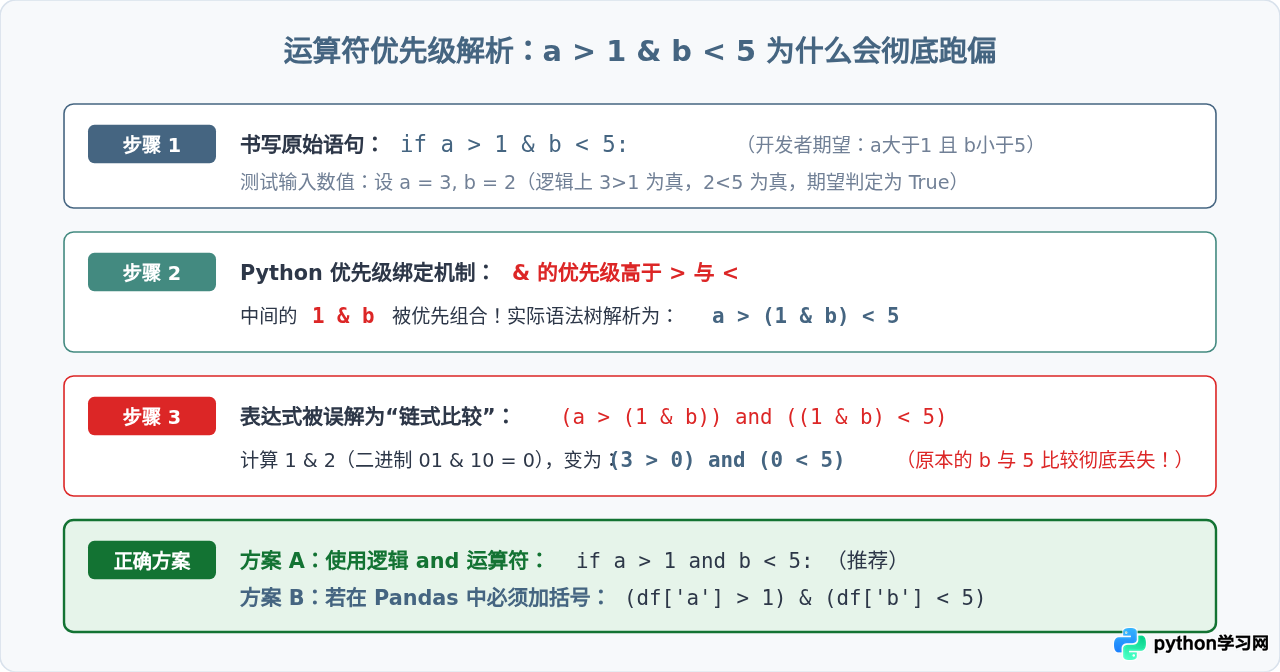
当执行 a > 1 & b < 5 时,由于 & 优先,Python 实际上执行的是 a > (1 & b) < 5。在 Python 的链式比较语法下,这被等价拆解为 (a > (1 & b)) and ((1 & b) < 5)。原本要验证 b < 5,结果变成了验证 (1 & b) < 5,变量 b 的真实大小完全脱离了校验,造成严重的静默 Bug。
四、不可替代的关键原因三:非布尔值的按位运算与真值偏差
在 Python 中,所有对象都具有真假值(Truthy / Falsy)。非零整数在逻辑判断中均视为真。但是 & 执行的是二进制按位与运算,两个均为真值的数字,经过 & 运算后完全可能得出 0(假值):
x = 1  # 0b0001 (真)
y = 2  # 0b0010 (真)

# 逻辑判断:x 为真 且 y 为真
print(bool(x and y))  # 输出:True,因为 1 和 2 都是非零真值

# 按位运算:1 & 2
print(bool(x & y))    # 输出:False,因为 0b0001 & 0b0010 = 0b0000 = 0!
当你在条件中判断两个整数或带数值状态的变量是否同时有效时,用 & 替代 and 会直接将同为真值的运算判定为假,这在业务逻辑中是致命的。
五、为什么在 Pandas 和 NumPy 中却必须用 &?
很多开发者之所以对 & 和 and 产生混淆,很大程度上是因为在数据分析库 Pandas 和 NumPy 中,多条件筛选必须使用 &,如果写成 and 反而会报错:
import pandas as pd
df = pd.DataFrame({'age': [18, 25, 30], 'score': [85, 92, 78]})

# 正确写法:在 Pandas 中必须使用 &,且每个子条件必须用括号包围
result = df[(df['age'] >= 20) & (df['score'] >= 80)]

# 错误写法 1:使用 and 会抛出 ValueError
# result = df[(df['age'] >= 20) and (df['score'] >= 80)]
# 报错:ValueError: The truth value of a Series is ambiguous.

# 错误写法 2:使用 & 但没有加括号,触发优先级错误
# result = df[df['age'] >= 20 & df['score'] >= 80]
# 报错:TypeError 或 运算错乱Python 语言规范规定:and 和 or 是保留的内置控制流关键字,不允许任何第三方类重载其底层逻辑。当你在 Pandas Series 上使用 and 时,Python 试图将整个序列转换为单个布尔值,因而引发歧义报错。
相反,& 是常规二元操作符,对应 Python 魔法方法 __and__。Pandas 对 __and__ 进行了重载,实现了数组内每个元素的按位/逐项与运算。同时,由于前面提到的 & 优先级高于 >=,在 Pandas 中必须给每个条件显式加上小括号。
六、选型决策指南与速查表
为了在实际编码中绝不混淆两者的用途,可参考以下决策路径:
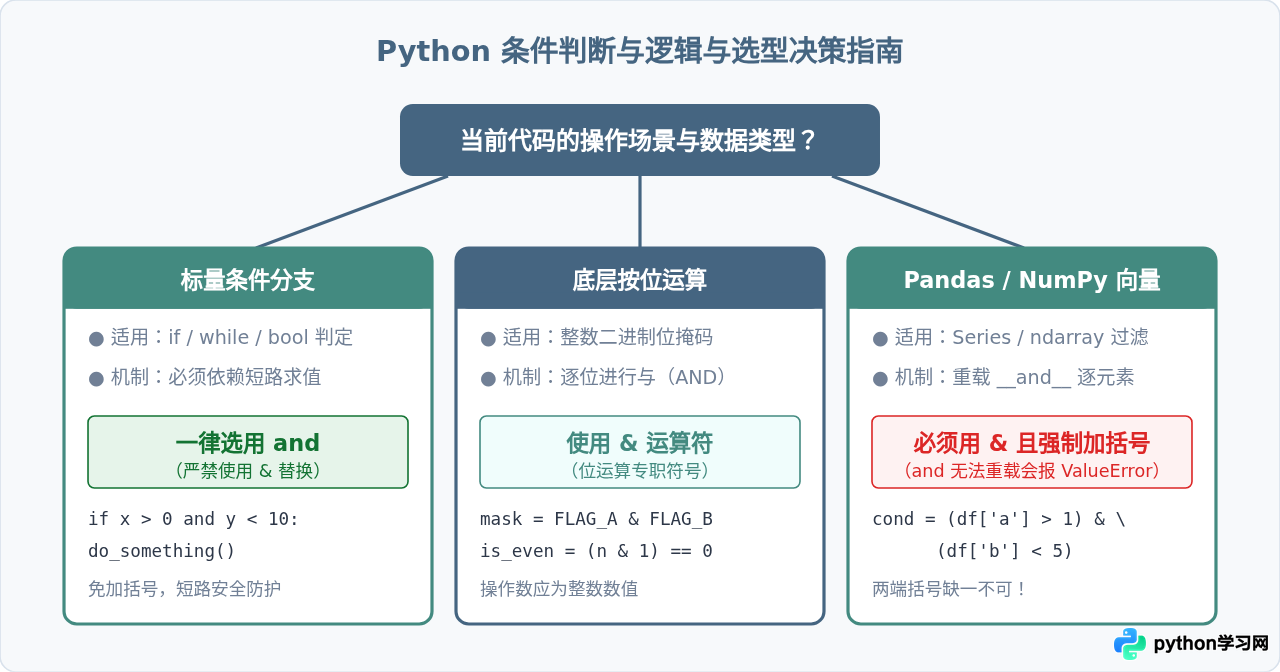
| 特性 / 维度 | and(逻辑与) |
&(按位与) |
|---|---|---|
| 本质功能 | 布尔真假值逻辑运算 | 整数的二进制逐位 AND 运算 |
| 短路特性 | 具备(左为假时不计算右侧) | 不具备(两侧必强制执行求值) |
| 与比较符优先级 | 低于比较运算符(无需对判断加括号) | 高于比较运算符(极易引起错误优先结合) |
| 非布尔值整数处理 | 按真假值评估,返回原对象 | 按二进制逐位计算,返回整型数值 |
| 控制流(if / while) | 唯一推荐标准写法 | 严禁使用 |
| Pandas / NumPy 数组 | 不支持(抛出 ValueError 异常) | 必须使用(重载逐项运算,需带括号) |
总结
回到最初的问题:“Python中&能代替and做条件判断吗?”
答案是明确不能。在常规的 Python 业务代码和条件分支中,永远只使用 and。记住两者的核心界限:做条件分支和布尔逻辑时,认准拥有短路保护的 and;只有在处理硬件接口、权限位掩码等底层二进制位操作,或在 Pandas / NumPy 中编写带括号的向量化布尔切片时,才属于 & 的专属舞台。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















