


解决Python 2.7中文乱码:unicode编码声明与文件头设置
针对Python 2.7开发中常见的中文乱码与Non-ASCII语法报错,详细讲解PEP 263文件头编码声明规范、unicode与str的底层区别、文件I/O与输出流的排查修复方案。
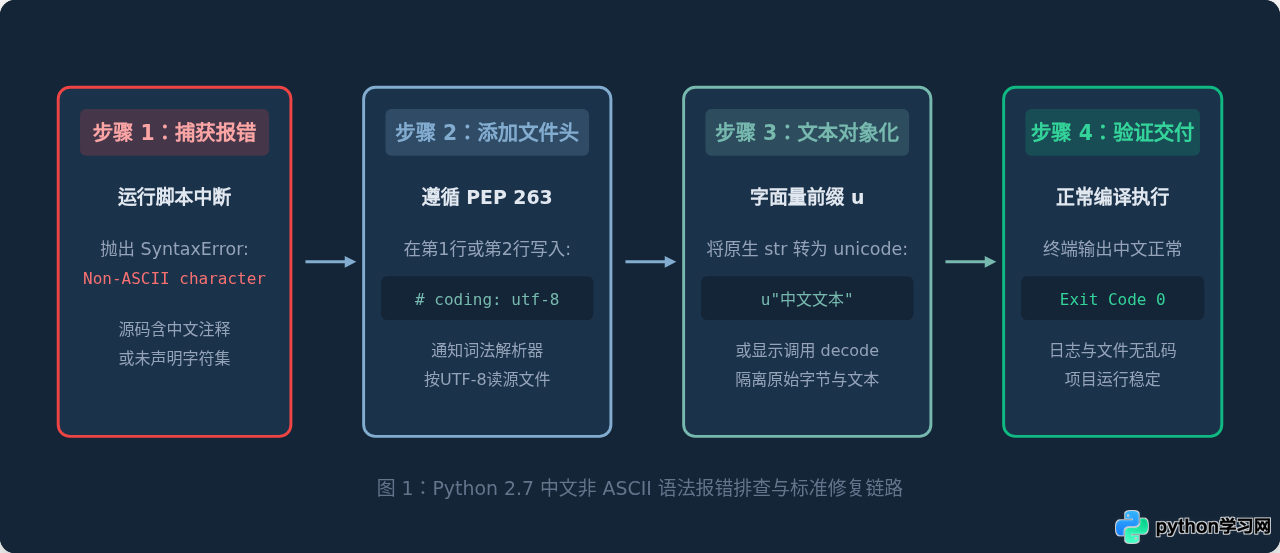
在维护或运行 Python 2.7 遗留项目时,许多开发者常遇到类似报错:在脚本中仅仅写了一行中文注释或打印了一个中文字符串,执行时便直接崩溃并抛出 SyntaxError: Non-ASCII character '\xe4' in file ... but no encoding declared。即使代码能运行,控制台输出或写入文件的数据也常常变成类似 \xe4\xbd\xa0\xe5\xa5\xbd 的十六进制乱码或问号。本文将围绕 Python 2.7 的源码解析机制,详细讲解文件头编码声明(PEP 263)的标准规范、str 与 unicode 的本质区别,以及如何构建可靠的中文编解码处理流程。
一、问题根源:为什么 Python 2.7 默认无法识别中文?
要解决乱码与语法错误,首先需要理解 Python 2.7 的两个设计事实:
- 默认源码解析编码是 ASCII:Python 2.x 解析器在读取
.py脚本源码时,若未发现显式的编码声明,会默认按 7 位 ASCII 编码来对源文件做词法分析。中文字符的 UTF-8 字节值普遍大于 127,词法解析器在第 1 阶段就会直接触发SyntaxError中断运行。 - 默认字符串类型是字节序列(Byte String):在 Python 2.7 中,字面量
"中文"的类型是str,它本质上只是系统当前编码下的原始字节列表;而真正的抽象文本类型是unicode,需要使用前缀u"中文"表示。如果二者混合操作,Python 会尝试使用默认的 ASCII 编码隐式转换,进而触发UnicodeDecodeError。
二、关键步骤:正确设置 PEP 263 文件头编码声明
为了让 Python 2.7 解释器正确解析脚本中的中文字符,官方在 PEP 263 中给出了明确规范:必须在源码文件的第 1 行或第 2 行添加编码指示魔术注释。
1. 常见的标准写法
以下两种格式是实际开发中最推荐的写法:
# -*- coding: utf-8 -*-或者更加简洁的格式:
# coding=utf-8实际上,Python 解析器使用的是正则表达式 ^[ \t\v]*#.*?coding[:=][ \t]*([-_.a-zA-Z0-9]+) 匹配该行。只要符合该正则,即可生效,但业界通常推荐遵循 Emacs 风格的 # -*- coding: utf-8 -*-,可读性与兼容性更佳。
2. 行号与 Shebang 的相对顺序
需要特别注意编码声明的行数位置限制:
- 如果脚本在 Unix/Linux 环境下作为可执行脚本运行,第 1 行通常是指定解释器路径的 Shebang(如
#!/usr/bin/env python),此时编码声明必须紧跟在第 2 行。 - 如果第 1 行不是 Shebang 且未留空,编码声明必须放置在第 1 行。
- 致命错误:若在编码声明前编写了空行、注释或导入语句(将其推迟至第 3 行或更靠后),Python 解释器将直接忽略该声明,仍然按 ASCII 解析并报错。
#!/usr/bin/env python
# -*- coding: utf-8 -*-

# 这里是中文注释:第1行是Shebang,第2行是PEP 263声明
greeting = u"你好,Python 2.7"
print greeting
三、底层剖析:Python 2.7 解释器如何检索与解析源码
了解解释器在启动时的工作流程,能帮我们在面对多层构建、自动化打包或脚本合并时从容排查问题。
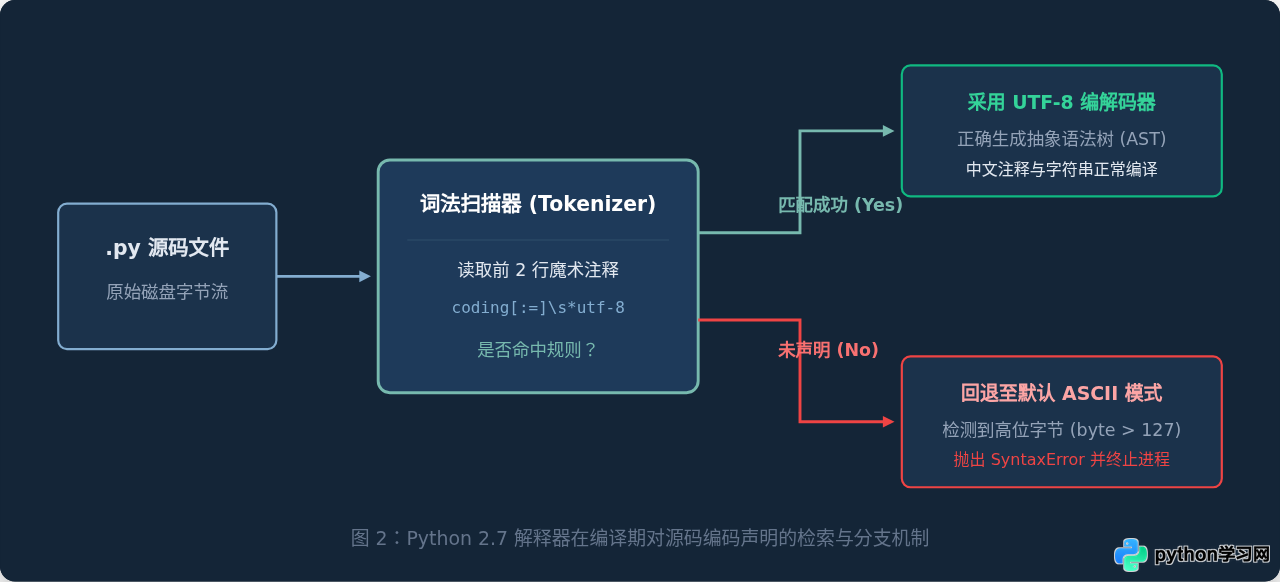
如图 2 所示,当 Python 2.7 解释器载入源文件时,内部词法分析器首先检查文件的开头部分。如果在前两行没有找到符合 PEP 263 正则的字符串,内部编解码器指针将保持默认的 ASCII 模式。一旦其后续词法单元中包含任何大于 0x7F 的字节,便判定为非法字符语法错误。因此,文件头声明的作用是告诉编译器如何将源码字节流读入内存,它并不自动将脚本内所有字符串转换为 Unicode 对象。
四、进阶核心:彻底理清 str 与 unicode 的编解码关系
很多开发者在添加了 # -*- coding: utf-8 -*- 之后,发现脚本可以运行了,但是在做字符串拼接、格式化输出或者向控制台打印时,依然会遇到 UnicodeDecodeError: 'ascii' codec can't decode byte...。这正是由于混淆了 str 和 unicode。
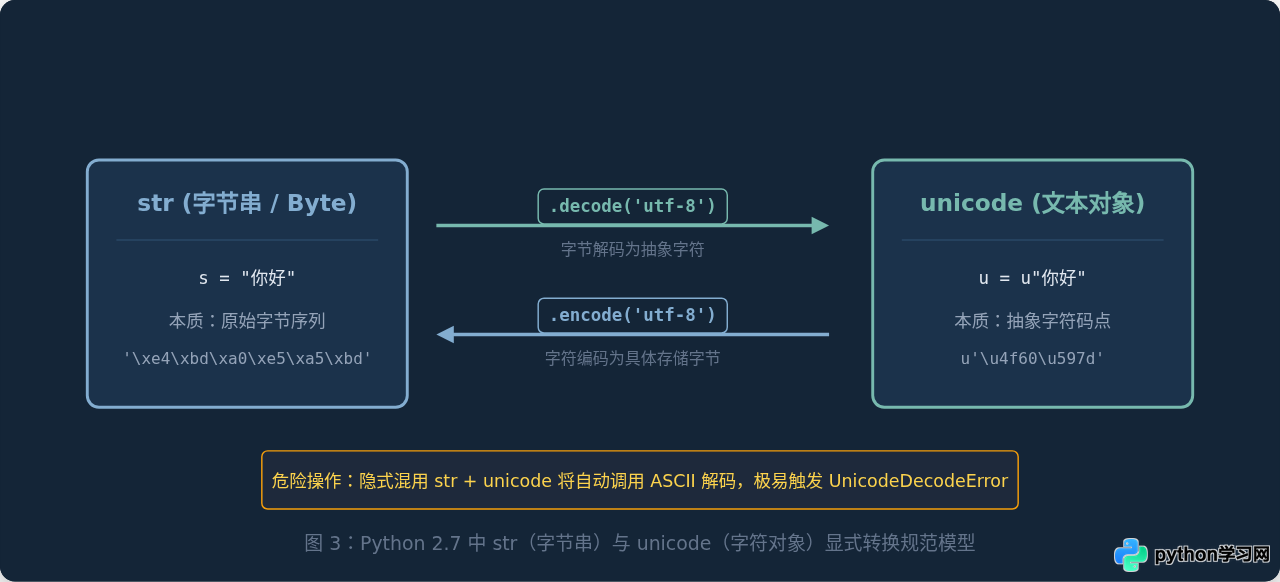
1. 关键转换规则:Decode 与 Encode
| 操作方法 | 起始类型 | 目标类型 | 核心作用与典型应用 |
|---|---|---|---|
s.decode('utf-8') |
str (字节串) |
unicode |
将外部读入的原始字节流解析为 Python 内部处理的 Unicode 字符。 |
u.encode('utf-8') |
unicode |
str (字节串) |
将处理完成的 Unicode 字符序列化为可写盘、可网络传输的特定字节流。 |
2. 永远显式声明 Unicode 字面量
在代码中书写中文常量时,务必养成加上前缀 u 的习惯:
# -*- coding: utf-8 -*-

# 错误示例:定义为 str 字节串
raw_str = "欢迎访问系统"

# 正确示例:显式定义为 unicode 抽象字符对象
uni_text = u"欢迎访问系统"

# 当与其它 unicode 拼接时,绝不会触发隐式 ASCII 解码错误
message = uni_text + u":请核对身份"
print message.encode('utf-8')
五、常见场景实操方案与陷阱规避
1. 文件读写场景:推荐使用 codecs.open 或 io.open
Python 2.7 原生的内建 open() 函数在读取文件时仅返回 str 字节流,开发者需要自行调用 decode,极易遗漏。最佳实践是引入标准库 codecs 或 Python 3 兼容的 io 模块:
# -*- coding: utf-8 -*-
import codecs

# 读文件:自动以 UTF-8 解码为 unicode
with codecs.open('input.txt', 'r', encoding='utf-8') as f:
    content = f.read()  # content 直接为 unicode 类型

# 写文件:接收 unicode 对象并自动以 UTF-8 编码写盘
with codecs.open('output.txt', 'w', encoding='utf-8') as f:
    f.write(u"写入测试:中文数据写入正常\n")
避坑指南:为什么不应滥用 sys.setdefaultencoding('utf-8')?
在网络上经常能看到一些老教程推荐在脚本开头执行 reload(sys); sys.setdefaultencoding('utf-8')。这种做法通过反射强行修改运行时的默认编码,虽然表面上消除了 UnicodeDecodeError,但它会掩盖隐式类型转换的逻辑缺陷,破坏依赖默认 ASCII 规则的第三方库(例如某些 C 扩展模块假设非法 ASCII 会报错),极易在复杂生产项目中引发偶发性严重隐患。标准且健壮的方案是严格执行“Unicode 三明治”原则(在输入边界 decode,在核心逻辑使用 unicode,在输出边界 encode)。
2. 终端打印输出与重定向乱码
在控制台执行 print 时,Python 会根据终端环境变量(如 sys.stdout.encoding)自动尝试编码。但在 Cron 定时任务、管道重定向(例如 python script.py > log.txt)或缺少 LANG 环境变量的 Docker 容器中,sys.stdout.encoding 常退化为 None 或 US-ASCII,从而导致 print 抛出 UnicodeEncodeError。规避方法如下:
# -*- coding: utf-8 -*-
import sys

def safe_print(unicode_text):
    # 若终端编码不可探测,回退到 utf-8 强制编码输出
    encoding = sys.stdout.encoding or 'utf-8'
    print unicode_text.encode(encoding, 'replace')
六、排查总结与快速自查清单
通过规范文件头设置与内部编码规范,可以彻底根治 Python 2.7 项目中的中文处理异常。以下是排查与预防乱码的四个核心维度:
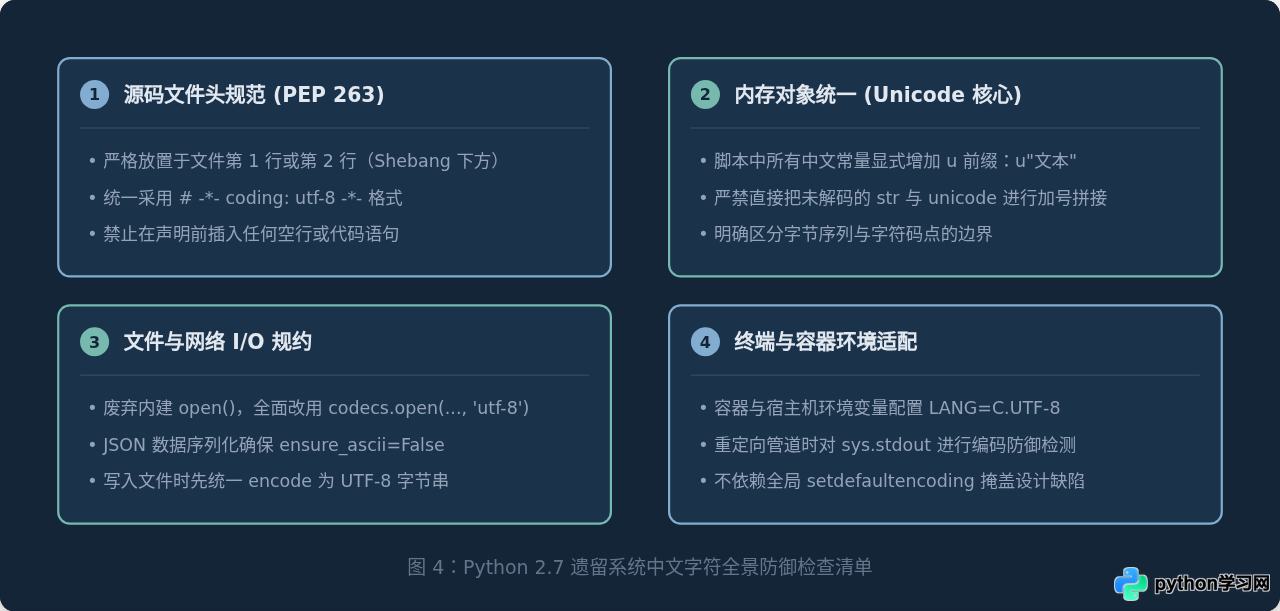
总结而言,解决 Python 2.7 中文问题的关键在于两步建立防火墙:首先在源码文件顶端规范写入 PEP 263 编码声明,解决解释器的编译期解析问题;其次在代码中坚决贯彻显式编码意识,通过 u"" 声明和 codecs 工具链隔绝 str 与 unicode 的混乱交织,确保系统即便在遗留运行环境下也能平稳、可靠地处理中文数据。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















