


Python字符串切片提取子串的常用方法
深入解析Python字符串切片提取子串的常用方法,包括基础语法[start:stop:step]、正负双向索引机制、前缀后缀与中间子串提取、等步长采样与反转技巧,以及越界安全与slice对象复用。
在 Python 中,提取字符串子串最核心、最常用的方式是使用切片语法 string[start:stop:step]。切片操作不仅语法凝练、执行速度快,而且具有天然的边界安全机制,能够在指定区间内提取单个字符、连续子串、等间隔字符序列或反转全文,而不会因为轻微越界抛出异常。
一、切片底层机制:正负双向索引与栅栏分割模型
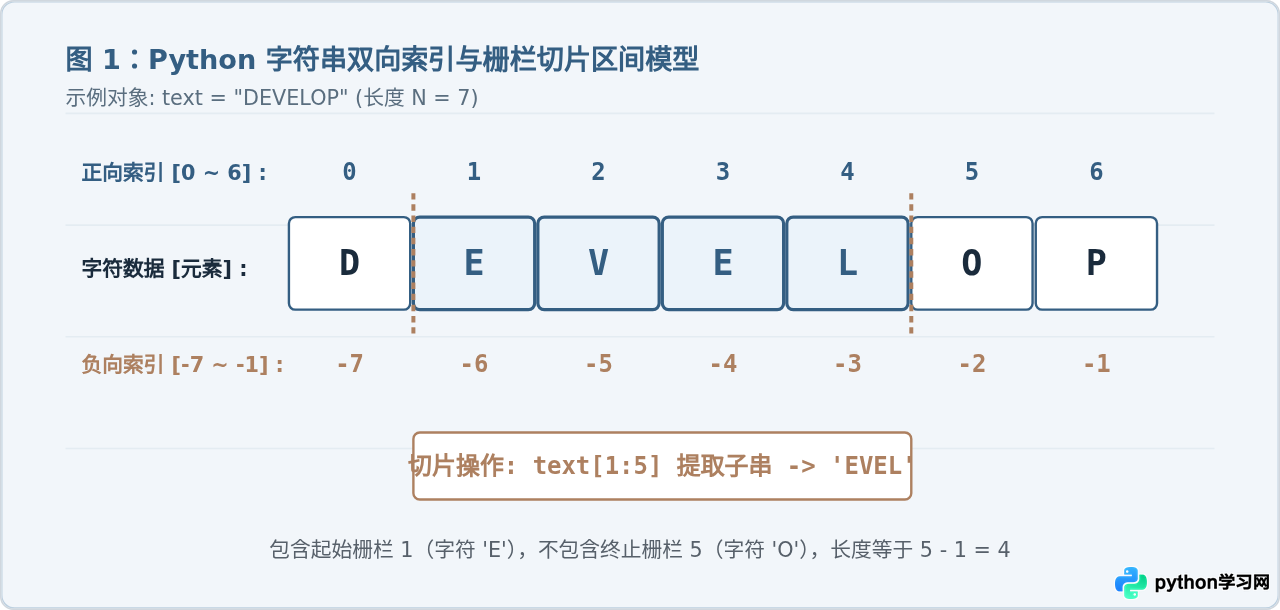
理解 Python 字符串切片,首先需要掌握 Python 的双向坐标体系与“左闭右开”区间规则。Python 字符串中的字符拥有两套对齐的索引序号:从左向右以 0 开始递增的正向索引,以及从右向左以 -1 开始递减的负向索引。
切片区间采用数学上的左闭右开区间 [start, stop),即包含起始位置 start 处的字符,但不包含终止位置 stop 处的字符。更直观的理解方式是“栅栏分割模型”:把索引看作字符之间的分割线或插槽边界,切片提取的就是两条栅栏线之间夹住的全部字符。
二、子串提取的操作步骤与参数推导
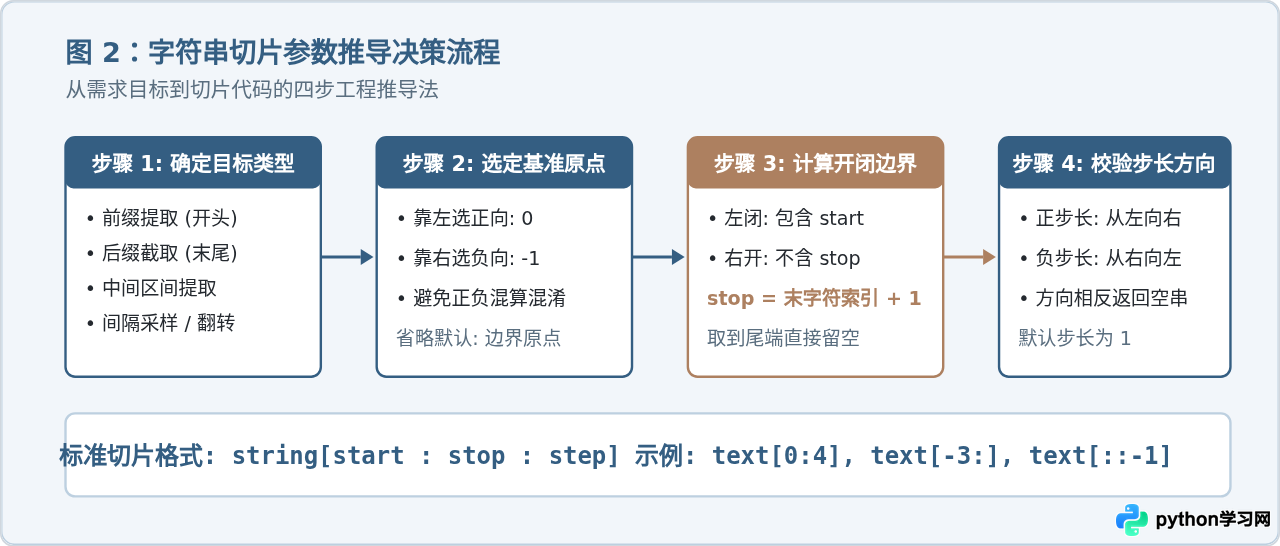
在实际编码时,为了准确写出切片表达式,建议按照以下四个步骤来推导参数:
- 明确截取目标:确定要提取的是固定长度前缀、特定末尾后缀、中间某一段,还是需要跨字符采样。
- 选定参考原点:如果目标靠近头部,优先选择正向索引(0 起步);如果目标靠近末尾,优先选择负向索引(-1 起步)。
- 确定开闭边界:根据“含头不含尾”原则,终止位置
stop必须设定为目标最后一个字符索引加1。如果是提取到字符串末尾,则直接省略stop。 - 核对步长符号:步长
step默认为1(正向从左到右)。若需要逆序提取,step必须为负数,且此时start必须位于stop的右侧。
三、六种常用子串提取场景与代码示例
掌握了参数推导方法后,在日常数据清洗与文本处理过程中,以下六种场景最为常见:
1. 截取前缀或前 N 个字符:s[:n]
当需要截取从字符串最开头算起的 N 个字符时,可直接省略起始索引 start。省略 start 时,Python 默认从索引 0 开始提取。
filename = "20261024_report.csv"

# 提取前 8 个字符作为日期前缀
date_prefix = filename[:8]
print(date_prefix)  # 示例输出: 20261024
2. 截取后缀或末尾 N 个字符:s[-n:]
提取固定结尾子串(如扩展名或序列末尾编号)时,推荐使用负向索引。将 start 设为 -n,并将 stop 留空,表示从倒数第 n 个字符一直截取到字符串末尾。
url = "https://example.com/assets/logo.png"

# 提取末尾 3 个字符作为格式标识
extension = url[-3:]
print(extension)  # 示例输出: png
3. 提取指定中间子串:s[start:stop]
当需要从特定位置截取已知区间的子串时,显式指定 start 和 stop。注意 stop 必须是目标区间末尾字符索引加 1。
serial_code = "DEV-8942-PROD"

# 提取中间的编号 "8942" (索引 4 到 7)
code = serial_code[4:8]
print(code)  # 示例输出: 8942
4. 去除首尾边界字符:s[1:-1]
在解析带有成对括号、引号或特定定界符的文本时,切片 s[1:-1] 可以去除最左侧和最右侧各 1 个字符,非常实用。
raw_token = "[AUTH_TOKEN_KEY]"

# 去除首尾的方括号
token = raw_token[1:-1]
print(token)  # 示例输出: AUTH_TOKEN_KEY
5. 等间隔跳跃提取:s[::step]
通过设置第三个参数 step,可以按固定间隔采样字符。例如提取奇数位或偶数位字符、提取隔位编码等。
data_stream = "A1B2C3D4E5"

# 提取全部偶数位字母 (索引 0, 2, 4, 6, 8)
letters = data_stream[::2]
print(letters)  # 示例输出: ABCDE

# 提取全部奇数位数字 (索引 1, 3, 5, 7, 9)
numbers = data_stream[1::2]
print(numbers)  # 示例输出: 12345
6. 快速反转字符串:s[::-1]
将步长设为 -1,且省略 start 和 stop,Python 会自动从最右侧开始,依次向左步进 1 个字符,从而生成一个逆序的新字符串。
original = "Python"

# 将字符串完全倒序
reversed_str = original[::-1]
print(reversed_str)  # 示例输出: nohtyP
四、越界安全机制与方向陷阱
在直接使用下标访问单个字符(如 s[i])与使用切片(如 s[start:stop])之间,存在一个非常关键的工程差异:切片操作永远不会引发 IndexError 异常。
如果指定的切片边界超出了字符串实际长度,Python 会自动将边界截断(Clamp)至合法边界。即使 start 或 stop 远超范围,也只会返回有效部分的截断子串,或者返回空字符串 ""。
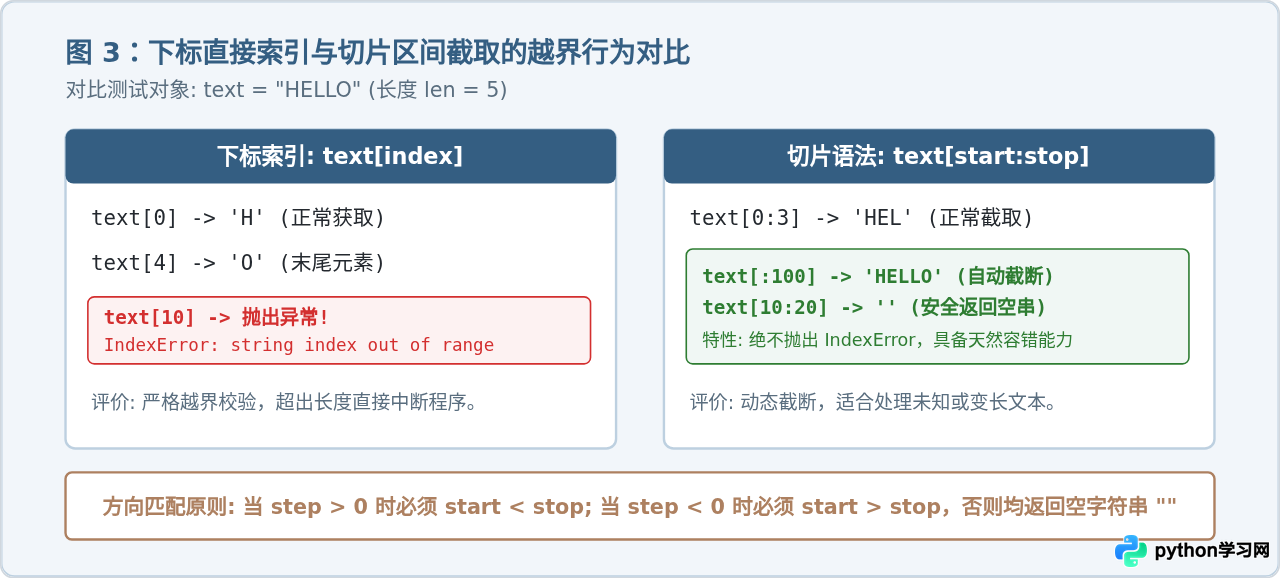
虽然切片具有容错能力,但在编写切片时必须注意步长方向与边界位置的一致性:
- 当步长为正(如默认的
1)时,切片要求从左向右移动。如果设置s[5:2],由于起始点在终止点右侧,搜索无法向前推进,Python 会直接返回空字符串""而不会报错。 - 同理,当步长为负(如
-1)时,切片要求从右向左移动。如果设置s[2:5:-1],同样会返回空字符串""。
五、工程化实践:使用 slice 对象实现切片复用
在编写处理固定宽度文本文件(如银行数据接口、老系统报文、固定格式日志)的代码时,如果在每个位置硬编码 [0:8]、[8:16]、[16:24],一旦格式调整,维护成本极高。
Python 提供了内置的 slice() 函数,它返回一个可命名的切片对象,语法为 slice(start, stop, step)。通过将切片命名化,可以大幅提升代码的可读性与复用性。
# 设定固定列宽协议的切片模式
RECORD_ID = slice(0, 8)
USER_NAME = slice(8, 20)
AMOUNT    = slice(20, 30)

# 解析固定宽度数据行
row_data = "10029384ZhangSan    0000045000"

record_id = row_data[RECORD_ID].strip()
user_name = row_data[USER_NAME].strip()
amount    = float(row_data[AMOUNT]) / 100.0

print(f"ID: {record_id}, 用户: {user_name}, 金额: {amount}")
# 示例输出: ID: 10029384, 用户: ZhangSan, 金额: 450.0工程提示:字符串切片会创建一个新的字符串对象。由于 Python 字符串是不可变类型(Immutable),对原始字符串进行切片不会修改原对象,这保证了多线程或复杂数据流中的数据安全性。
六、核心方法总结与速查
为了便于在日常开发中随时查阅,下图对 Python 字符串切片的典型场景、语法模板、示例及结果进行了系统总结。
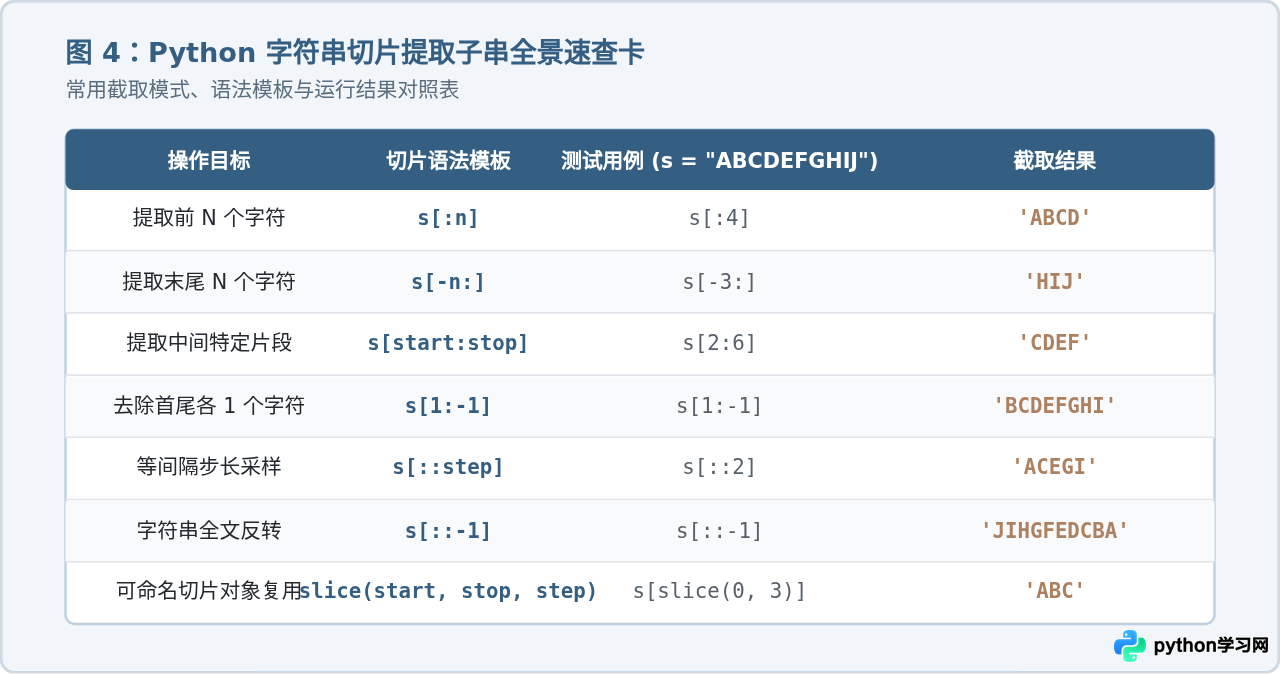
综上所述,Python 字符串切片以 [start:stop:step] 为统一接口,结合左闭右开与双向索引机制,兼顾了高效性与边界安全性。在日常开发中,建议牢记“含头不含尾”原则,善用负索引定位末尾字符,并在处理固定协议格式时使用 slice() 对象提升代码质量。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















