


Python三种排序方式怎么选:内置函数、手写算法与第三方库
深入对比Python中内置函数、手写算法与第三方库三种排序方式的适用边界、性能特征与工程选型依据,助你在不同场景下做出正确选择。
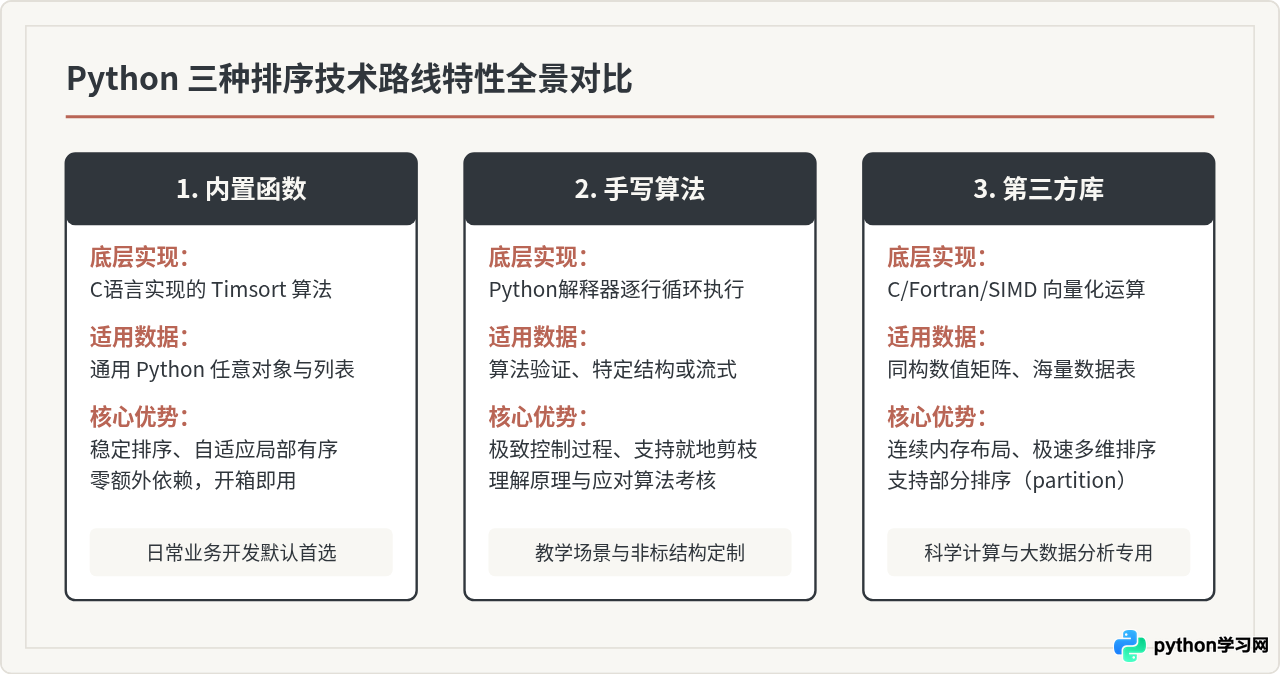
面对排序需求时,Python开发者通常有三条主要路径可选:使用语言自带的内置函数(sort() 和 sorted())、纯手写经典算法(如快速排序、归并排序),或是借助第三方高性能库(如 NumPy、Pandas)。结论在工程实践中其实非常明确:绝大多数普通业务逻辑首选内置函数,海量同构数值计算依托第三方库,而手写算法的主要价值则在于教学研究、定制化约束与应对特定硬件边界。本文将通过原理剖析、性能对照及典型场景拆解,帮助你在面对不同数据规模和工程目标时做出精准抉择。
一、内置函数:工程开发的不二之选
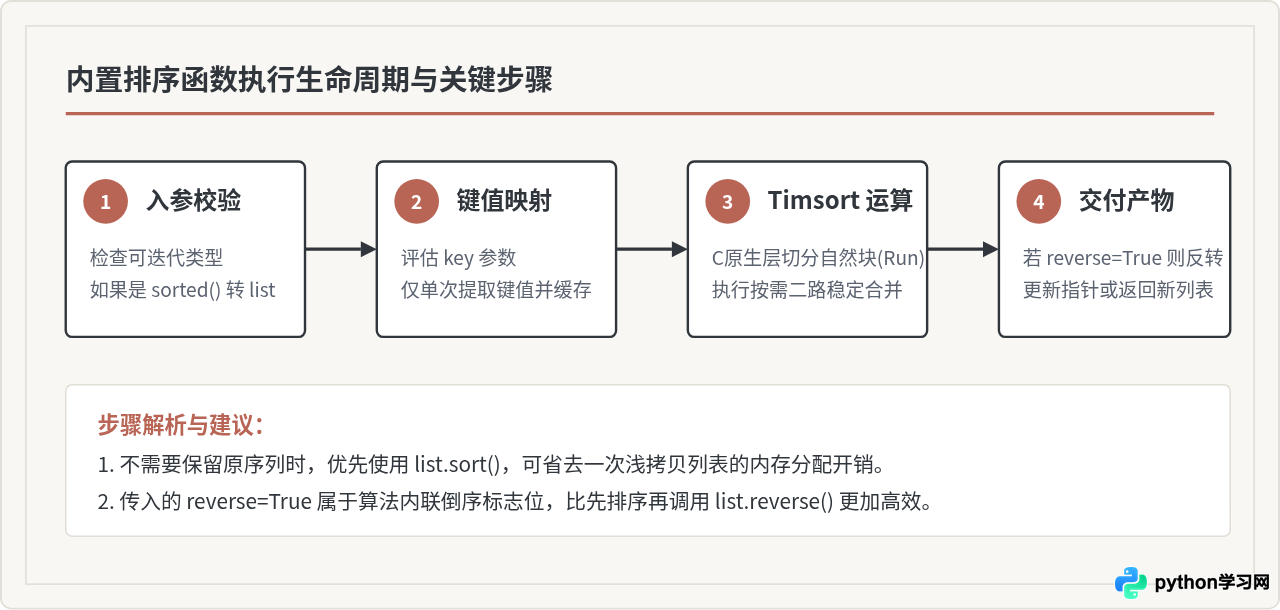
Python提供了两种内建排序接口:列表自身的原地排序方法 list.sort(),以及接受任意可迭代对象并返回新列表的全局函数 sorted()。这两个函数底层均使用 Timsort 算法(一种结合了插入排序与归并排序思想的自适应混合排序算法)。
Timsort在C底层实现,高度优化了CPU缓存与指针比对。更关键的是,它具备稳定性(相等的元素在排序后保持原有先后相对顺序),且在面对真实业务中常见的“部分已排序数据”时,时间复杂度能从最坏的 \(O(n \log n)\) 自动蜕化为 \(O(n)\)。
核心用法示例
# 1. 原地修改(仅适用于list,节省新建列表的内存)
data = [5, 2, 9, 1, 5, 6]
data.sort()
# 示例输出:data 变为 [1, 2, 5, 5, 6, 9]

# 2. 返回新列表(保留原对象,支持元组、集合、生成器等任意可迭代对象)
raw_tuple = (14, 3, 77, 21)
sorted_list = sorted(raw_tuple)
# 示例输出:sorted_list 为 [3, 14, 21, 77],raw_tuple 保持不变

# 3. 灵活的多字段与自定义键值排序(通过 key 参数)
records = [
    {"name": "Alice", "score": 92, "age": 24},
    {"name": "Bob", "score": 85, "age": 22},
    {"name": "Charlie", "score": 92, "age": 20}
]
# 按成绩降序;若成绩相同,按年龄升序
records.sort(key=lambda x: (-x["score"], x["age"]))
# 示例输出:
# [
#   {'name': 'Charlie', 'score': 92, 'age': 20},
#   {'name': 'Alice', 'score': 92, 'age': 24},
#   {'name': 'Bob', 'score': 85, 'age': 22}
# ]key 内部编写高耗时的重度计算逻辑。key 函数对列表中的每个元素只调用一次并缓存提取出的键值(Key Extraction),但如果在 lambda 或函数内进行网络调用或深层遍历,仍会显著拖慢总体耗时。
二、手写排序算法:学习理解与特殊定制
很多初学者会疑惑:既然内置排序这么优秀,为什么教材和面试中还要反复要求手写冒泡、快排或归并排序?
手写排序的主要价值从来不是在常规业务中追求速度。事实上,由于Python解释器的循环开销和动态类型检查,用纯Python手写的快速排序,其运行耗时往往是内置 sort() 的 20 到 50 倍以上。手写算法的真正应用场景在于:
- 面试与计算机基础教学:理解分治法、递归调用栈、原地指针移动(In-place Partitioning)以及时间复杂度分析。
- 深度非标定制:例如在内存极其受限的微控制器(如运行 MicroPython)中实现固定内存占用的外排序、在单链表或流式管道中进行就地归并、或者在排序比较的同时收集特殊的统计指标。
手写快速排序代码示例(原地分区版)
def quick_sort(arr, low=0, high=None):
    """
    原地快速排序(三数取中优化版),避免全局切片产生额外内存开销
    """
    if high is None:
        high = len(arr) - 1

    if low < high:
        # 获取分区索引
        pivot_index = partition(arr, low, high)
        # 递归排序左右子区间
        quick_sort(arr, low, pivot_index - 1)
        quick_sort(arr, pivot_index + 1, high)
    return arr

def partition(arr, low, high):
    pivot = arr[high]  # 选择基准点
    i = low - 1
    for j in range(low, high):
        if arr[j] <= pivot:
            i += 1
            arr[i], arr[j] = arr[j], arr[i]
    arr[i + 1], arr[high] = arr[high], arr[i + 1]
    return i + 1

# 示例验证:
sample = [33, 10, 55, 71, 29, 15]
quick_sort(sample)
# 示例输出:sample 变为 [10, 15, 29, 33, 55, 71]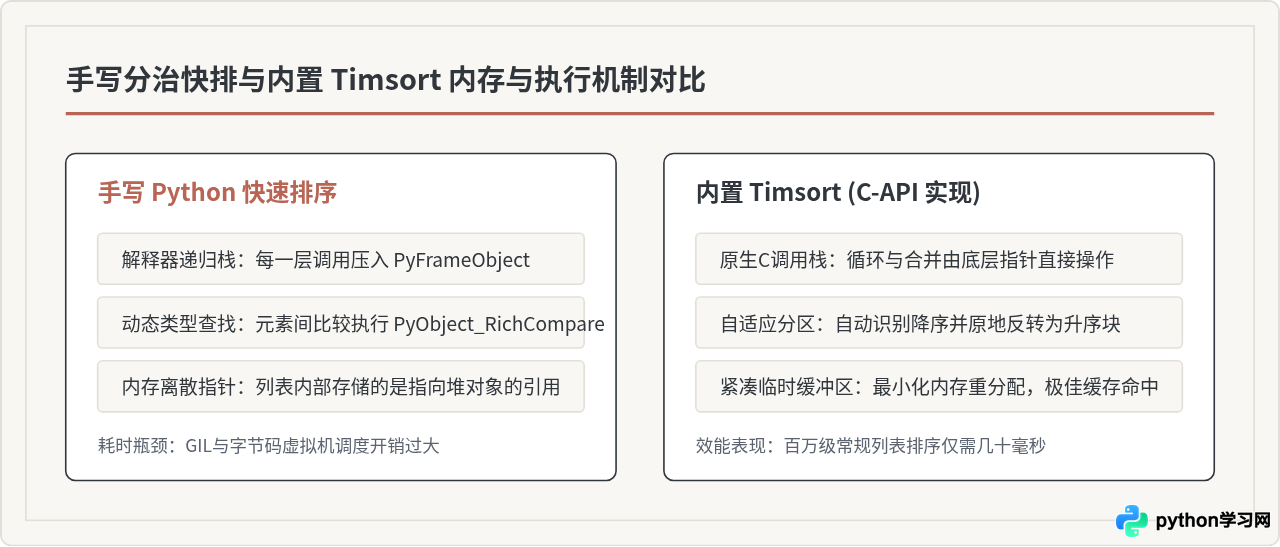
三、第三方库:面向海量数值与工程分析
当处理的数据规模跨越到数十万、数千万,且数据具备同构数值型(如连续整数、浮点数向量)时,Python内置列表就会显现出明显的内存与计算瓶颈。因为普通 list 存储的是对象的指针,访问每个数字都需要一次解引用。此时,以 NumPy 或 Pandas 为代表的第三方库成为绝对主力。
NumPy数组在底层拥有连续的C原生内存块,其内部实现的 numpy.sort() 和 argsort() 不仅使用高度优化的快速排序、堆排序与基数排序,更支持单指令多数据流(SIMD)并行加速。对于仅需要获取前 K 个最小/最大元素的场景,NumPy 提供的 argpartition 更是可以在 \(O(n)\) 线性时间内完成部分排序。
NumPy 高性能排序示例
import numpy as np

# 构造包含 1,000,000 个随机浮点数的连续数组
arr = np.random.rand(1_000_000)

# 1. 高性能就地排序 (底层默认快速排序)
arr.sort()

# 2. 间接排序:返回排好序的原索引序列(常用于协同排序其他关联矩阵)
indices = np.argsort(arr)

# 3. 极速部分排序(只找出最小的 5 个元素,时间复杂度 O(N))
top5_indices = np.argpartition(arr, 5)[:5]
top5_values = arr[top5_indices]
四、三种排序方式选型决策模型
为了帮助你在实际开发中不再纠结,可以通过以下三个核心维度快速评估:
- 数据结构与类型:若数据是通用字典、自定义对象、字符串或异构列表,直接选内置
sort() / sorted();若是同构的大规模数值矩阵、表格列数据,选用NumPy / Pandas。 - 稳定性需求:如果业务依赖多个属性先后排序(如先按时间排序,再按类别稳定分组),必须选内置
sort()(Timsort保证稳定性)或 NumPy 的kind='stable'(归并排序)。手写快速排序通常是不稳定的。 - 维护成本与环境依赖:内置函数不需要额外安装任何第三方依赖,是编写轻量工具脚本、通用库的首选;若项目本身属于数据科学或机器学习流水线,引入 NumPy/Pandas 则是自然选择。
| 对比维度 | 内置函数 (sort / sorted) | 手写排序算法 (如快排) | 第三方库 (NumPy / Pandas) |
|---|---|---|---|
| 底层引擎 | C 语言原生 (Timsort) | Python 字节码虚拟机循环 | C / Fortran 编译库 + SIMD 指令 |
| 执行速度 | 极快(单核通用极限) | 较慢(存在解释器开销) | 针对纯数值计算极其出色 |
| 排序稳定性 | 严格保证稳定 | 视具体算法而定(快排通常不稳定) | 可选(默认quicksort不稳定,可指定stable) |
| 外部依赖 | 零依赖(Python标准库) | 零依赖 | 需安装外部扩展包 |
| 典型场景 | 后端接口、业务数据组装、日常脚本 | 算法竞赛、教学面试、极端外排定制 | 量化分析、图像处理、海量数值挖掘 |
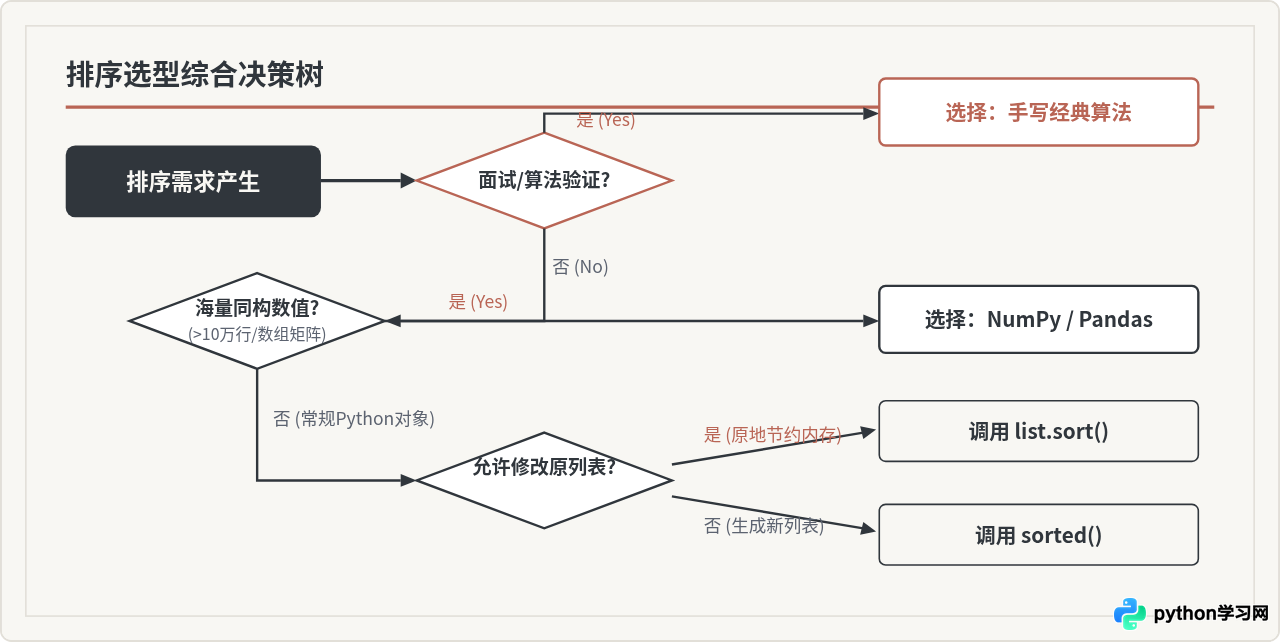
总结与建议
在Python开发中选择排序方式,本质上是在开发效率、维护性与运行时硬件效率之间寻找平衡:
- 95% 的业务场景:坚定不移地选择内置的
sort()或sorted()。它是经过数十万人检验的工业级实现,自适应性强且高度稳定。 - 科学计算与矩阵分析:拥抱
NumPy或Pandas,用底层紧凑连续的内存布局换取百倍的吞吐提升。 - 原理探究与特定算法训练:在草稿纸或教学代码中手写快排、堆排与归并排,但在生产环境的代码提交中,请保持克制,将其替换为语言的标准工具。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















