


HanLP与Jieba:Python中文自然语言处理库怎么选
针对Python中文自然语言处理场景,深度对比HanLP与Jieba的底层原理、性能开销、功能边界与工程适用性,提供清晰务实的技术选型指南。
一、底层原理与技术路线的根本差异
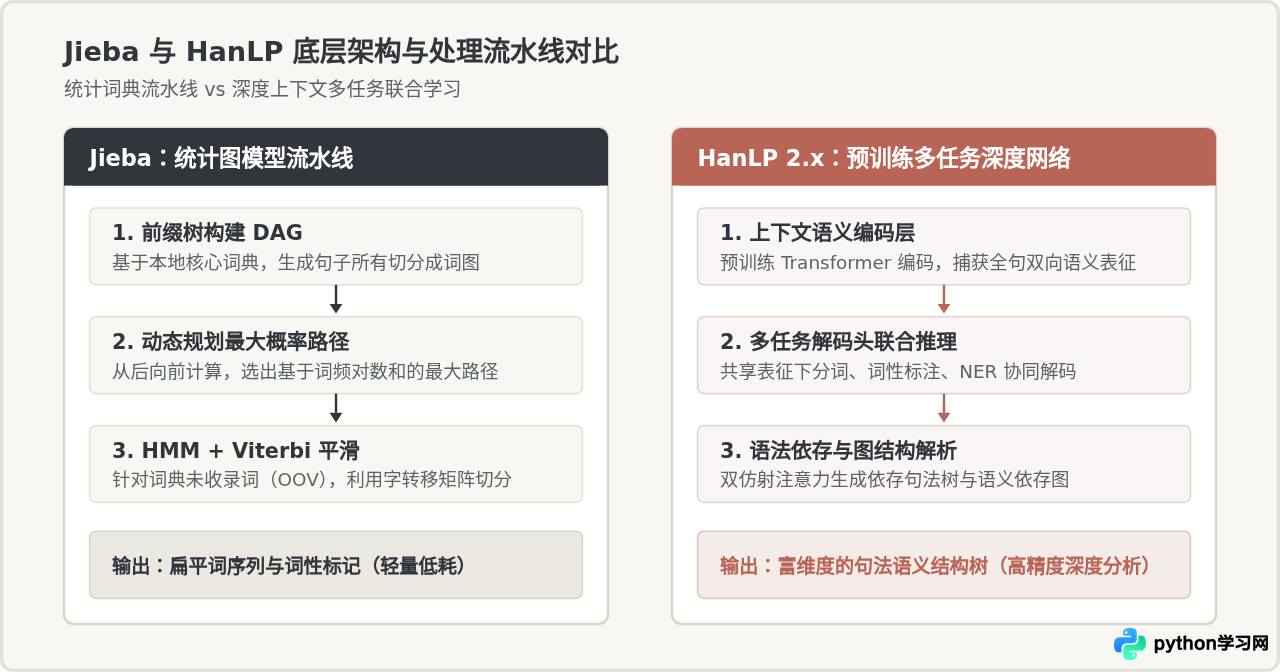
Jieba 与 HanLP 并非同一技术维度的简单迭代,而是代表了中文自然语言处理中两种截然不同的架构路线:基于统计词典的轻量级规则流水线,与基于深度神经网络的端到端多任务学习框架。
Jieba 的核心逻辑建立在高效的词典查找与概率图模型之上:首先通过前缀词典构建输入文本所有切分可能性的有向无环图(DAG),利用动态规划查找基于词频的最大概率路径,得出已知词的最佳组合;对于词典中未收录的未登录词(OOV),则借助预先训练的隐马尔可夫模型(HMM)与 Viterbi 算法进行字级状态转移解码。这一设计使 Jieba 完全摆脱了重型计算图的束缚,纯 Python 编写且依赖极少,进程加载速度往往在 0.5 秒以内。
HanLP(以 2.x 原生 Python 版本为代表)则将架构重心转向了现代上下文语言模型。它采用多任务联合学习(Multi-Task Learning)体系,底层通常由轻量化或全尺寸的预训练 Transformer(如 Electra、RoBERTa)提取上下文词向量,上层针对分词(CWS)、词性标注(POS)、命名实体识别(NER)以及依存句法分析(DEP)并行挂载专用解码头。这使得 HanLP 具备理解全局句法约束的能力,但在启动时需要加载权重文件,并占用可观的显存或系统内存。
二、操作步骤与调用代码实践
在工程接入阶段,两者的安装依赖、模型分发以及 API 调用逻辑具有显著差异。以下为标准生产环境下的接入流程与验证方法。
步骤 1:环境安装与依赖管理
在 Python 虚拟环境中执行安装。Jieba 无外部编译或复杂二进制依赖;HanLP 则依赖 PyTorch 计算后端:
# 1. 安装 Jieba(纯 Python 包,轻量秒级完成)
pip install jieba

# 2. 安装 HanLP 2.x(建议提前配置与当前 CUDA/CPU 匹配的 PyTorch)
pip install torch --index-url https://download.pytorch.org/whl/cpu
pip install hanlp
步骤 2:Jieba 典型调用范式与词典注入
Jieba 支持精确模式、全模式和搜索引擎模式,并能直接加载纯文本格式的自定义词典(格式为:词语 词频 词性,空格分隔):
import jieba
import jieba.posseg as pseg

# 1. 加载用户自定义词典(避免特定领域专有名词被拆分)
# dict.txt 内容示例: 自然语言处理 3 n
jieba.load_userdict("dict.txt")

text = "南京市长江大桥欢迎中外游客参观指导"

# 2. 精确切分模式
words = jieba.lcut(text, cut_all=False)
print("Jieba 分词结果:", words)

# 3. 词性标注模式
words_pos = pseg.lcut(text)
print("Jieba 词性标注:", [(w, flag) for w, flag in words_pos])
示例输出:
Jieba 分词结果: ['南京市', '长江大桥', '欢迎', '中外', '游客', '参观指导']
Jieba 词性标注: [('南京市', 'ns'), ('长江大桥', 'ns'), ('欢迎', 'v'), ('中外', 'b'), ('游客', 'n'), ('参观指导', 'v')]
步骤 3:HanLP 2.x 多任务管道加载与高级解析
HanLP 采用 Pipeline 模式统一多任务调用。初次运行会自动从官方托管仓库拉取并缓存预训练模型权重:
import hanlp

# 加载多任务预训练管道(涵盖分词、词性标注、命名实体识别与依存句法)
# 默认使用轻量高效的多任务预训练模型
nlp = hanlp.load(hanlp.pretrained.mtl.CLOSE_TOK_POS_NER_SRL_DEP_SDP_CON_ELECTRA_BASE_ZH)

text = "南京市长江大桥欢迎中外游客参观指导"
doc = nlp(text)

# 打印分词与词性
print("HanLP 分词结果:", doc['tok/fine'])
print("HanLP 词性标注:", doc['pos/ctb'])

# 打印命名实体识别(NER)
print("HanLP 实体识别:", doc['ner/msra'])

# 打印依存句法关系(DEP)
print("HanLP 依存句法:", doc['dep'])
示例输出:
HanLP 分词结果: ['南京市', '长江大桥', '欢迎', '中外', '游客', '参观', '指导']
HanLP 词性标注: ['NR', 'NR', 'VV', 'JJ', 'NN', 'VV', 'NN']
HanLP 实体识别: [('南京市', 'LOCATION', 0, 1), ('长江大桥', 'FACILITY', 1, 2)]
HanLP 依存句法: [{'id': 1, 'head': 2, 'rel': 'nmod'}, {'id': 2, 'head': 3, 'rel': 'nsubj'}, {'id': 3, 'head': 0, 'rel': 'root'}, ...]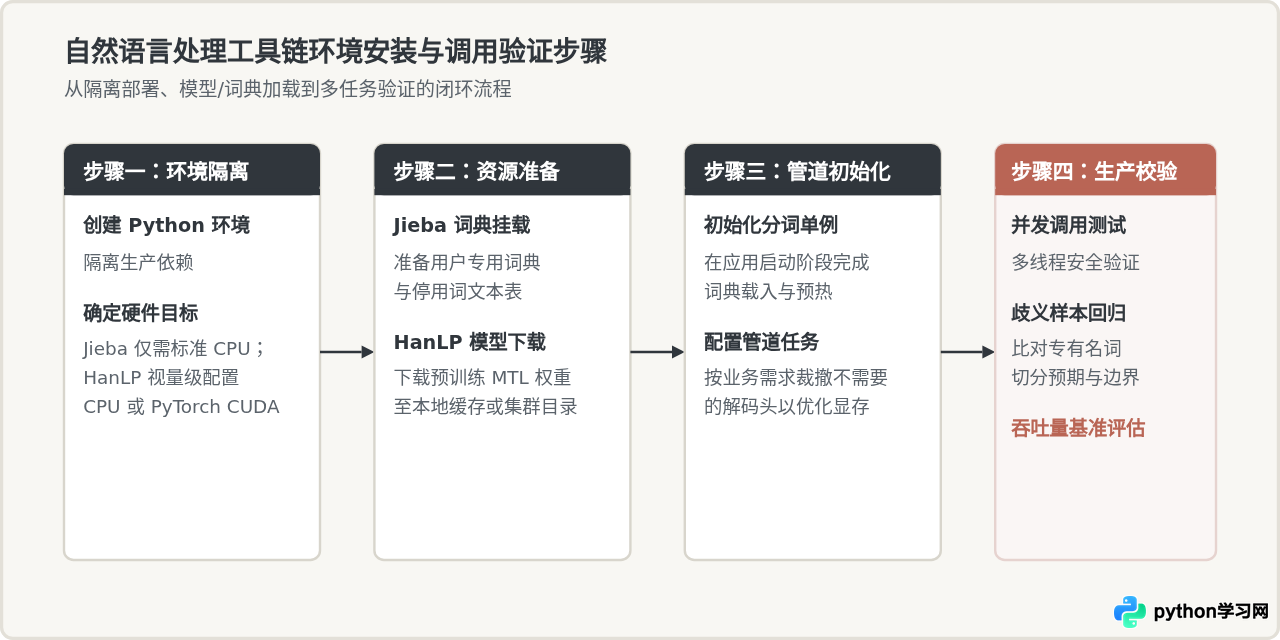
三、核心能力维度对比:准确度、性能与功能边界
为了直观评估两者的工程适用性,我们从分词机制、语义理解层次以及系统资源消耗三个核心维度展开详细分析。
| 评估维度 | Jieba (结巴中文分词) | HanLP 2.x (深度多任务版) |
|---|---|---|
| 底层算法 | 前缀树 + 动态规划 + HMM (Viterbi) | 预训练 Transformer (Electra/BERT) + 多任务联合学习 |
| 冷启动时间 | 极快(通常 < 0.5 秒) | 较慢(加载模型权重需 3 至 8 秒) |
| 内存/显存开销 | 极低(约 30MB ~ 60MB) | 较高(CPU 模式约 0.8GB ~ 1.5GB;GPU 显存需 1GB+) |
| 未登录词识别 (OOV) | 基于字发射概率平滑,容易出现过度切分 | 基于双向上下文语境,新词与专有名词识别率极高 |
| 命名实体识别 (NER) | 无专用模型(仅依赖粗粒度词性如 nr、ns 映射) | 支持多领域细粒度 NER(人名、机构、地名、专业术语等) |
| 句法与语义解析 | 不支持 | 支持完整的依存句法分析(DEP)与语义依存分析(SDP) |
| 自定义词典干预 | 原生支持,即改即生效,支持强制调权 | 支持词典强制优先与白名单,但权重微调相对复杂 |
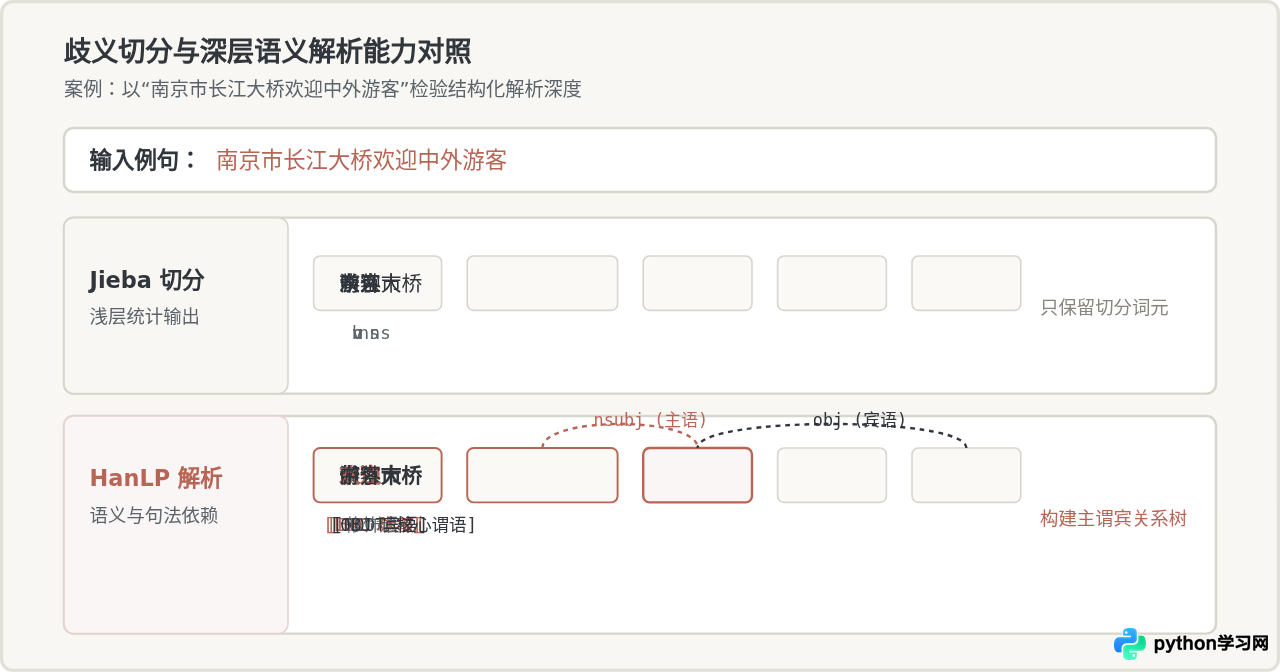
在中文自然语言处理中,交搭歧义与组合歧义是衡量工具分析深度的试金石。以典型句子“南京市长江大桥”为例:
- 若仅考虑词频,可能产生“南京市 / 长江 / 大桥”与“南京 / 市长 / 江大桥”之间的歧义。Jieba 依赖统计词典,通常能正确匹配“南京市”与“长江大桥”,但当语境变更为“市长亲自来到大桥”时,静态概率可能受到词频分布的干扰。
- 更关键的差异在于深层语法结构的缺失:Jieba 只能输出孤立的词序列,无法说明“长江大桥”在句中是充当主语、宾语还是定语。而 HanLP 不仅能精准识别“南京市”为行政区划(NS)、“长江大桥”为建筑地标实体(FACILITY),还能通过依存关系树明确指出“长江大桥”与核心动词“欢迎”之间的名次主语(nsubj)从属关系。
四、具体业务场景下的选型决策
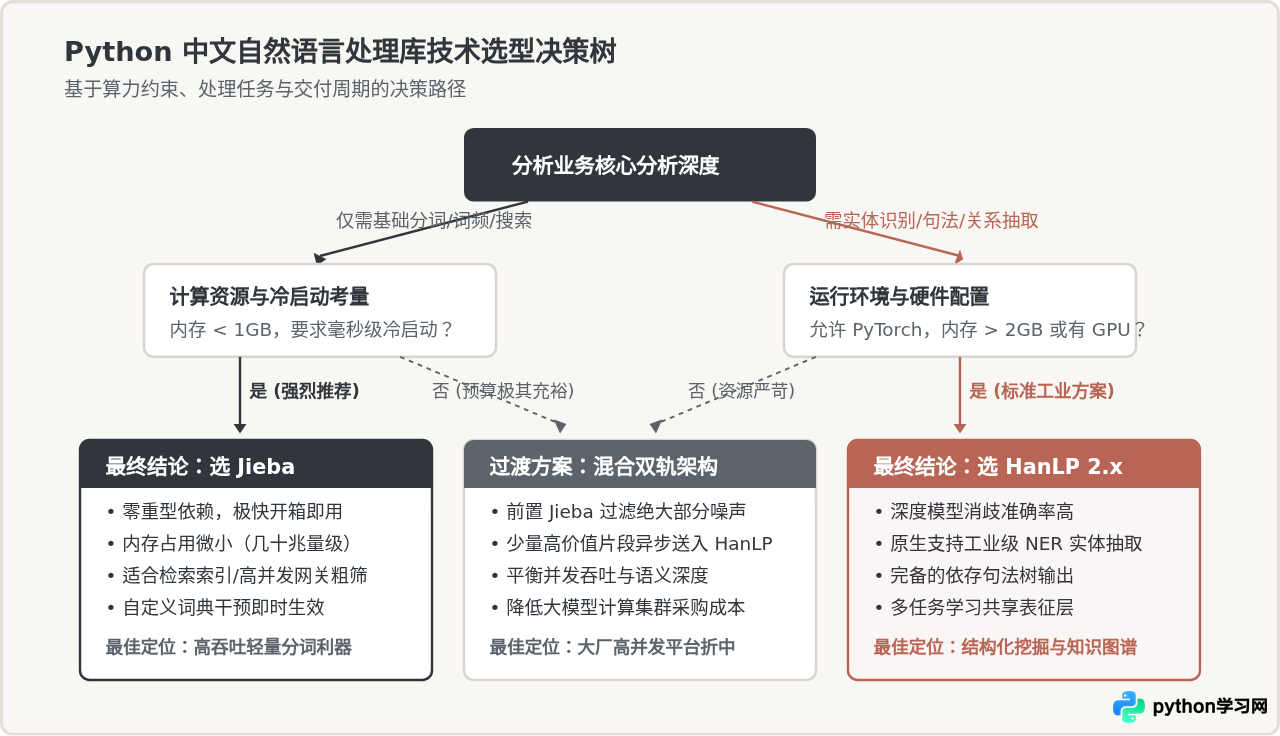
为了摆脱空泛的技术优缺点罗列,我们结合研发团队在实际交付中最常遇到的四类典型业务场景,给出确定性的选择依据:
场景 1:全文检索与日志系统分词(推荐:Jieba)
在 Elasticsearch、OpenSearch 或 自研日志分析服务中,分词器的主要任务是将长文本切割为倒排索引中的 Term。这类业务往往伴随极高的写入并发与海量文本流,对单核吞吐量极其敏感,且无需复杂的上下文句法推导。Jieba 的前缀树扫描能够提供每秒数万字的稳定吞吐,单进程常驻内存仅数十兆,可极低成本地随应用水平扩容。
场景 2:垂直行业知识图谱与结构化抽取(推荐:HanLP)
在金融研报解析、医疗病历结构化、法律合同合规审查等场景下,核心目标是从长非结构化文本中抽取“主体-关系-客体”三元组。此时不仅需要识别特定机构、产品或法规名称(NER),还需要通过依存句法(DEP)理顺从属关系。Jieba 由于缺乏句子级别语法树支持,无法判定两个实体间是否存在修饰或施受事关系,而 HanLP 2.x 的联合解析头能直接为知识提取提供高可靠的语法拓扑结构。
场景 3:边缘设备、Serverless 与低算力容器(推荐:Jieba)
在 Serverless(如 AWS Lambda、阿里云函数计算)或 512MB 规格的轻量微服务 Pod 中,函数冷启动耗时直接决定了用户首屏延迟。HanLP 初始化时加载深度学习权重需要数秒,且瞬时内存极易突破规格限制发生 OOM(Out Of Memory)。Jieba 零外部重型依赖,冷启动在百毫秒内完成,是资源受限环境下的不二之选。
场景 4:生产级混合双轨架构方案(兼顾效率与深度)
在大型数据处理平台中,二者往往并非互斥,而是协同构成阶梯式处理流水线:
第一道网关由 Jieba 负责轻量初筛,进行高吞吐的敏感词命中、基于 TF-IDF 的关键词提取与快速粗分类;过滤出的高价值关键文本(如命中合规风险的段落)再异步投递至专用的深度学习计算集群,由 HanLP 运行完整的实体抽取与句法树分析。这种“快慢分离”的设计在保障集群吞吐的同时,大幅降低了深度模型的硬件开销。
五、常见认知误区与规避建议
深度学习的精度提升并非免费。在微服务架构中,如果部署了 50 个 Pod 实例,每个实例若使用 HanLP 2.x,将额外消耗至少 50GB 至 100GB 的集群物理内存,冷启动时间也会从秒级延长到数十秒,显著增加发布与弹性扩缩容的等待时间。在仅需要分词和词频统计的场景下,使用 HanLP 属于典型的过度设计。
词典匹配是静态的。当业务中出现诸如“南京市长江大桥”或“乒乓球拍卖完了”这类组合型交搭歧义时,盲目添加词典往往会顾此失彼:调高了“长江大桥”的词频,可能破坏后续“长江 / 沿岸 / 大桥”的切分;调高了“拍卖”,则破坏了“球拍 / 卖 / 完”的逻辑。语义层面的消歧必须依赖上下文感知机制,此时应果断转向 HanLP 这一类上下文感知模型,而非继续堆砌词典规则。
国内许多早期博客提及的 HanLP 依赖 Java 环境、jpype 桥接或基于传统统计感知机(Perceptron)。而现代的 HanLP 2.x 是纯 Python 原生实现的深度多任务模型,底层驱动为 PyTorch。在进行方案调研时,务必根据自身团队的技术栈(Java 还是 Python 生态)明确所参考的具体版本,避免在环境配置与调用代码上走弯路。
六、总结与落地建议
在 Python 中文自然语言处理的技术选型中,决策的核心从来不是“哪个工具更先进”,而是业务场景需要的分析深度与系统能承受的资源开销之间的权衡:
- 当业务属于宽泛过滤、搜索引擎倒排索引、关键词提取、低延迟微服务网关时,Jieba 能够以极低的资源占用、秒级的部署速度和高度可控的词典调整机制满足生产要求。
- 当业务属于政企知识图谱、合同要素抽取、深度问答、长难句结构化分析时,HanLP 2.x 能够提供工业级的命名实体识别与依存句法拓扑,帮助系统真正理解文本背后的实体关联与语义脉络。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















