


Python中文分词库jieba与pkuseg性能准确度对比

本文对比分析Python中常用的中文分词库jieba与pkuseg。详细讲解jieba的三种分词模式、自定义词典及停用词处理,并介绍pkuseg的多领域预训练模型优势。通过京东评论数据实例,对比两者在分词准确率与执行速度上的表现,为不同场景下的分词工具选择提供参考。
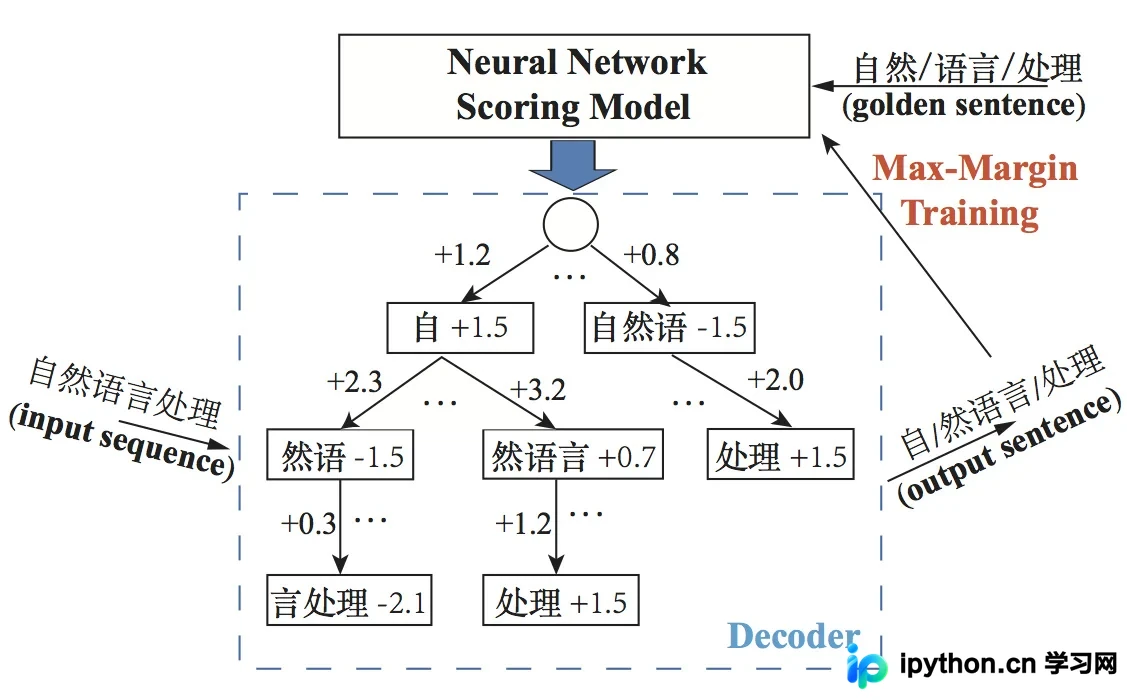
中文分词(Chinese Word Segmentation)是指将连续的中文文本切分成独立的词语单元。与英文天然以空格分隔单词不同,中文字符之间没有明显的分隔符,且单个汉字与词语的含义往往存在巨大差异,这使得中文分词的复杂度远高于英文分词。
分词技术是自然语言处理(NLP)的基础环节,广泛应用于以下场景:
- 搜索优化与关键词提取(例如百度指数分析)。
- 语义分析与智能问答系统(如客服机器人)。
- 非结构化文本内容的处理,例如社交媒体舆情监控(如微博热榜)。
- 文本聚类与自动分类(如行业分类标签生成)。
Python中文分词
Python生态中提供了多种中文分词库,常见的包括:
- jieba(结巴分词)。
- THULAC(清华大学自然语言处理与社会人文计算实验室开发)。
- pkuseg(北京大学语言计算与机器学习研究组开发)。
- SnowNLP。
- pynlpir。
- CoreNLP。
- pyltp。
在上述库中,前三种较为常见,它们在易用性、准确率和性能方面表现均衡。笔者早期主要使用结巴分词,近期则开始尝试pkuseg,下文将详细对比两者的使用方法。
结巴分词
简介
“结巴”中文分词旨在成为Python中最优秀的中文分词组件,主要特点包括:
- 支持三种分词模式:
- 精确模式:试图将句子最精确地切开,适用于文本分析。
- 全模式:扫描句子中所有可能成词的词语,速度极快,但无法解决歧义问题。
- 搜索引擎模式:在精确模式基础上对长词再次切分,以提高召回率,适合搜索引擎场景。
- 支持繁体中文分词。
- 支持用户自定义词典。
jieba分词实例
我们以京东商场美的电器的用户评论为例,演示jieba分词的效果。若未安装jieba库,需在命令行执行pip install jieba进行安装,随后即可开始分词操作。
评论数据已整理至文件meidi_jd.csv中。在读取数据前需导入相关库,注意中文文本编码可能为gb18030、utf-8或gb2312/gbk,需根据实际情况自行测试选择。
# 导入相关库
import pandas as pd
import jieba

# 读取数据
data = pd.read_csv('meidi_jd.csv', encoding='gb18030')

# 查看数据
data.head()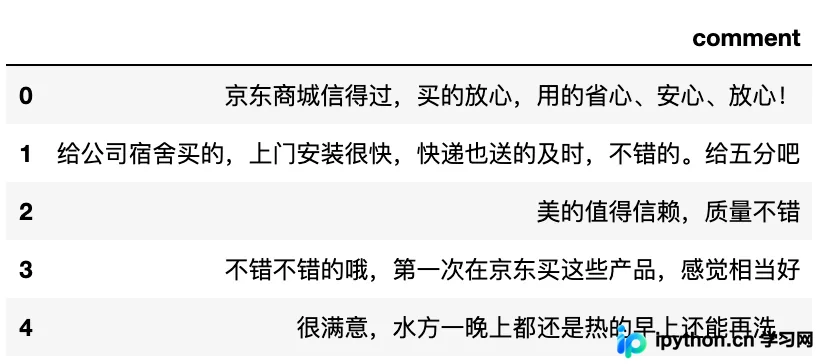
# 生成分词
data['cut'] = data['comment'].apply(lambda x : list(jieba.cut(x)))

data.head()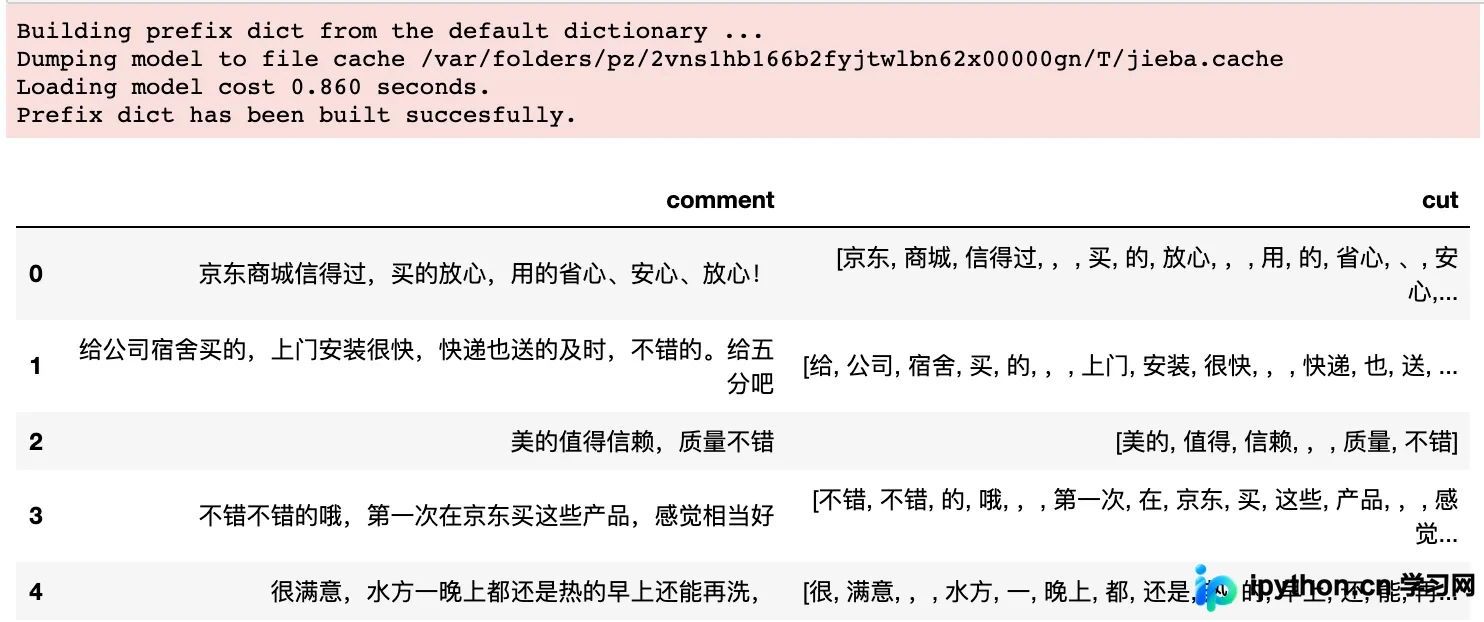
至此,仅需一行代码即可生成中文分词列表。若需对分词结果进行去重处理,可修改代码为集合形式。
data['cut'] = data['comment'].apply(lambda x : list(set(jieba.cut(x))))自定义词典
观察前述分词结果,会发现部分词语被错误地切分为单独汉字,例如:
print(data['cut'].loc[14])['很', '好', '很', '好', '很', '好', '很', '好', '很', '好', '很', '好', '很', '好', '很', '好', '很', '好', '很', '好', '很', '好']
此时需导入自定义词典以包含jieba词库中未收录的新词。尽管jieba具备新词识别能力,但手动添加特定词汇可确保更高的准确率。自定义词典格式为一词一行,演示中添加了“很好”并保存为dict.txt文件,随后即可应用自定义词典。
data['cut'] = data['comment'].apply(lambda x : list(jieba.cut(x)))

data.head()

print(data['cut'].loc[14])
['很好', '很好', '很好', '很好', '很好', '很好', '很好', '很好', '很好', '很好', '很好']
分词结果已按预期正确输出,效果良好。
停用词
分词过程中,部分词汇(如标点符号、语气词“嗯”、“啊”等)对语义贡献较小,需予以去除。首先需准备停用词表,可自定义或从网络下载,此处使用下载的StopwordsCN.txt文件。
# 读取停用词数据
stopwords = pd.read_csv('StopwordsCN.txt', encoding='utf8', names=['stopword'], index_col=False)

stopwords.head()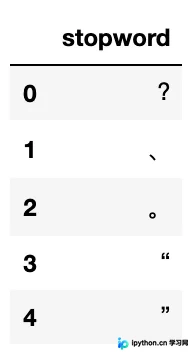
只需适当修改分词代码,即可在分词过程中过滤掉停用词。
# 转化词列表
stop_list = stopwords['stopword'].tolist()

# 去除停用词
data['cut'] = data['comment'].apply(lambda x : [i for i in jieba.cut(x) if i not in stop_list])

data.head()
pkuseg
pkuseg简单易用,支持细分领域分词,有效提升了分词准确度。
简介
pkuseg具有以下特点:
- 多领域分词:不同于通用分词工具,该工具包致力于为不同领域数据提供个性化预训练模型。用户可根据文本领域特点选择不同模型,目前支持新闻、网络文本及混合领域,未来计划推出医药、旅游、专利、小说等更多细领域模型。
- 更高的分词准确率:在相同训练和测试数据下,pkuseg相比其他工具包能获得更高的准确率。
- 支持用户自训练模型:允许用户使用全新标注数据进行模型训练。
注意:pkuseg目前仅支持Python3,鉴于许多主流库已不再支持Python2,建议使用Python3版本。如需使用Python2,可通过创建虚拟环境搭建。
Python中文分词库pkuseg实例
pkuseg的使用与jieba略有不同,需先创建模型实例再调用cut方法。前文提到pkuseg支持加载与训练模型,这大幅提升了分词准确性,尤其适用于细分领域数据集,详细信息可查阅GitHub文档。
import pkuseg

# 以默认配置加载模型
seg = pkuseg.pkuseg()

# 进行分词
data['cut'] = data['comment'].apply(lambda x: [i for i in seg.cut(x) if i not in stop_list])

data.head()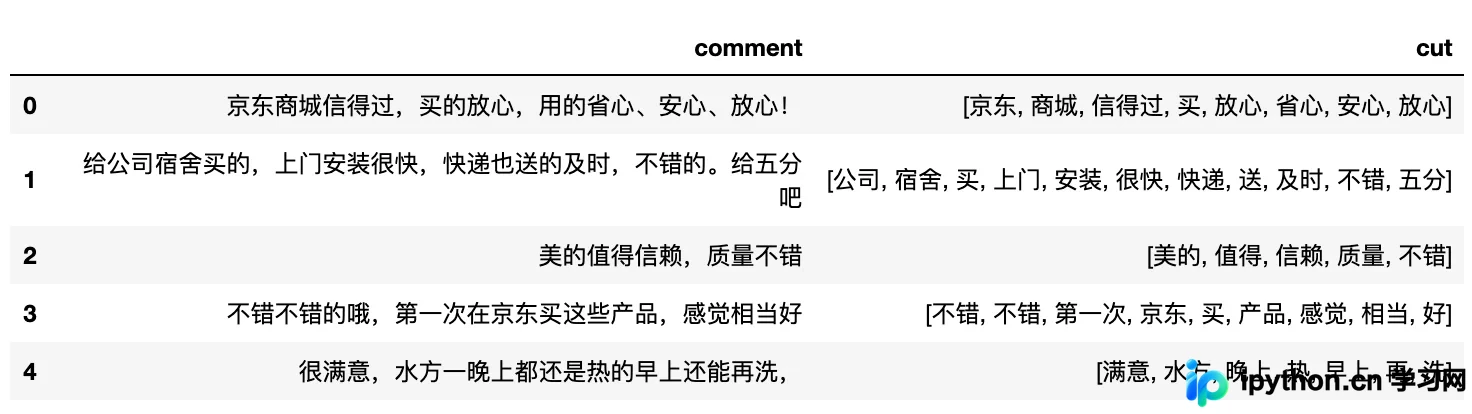
自定义词典
同样,pkuseg也支持通过自定义词典来提高分词准确率。
# 使用默认模型,并使用自定义词典
seg = pkuseg.pkuseg(user_dict='dict.txt')

# 进行分词
data['cut'] = data['comment'].apply(lambda x: [i for i in seg.cut(x) if i not in stop_list])

print(data['cut'].loc[14])
自定义预训练模型
在分词模式下,用户需加载预训练好的模型。pkuseg提供基于三种不同数据类型训练的模型:
- MSRA:在MSRA(新闻语料)上训练的模型。下载地址
- CTB8:在CTB8(新闻文本及网络文本的混合型语料)上训练的模型。下载地址
- WEIBO:在微博(网络文本语料)上训练的模型。下载地址
- MixedModel:混合数据集训练的通用模型。随pip包附带的是此模型。下载地址
# 下载后解压出来,并复制文件夹路径
file_path = '/Users/jan/anaconda3/lib/python3.6/site-packages/pkuseg/ctb8'

# 加载其他预训练模型
seg = pkuseg.pkuseg(model_name=file_path)

text = seg.cut('京东商城信得过,买的放心,用的省心、安心、放心!')

print(text)
jieba与pkuseg性能对比
jieba的分词速度说明较为简单,官方描述中缺乏直接的性能对比,更多侧重于分词内容与运行环境。
- 全模式下速度为1.5 MB/秒
- 默认模式下速度为400 KB/秒
- 测试环境:Intel(R) Core(TM) i7-2600 CPU @ 3.4GHz;《围城》.txt
相比之下,pkuseg选择了jieba、THULAC等国内代表性分词工具包进行性能对比。以下是在不同数据集上的对比结果:
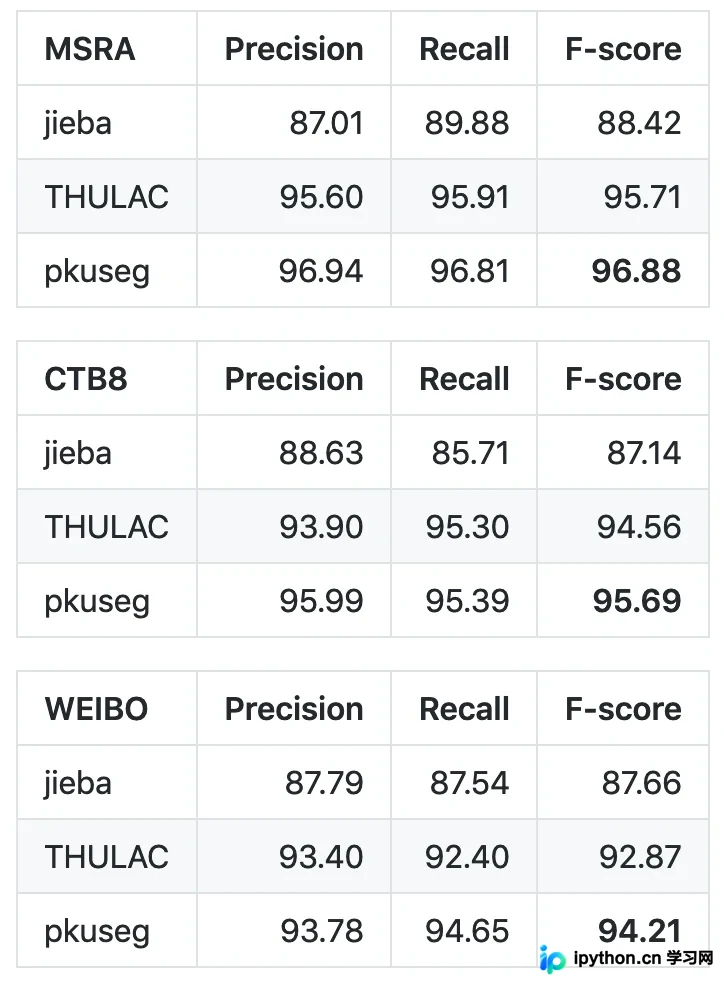
从结果来看,pkuseg在精确度、召回率和F分数上表现相当出色。在性能方面,笔者使用Jupyter Notebook进行了简单测试。
%%timeit
data['cut'] = data['comment'].apply(lambda x : [i for i in jieba.cut(x) if i not in stop_list])
%%timeit
data['cut'] = data['comment'].apply(lambda x: [i for i in seg.cut(x) if i not in stop_list])
输出结果:
结巴:2.54 s ± 3.77 ms per loop (mean ± std. dev. of 7 runs, 1 loop each)
pkuseg:7.45 s ± 68.9 ms per loop (mean ± std. dev. of 7 runs, 1 loop each)
从数据结果看,pkuseg的分词耗时高于jieba。当然,pkuseg提供多进程分词功能,通过多进程处理可进一步提升性能。
词频统计
至此,我们已基本掌握使用Python库进行分词的方法。关于词频统计有多种方式,此处先将所有分词结果合并以便统计。
# 将所有的分词合并
words = []

for content in data['cut']:
 words.extend(content)
方式一:
# 创建分词数据框
corpus = pd.DataFrame(words, columns=['word'])
corpus['cnt'] = 1

# 分组统计
g = corpus.groupby(['word']).agg({'cnt': 'count'}).sort_values('cnt', ascending=False)

g.head(10)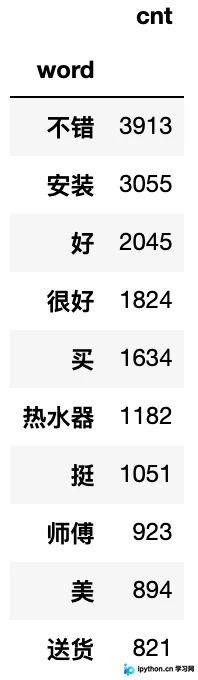
方式二:
# 导入相关库
from collections import Counter
from pprint import pprint
counter = Counter(words)

# 打印前十高频词
pprint(counter.most_common(10))
[('不错', 3913),
('安装', 3055),
('好', 2045),
('很好', 1824),
('买', 1634),
('热水器', 1182),
('挺', 1051),
('师傅', 923),
('美', 894),
('送货', 821)]
结尾
个人使用建议:若追求简单快速上手,可使用jieba分词;若追求准确度及特定领域分词,建议选择pkuseg并加载相应模型。此外,jieba和THULAC未提供细分领域预训练模型,若需使用自定义模型分词,需利用其提供的训练接口在细分领域数据集上进行训练,再使用训练得到的模型进行中文分词。
更多关于Python中文分词库jieba与pkuseg的相关文章,请点击下方相关链接。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















