


Python自然语言处理入门:环境搭建与NLTK基础教程
本教程针对Python自然语言处理(NLP)初学者,详细讲解独立虚拟环境搭建、NLTK库与语料数据下载配置,并提供分词、停用词过滤、词形还原与词性标注的完整实操代码。
自然语言处理(NLP)的核心目标是让计算机能够解析、理解和提取人类语言的结构与含义。NLTK(Natural Language Toolkit)作为Python生态中经典的教学与研究工具库,提供了规范的数据管道与算法实现。本文将指导你完成Python独立运行环境配置、NLTK依赖库与离线语料安装,并通过完整代码示例掌握分词、停用词过滤、词形处理及词性标注等核心操作。
一、自然语言处理核心流程与架构解析
计算机无法直接理解连续书写的非结构化自然语言文本。在将文本送入统计分析模型或机器学习算法之前,必须经过一系列标准化的文本预处理(Text Preprocessing)步骤。标准的NLP处理流水线通常由粗到细拆解为四个主要阶段:原始文本清洗、分词、词汇规范化以及句法特征标注。
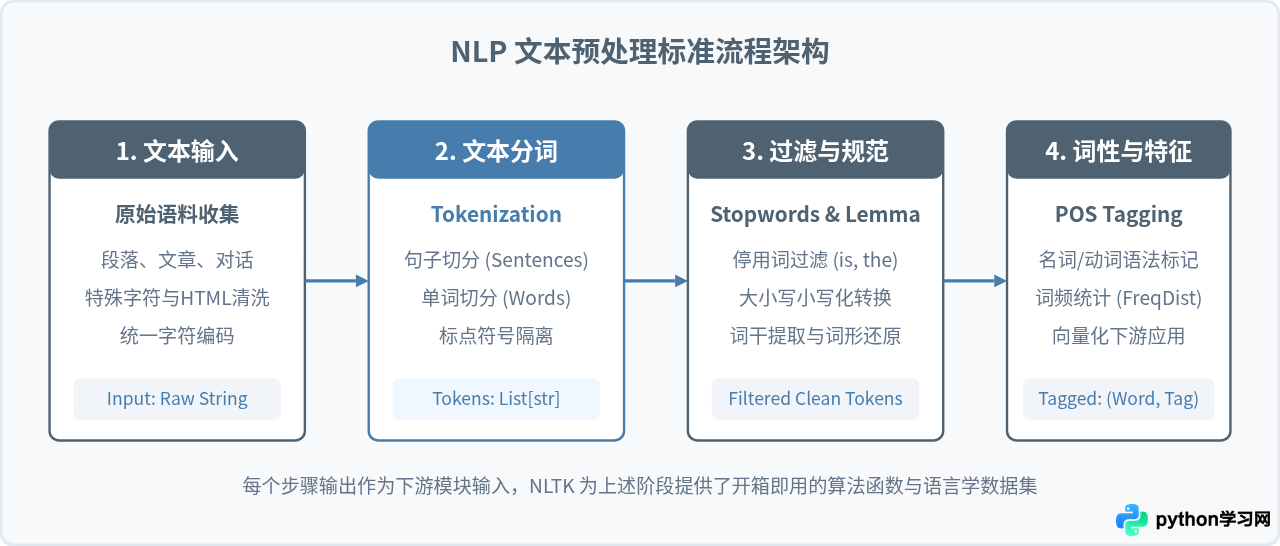
在上述流程中,NLTK扮演了底层工具库的角色。理解上述阶段有助于明确后续编写代码时调用的各个模块(如 tokenize、corpus、stem、tag)在整个体系中所处的位置。
二、Python环境搭建与NLTK依赖安装
开展NLP开发建议使用隔离的Python虚拟环境,以避免不同项目间的依赖冲突。本教程要求系统已安装 Python 3.8 或更高版本。
1. 创建并激活虚拟环境
打开操作系统终端(Windows下使用PowerShell或命令提示符,macOS/Linux下使用Bash或Zsh),执行以下命令创建名为 nlp_env 的独立环境:
# 1. 进入工作目录并创建虚拟环境
python3 -m venv nlp_env

# 2. 激活虚拟环境
# macOS / Linux 系统:
source nlp_env/bin/activate

# Windows 系统 (PowerShell):
.\nlp_env\Scripts\Activate.ps1

# Windows 系统 (CMD):
.\nlp_env\Scripts\activate.bat
激活成功后,命令行提示符左侧会显示环境名称 (nlp_env)。
2. 安装 NLTK 核心库
在激活的环境中,升级 pip 并安装 NLTK 库:
pip install --upgrade pip
pip install nltk
安装完成后,可在终端执行命令验证是否安装成功:
python -c "import nltk; print('NLTK版本:', nltk.__version__)"控制台正常输出版本号(例如 NLTK版本: 3.8.1 或更新版本)即代表库本身安装完成。
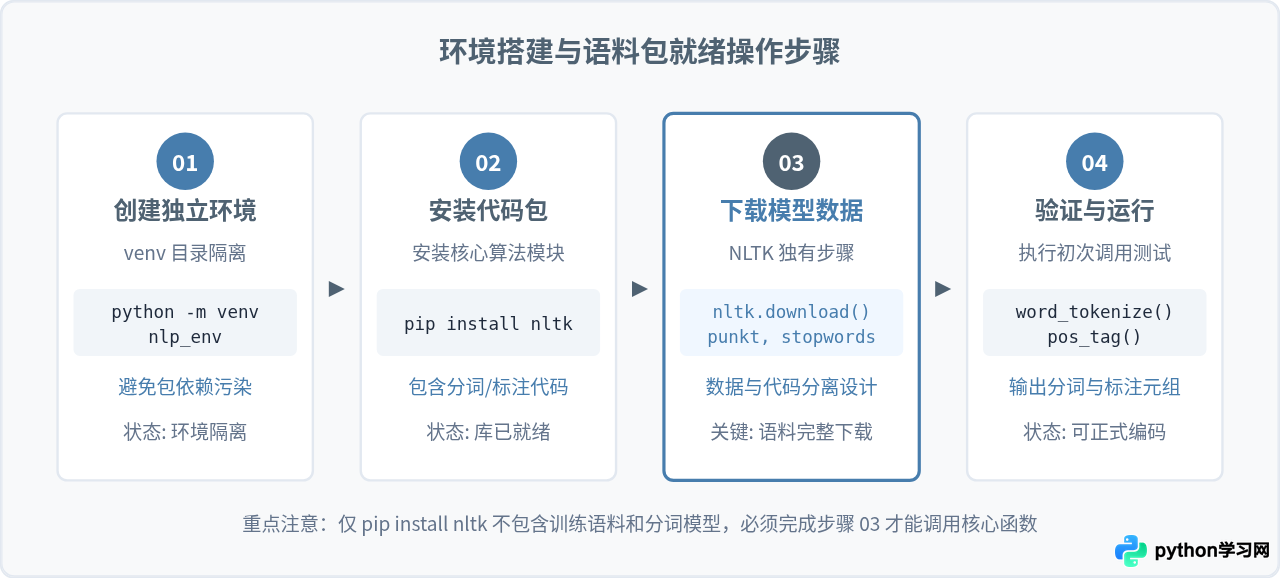
3. 语料库数据(nltk_data)下载与配置
与其他Python库不同,NLTK采用“代码逻辑与模型数据分离”的架构。pip install nltk 仅下载了算法逻辑,算法运行所需的词典、语法树模型和语料库文件需要通过 nltk.download() 单独获取。
创建一个Python脚本文件 setup_data.py,编写以下下载逻辑:
import nltk

# 常用基础数据包列表
essential_packages = [
    'punkt',                          # 基础分词模型
    'punkt_tab',                      # 新版 NLTK 分词表格
    'stopwords',                      # 多语言停用词表
    'averaged_perceptron_tagger',     # 词性标注模型
    'averaged_perceptron_tagger_eng', # 新版英文词性标注模型
    'wordnet',                        # 英文同义词词网(词形还原需要)
    'omw-1.4'                         # 开放多语言 WordNet 扩展
]

print("开始检查并下载 NLTK 必要语料包...")
for pkg in essential_packages:
    try:
        nltk.download(pkg)
        print(f"数据包 [{pkg}] 就绪")
    except Exception as e:
        print(f"数据包 [{pkg}] 下载出现异常: {e}")

print("下载配置流程执行完毕。")
如果执行上述下载脚本时出现 [Errno 60] Operation timed out 或 getaddrinfo failed,说明访问官方语料库服务器受限。此时可以通过配置国内镜像地址,或从官方仓库(GitHub nltk/nltk_data)手动下载对应压缩包,解压到系统的 nltk_data 目录下(通常为用户的家目录 ~/nltk_data/tokenizers/ 或 ~/nltk_data/corpora/)。
三、NLTK核心功能实操教程
完成环境和基础数据准备后,即可调用 NLTK 提供的各个函数处理文本。以下按实际文本分析顺序逐个展开讲解。
1. 文本分词(Tokenization)
分词是将连续的字符序列切分为具有独立语义单位(Token)的过程。在英文中,单词之间虽然存在空格,但不能单纯依赖 str.split(' '),因为标点符号(如逗号、句号、连字符、缩写词如 don't、U.S.A.)需要特殊的切分策略。
NLTK 提供了句子级分词器 sent_tokenize 与单词级分词器 word_tokenize:
from nltk.tokenize import sent_tokenize, word_tokenize

sample_text = "Natural Language Processing with Python is powerful. Don't overlook NLTK's utility; it's a great tool!"

# 1. 句子切分 (Sentence Tokenization)
sentences = sent_tokenize(sample_text)
print("【句子切分结果】:")
for idx, s in enumerate(sentences, 1):
    print(f"  句子 {idx}: {s}")

# 2. 单词切分 (Word Tokenization)
words = word_tokenize(sample_text)
print("\n【单词切分结果】:")
print(words)
运行结果示例:
【句子切分结果】:
  句子 1: Natural Language Processing with Python is powerful.
  句子 2: Don't overlook NLTK's utility; it's a great tool!

【单词切分结果】:
['Natural', 'Language', 'Processing', 'with', 'Python', 'is', 'powerful', '.', 'Do', "n't", 'overlook', 'NLTK', "'s", 'utility', ';', 'it', "'s", 'a', 'great', 'tool', '!']
从单词切分结果可见,Don't 被规范拆分为 Do 和 n't,标点符号 . 和 ; 也被单独分离,符合语言学标注的标准格式。
2. 停用词过滤(Stopwords Filtering)
停用词(Stop Words)指的是在语料库中频繁出现但对文本核心语义贡献较小的功能词,例如 is、the、with、a 等。在进行主题分析、文本分类或关键词提取时,通常需要将它们剔除以降低特征维度。
from nltk.corpus import stopwords
from nltk.tokenize import word_tokenize

# 获取英文停用词集合
stop_words = set(stopwords.words('english'))

raw_tokens = ['Natural', 'Language', 'Processing', 'with', 'Python', 'is', 'powerful', 'it', 'is', 'a', 'tool']

# 过滤停用词与非字母符号(转为小写对比)
filtered_tokens = [
    word for word in raw_tokens
    if word.lower() not in stop_words and word.isalpha()
]

print("原始单词列表:", raw_tokens)
print("过滤后结果:", filtered_tokens)
运行结果示例:
原始单词列表: ['Natural', 'Language', 'Processing', 'with', 'Python', 'is', 'powerful', 'it', 'is', 'a', 'tool']
过滤后结果: ['Natural', 'Language', 'Processing', 'Python', 'powerful', 'tool']
3. 词干提取(Stemming)与词形还原(Lemmatization)
英文单词具有丰富的屈折与派生形态,例如 study、studying、studies、studied 表达同一基本概念。为了统一度量,NLP提供了两种不同的规范化方案:
- 词干提取(Stemming):采用启发式规则,机械切除常见的词缀(如 -ing、-ed、-s)。运行速度极快,但提取出的词干可能并不是一个合法的词汇(如
studies会被截断为studi)。 - 词形还原(Lemmatization):基于完整的词汇数据库(如 WordNet)和形态学规则,将词汇还原为语言学原型(Lemma)。处理更精确,但需要结合词性标注信息。
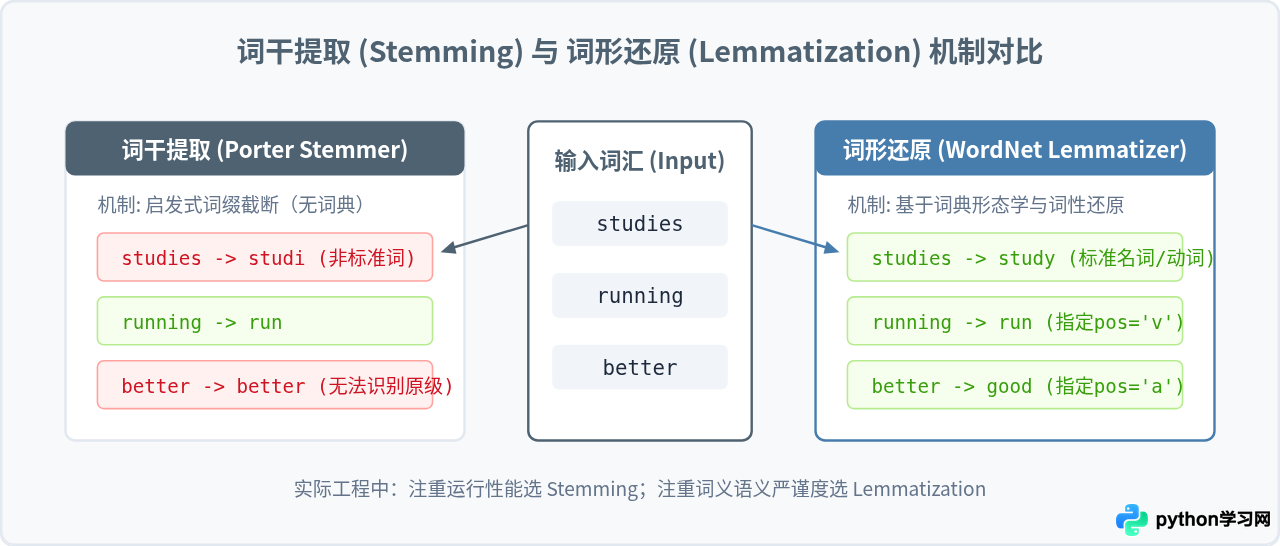
在 Python 中调用这两种方法的代码如下:
from nltk.stem import PorterStemmer, WordNetLemmatizer
from nltk.corpus import wordnet

stemmer = PorterStemmer()
lemmatizer = WordNetLemmatizer()

words = ['studies', 'studying', 'ran', 'better']

print(f"{'原词':<10}{'PorterStemmer':<16}{'WordNetLemmatizer':<18}")
print("-" * 44)
for w in words:
    # 词干提取
    stemmed = stemmer.stem(w)
    # 词形还原(默认pos='n',可显式指定动词'v'或形容词'a')
    pos = wordnet.VERB if w in ['studying', 'ran'] else (wordnet.ADJ if w == 'better' else wordnet.NOUN)
    lemma = lemmatizer.lemmatize(w, pos=pos)
    print(f"{w:<10}{stemmed:<16}{lemma:<18}")
输出示例:
原词        PorterStemmer   WordNetLemmatizer
--------------------------------------------
studies   studi           study
studying  studi           study
ran       ran             run
better    better          good
4. 词性标注(Part-of-Speech Tagging)
词性标注为句子中的每一个 Token 赋予对应的语法角色(如名词、动词、形容词、副词、连词等)。NLTK 使用宾州树库(Penn Treebank)词性标注集,调用 nltk.pos_tag 即可完成标注:
import nltk
from nltk.tokenize import word_tokenize

sentence = "Python allows fast development of natural language applications."
tokens = word_tokenize(sentence)
tags = nltk.pos_tag(tokens)

print("词性标注元组列表:")
print(tags)
输出示例:
词性标注元组列表:
[('Python', 'NNP'), ('allows', 'VBZ'), ('fast', 'JJ'), ('development', 'NN'), ('of', 'IN'), ('natural', 'JJ'), ('language', 'NN'), ('applications', 'NNS'), ('.', '.')]
常用 Penn Treebank 词性标签说明如下:
| 标签 (Tag) | 词性说明 | 代码中对应示例 |
|---|---|---|
NNP |
专有名词单数 (Proper noun, singular) | Python |
NN / NNS |
普通名词单数 / 复数 | language / applications |
VBZ |
动词第三人称单数现在时 | allows |
JJ |
形容词 (Adjective) | fast, natural |
IN |
介词或从属连词 (Preposition) | of |
四、常见问题排查与边界说明
在初次配置与使用 NLTK 过程中,开发者通常会遇到以下两类典型问题:
1. 资源缺失报错 (Resource punkt / punkt_tab not found)
报错现象:执行 word_tokenize 时抛出异常:
LookupError: Resource punkt_tab not found. Please use the NLTK Downloader to obtain the resource.
原因与解法:NLTK 从 3.8.2 版本开始针对分词模块引入了 punkt_tab 数据包。请检查调用代码,增加以下容错加载逻辑,确保首次运行时能自动触发缺失资源的下载:
import nltk

def ensure_nltk_resource(resource_path, package_name):
    try:
        nltk.data.find(resource_path)
    except LookupError:
        print(f"正在自动拉取缺失资源: {package_name}")
        nltk.download(package_name)

ensure_nltk_resource('tokenizers/punkt', 'punkt')
ensure_nltk_resource('tokenizers/punkt_tab', 'punkt_tab')
2. 中文与英文处理的适用边界
NLTK 的内置分词与词法分析规则主要基于印欧语系(以英文为主)。中文书写在词与词之间没有空格分隔,直接使用 word_tokenize 会将整段中文按单字切分,无法识别复合词汇。
工程建议:对于中文自然语言处理任务,分词环节应使用针对中文语料训练的专业工具(如 jieba 或 pkuseg);完成中文分词并生成带空格的词列表后,依然可以使用 NLTK 提供的 FreqDist(词频统计)、语料分析和机器学习分类器。
五、总结与后续进阶路径
本文系统梳理了基于 Python 与 NLTK 的自然语言处理入门路径。掌握环境搭建与基础预处理,是后续进行文本分类、情感分析和信息抽取的基石。
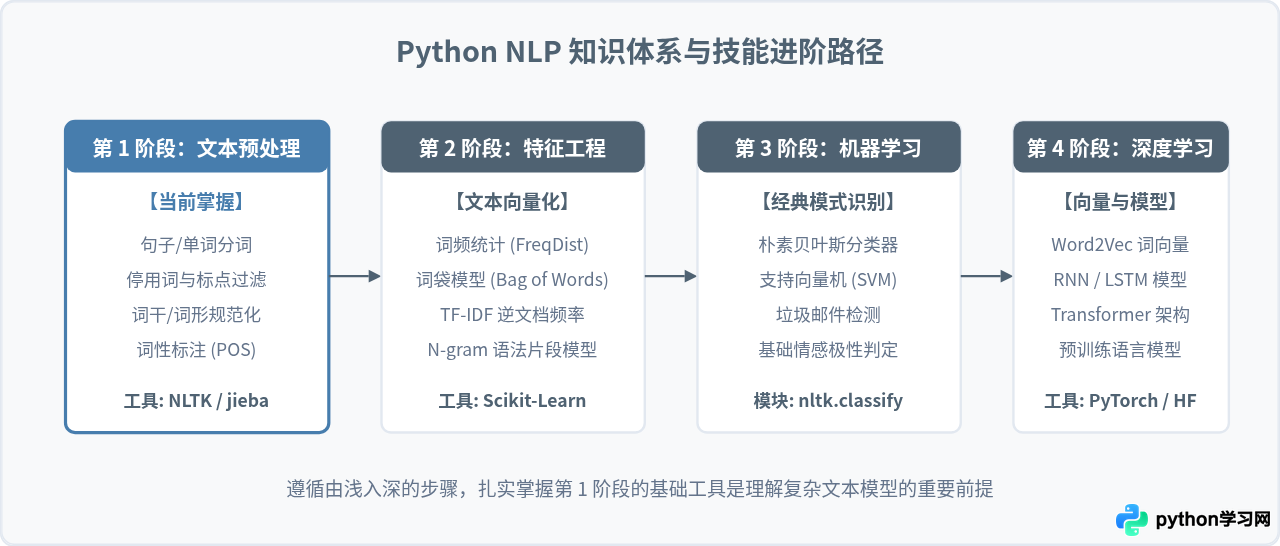
初学者建议在本地环境依次练习分词、词汇清理与词性统计,完成简单的英文文本特征提取之后,再逐步引入 scikit-learn 进行文本向量化与分类建模。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















