


Python函数返回多个值时为什么要用元组
深入解析Python函数在返回多个值时为什么默认使用元组(tuple),从逗号打包语法、CPython字节码机制、不可变安全性、内存性能及语义契约等维度进行全面剖析与实践指南。
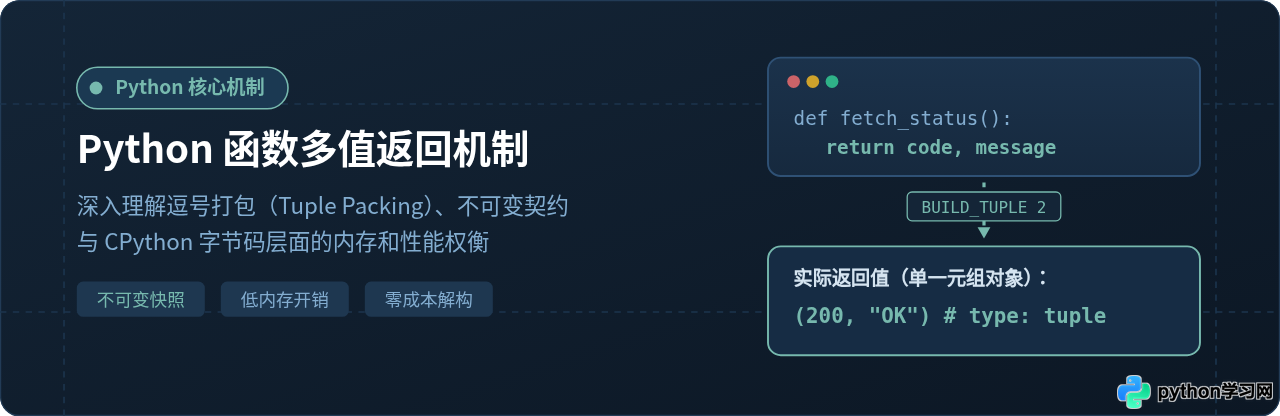
return x, y 时,表面上看它同时输出了两个独立结果,但若打印其类型,会发现返回值其实是一个单一的元组(Tuple)。Python 函数在底层严格遵守单值返回机制;语言设计者之所以没有默认采用列表(List)或引入专有复合寄存器,而是将多个值隐式打包为元组,是因为元组凭借其不可变数据契约、极低的内存与分配开销、天然的可哈希特性以及专为异构定长记录设计的语言语义,提供了最安全、最高效的工程解法。
一、核心机制:函数从未真正返回“多个独立值”
假设我们需要编写一个网络请求函数,在请求结束后需要同时向上层汇报状态码与状态文本。在 Python 中通常会直接这样写:
def fetch_status():
    status_code = 200
    status_message = "OK"
    return status_code, status_message  # 看似返回两个值

result = fetch_status()
print(result)
print(type(result))
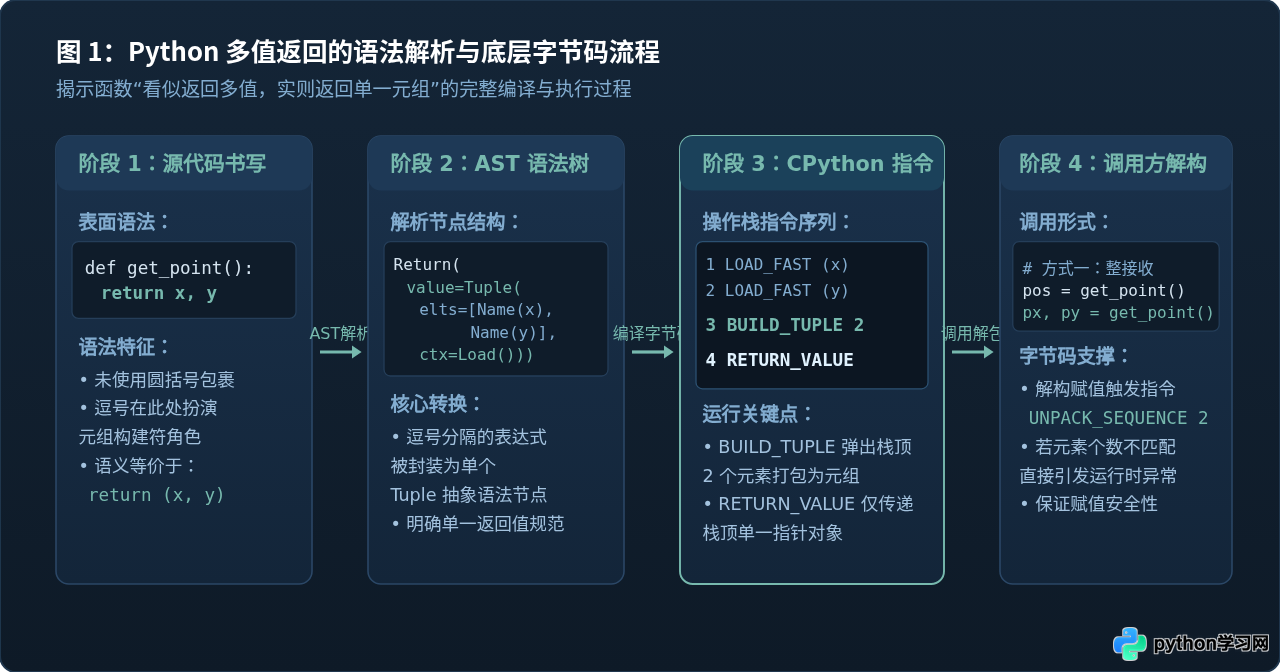
控制台输出清晰地印证了结论:result 是一个包含两个元素的 tuple。在语法层面,很多人误以为元组是由圆括号 () 定义的,但实际上逗号(Comma)才是元组的真正构建运算符。圆括号的作用主要是在语法产生歧义时界定边界(例如函数调用的实参列表),而表达式 status_code, status_message 本身就已经构成了元组对象。
1.1 CPython 字节码证明
我们可以使用 Python 标准库中的 dis 模块,对上述函数的字节码进行反编译,观察解释器底层的实际操作指令:
import dis

def get_point():
    x = 10
    y = 20
    return x, y

dis.dis(get_point)
从指令序列中可以看到,当执行到 return x, y 时:
- 解释器先后执行
LOAD_FAST 0 (x)和LOAD_FAST 1 (y),将局部变量依次压入当前线程的求值栈。 - 编译器识别出逗号表达式,紧接着生成了
BUILD_TUPLE 2指令。该指令从栈顶弹出 2 个元素,并在堆内存中打包为一个新的元组对象,随后将此元组的指针重新压回栈顶。 - 最后调用
RETURN_VALUE。该指令只负责将求值栈顶的单一对象指针传递给调用方栈帧并弹出当前作用域。
由此可见,CPython 虚拟机在函数执行模型上自始至终只支持“单进单出”。所谓的“返回多个值”,本质是编译器在函数退出前执行了一次自动的元组打包(Tuple Packing)。
二、为什么选择元组而非列表?核心设计权衡
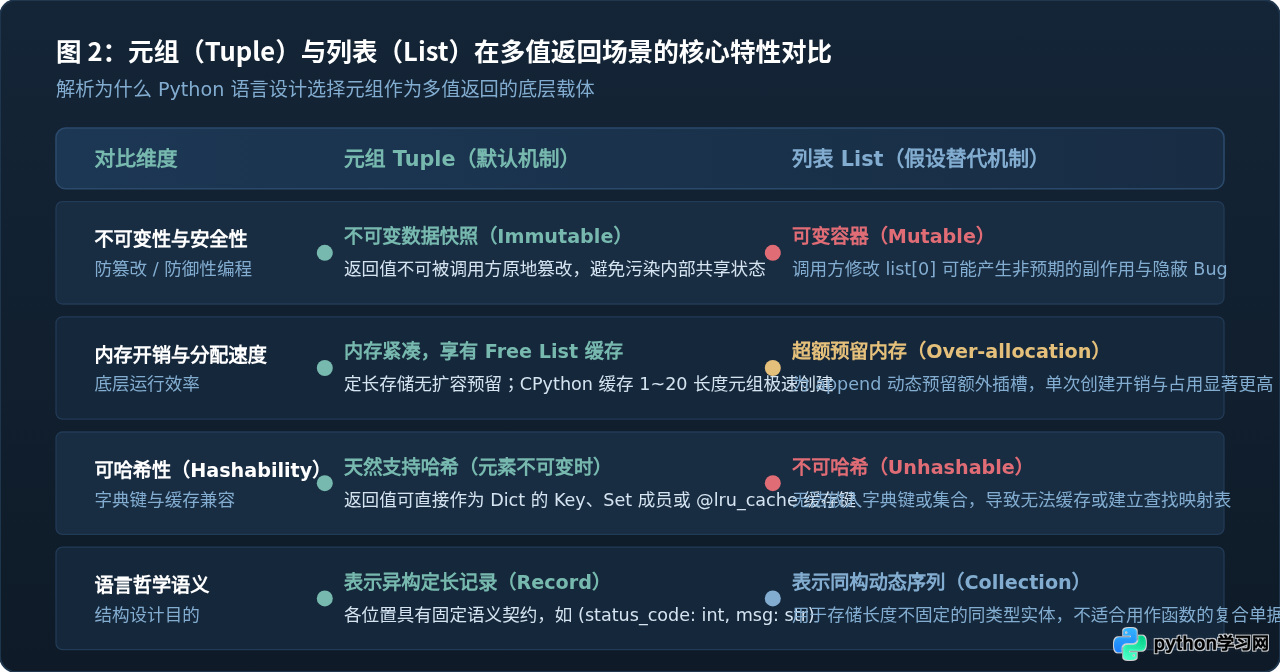
既然必须将多个值收拢为单个容器对象返回,为什么 Python 官方设计选择元组,而不是同样内置且更具灵活性的列表(List)?这涉及四个层面的关键考量:
2.1 不可变性保障数据契约与防御性编程
函数返回的值通常代表了某次计算的终态快照(Snapshot)。快照的特点是只读、确定且不应被随意篡改:
- 杜绝调用方的隐式污染:如果默认返回可变列表,调用者在拿到结果后执行
res[0] = 999,若该结果引用了函数内部的缓存或公用数据,就会直接破坏原有的数据一致性。 - 防御性编程范式:在软件工程中,向调用方提供不可变容器是最安全的数据传递策略。调用方明确知道这组返回值是定长、只读的,任何尝试修改原结果的行为都会在编译或运行时第一时间报错,降低了模块间的耦合风险。
2.2 内存开销与 CPython 分配性能
元组是固定长度的不可变对象,而列表是可随时扩容(append、extend)的动态数组。这种本质区别直接体现在内存布局与运行效率上:
- 无超额预留内存(No Over-allocation):列表为了保证追加元素时达到平摊 O(1) 的性能,在底层 C 结构体中往往会多分配 1/8 到 1/4 的预留槽位(Allocated Slots)。元组则在创建时刻精准分配所需长度的指针数组,没有一字节多余预留。
- 享有 CPython 空闲链表(Free List)优化:在 CPython 解释器实现中,针对长度在 1 到 20 之间的元组维护了全局复用池。当一个小元组生命周期结束被回收时,其 C 结构体并不立即归还给系统操作系统堆,而是挂载在对应的
free_list上。当下一次函数再次构建元组时,可以直接复用已存在的内存槽,几乎零系统调用开销。
import sys

tup = (1, 2)
lst = [1, 2]

print("元组内存占用:", sys.getsizeof(tup), "字节")
print("列表内存占用:", sys.getsizeof(lst), "字节")2.3 可哈希性(Hashability)与缓存支持
只要元组内部的元素本身是不可变类型(如整型、字符串、浮点数),该元组就是天然可哈希的(Hashable),实现了 __hash__() 协议。
这意味着函数多值返回的元组可以直接作为字典(dict)的键,加入集合(set),或作为 functools.lru_cache 的备忘录键值。如果默认返回列表,由于列表无法进行哈希计算,一旦调用方尝试将其作为映射表的索引,便会立刻抛出 TypeError: unhashable type: 'list'。
2.4 符合 Python 类型系统的语义哲学
在 Python 的标准类型体系中,元组与列表并不仅仅是“只读与可写”的区别,更承担着截然不同的语义分工:
- 元组(Tuple):表示异构的定长记录(Record)。每个位置有着明确的业务含义。例如
(status_code, response_data, elapsed_time),位置 0 是数字,位置 1 是字符串,位置 2 是浮点数。 - 列表(List):表示同构的变长集合(Collection)。列表通常用于存放同一种实体(例如用户列表
[User, User, ...]),元素的顺序和数量通常随业务动态变化。
函数的多个返回值往往分别代表不同属性(如经度与纬度、行号与列号、商与余数),其内在本质正是“一条包含异构字段的定长记录”,因此选用元组完全贴合 Python 语言的设计初衷。
三、元组解构赋值(Unpacking)的执行与校验机制
函数返回元组之所以在日常编码中如此自然,是因为它与 Python 的序列解包协议(Sequence Unpacking)形成了天衣无缝的配合。
3.1 解包赋值的执行步骤
当我们在调用端编写 a, b = get_point() 时,底层所发生的过程如下:
- 调用
get_point(),获取返回的元组对象指针。 - 解释器执行
UNPACK_SEQUENCE 2字节码指令。 - 解释器首先核实容器长度:若该元组长度严格等于 2,则依次将其各个元素的指针解绑并写入左侧的变量槽位(
a和b)。
ValueError,绝不会进行静默的截断或填补 None。这是一种强韧的数据完整性保护机制。
def calc_stats():
    return 100, 95, 80  # 返回 3 个元素

# 错误用法一:接收变量过少
max_val, min_val = calc_stats()
# 触发异常:ValueError: too many values to unpack (expected 2)

# 错误用法二:接收变量过多
v1, v2, v3, v4 = calc_stats()
# 触发异常:ValueError: not enough values to unpack (expected 4, got 3)
3.2 进阶解包:星号扩展解构
如果函数返回的值较多,或者我们只关心部分固定返回值,可以利用 Python 3 引入的星号解构语法(Extended Iterable Unpacking):
def query_sensor_data():
    return "SN-9021", 24.5, 25.1, 24.8, "NORMAL"

# 提取首个元素(设备号)、尾部元素(状态),其余采样点收集到列表
device_id, *readings, status = query_sensor_data()

print("设备编号:", device_id)
print("采样数据:", readings)
print("工作状态:", status)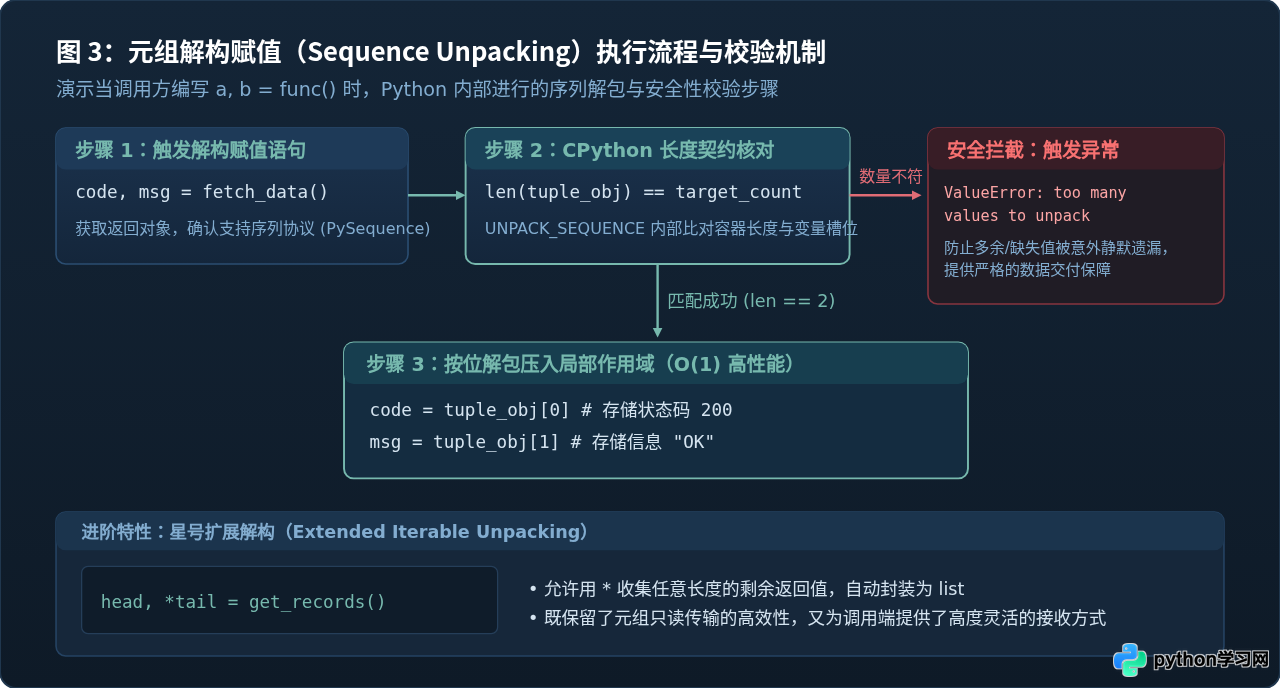
四、什么时候不该直接返回普通元组?结构化演进策略
虽然原生元组在 2 到 3 个返回值的场景下极其轻巧,但当返回参数逐渐增多时,过度依赖普通元组会暴露出显著的工程维护缺陷:
- 依赖位置记忆:调用方必须死记硬背每个位置代表什么。若函数返回
(host, port, username, password, database, timeout),一旦两个同为字符串类型的参数顺序弄反,静态类型检查器和解释器都无法察觉。 - 重构成本高昂:一旦在元组中间新增或删减了一个字段,所有调用该函数并进行解包的代码都会瞬间崩溃。
4.1 方案演进 1:typing.NamedTuple
如果希望保留元组零开销、不可变和支持解包的全部优点,同时又获得类似对象属性的点号访问支持与 IDE 代码补全,推荐使用 typing.NamedTuple:
from typing import NamedTuple

class ResponseRecord(NamedTuple):
    code: int
    message: str
    latency_ms: float

def execute_api_call() -> ResponseRecord:
    return ResponseRecord(code=200, message="Success", latency_ms=18.4)

# 方式 1:保持兼容,直接像元组一样解包
c, m, t = execute_api_call()

# 方式 2:使用具备强可读性的属性名访问
res = execute_api_call()
print(res.code, res.latency_ms)
4.2 方案演进 2:不可变数据类 @dataclass(frozen=True)
如果返回结果属于核心业务领域模型,需要包含字段默认值、复杂类型校验或定义计算方法,应当升级为不可变数据类:
from dataclasses import dataclass

@dataclass(frozen=True)
class UserMetrics:
    user_id: int
    login_count: int
    score: float
    is_vip: bool = False

    def is_active(self) -> bool:
        return self.login_count > 10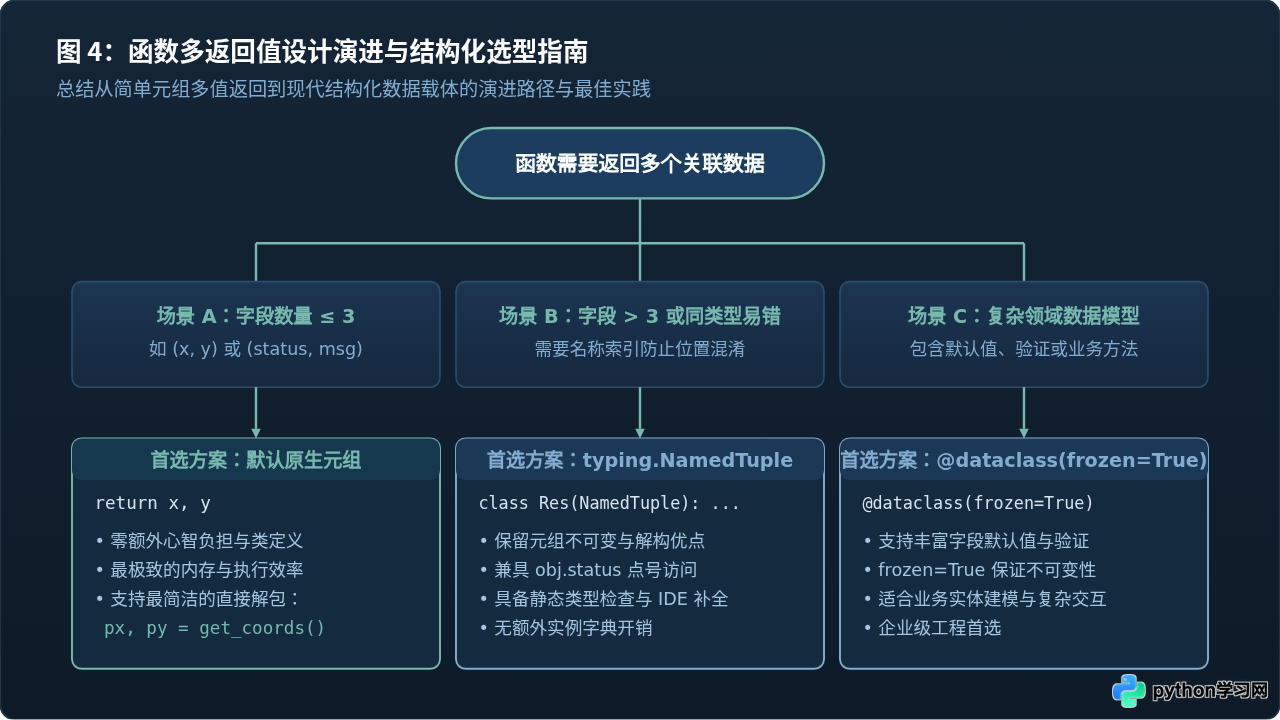
五、总结与实践速查
理解 Python 为什么在函数返回多个值时使用元组,有助于我们在架构设计中写出兼具性能与可维护性的工业级代码。下表对不同返回值组织方式进行了横向对比:
| 返回方案 | 底层容器 | 可变性 | 内存与速度 | 调用访问方式 | 适用典型场景 |
|---|---|---|---|---|---|
| 默认逗号多值返回 | 原生 tuple |
不可变 | 极快,享有 free_list | 位置解包 x, y = f() |
返回值 ≤ 3 个,坐标、商余、状态与结果等紧密关联对 |
| 显式列表返回 | 原生 list |
可变 | 稍慢,有预留扩容槽 | 下标或解包 res[0] |
明确需要调用方原地增删过滤的同构动态集合 |
| 具名元组 NamedTuple | 扩展 tuple |
不可变 | 与普通元组完全一致 | 解包或属性 res.status |
返回值 3~6 个,需字段自解释且需要类型提示 |
| 数据类 DataClass | 自定义类实例 | 可配置(frozen) | 常规对象开销 | 属性访问 res.field |
业务领域核心实体、多默认参数、需要挂载行为方法 |
- 当函数仅返回 2 到 3 个紧密相关结果时,放心使用
return a, b,利用元组的轻量与防御性; - 如果仅返回一个元素,切忌多写末尾逗号(例如
return data,会意外构造单元素元组); - 当返回值超过 3 个或含有多个相同基本类型(如多个连续的 int 或 str)时,坚决弃用普通元组解包,重构为
NamedTuple或dataclass。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















