


Python递归实现汉诺塔算法:代码详解与执行流程
深入解析Python递归实现汉诺塔算法的核心原理、代码逐行实现、执行流程树以及时空复杂度分析,配备四幅专业架构与流程图示。
求解汉诺塔问题的核心在于把复杂的整塔迁移转化为“移动 n-1 个盘”与“移动底层最大盘”的递推拆解。本文直接给出标准 Python 递归实现代码,深入剖析形参动态轮换机制,通过 3 阶实例完整还原每一步物理位移与调用栈压栈、弹栈时序,帮助读者彻底搞懂递归思维与执行本质。
一、汉诺塔问题的规则与数学模型
汉诺塔(Tower of Hanoi)源自古印度传说。题目给定三根立柱:A(起始柱)、B(辅助柱)和 C(目标柱)。初始状态下,A 柱上由下至上依序叠放着 n 个尺寸从小到大的圆盘。任务要求将全部圆盘平移到 C 柱,且在移动过程中必须恪守以下三条铁律:
- 每次操作只能移动一根柱子最顶端的一枚圆盘;
- 圆盘只能在三根柱子之间互移,不得随意放置在桌面上;
- 在任何时刻、任意柱子上,大圆盘绝不能压在小圆盘上方。
二、递归思维的本质:大问题化小
很多初学者陷入汉诺塔的思维误区,试图在脑海中追踪每一个圆盘在每一秒的具体落点,这在盘数达到 3 个以上时会迅速超出人脑的短时记忆容量。递归的核心是“信任机制”与“抽象建模”:
- 基线条件(Base Case):当圆盘只有 1 个时(n = 1),不需要借助辅助柱,直接将其从起始柱移动到目标柱。
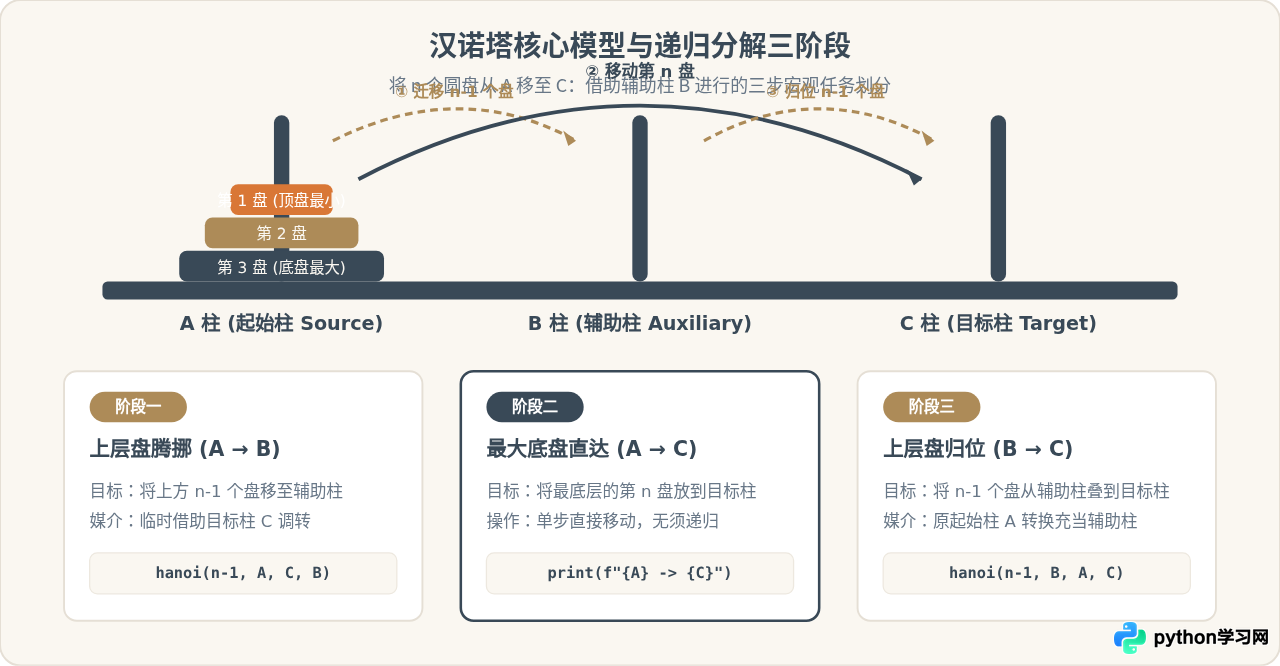
- 递推步骤(Recursive Step):若已知如何移动 n-1 个盘,那么处理 n 个盘只需三步:
- 第一步:假定能把上面的 n-1 个盘作为一个整体,从起始柱 A 移动到辅助柱 B(此时 C 柱作为临时中转);
- 第二步:此时 A 柱只剩下最大的第 n 号盘,直接将该底盘从 A 柱移至目标柱 C;
- 第三步:把暂留在 B 柱上的 n-1 个盘,重新移动到目标柱 C 上(此时 A 柱反过来作为临时辅助)。
因为第 n 号盘是全场最大的盘子,所以在此过程中,无论是把上面的小盘放在它身上,还是让它从空柱子间移动,绝不可能违背“大盘压小盘”的规则。底盘的移动与上方 n-1 个盘的相对移动完全解耦,这就是递归能够成立的数学基石。
三、Python代码实现与逐行解析
下面给出生产可用的 Python 实现代码,包含移动路径打印与移动步数统计:
def hanoi(n, source, auxiliary, target, step_counter=None):
    """
    Python递归求解汉诺塔问题
    :param n: 当前需要移动的圆盘总数 (正整数)
    :param source: 当前任务的起始柱标识
    :param auxiliary: 当前任务的辅助柱标识
    :param target: 当前任务的目标柱标识
    :param step_counter: 移动计数器列表 [count]
    """
    if step_counter is None:
        step_counter = [0]

    # 基线条件:只剩一个盘时,直接移动并返回
    if n == 1:
        step_counter[0] += 1
        print(f"步骤 {step_counter[0]}: 移动盘 1 从 {source} -> {target}")
        return

    # 阶段一:将上方的 n-1 个盘从 source 搬到 auxiliary,借助 target
    hanoi(n - 1, source, target, auxiliary, step_counter)

    # 阶段二:将当前最大的第 n 号底盘从 source 搬到 target
    step_counter[0] += 1
    print(f"步骤 {step_counter[0]}: 移动盘 {n} 从 {source} -> {target}")

    # 阶段三:将暂存在 auxiliary 的 n-1 个盘搬到 target,借助 source
    hanoi(n - 1, auxiliary, source, target, step_counter)

    return step_counter[0]


if __name__ == "__main__":
    n = 3
    print(f"========== 开始求解 {n} 阶汉诺塔 ==========")
    total_steps = hanoi(n, 'A', 'B', 'C')
    print(f"========== 求解完毕,总操作步数: {total_steps} ==========")
函数声明中的参数名 source、auxiliary、target 代表的是逻辑角色,而不是固定的柱子名称。在第一段递归 hanoi(n - 1, source, target, auxiliary) 中,第三个形参传入了 auxiliary,意味着原本的辅助柱在此次调用中充当了目标柱;而在第三段递归 hanoi(n - 1, auxiliary, source, target) 中,第一个形参传入了 auxiliary,意味着原本的辅助柱成为了新的起点。
四、3 阶汉诺塔 7 步操作时序拆解
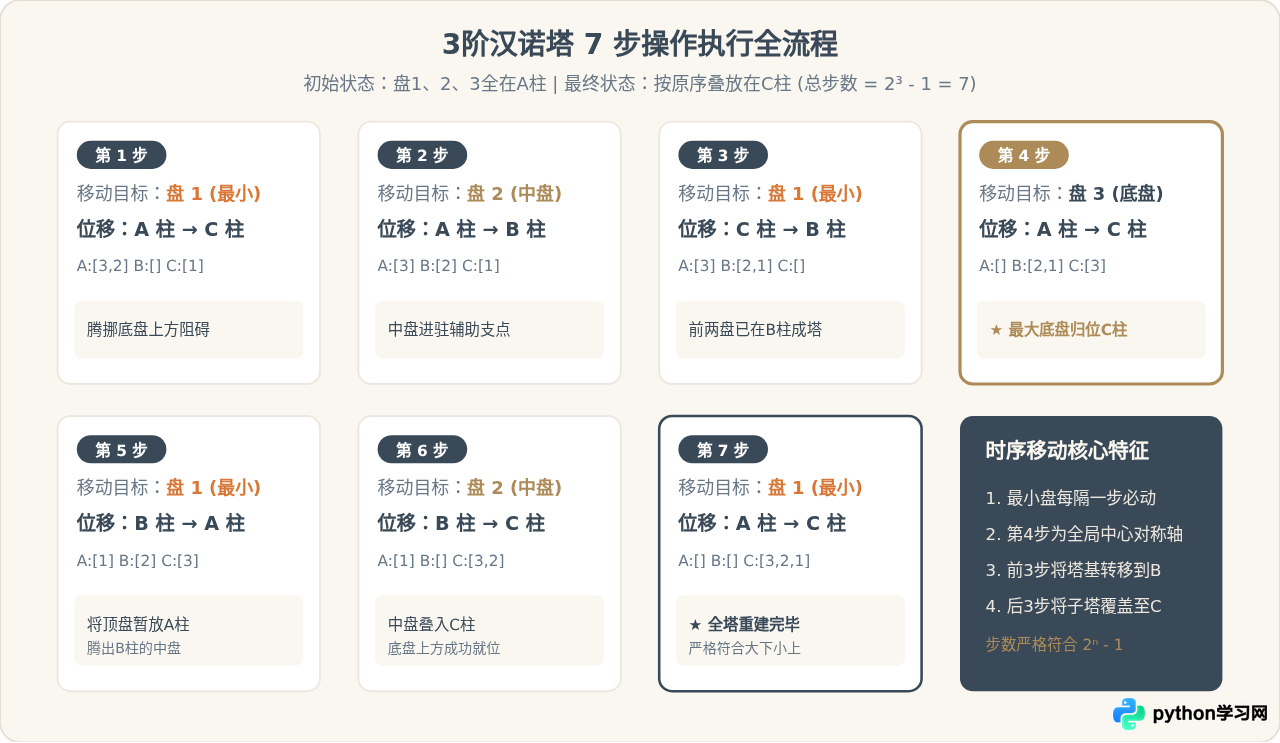
当 n = 3 时,根据数学公式移动总步数为 \(2^3 - 1 = 7\) 步。运行上述 Python 代码后,控制台输出的真实结果如下表所示:
| 序号 | 操作圆盘 | 移动路径 | 阶段归属 | 移动后三柱状态 (A, B, C) |
|---|---|---|---|---|
| 第 1 步 | 盘 1 (小) | A → C | 子问题 n=2 阶段一 | A: [3, 2], B: [], C: [1] |
| 第 2 步 | 盘 2 (中) | A → B | 子问题 n=2 阶段二 | A: [3], B: [2], C: [1] |
| 第 3 步 | 盘 1 (小) | C → B | 子问题 n=2 阶段三 | A: [3], B: [2, 1], C: [] |
| 第 4 步 | 盘 3 (大) | A → C | 主问题 n=3 阶段二 (最大盘落位) | A: [], B: [2, 1], C: [3] |
| 第 5 步 | 盘 1 (小) | B → A | 子问题 n=2 阶段一 | A: [1], B: [2], C: [3] |
| 第 6 步 | 盘 2 (中) | B → C | 子问题 n=2 阶段二 | A: [1], B: [], C: [3, 2] |
| 第 7 步 | 盘 1 (小) | A → C | 子问题 n=2 阶段三 | A: [], B: [], C: [3, 2, 1] |
五、递归调用树与栈帧压栈/出栈机制
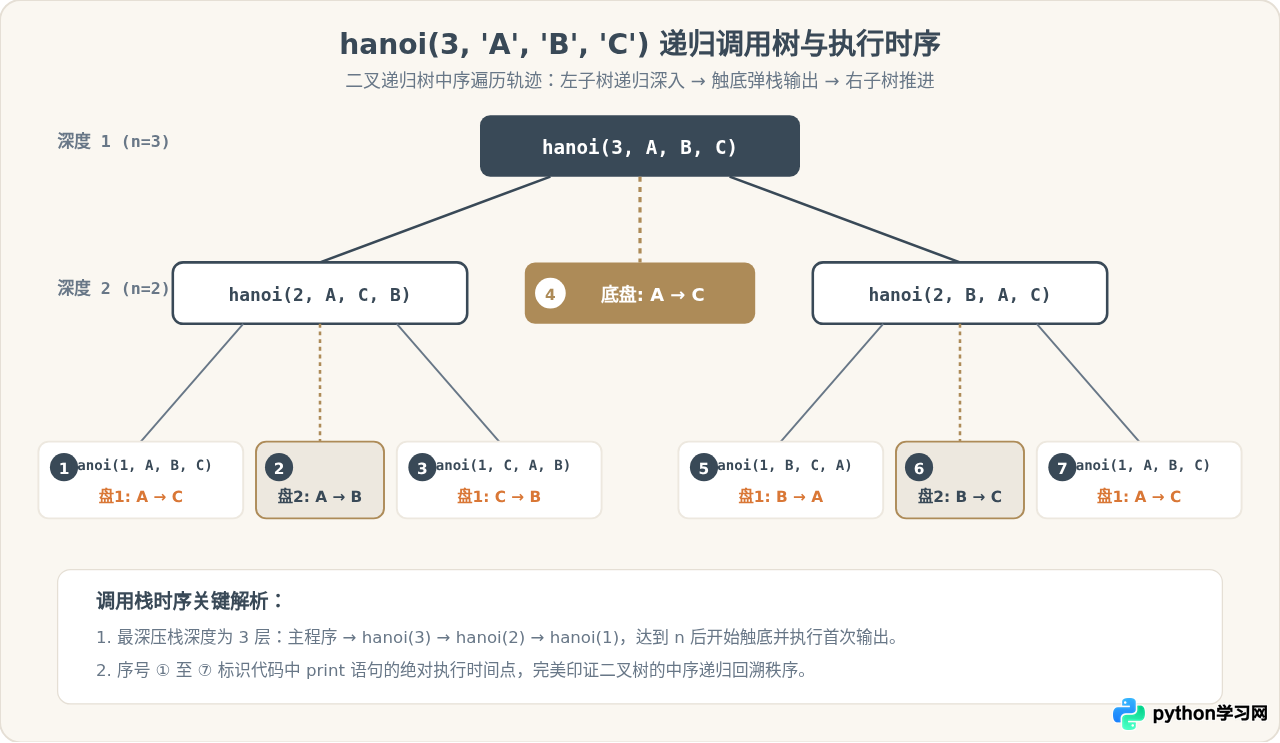
当 Python 执行递归函数时,底层操作系统和解释器会为每次函数调用在调用栈(Call Stack)上开辟独立的栈帧(Stack Frame)。每个栈帧中封存了当次调用的局部变量、传入的实参引用以及执行完毕后的返回地址。
对于 hanoi(3, 'A', 'B', 'C'),其执行过程对应一棵严格的完全二叉调用树。程序的物理移动顺序,本质上是对这棵递归树进行的中序遍历(In-Order Traversal:左子树递归 → 访问本节点输出移动指令 → 右子树递归)。
六、算法复杂度与关键避坑指南
评估汉诺塔算法的性能与工程适用性,需要从递推方程的渐进分析入手:
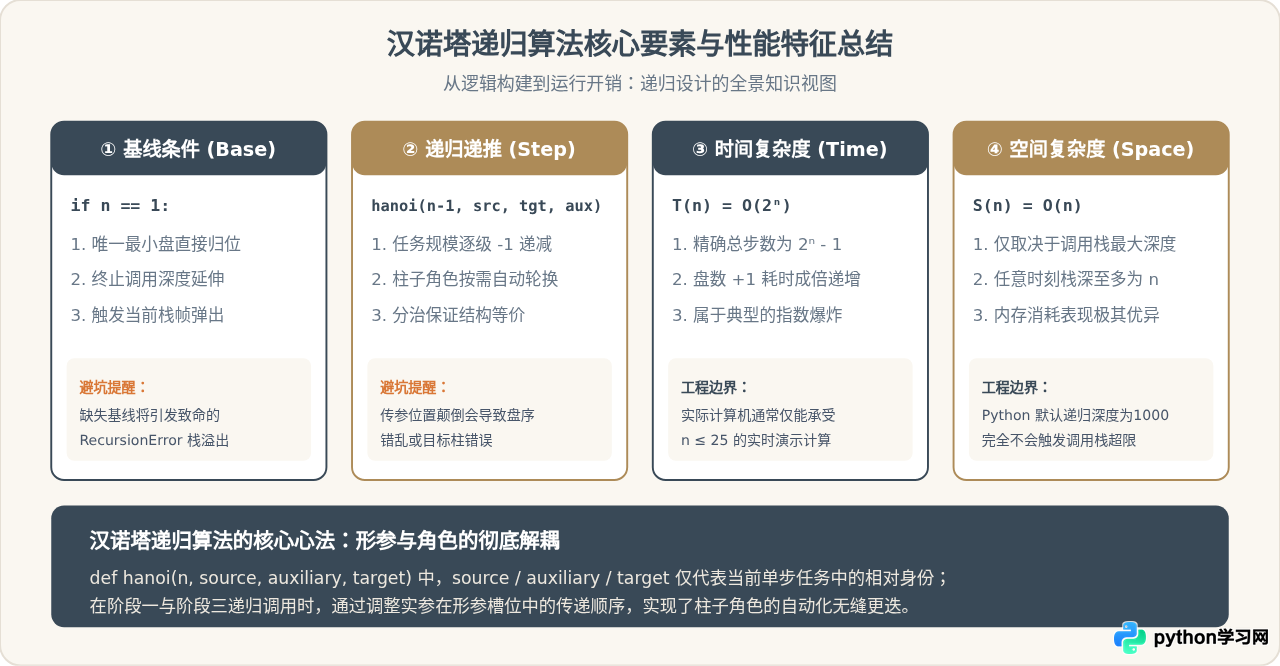
1. 时间复杂度:\(O(2^n)\)
设移动 n 个圆盘所需的操作次数为 \(T(n)\)。根据代码逻辑:
- 基线条件:\(T(1) = 1\)
- 递推关系:\(T(n) = 2 \cdot T(n - 1) + 1\)
两边同时加 1,可得 \(T(n) + 1 = 2 \cdot [T(n - 1) + 1]\)。这是一项公比为 2 的等比数列,其闭式通项公式为:
\[ T(n) = 2^n - 1 \]
这意味着每增加一个圆盘,执行耗时与操作次数就会直接翻倍。当 n = 10 时,总步数为 1,023 次;当 n = 30 时,总步数将超过 10 亿次;而如果 n = 64,即便计算机每秒能执行 10 亿步操作,也需要大约 584 年才能跑完全部流程。因此,汉诺塔算法天然属于指数级复杂度问题。
2. 空间复杂度:\(O(n)\)
尽管汉诺塔的时间开销极其庞大,但其空间复杂度却表现得相当节制,仅为 \(O(n)\)。这是因为递归调用栈的最大深度由树的高度决定,而不是树的节点总数。在任意时刻,调用栈中最多同时存留 n 个栈帧(即从根节点一路向左深入到叶子节点的单链路径),完成左侧回溯后即被垃圾回收或覆盖,因此栈内存的占用与盘数 n 呈线性关系。
七、常见疑问与易错点答疑 (FAQ)
1. 为什么代码中看不到任何移动盘子的物理约束校验?
很多初学者会疑惑:代码里并没有写诸如 if disk_A < disk_B 这样的大盘小盘比对逻辑,程序怎么能确保不违背规则?答案是数学归纳法在递归结构上的保真性。因为:
- 在移动第 n 号盘之前,上方所有比它小的 n-1 个盘已经全部被完整挪走到了辅助柱,A 柱只剩底盘,目标柱 C 此时完全为空;
- 底盘放到 C 柱后,它是全场最大的盘子,后续将任何小盘往 C 柱上叠放,都不可能违背“大盘压小盘”原则;
- 因此,规则的约束并非通过运行时的动态条件判断来维持,而是由递归分治的执行顺序在结构上予以天然保障。
2. Python 递归深度限制会对汉诺塔产生影响吗?
Python 解释器默认的递归栈深度阈值通常为 1000(可通过 sys.getrecursionlimit() 查看)。正如前面空间复杂度分析所述,汉诺塔的调用树最大深度严格等于圆盘总数 n。如果计算 n = 64,栈深仅仅需要 64 层,远低于 1000 的上限。阻碍汉诺塔向更大盘数扩展的瓶颈绝对不是内存或栈深度,而是高达 \(2^n\) 的时间开销。
3. 能否改用非递归(循环迭代)方式实现?
完全可以。汉诺塔存在明确的位运算与状态机规律:例如奇数号盘与偶数号盘的移动周期具有强烈的模 3 循环特性,也可以显式使用自定义的栈数据结构模拟函数压栈。但非递归实现的代码复杂度与状态维护成本明显高于递归版本,递归实现仅需 8 行代码便能精准表达算法全貌,是掌握计算机分治思想最为精炼的经典范例。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















