


Python递归实现汉诺塔:代码详解与执行流程

许多初学者在刚学习递归时,接触的往往是阶乘或斐波那契数列,这类数学递推公式清晰直观,容易让人误以为递归只是简单的“自身调用”。然而一旦面对汉诺塔(Tower of Hanoi),如果试图在脑海中单步追踪每一个盘子的每次挪动,往往很快就会陷入思维过载。理解汉诺塔的关键在于建立分治(Divide and Conquer)信念:我们不需要手动模拟全部几百步具体动作,而是将问题精准拆解为结构完全相同、但规模更小的子问题。本文将从三步递归模型切入,逐行剖析 Python 代码实现,并通过 3 阶实操步骤与调用树,拆解其运行机制与时空开销。
一、汉诺塔问题规则与分治递归模型
汉诺塔源于一个古老的数学传说。现设有三根柱子(分别记为源柱 A、辅助柱 B、目标柱 C),在 A 柱上自底向上按直径由大到小的顺序套有 n 个圆盘。游戏要求在满足以下三项规则的前提下,将所有圆盘完整移至 C 柱:
- 每次只能移动一个圆盘;
- 任何圆盘只能从一根柱子的最顶端取出,放置在另一根柱子的最顶端;
- 在整个移动过程中,大圆盘决不能压在小圆盘之上。
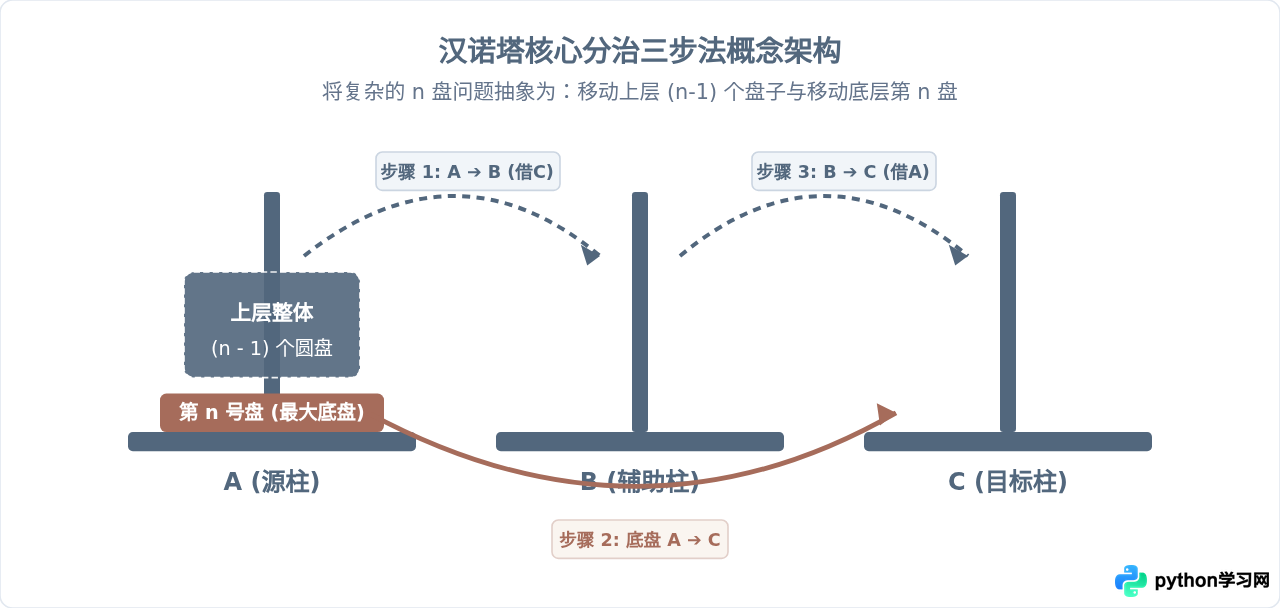
如果只有 1 个盘子,直接从 A 移到 C 即可。但当盘子数量为 n(例如 n > 1)时,任何直接移动底层大盘的尝试都会被上方的盘子阻挡。为了移出最底部的第 n 号大盘,必须先把压在它上面的 n - 1 个盘子全部移开。这就导出了解决汉诺塔问题经典且唯一优美的三步递归模型:
- 第一步(借助目标柱转移上层):将 A 柱上方的
n - 1个盘子视为一个整体,借助 C 柱全部移动到辅助柱 B; - 第二步(归位最大底层盘):此时 A 柱只剩下第
n号最大盘,且 C 柱为空,直接将第n号盘从 A 移到目标柱 C; - 第三步(借助源柱归位上层):将停留在 B 柱上的
n - 1个盘子,借助已经空出底座的 A 柱,全部移动到目标柱 C。
二、Python 递归实现代码与逐行详解
基于上述三步抽象,在 Python 中实现汉诺塔递归函数只需寥寥数行。代码不仅精炼,而且严格映射了分治思想:
def hanoi(n, source, target, auxiliary):
    """
    递归解决汉诺塔问题
    :param n: 当前需要移动的圆盘数量
    :param source: 当前起始柱(源柱)
    :param target: 当前目标柱(终点)
    :param auxiliary: 当前辅助柱
    """
    # 基线条件(Base Case):如果只有 1 个圆盘,直接移动
    if n == 1:
        print(f"移动盘 1: 从 {source} -> {target}")
        return

    # 步骤 1:将上面 n - 1 个盘子从 source 移动到 auxiliary,借助 target
    hanoi(n - 1, source, auxiliary, target)

    # 步骤 2:将底部的第 n 号大盘从 source 移动到 target
    print(f"移动盘 {n}: 从 {source} -> {target}")

    # 步骤 3:将 auxiliary 上的 n - 1 个盘子移动到 target,借助 source
    hanoi(n - 1, auxiliary, target, source)

# 示例调用:移动 3 个盘子,从 A 柱移到 C 柱,以 B 为辅助
if __name__ == "__main__":
    hanoi(3, 'A', 'C', 'B')
核心代码要点逐行解析
初学者阅读这段代码时,最容易混淆的是形参位置的动态轮转。下面详细解析每个关键要素:
- 基线条件
if n == 1:递归必须有明确终止边界。当问题规模缩小到只有一个盘子时,它不受任何大盘压制,直接从当前source输出移动到target即可退出本层调用,防止无限递归导致栈溢出。 - 步骤 1 的传参顺序
hanoi(n - 1, source, auxiliary, target): 这里的核心在于角色互换。对于这n - 1个盘子而言,它们最终要暂存到辅助柱上,因此原本的辅助柱auxiliary充当了本次子调用的“目标柱”,而原本的目标柱target则退居为“辅助柱”。 - 步骤 2 的物理移动
print(f"移动盘 {n}: ..."): 在此刻,由于上方的n - 1个盘子已经被全部妥善移至auxiliary,source顶部只剩第n号盘,而target顶部无任何盘子或仅有比它更大的基座,因此可以合法执行物理转移。 - 步骤 3 的传参顺序
hanoi(n - 1, auxiliary, target, source): 此时n - 1个盘子正堆在auxiliary上。现在它们需要移往真正的终点target,而已被清空的source柱则重新作为中间过渡的“辅助柱”。
三、以 3 阶汉诺塔为例的分步演进全过程
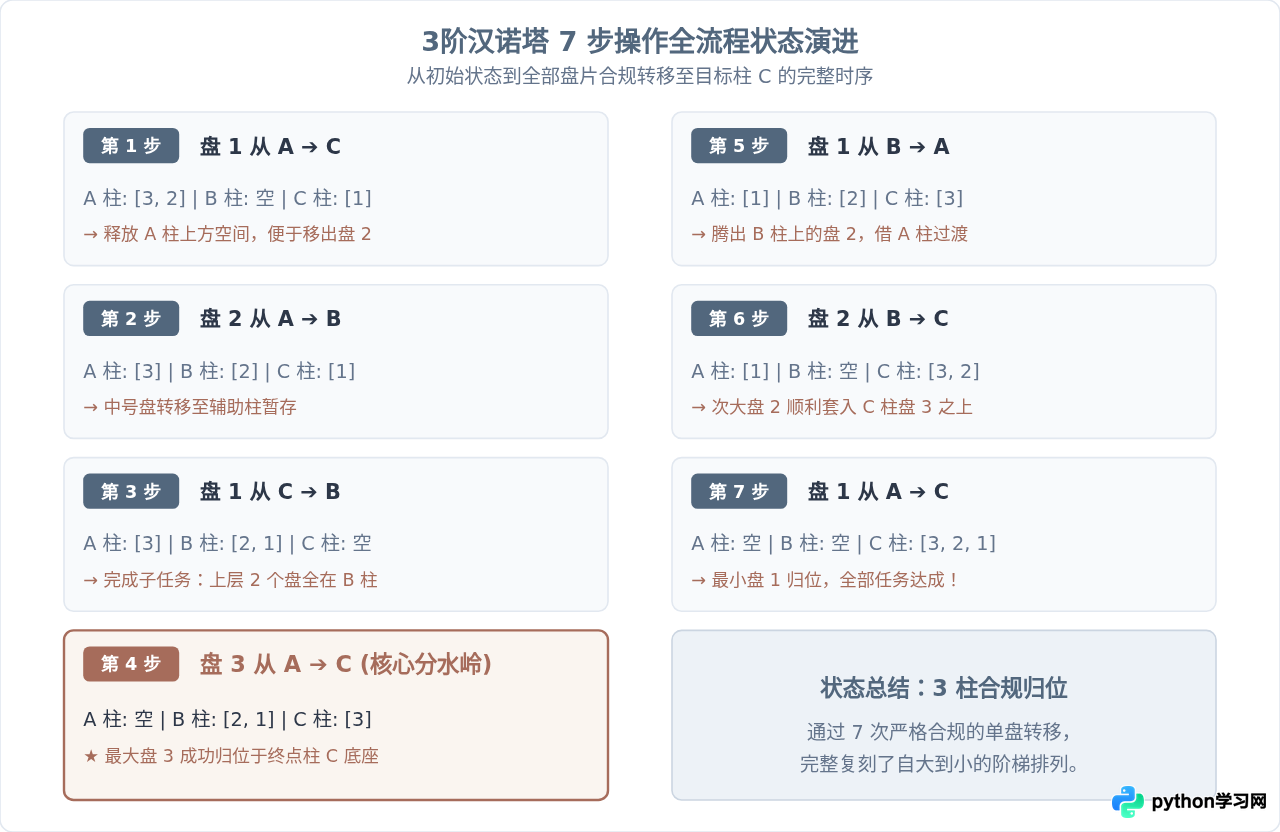
为了直观感受代码执行时的状态跃迁,我们以 n = 3(共 3 个盘子,从小到大依次编号为 1、2、3)为例。总共需要 $2^3 - 1 = 7$ 步操作。以下是 Python 程序执行时的每一步打印结果与对应柱子的实际盘片分布:
| 步骤序号 | 控制台输出指令 | 移动盘号 | 起始柱 | 终点柱 | 操作完成后各柱状态 [A | B | C] |
|---|---|---|---|---|---|
| 初始状态 | - | - | - | - | A: [3, 2, 1] | B: [ ] | C: [ ] |
| Step 1 | 移动盘 1: 从 A -> C | 盘 1 | A | C | A: [3, 2] | B: [ ] | C: [1] |
| Step 2 | 移动盘 2: 从 A -> B | 盘 2 | A | B | A: [3] | B: [2] | C: [1] |
| Step 3 | 移动盘 1: 从 C -> B | 盘 1 | C | B | A: [3] | B: [2, 1] | C: [ ] |
| Step 4 | 移动盘 3: 从 A -> C | 盘 3 | A | C | A: [ ] | B: [2, 1] | C: [3] |
| Step 5 | 移动盘 1: 从 B -> A | 盘 1 | B | A | A: [1] | B: [2] | C: [3] |
| Step 6 | 移动盘 2: 从 B -> C | 盘 2 | B | C | A: [1] | B: [ ] | C: [3, 2] |
| Step 7 | 移动盘 1: 从 A -> C | 盘 1 | A | C | A: [ ] | B: [ ] | C: [3, 2, 1] |
四、递归调用树与底层执行栈追踪
为了探究 Python 解释器在背后究竟如何调度这些函数,我们需要观察其调用栈(Call Stack)的动态变化。在计算机内部,每次调用 hanoi() 都会在内存的调用栈顶分配一个栈帧(Stack Frame),用来保存局部变量 n、source、target、auxiliary 以及当前执行到的行号代码指令。
调用 hanoi(3, 'A', 'C', 'B') 的本质是展开一棵二叉递归树。树的中序遍历(In-order Traversal)正好对应了控制台实际输出的 7 条移动指令:
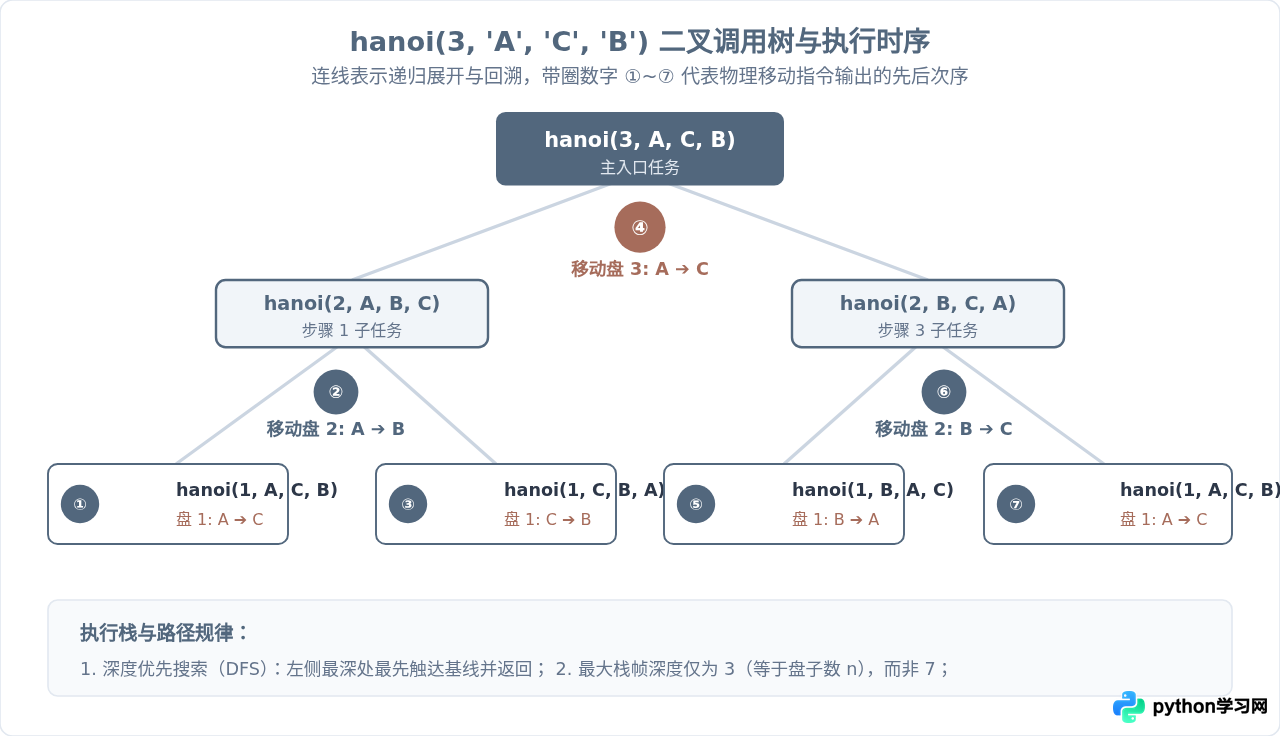
很多读者会下意识地认为“既然有 7 步移动,内存中是不是同时存在 7 个栈帧?”答案是否定的。递归调用是深度优先(DFS)的。在左子树完全执行完毕并弹栈释放之后,计算机才会去压入右子树的栈帧。因此,任何时刻内存中的最大活跃调用层数正好等于树的高度,即 n。移动 3 个盘子时,系统调用栈在任一时刻最多只有 3 层。
五、算法时空复杂度与常见认知误区
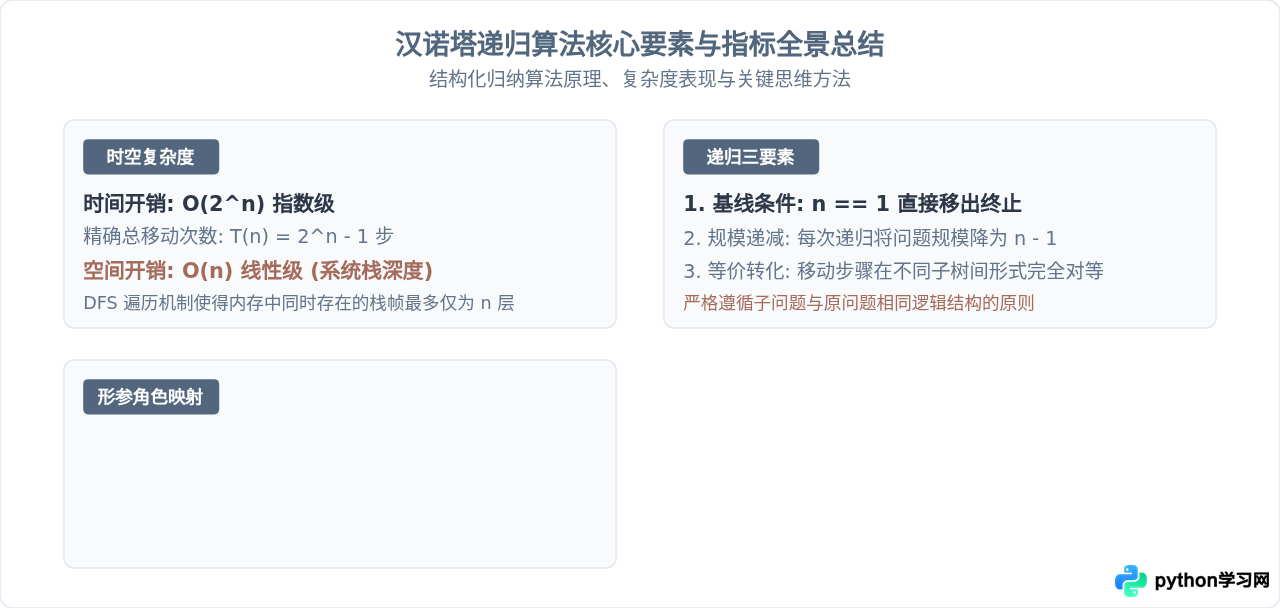
1. 时间复杂度:为什么是 $O(2^n)$
设移动 n 个盘子所需的总移动次数为 $T(n)$。根据递归三步法:
- 移动上面 $n-1$ 个盘子到辅助柱,需要 $T(n-1)$ 次;
- 移动底部的第 $n$ 个盘子,需要 $1$ 次;
- 将辅助柱上的 $n-1$ 个盘子移到目标柱,又需要 $T(n-1)$ 次。
因此得到递推方程:
T(1) = 1
T(n) = 2 * T(n-1) + 1
我们对两边同时加 1:
T(n) + 1 = 2 * (T(n-1) + 1)可知序列 $\{T(n) + 1\}$ 是首项为 $T(1) + 1 = 2$,公比为 $2$ 的等比数列。因此:
T(n) + 1 = 2^n => T(n) = 2^n - 1这意味着时间复杂度为严格的 $\mathcal{O}(2^n)$。当 $n = 64$ 时,移动次数高达 $2^{64} - 1 \approx 1.84 \times 10^{19}$ 次。即便计算机每微秒完成一次移动,也需要约 5849 亿年才能完成。这种指数级增长特性由数学本质决定,不可通过算法内部优化去除。
2. 空间复杂度:$\mathcal{O}(n)$
如前所述,辅助空间完全由递归系统栈的深度决定。系统栈的最大深度与递归树的高度一致,即为 $\mathcal{O}(n)$。尽管时间开销呈指数级膨胀,但空间增长却是温和的线性增长,这也是汉诺塔算法极其精巧的特性之一。
3. 初学者最易陷入的思维误区
- 误区一:试图在人脑中“单步追踪完整调用”。
很多人刚学递归时,总想一步步算出每一个子调用的每一步。当 $n=3$ 时勉强能推演,但当 $n=10$ 时计算量达到 1023 步,人脑必定“栈溢出”。正确的递归思考方式是数学归纳法思维:只要我相信
hanoi(n-1)能够正确把 $n-1$ 个盘子移走,那么我只需要处理好当前第 $n$ 个盘子即可。 - 误区二:混淆“形参名”与“实参名”。
许多人在调试代码时困惑于
source、target和auxiliary为什么在不同函数层级对应不同的字母。必须牢记:在代码中,形参表示的是当前子问题中的角色职责,而不是物理上的固定柱子。每次调用都会根据当前任务将实际的物理柱('A', 'B', 'C')映射到对应的逻辑角色上。
总结
汉诺塔问题之所以作为计算机科学教学中最经典的递归案例,是因为它以最纯粹的形式展现了“分治”与“递归”的本质魅力。通过将庞杂的移动步骤抽象为“上层 $n-1$ 个盘子”与“底层最大盘”,我们用短短十几行 Python 代码就解决了指数级操作复杂度的难题。掌握形参在调用过程中的动态角色绑定,以及基于深度优先遍历的调用栈演变,不仅能帮助你彻底攻克汉诺塔,更能为后续理解二叉树遍历、快速排序、回溯算法等更复杂的树形递归算法打下坚实的认知基础。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















