


Python正则表达式常用元字符与语法规则详解
系统详解Python正则表达式常用元字符与语法规则,包括字符类、数量限定符、边界锚点、分组捕获及re模块匹配流程与实用避坑指南。
re 模块实现。熟练掌握常用元字符与语法规则,能够避免模糊盲目的字符串切片,以严谨高效的模式匹配解决复杂的文本清洗与结构化抽取任务。
一、原生字符串(Raw String)与转义机制
在 Python 中编写正则表达式时,首要准则是始终使用原生字符串前缀 r"..."。普通 Python 字符串会将反斜杠 \ 作为自身的转义引导字符(例如 \n 表示换行符、\t 表示制表符)。而正则表达式引擎本身也有独立的转义解析规则。
如果不使用原生字符串,要想在正则表达式中表达一个反斜杠字符字面量,Python 字符串层面需要先转义为 "\\\\",然后再由正则表达式解析为单个 \,造成繁琐的双重转义。使用原生字符串后,Python 不会对 \ 提前转义,直接完整传递给底层正则引擎:
import re

# 推荐写法:使用原生字符串 r""
pattern = r"\\section"

# 非原生字符串:需要写 4 个反斜杠
bad_pattern = "\\\\section"
二、常用单字符匹配元字符
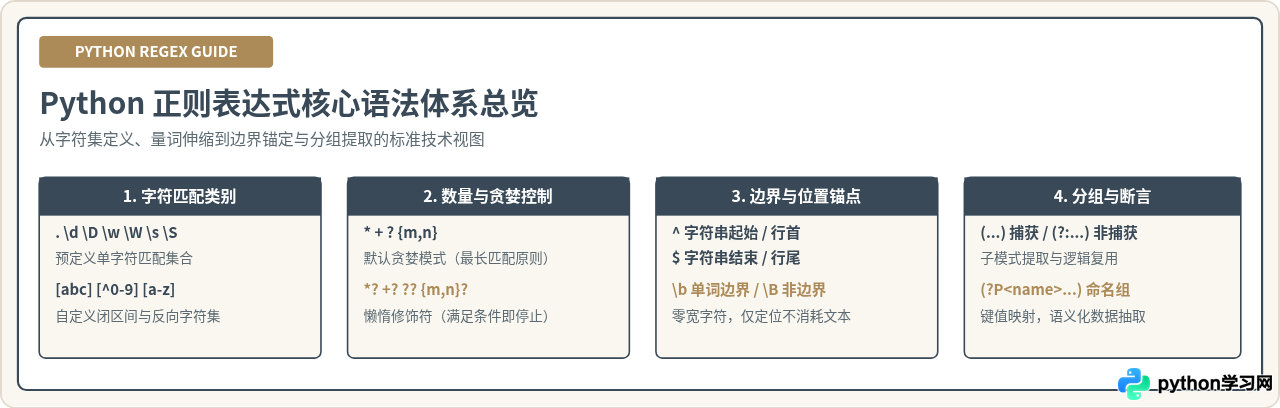
元字符是正则表达式中具有特殊语法含义的保留字符。最基础的元字符用于指定某一个位置上允许出现的单个字符类别。
| 元字符 | 语法含义 | 示例与匹配结果 |
|---|---|---|
. |
匹配除换行符 \n 外的任意单个字符(开启 DOTALL 模式可匹配换行符) |
a.c 匹配 abc, a1c, a_c;不匹配 a\nc |
\d |
匹配任意一个十进制数字,等价于 [0-9] |
id_\d\d 匹配 id_01, id_99 |
\D |
匹配任意一个非数字字符,等价于 [^0-9] |
\D\d+ 匹配 A123, #42 |
\w |
匹配字母、数字及下划线,ASCII 模式下等价于 [a-zA-Z0-9_] |
user_\w+ 匹配 user_admin, user_007 |
\W |
匹配任意非单字字符,即非字母、数字和下划线 | \w+\W\w+ 匹配 hello world, code#tag |
\s |
匹配任意空白字符(包含空格、制表符 \t、换行符 \n 等) |
price:\s*\d+ 匹配 price: 100, price:\t50 |
\S |
匹配任意非空白字符 | \S+ 匹配连续的非空内容 |
自定义字符集:方括号 [...]
当预定义字符类无法满足精确匹配时,可使用方括号自定义字符集。在方括号内,普通元字符多数会失去特殊含义变回字面量(如 [.] 仅匹配句号点本身):
- 列举枚举:
[aeiou]匹配任意一个元音字母。 - 范围区间:
[a-z]匹配任意小写字母;[0-9A-Fa-f]匹配十六进制字符。 - 反向字符集:脱字符
^放在方括号最左端表示“非”匹配。例如[^0-9]匹配非数字字符;如果^不在第一个位置(如[a^b]),则仅代表字符^本身。
三、数量限定符与贪婪/非贪婪模式
数量限定元字符紧跟在字符或分组之后,用于指定前导模式出现的重复频次:
*:匹配前导字符 0 次或多次(即任意次)。例如go*gle匹配ggle、gogle、google。+:匹配前导字符 1 次或多次(至少出现一次)。例如go+gle匹配gogle,但不匹配ggle。?:匹配前导字符 0 次或 1 次(可选项)。例如colou?r可同时兼容color与colour。{n}:精确匹配前导字符恰好出现n次。例如\d{4}匹配连续 4 位数字。{n,}:匹配前导字符至少出现n次。{n,m}:匹配前导字符出现n到m次(包含两端)。例如\d{6,8}匹配 6 到 8 位连续数字。
贪婪匹配与惰性匹配的运行差异
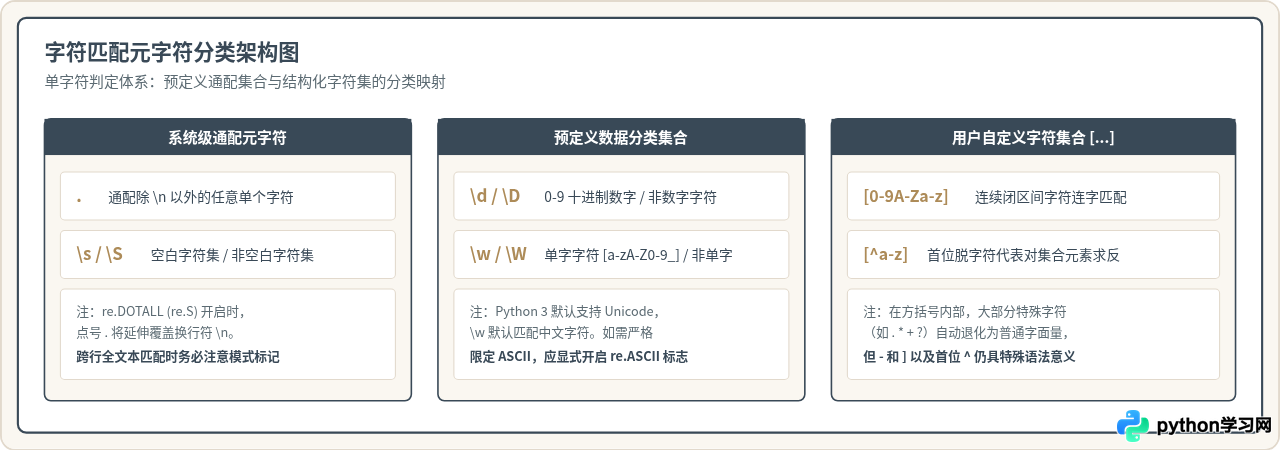
在正则表达式中,上述数量词默认处于贪婪模式(Greedy),即引擎会尝试吃掉尽可能多的字符,只有在后续模式不匹配时才一步步“吐出”字符进行回溯。
如果在任何数量词后紧跟一个问号 ?(例如 *?、+?、??、{m,n}?),则会切换为非贪婪/懒惰模式(Lazy)。此时引擎会在满足整体模式的前提下,尽可能少地消耗字符。
四、边界匹配与位置锚点
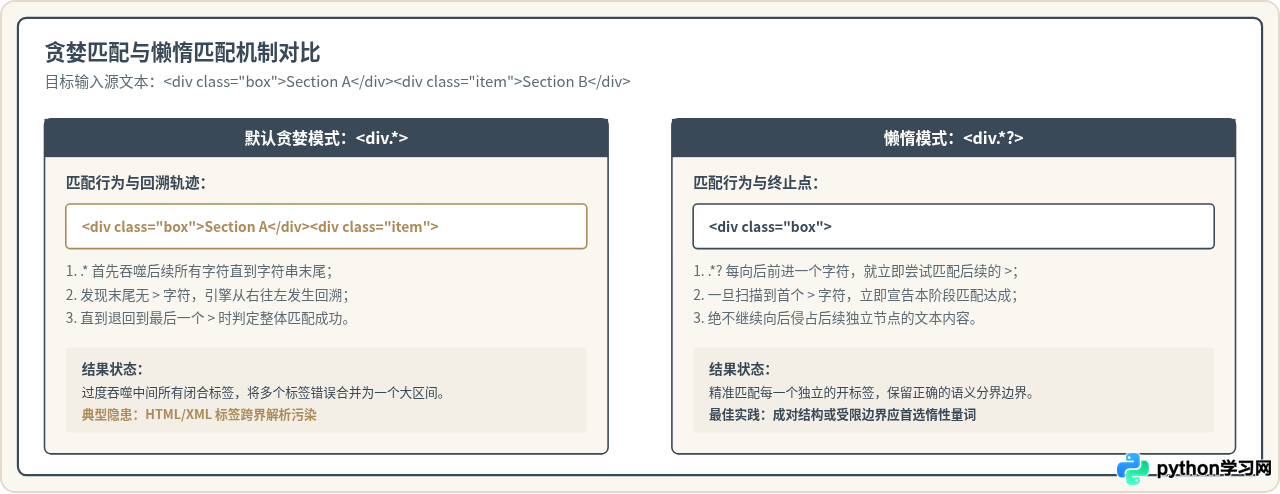
边界元字符不消耗实际的字符(即不占位,属于零宽断言),它们只对特定的“位置”进行判定,常用于确保数据从首至尾完全符合规范:
^:匹配输入字符串的起始位置。当设置re.MULTILINE标志时,也能匹配每一行的行首。$:匹配输入字符串的末尾位置。当设置re.MULTILINE时,匹配每一行的行尾。\b:匹配单词边界(即\w与\W、或\w与字符串首尾的交界处)。\B:匹配非单词边界(位置两边同为\w或同为\W)。
若在文本中查找独立单词 is,使用模式 r"is" 会错误匹配到 this 或 island 中的子串;改用 r"\bis\b" 能够严格限定前后必须为单词分界,杜绝误伤。
五、分组、捕获与高级断言
圆括号 (...) 在正则表达式中具备多重能力,主要负责提高运算优先级、形成模式子集以及提取结构化数据。
1. 捕获组与非捕获组
- 常规捕获组
(pattern):将括号内的匹配内容缓存到内存中,后续可通过编号(group(1),group(2))或反向引用\1调用。 - 非捕获组
(?:pattern):仅将模式作为整体应用量词(如(?:abc)+匹配连续的abc),但不提取也不消耗捕获编号,运行效率更高。 - 命名捕获组
(?P<name>pattern):为提取的分组赋予可读性更高的字符串键名,匹配后直接通过match.group('name')或match.groupdict()获取字典映射。
2. 分支选择:竖线 |
竖线表示“或”逻辑,匹配符号左侧或右侧的子表达式。由于 | 的运算符优先级较低,通常必须搭配括号限制作用域。例如 cat|dog 匹配 cat 或 dog;而 (P|p)ython 精确匹配 Python 或 python。
3. 环视零宽断言(Lookaround)
环视用于在不消耗字符的前提下,检查目标模式的前后上下文环境:
(?=...)正向前瞻:要求后方紧随指定内容。例如\d+(?=px)匹配1920px中的数字1920,但不提取px。(?!...)负向前瞻:要求后方不得紧随指定内容。例如\d{3}(?!\d)匹配不跟数字的 3 位数。(?<=...)正向后顾:要求前方紧随指定内容。例如(?<=\$)\d+匹配$100中的100。(?<!...)负向后顾:要求前方不得紧随指定内容。
六、Python re 模块标准操作流程
在实际工程代码中,调用正则表达式通常遵循固定的准备、编译、执行与提取流程。规范的流程不仅能提高代码可读性,还能借助预编译显著提升循环中的正则执行性能。
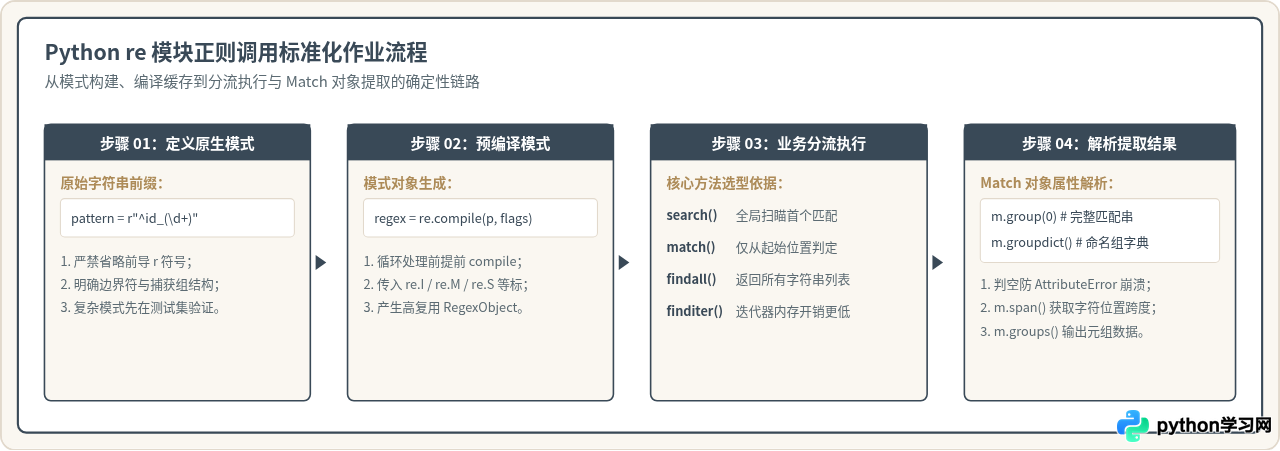
核心执行代码示例
import re

text = "系统订单: ORDER_20261025_9871, 金额: 5600 元, 状态: SUCCESS"

# 1. 编译命名捕获组正则表达式
order_pattern = re.compile(
    r"ORDER_(?P<date>\d{8})_(?P<id>\d+).*?金额:\s*(?P<amount>\d+)",
    re.IGNORECASE
)

# 2. 搜索匹配内容
match = order_pattern.search(text)

if match:
    # 提取命名组字典
    data = match.groupdict()
    print("提取数据:", data)
    # 输出: 提取数据: {'date': '20261025', 'id': '9871', 'amount': '5600'}
else:
    print("未匹配到合规订单信息")
七、语法规则速查与常见避坑指南
在实际编码中,正则引发的 bug 往往不是语法报错,而是逻辑偏差或性能恶化。掌握以下速查要点可规避绝大多数隐性错误:
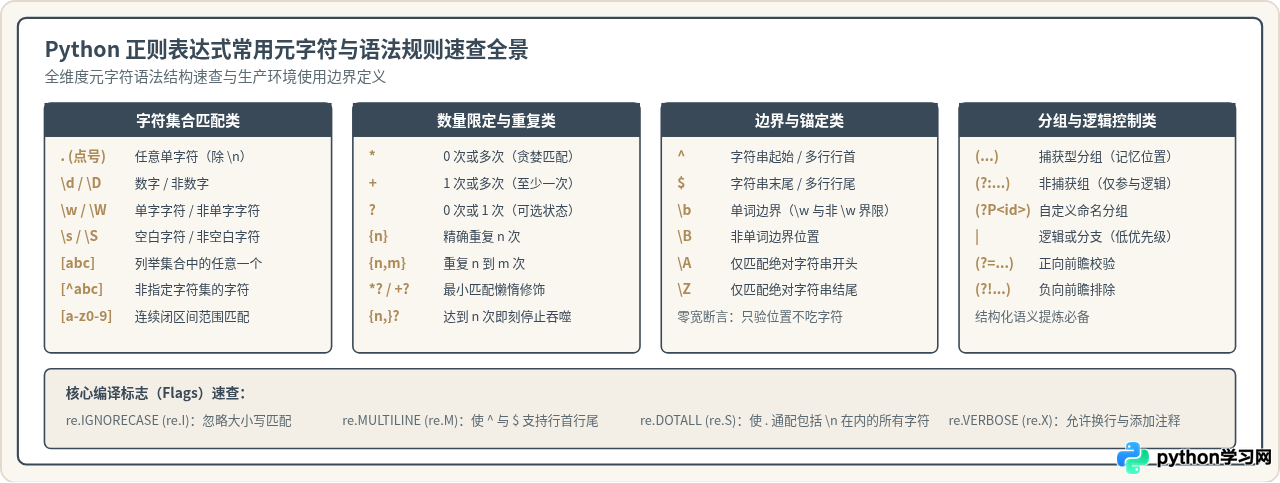
工程实践中的高频陷阱
-
混淆
re.match()与re.search():
re.match()必须从字符串的最左端第一位起就匹配成功,若第一位不满足则立即返回None;而re.search()会扫描整个字符串寻找第一处匹配。检索长文本内的子串时应使用search()。 -
灾难性回溯(Catastrophic Backtracking):
嵌套量词(如(a+)+$或(.*\d+)*)在面对不匹配的长输入时,状态机会进行指数级的回溯尝试,导致 CPU 占用率 100% 并引发线程卡死。编写模式时应尽量精确字符集,避免两个连续模糊量词的无约束嵌套。 -
findall()中的捕获组陷阱:
当正则表达式中包含捕获组()时,re.findall()会默认仅返回捕获组中的内容,而不是整段匹配的字符串。若需要返回完整匹配项,应将括号改为非捕获组(?:...),或改用re.finditer()通过match.group(0)提取。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















