


Python离线翻译中文怎么实现?使用transformers本地模型方案
详细讲解如何使用 Python 与 Hugging Face transformers 库实现纯离线环境下的英文到中文翻译,涵盖本地模型权重下载、环境配置、断网加载机制、长文本与批量推理处理及常见报错排查。
在企业内网开发、敏感数据处理或脱网边缘设备运行等场景中,调用在线翻译 API(如 Google 翻译或百度翻译)不仅面临网络阻断,还存在数据外泄的合规风险。使用 Python 实现高质量离线中文翻译的核心解决路径,是利用 Hugging Face 提供的 transformers 库,结合本地存储的轻量预训练 Seq2Seq 翻译模型(如 Helsinki-NLP 推出的 opus-mt-en-zh)。开发者提前在外网环境下载模型架构、词表与权重,随后在内网环境中通过本地目录路径加载,并设置参数强制阻断所有外部网络连接,即可在纯本地 CPU 或 GPU 上完成文本向量化、序列解码与中文生成。
一、离线翻译的核心原理与架构设计
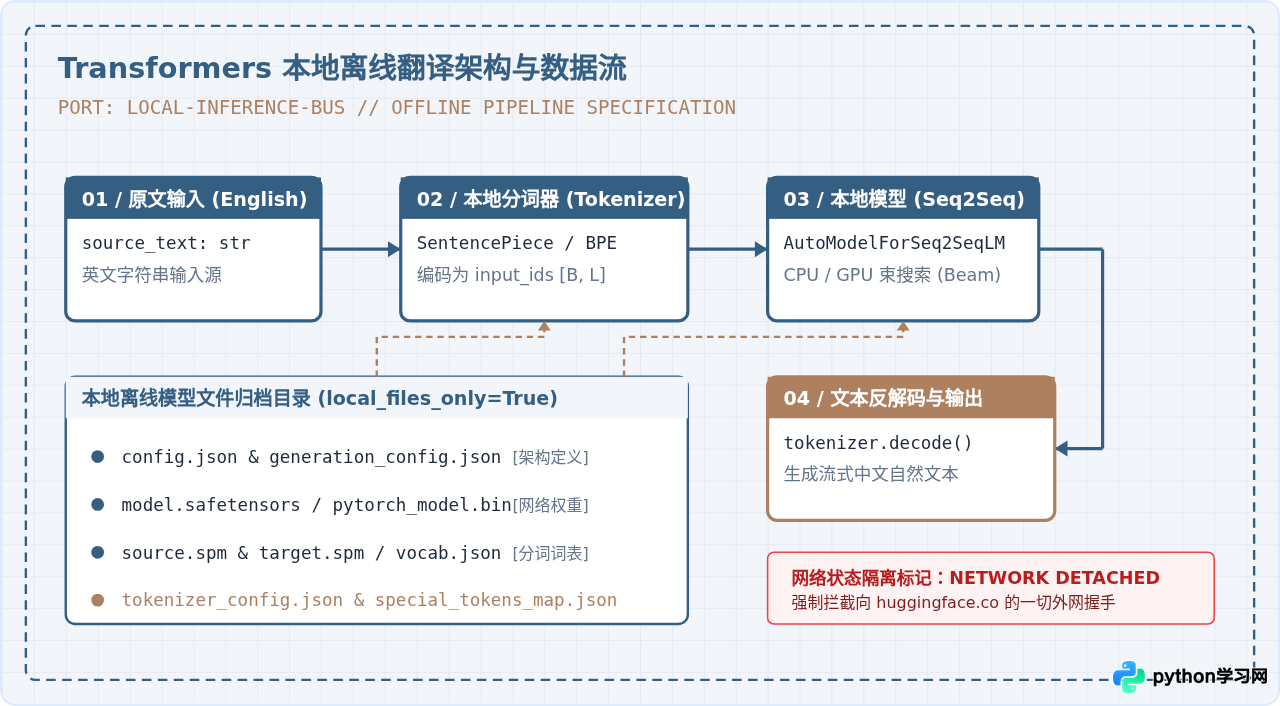
离线翻译的本质是在没有互联网连接的情况下,完全依靠本地计算资源运行深度学习翻译模型。基于 transformers 库的离线方案主要包含三个核心环节:本地模型分词(Tokenizer)、模型推理引擎(Seq2Seq Model)以及离线隔离配置(Local Cache Management)。
首先,分词器(如基于 SentencePiece 算法的 Tokenizer)负责将输入的英文长句切割成子词(Subwords)并映射为整数向量(Token IDs)。随后,Seq2Seq 编码器-解码器架构(如 MarianMT)接收这些输入向量,在本地执行注意力机制计算,并在解码端逐词预测最匹配的中文目标向量。最后,分词器将输出的整数序列反向解码为人类可读的中文句子。整个过程中,代码通过指定 local_files_only=True 彻底禁用向 Hugging Face Hub 发起 HTTP/HTTPS 探测,确保断网环境下的确定性运行。
二、环境准备与核心依赖安装
在离线运行前,必须确保 Python 环境中已经安装了 PyTorch、Transformers 以及处理词表必需的 SentencePiece。建议使用 Python 3.8 至 3.11 版本。
1. 在有外网环境中安装依赖
如果目标机器当前尚能访问网络,可以直接通过 pip 完成安装:
# 安装 PyTorch(CPU 版本或根据显卡安装对应 CUDA 版本)
pip install torch --index-url https://download.pytorch.org/whl/cpu

# 安装 transformers 与分词必须的 sentencepiece
pip install transformers sentencepiece
2. 针对纯离线内网机器的打包方案
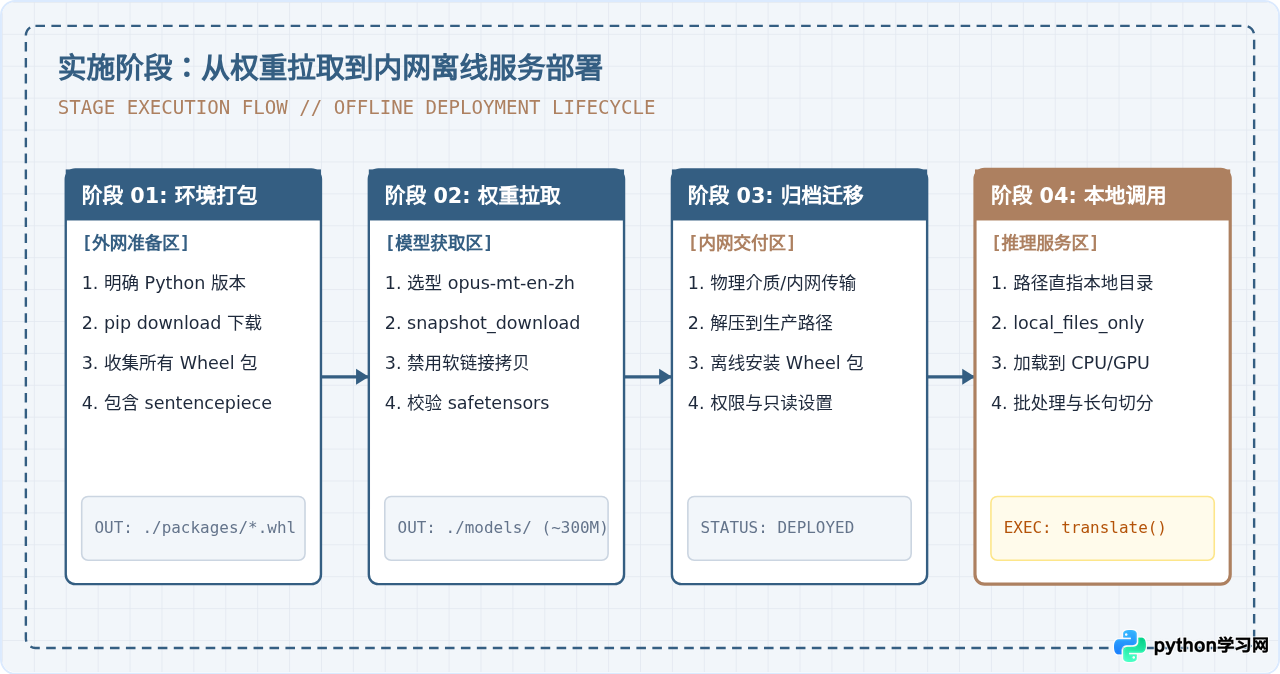
如果内网机器完全无法访问外网,可以在一台同架构、同 Python 版本的有网机器上执行包下载命令,生成离线 Wheel 包后拷贝至目标机:
# 步骤 A:在外网机器将依赖 Wheel 包下载到本地 packages 目录
pip download -d ./packages torch transformers sentencepiece

# 步骤 B:将 packages 目录拷贝至内网机器后,执行免联网安装
pip install --no-index --find-links=./packages torch transformers sentencepieceHelsinki-NLP/opus-mt-en-zh 模型的分词器底层依赖 sentencepiece。很多初学者在只安装了 transformers 时运行会报错 ImportError: SentencePiece is required for MarianTokenizer。在离线环境分发前,务必核对该包已正确安装在环境中。
三、本地翻译模型选型与权重下载
面对不同的业务要求,开源社区提供了多种可选的机器翻译模型。针对中文翻译,主要的代表模型及特征如下:
| 模型名称 | 参数规模 / 权重体积 | 翻译方向 | 推荐运行硬件 | 典型适用场景 |
|---|---|---|---|---|
| Helsinki-NLP/opus-mt-en-zh | 约 77M 参数 / ~300MB | 英文 -> 中文 | 普通多核 CPU / 边缘设备 | 轻量、快速、日常文档与界面翻译 |
| Helsinki-NLP/opus-mt-zh-en | 约 77M 参数 / ~300MB | 中文 -> 英文 | 普通多核 CPU / 边缘设备 | 反向翻译、双向对照 |
| facebook/m2m100_418M | 418M 参数 / ~1.9GB | 100 种多语言互译 | 8GB 内存 / 入门级 GPU | 多语言复杂混译、专业精度要求 |
对于大部分常规的英文译中文需求,Helsinki-NLP/opus-mt-en-zh 是性价比最高的选择:模型体积仅约 300MB,推理开销低,即使在无 GPU 的纯 CPU 服务器上也能实现百毫秒级别的翻译响应。
完整下载模型权重文件
模型权重必须完整保存在本地目录中。可以使用 huggingface_hub 提供的 snapshot_download 函数进行一键下载:
from huggingface_hub import snapshot_download

# 指定模型名称与保存的本地目标路径
model_repo = "Helsinki-NLP/opus-mt-en-zh"
target_local_dir = "./models/opus-mt-en-zh"

print("正在下载模型及完整分词词表...")
snapshot_download(
    repo_id=model_repo,
    local_dir=target_local_dir,
    local_dir_use_symlinks=False  # 确保下载真实文件,防止软链接在拷贝时损坏
)
print("模型下载完成,已保存至:", target_local_dir)
下载完成后,检查 ./models/opus-mt-en-zh 目录,必须包含以下核心文件:
config.json:模型超参数与结构配置pytorch_model.bin或model.safetensors:模型核心权重source.spm与target.spm:源语言与目标语言的 SentencePiece 词表文件tokenizer_config.json与vocab.json:分词器映射与特殊标记定义
四、核心代码实现:本地加载与离线翻译
在内网生产环境中,编写 Python 脚本加载本地模型进行推理。为了避免由于默认配置引起的不必要网络请求,必须严格显式传入本地路径和断网控制开关。
完整可运行示例
import os
import torch
from transformers import AutoTokenizer, AutoModelForSeq2SeqLM

# 1. 设置模型所在的绝对或相对本地路径
MODEL_PATH = "./models/opus-mt-en-zh"

# 2. 判断运算设备:若无 GPU 则使用 CPU
device = "cuda" if torch.cuda.is_available() else "cpu"

print(f"当前运行计算设备: {device}")
print("正在从本地磁盘加载分词器与翻译模型...")

# 3. 加载本地分词器与模型(关键参数: local_files_only=True)
tokenizer = AutoTokenizer.from_pretrained(
    MODEL_PATH,
    local_files_only=True
)

model = AutoModelForSeq2SeqLM.from_pretrained(
    MODEL_PATH,
    local_files_only=True
).to(device)

# 设置模型为评估模式,关闭 Dropout
model.eval()

def translate_en_to_zh(text: str) -> str:
    """
    接收英文纯文本,返回离线翻译后的中文文本
    """
    if not text.strip():
        return ""

    # 将文本转换为模型张量输入
    encoded_input = tokenizer(
        text,
        return_tensors="pt",
        padding=True,
        truncation=True,
        max_length=512
    ).to(device)

    # 禁用梯度计算以节省内存与显存
    with torch.no_grad():
        generated_tokens = model.generate(
            **encoded_input,
            num_beams=4,          # 使用 4 束集束搜索提升翻译流畅度
            max_length=512,       # 输出最大 token 长度限制
            early_stopping=True   # 命中终止标记立即停止
        )

    # 将生成的 token 还原为中文字符串
    translated_result = tokenizer.decode(
        generated_tokens[0],
        skip_special_tokens=True  # 过滤 <pad>、<s> 等特殊标记
    )
    return translated_result

if __name__ == "__main__":
    sample_text = "Transformers provides APIs and tools to easily download and train state-of-the-art pretrained models."
    zh_result = translate_en_to_zh(sample_text)

    print("\n--- 翻译执行验证 ---")
    print("【英文原文】:", sample_text)
    print("【中文译文】:", zh_result)
关键参数解析
local_files_only=True:该参数至关重要。如果不显式设置,Transformers 库在初始化时仍会尝试尝试向远端检查文件是否有更新,在断网环境下会导致长时间的网络连接超时阻塞或报MaxRetryError。num_beams=4:启用 Beam Search(集束搜索)。相比于贪心解码(Greedy Search,即num_beams=1),Beam Search 会在每一步保留候选概率最高的分支,大幅提升翻译语句的自然度和语病控制水平。skip_special_tokens=True:解码时必须开启,否则输出结果可能会夹带<pad>、<s>等模型控制标记。
五、进阶优化:长文本分段与批量推理
在实际业务中,我们通常需要翻译成百上千篇文档或很长的段落。直接将数千字的长文本输入模型会导致超出模型的最大上下文窗口(通常为 512 个 Token),超出部分会被直接截断丢失。为此,需要进行分句分块和批量化(Batching)处理。
1. 规则分句与长文本保护
对长文本根据标点符号(句号 .、换行 \n、感叹号 ! 等)切分成句子列表,分批次翻译后再重新拼装:
import re

def split_sentences(text: str) -> list[str]:
    """按英文常见标点切分段落为句子列表"""
    sentences = re.split(r'(?<=[.?!])\s+', text)
    return [s.strip() for s in sentences if s.strip()]
2. 批处理(Batch)推理优化性能
相比于单句循环翻译,将多个句子组合为一个 Batch 传入模型,可以充分调动 CPU 多线程或 GPU 的矩阵并行能力,吞吐量可提升 3 至 5 倍:
def translate_batch(sentences: list[str], batch_size: int = 8) -> list[str]:
    """批量翻译句子列表"""
    results = []
    for i in range(0, len(sentences), batch_size):
        batch = sentences[i : i + batch_size]
        inputs = tokenizer(batch, return_tensors="pt", padding=True, truncation=True, max_length=512).to(device)
        with torch.no_grad():
            outputs = model.generate(**inputs, num_beams=4, max_length=512)
        decoded = tokenizer.batch_decode(outputs, skip_special_tokens=True)
        results.extend(decoded)
    return results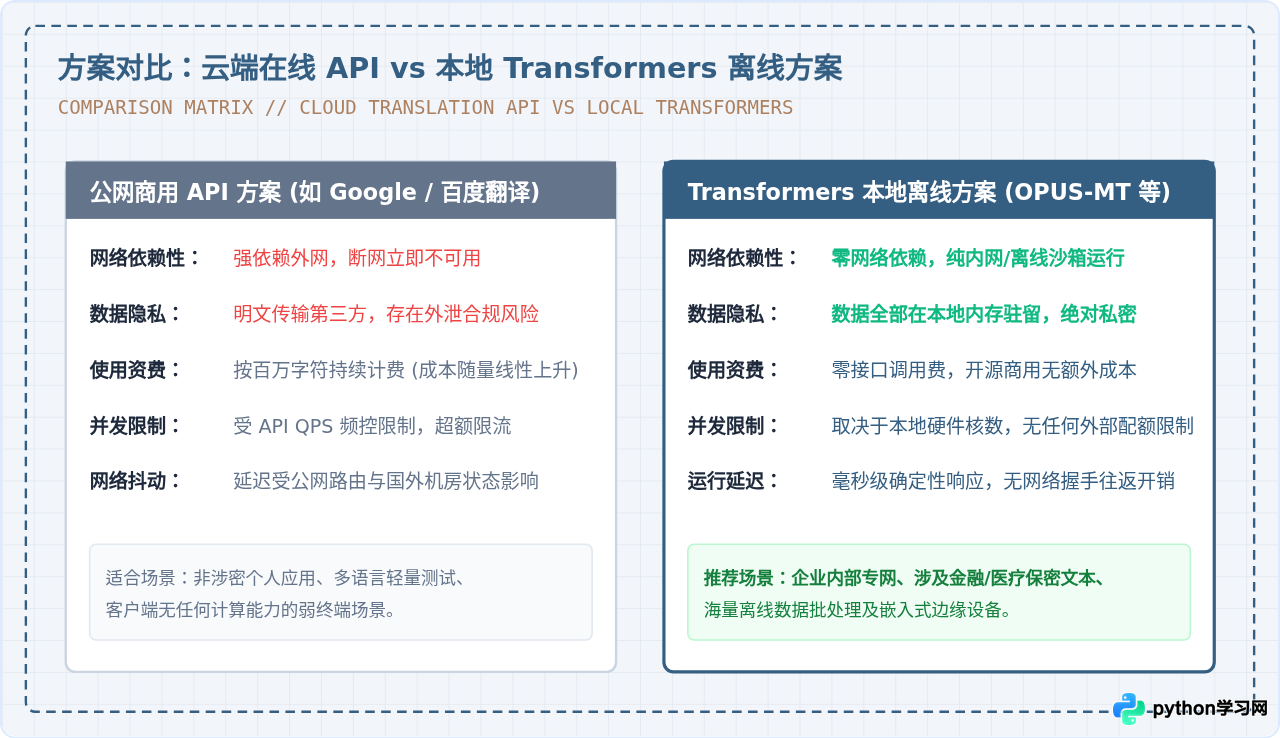
六、常见问题排查与注意事项
在实际落地离线方案的过程中,由于缺少网络日志或缺少某些系统依赖,常常会遇到以下几类典型问题:
1. 报错:OSError: We couldn't connect to 'https://huggingface.co'
原因排查:这是初学者最常见的问题。有两种可能:
- 未在代码中传递
local_files_only=True,Transformers 试图联网检测新版本; - 传入的
MODEL_PATH路径错误,或者该路径下缺少config.json等核心配置文件,导致库试图回退到云端拉取。
解决方法:确保目录内文件完整,并确认代码中传入的是正确的本地目录路径,且设置了 local_files_only=True。
2. 报错:ImportError: SentencePiece is required for MarianTokenizer
原因排查:Marian 架构(即 OPUS 系列模型)使用 SentencePiece 作为底层分词驱动,Python 环境中缺少 C++ 拓展库 sentencepiece。
解决方法:在目标环境中安装 sentencepiece。Windows/Linux 均可通过 pip install sentencepiece 直接安装预编译的二进制 Wheel。
3. 显存溢出(CUDA Out of Memory)或 CPU 占用过高
优化策略:
- 如果是纯 CPU 推理,可以通过
torch.set_num_threads(4)控制 PyTorch 占用的 CPU 线程数,防止抢占全部核心导致系统卡死; - 如果是 GPU 推理,对于
opus-mt-en-zh这种 300MB 的模型,单张显卡仅占用不到 1GB 显存;若翻译批量大,减小batch_size(例如从 32 降到 8)即可稳定运行。
七、总结
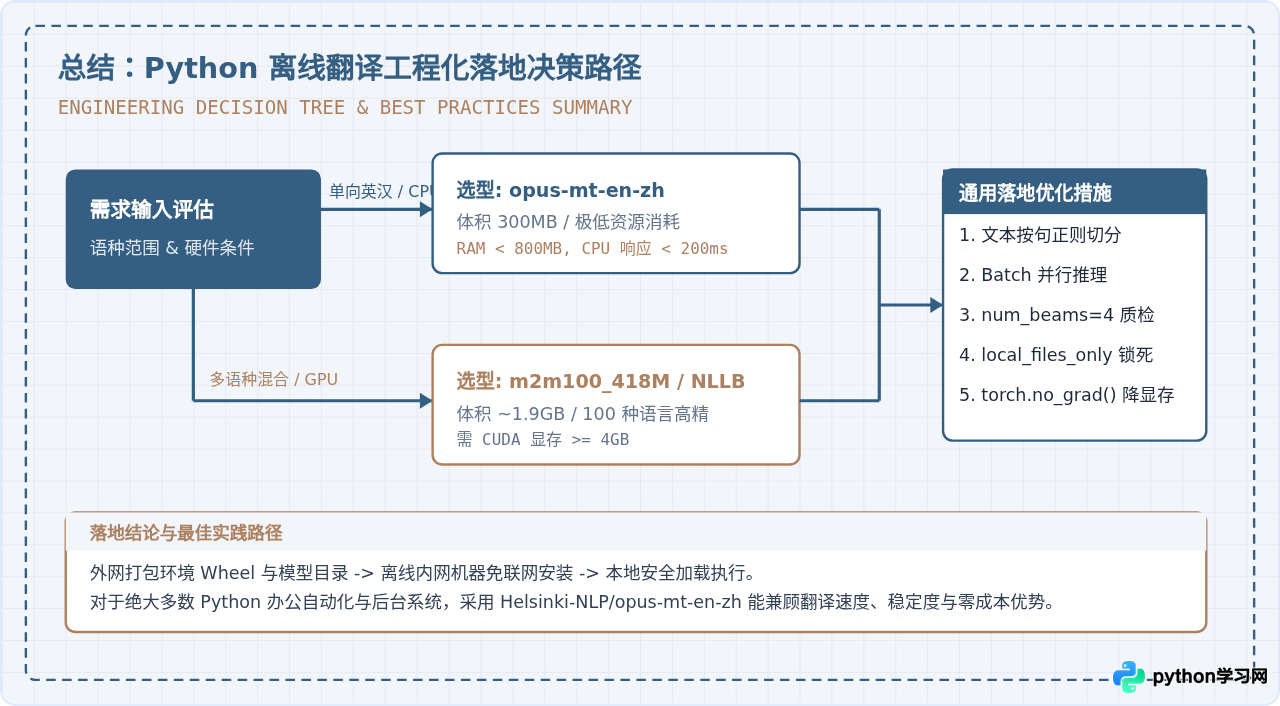
通过基于 Hugging Face transformers 的本地模型方案,开发者能够摆脱对云端 API 的网络依赖,构建真正私有、合规且成本可控的 Python 离线翻译流程。从工程实践的角度来看:
- 对于常规的英译中场景,优先选用轻量且专精的
Helsinki-NLP/opus-mt-en-zh,可在普通的 CPU 资源下实现秒级平滑翻译; - 在代码层面,严格指定
local_files_only=True并使用torch.no_grad(),可以有效杜绝网络握手超时并压缩资源开销; - 配合长文本分句切分与批处理(Batch)机制,该方案既能支持单句实时转换,也能稳定胜任大体量文档的离线批量翻译。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















